Einführung in KI-native Behebung: Vom validierten Befund zur geprüften Korrektur
Wie aus einem validierten Befund ein prüfungsfertiger Pull Request mit Belegen, Regressionstests und Retest wird und warum Ihr Team über den Merge entscheidet.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenSchwachstellen zu finden war noch nie so günstig.
Die Behebung hat nicht Schritt gehalten.
Scanner, Pentests und KI-Agenten erzeugen heute mehr Befunde, als Engineering-Teams lesen können. Der Rückstand wächst. Das Risiko bleibt in der Produktion.
KI-native Behebung bedeutet, einen validierten Sicherheitsbefund in eine prüfungsfertige Codeänderung zu verwandeln, mit Belegen, Begründung und Tests im Anhang. So kann ein Mensch sie mit Zuversicht mergen, und ein Retest kann nachweisen, dass die Korrektur gewirkt hat.
Sie ist kein Bot, der Patches in die Produktion schiebt.
Sie ist der letzte Schritt eines geschlossenen Kreislaufs: das Problem nachweisen, es im Code verstehen, die Änderung vorschlagen, einen Menschen entscheiden lassen und dann nachweisen, dass das Problem verschwunden ist.
Der Bedarf ist messbar. Im Data Breach Investigations Report 2026 stellte Verizon fest, dass die Ausnutzung von Schwachstellen mit 31 % der Sicherheitsverletzungen mit bekanntem Erstzugangsvektor in seinem Datensatz zum häufigsten anfänglichen Angriffsvektor geworden ist. Laut demselben Bericht wurden 2025 nur 26 % der CISA Known Exploited Vulnerabilities (KEV), die in den Umgebungen von Unternehmen gefunden wurden, vollständig behoben, nach 38 % im Vorjahr, und die mediane Zeit bis zur vollständigen Behebung stieg auf 43 Tage.
Angreifer nutzen die Lücke zwischen „gefunden“ und „behoben“. KI-native Behebung soll sie schließen, ohne die Kontrolle abzugeben.
Was ist KI-native Behebung?
KI-native Behebung ist ein Behebungsworkflow, der von Anfang an um KI herum entworfen wurde: Das System liest einen validierten Befund, sammelt den Codekontext dazu, entwirft eine minimale Korrektur mit Tests und Erklärung, öffnet sie als Pull Request zur menschlichen Prüfung und testet den ursprünglichen Nachweis nach der Änderung erneut.
Drei Wörter in dieser Definition tragen die meiste Last.
Validiert. Der Input ist ein Befund, dessen Echtheit nachgewiesen wurde, keine rohe Warnung. Lässt sich das Problem nicht reproduzieren, gibt es noch nichts zu beheben.
Prüfungsfertig. Das Ergebnis ist eine Änderung, die ein Entwickler in wenigen Minuten bewerten kann: ein kleiner Diff, der Grund, warum er die Schwachstelle beseitigt, die Tests, die ihn abdecken, und die betroffenen Quellcodestellen.
Erneut getestet. Die Korrektur ist mit dem Merge nicht erledigt. Sie ist erledigt, wenn der ursprüngliche Nachweis nicht mehr funktioniert.
Fehlt eines davon, entsteht etwas Schwächeres.
Ohne Validierung automatisieren Sie Korrekturen für Probleme, die es vielleicht gar nicht gibt.
Ohne Review geben Sie einem Modell Schreibzugriff.
Ohne Retest haben Sie eine Änderung, die richtig aussieht und es vielleicht nicht ist.
Warum die Behebung 2026 der Engpass ist
Die Erkennung wurde zuerst skaliert. Die Behebung nicht.
Die Zahlen aus unabhängigen Quellen zeigen in dieselbe Richtung.
Die Patch-Daten.
Der DBIR 2026 hat die Behebung von KEV-gelisteten Schwachstellen gemessen, die Scanner in den Umgebungen von Unternehmen gefunden haben, auf Basis aggregierter Daten von mehr als 13.000 Unternehmen. Drei Ergebnisse stechen hervor:
- Nur 26 % dieser KEV-Schwachstellen wurden 2025 vollständig behoben, gegenüber 38 % im Vorjahr.
- Die mediane Zeit bis zur vollständigen Behebung stieg von 32 auf 43 Tage.
- Das mediane Unternehmen musste 16 KEV-Schwachstellen patchen, nach 11 im Vorjahr. Der Bericht nennt das fast 50 % mehr.
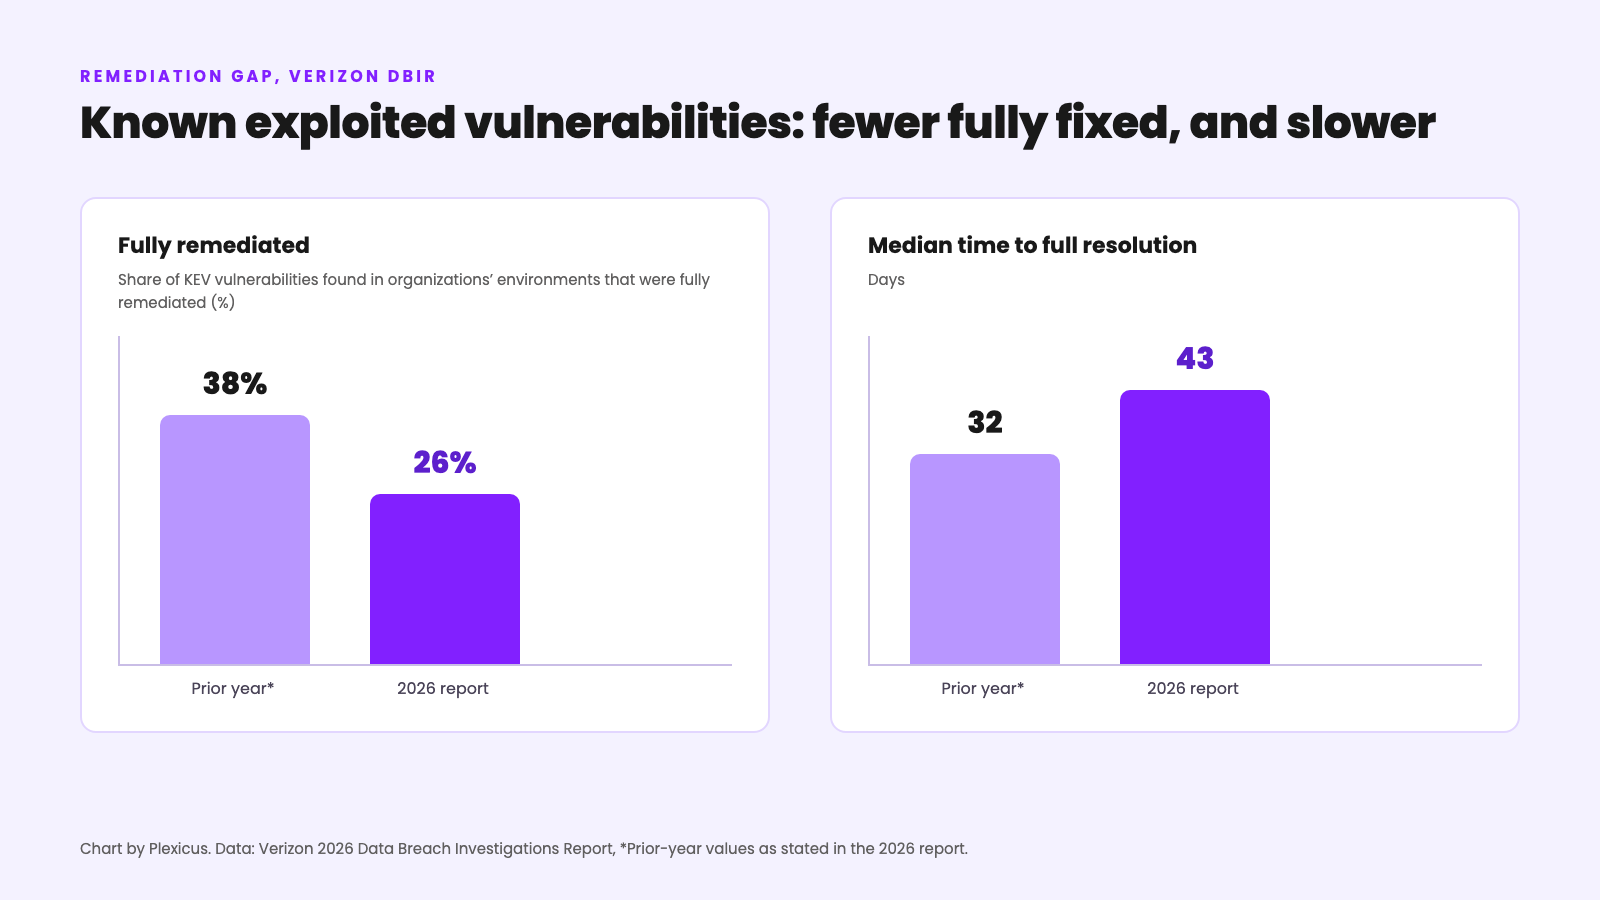
Diagramm von Plexicus auf Basis der Zahlen aus dem Verizon Data Breach Investigations Report 2026; die Vorjahreswerte sind die Vergleichswerte, die der Bericht selbst nennt.
Diese Zahlen beschreiben das Patchen bekannter Schwachstellen in den Umgebungen von Unternehmen, nicht Korrekturen im eigenen Anwendungscode. Sie zeigen trotzdem die Form des Problems: Die Warteschlange wächst schneller, als Teams sie abarbeiten.
Die Fristen.
Für US-Bundesbehörden ist der Zeitrahmen keine Frage der Vorliebe. Die Binding Operational Directive (BOD) 26-04 der CISA, am 10. Juni 2026 erlassen, hob die BOD 22-01 auf und ersetzte deren Standard-KEV-Fristen durch risikobasierte Behebungsfristen für die zivilen Bundesbehörden der Exekutive.
Vier Faktoren bestimmen die Frist für jedes Asset:
- Ob es öffentlich erreichbar ist.
- Ob die Schwachstelle im KEV-Katalog steht.
- Ob ein Angreifer alle zur Ausnutzung nötigen Schritte automatisieren kann.
- Ob eine erfolgreiche Ausnutzung dem Angreifer partielle oder vollständige Kontrolle über das Asset verschafft.
Die Fristen passen sich an, wenn sich diese Fakten ändern: Die Frist einer Schwachstelle verkürzt sich, sobald die CISA sie in den KEV-Katalog aufnimmt. Die Behörden müssen KEV-Schwachstellen bereits bis zu den Fälligkeitsterminen im KEV-Katalog beheben und die vollständigen Fristen für jede Schwachstelle mit CVE-ID innerhalb von 180 Tagen nach dem Erlass einhalten.
In Europa trat der Cyber Resilience Act am 10. Dezember 2024 in Kraft. Laut Europäischer Kommission gelten die Meldepflichten ab dem 11. September 2026 und die Hauptpflichten ab dem 11. Dezember 2027. Hersteller von Produkten mit digitalen Elementen müssen aktiv ausgenutzte Schwachstellen jetzt melden.
Regulierung schreibt keine Patches. Sie verkürzt aber die Zeit, die ein Team für die Entscheidung hat, ob es patcht.
Der Code, der entsteht.
Auch die Menge an neuem Code verändert sich. Der 2025 GenAI Code Security Report von Veracode testete mehr als 100 große Sprachmodelle mit Programmieraufgaben und berichtete, dass 45 % der Codebeispiele Sicherheitstests nicht bestanden und Schwächen aus den OWASP Top 10 einführten. Es handelt sich um vom Anbieter berichtete Ergebnisse aus Veracodes eigenem Testset, nicht um eine unabhängige Replikation.
Auch mit diesem Vorbehalt ist die Richtung klar. KI-Programmierwerkzeuge erhöhen die Menge an Code, die ins Review gelangt. Ein Teil davon enthält dieselben klassischen Fehler, die Sicherheitsteams seit zwanzig Jahren beheben.
Die Menge der Offenlegungen.
Die Methodik der CWE Top 25 2025 von MITRE analysierte 39.080 CVE-Einträge, die zwischen dem 1. Juni 2024 und dem 1. Juni 2025 veröffentlicht wurden. Das ist ein Jahr veröffentlichter CVE-Einträge, noch bevor Sie zählen, was Ihre eigenen Scanner und Tests in Ihrem eigenen Code finden.
Mehr Befunde, engere Fristen, mehr Code. Der Engpass liegt nicht mehr darin, das Problem zu sehen. Er liegt darin, es zu schließen.
Was „KI-nativ“ bedeutet und was nicht
„KI-nativ“ lässt sich leicht missbrauchen, daher lohnt sich Präzision.
Ein KI-nativer Behebungsworkflow ist einer, in dem die KI Teil des Pipeline-Designs ist: Sie erhält strukturierte Belege, arbeitet mit dem echten Repository, liefert ein strukturiertes Ergebnis und wird durch Tests und einen Menschen geprüft.
Das ist etwas anderes, als einem Scanner ein Chatfenster anzuschrauben.
Es ist auch etwas anderes als Autonomie ohne Grenzen.
Die KI entwirft. Tests prüfen. Menschen entscheiden. Ein Retest bestätigt.
In diesem Sinn beschreibt „KI-nativ“, wo die KI im Kreislauf sitzt, nicht wie viel Befugnis sie hat.
Je mehr Arbeit die KI übernimmt, desto mehr Belege und Review braucht der Workflow um sie herum.
KI-native Behebung im Vergleich zu automatisiertem Patch-Management
Automatisiertes Patch-Management und Bots für Abhängigkeitsupdates lösen ein engeres Problem sehr gut.
Die GitHub-Dokumentation zu Dependabot-Sicherheitsupdates beschreibt das Muster: Gibt es für eine Abhängigkeit eine veröffentlichte Sicherheitsmeldung, prüft Dependabot, ob ein Upgrade auf eine korrigierte Version möglich ist, ohne den Abhängigkeitsgraphen zu beschädigen. Dann öffnet es einen Pull Request, der die Abhängigkeit auf die niedrigste Version mit dem Patch aktualisiert.
Das ist ein wertvoller Workflow. Behalten Sie ihn.
Er beantwortet aber nur eine Frage: Gibt es eine neuere Version dieses Pakets ohne die bekannte Schwachstelle?
Der Pull Request mit dem Versionssprung beantwortet selbst nicht:
- Ruft Ihr Code die verwundbare Funktion tatsächlich auf?
- Liegt der Fehler in Ihrem eigenen Code statt in einer Bibliothek?
- Muss sich für die Korrektur ändern, wie Ihre Anwendung die Bibliothek aufruft?
- Ist das eigentliche Problem eine Autorisierungsprüfung, die nie geschrieben wurde?
KI-native Behebung beginnt mit einem anderen Input. Sie startet mit einem validierten Befund in Ihrer Anwendung, auch im eigenen Code, und kann Änderungen an diesem Code vorschlagen, nicht nur an einem Manifest.
Beide Ansätze ergänzen sich gut. Ein Versionssprung ist oft die richtige Korrektur. Manchmal reicht er nicht aus.
KI-native Behebung im Vergleich zu KI-Codevorschlägen
Inline-KI-Vorschläge im Editor oder im Pull Request helfen Entwicklern, die sich das Problem bereits ansehen.
Sie sind nützlich. Sie sind aber etwas anderes.
Ein Inline-Vorschlag beginnt meist mit einer Scanner-Warnung oder einem Prompt des Entwicklers. Er schlägt eine Änderung vor. Der Entwickler entscheidet, ob die Warnung echt war und ob die Änderung korrekt ist.
KI-native Behebung zieht zwei dieser Entscheidungen nach vorn und macht sie explizit:
- Ist der Befund echt? Der Workflow akzeptiert nur validierte Befunde mit Belegen.
- Funktioniert die Korrektur? Der Workflow hängt Tests an und führt den ursprünglichen Nachweis erneut aus.
Der Entwickler prüft die Änderung weiterhin. Er prüft sie mit mehr Kontext und weniger Raten.
KI-native Behebung im Vergleich zu manueller Behebung
Manuelle Behebung ist der Maßstab und bleibt das richtige Werkzeug für die schwierigsten Probleme.
Ein erfahrener Engineer versteht Designabsicht, Teamkonventionen und Geschäftsregeln, die in keinem Befundbericht stehen. Bei einem Fehler, der in der Architektur wurzelt, sollte ein Mensch die Führung übernehmen.
Die Schwäche manueller Behebung ist nicht die Qualität. Es sind Durchsatz und Konsistenz.
Jeder Befund braucht jemanden, der ihn reproduziert, lokalisiert, versteht, eine Korrektur entwirft, Tests schreibt und einen Pull Request öffnet. Diese Arbeit konkurriert mit der Produkt-Roadmap, und meist gewinnt die Roadmap.
KI-native Behebung übernimmt den repetitiven Teil dieser Abfolge und lässt die Entscheidung beim Engineer.
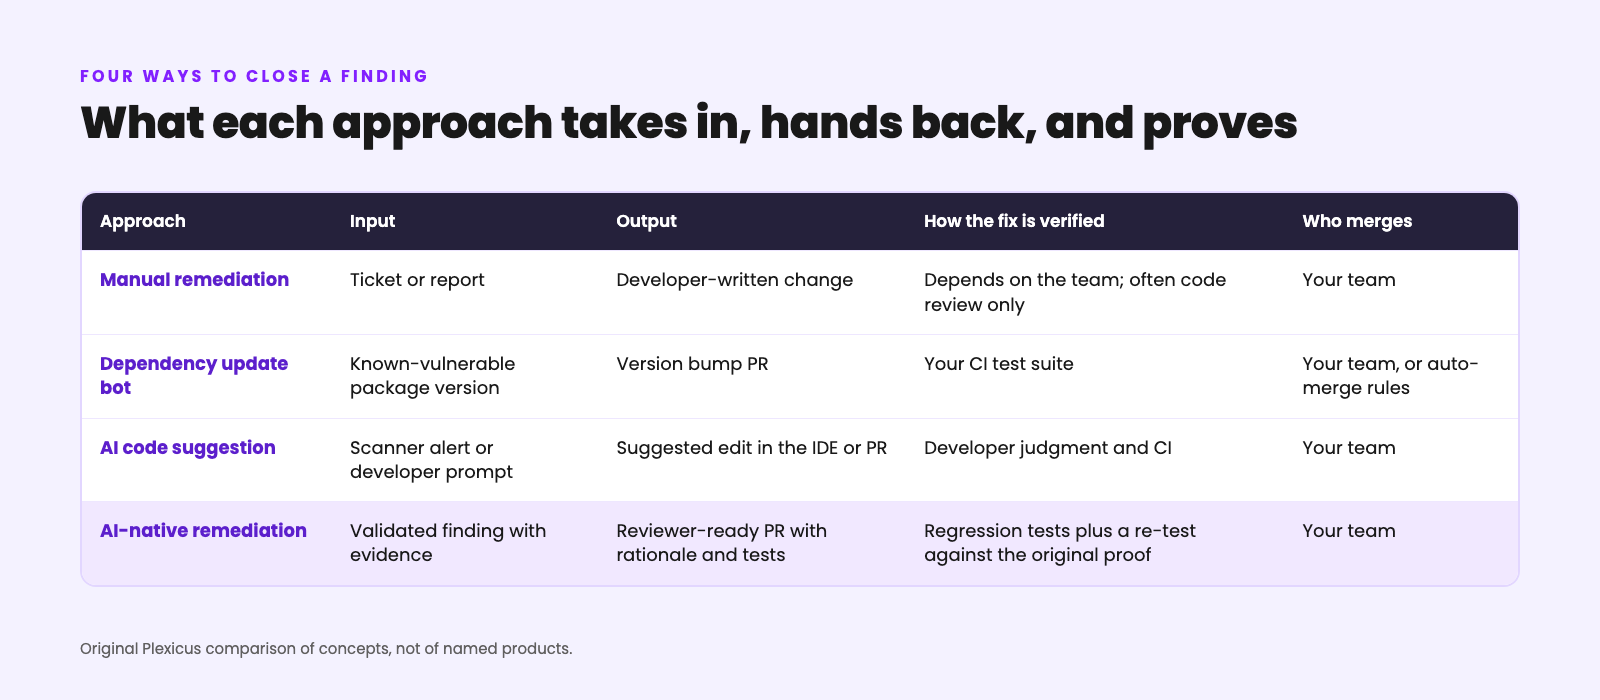
Eigener Plexicus-Vergleich der vier Ansätze als Konzepte; er beschreibt kein bestimmtes Produkt.
So funktioniert KI-native Behebung
Ein vollständiger Workflow hat sieben Phasen. Jede übergibt der nächsten ein bestimmtes Artefakt. Das Diagramm unten fasst sie in fünf Schritten zusammen.
Validated finding + evidence
        ↓
Code context and root cause
        ↓
Fix strategy
        ↓
Drafted change + tests + rationale
        ↓
Automated checks (CI)
        ↓
Human review and merge decision
        ↓
Re-test against the original proof
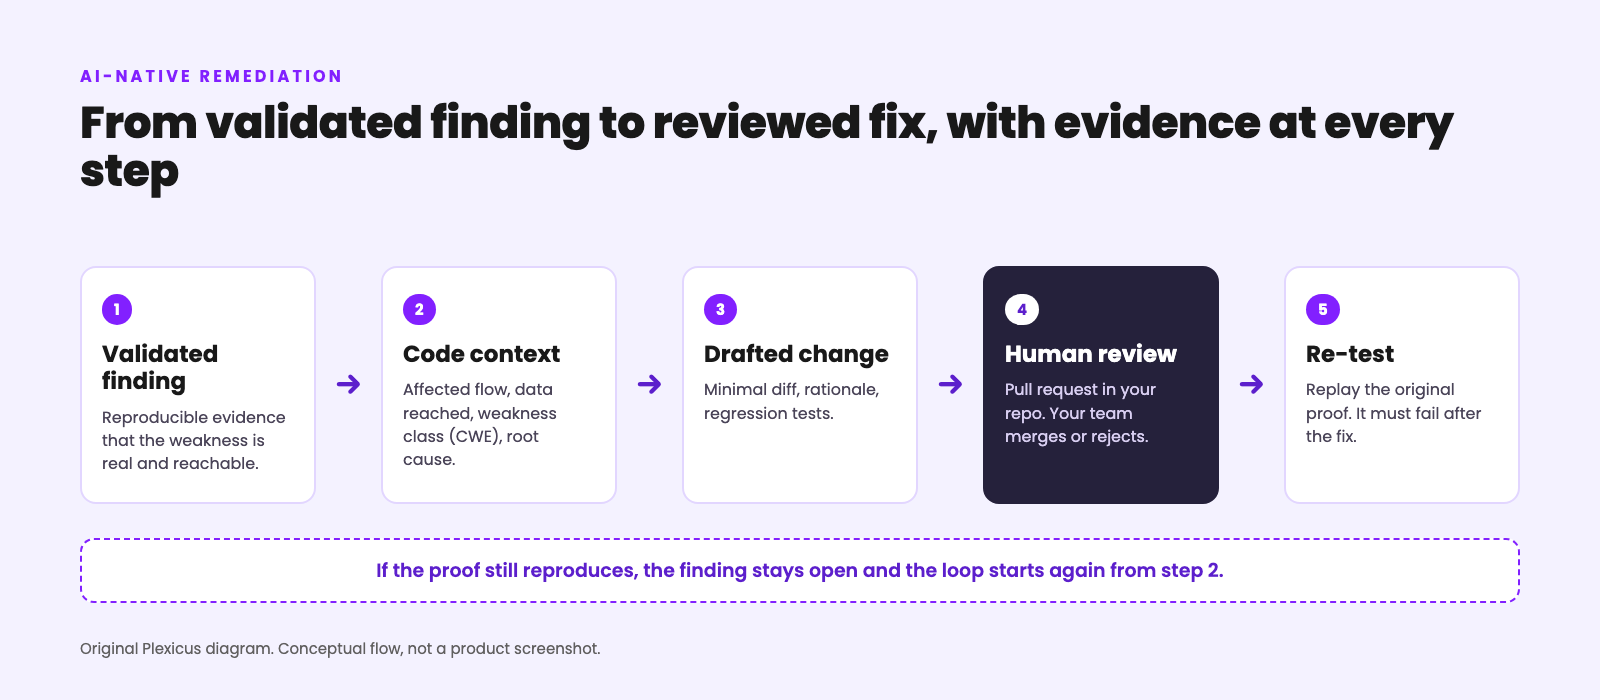
Eigenes Plexicus-Diagramm des Behebungskreislaufs; es zeigt einen konzeptionellen Ablauf, keinen Produkt-Screenshot.
1. Von einem validierten Befund ausgehen
Der Input ist ein Befund mit Belegen: die Anfrage, die den Fehler ausgelöst hat, die Antwort, die ihn nachgewiesen hat, die erreichten Daten und die Rolle, die sie erreichen konnte.
Ein Befund ohne Belege ist eine Hypothese. Eine Behebung auf Basis einer Hypothese verschwendet Review-Zeit und untergräbt das Vertrauen in jeden späteren Pull Request.
2. Codekontext und Grundursache ermitteln
Das System verfolgt den Befund zurück in den Code: Endpunkt, Handler, Funktion, Parameter und den Datenfluss dazwischen.
Es bestimmt auch die Schwachstellenklasse, meist als CWE-Eintrag wie CWE-89 für SQL Injection. Die Klasse ist wichtig, weil das Korrekturmuster von ihr abhängt.
So sieht der Codekontext eines Befunds in der Plexicus-Plattform aus.
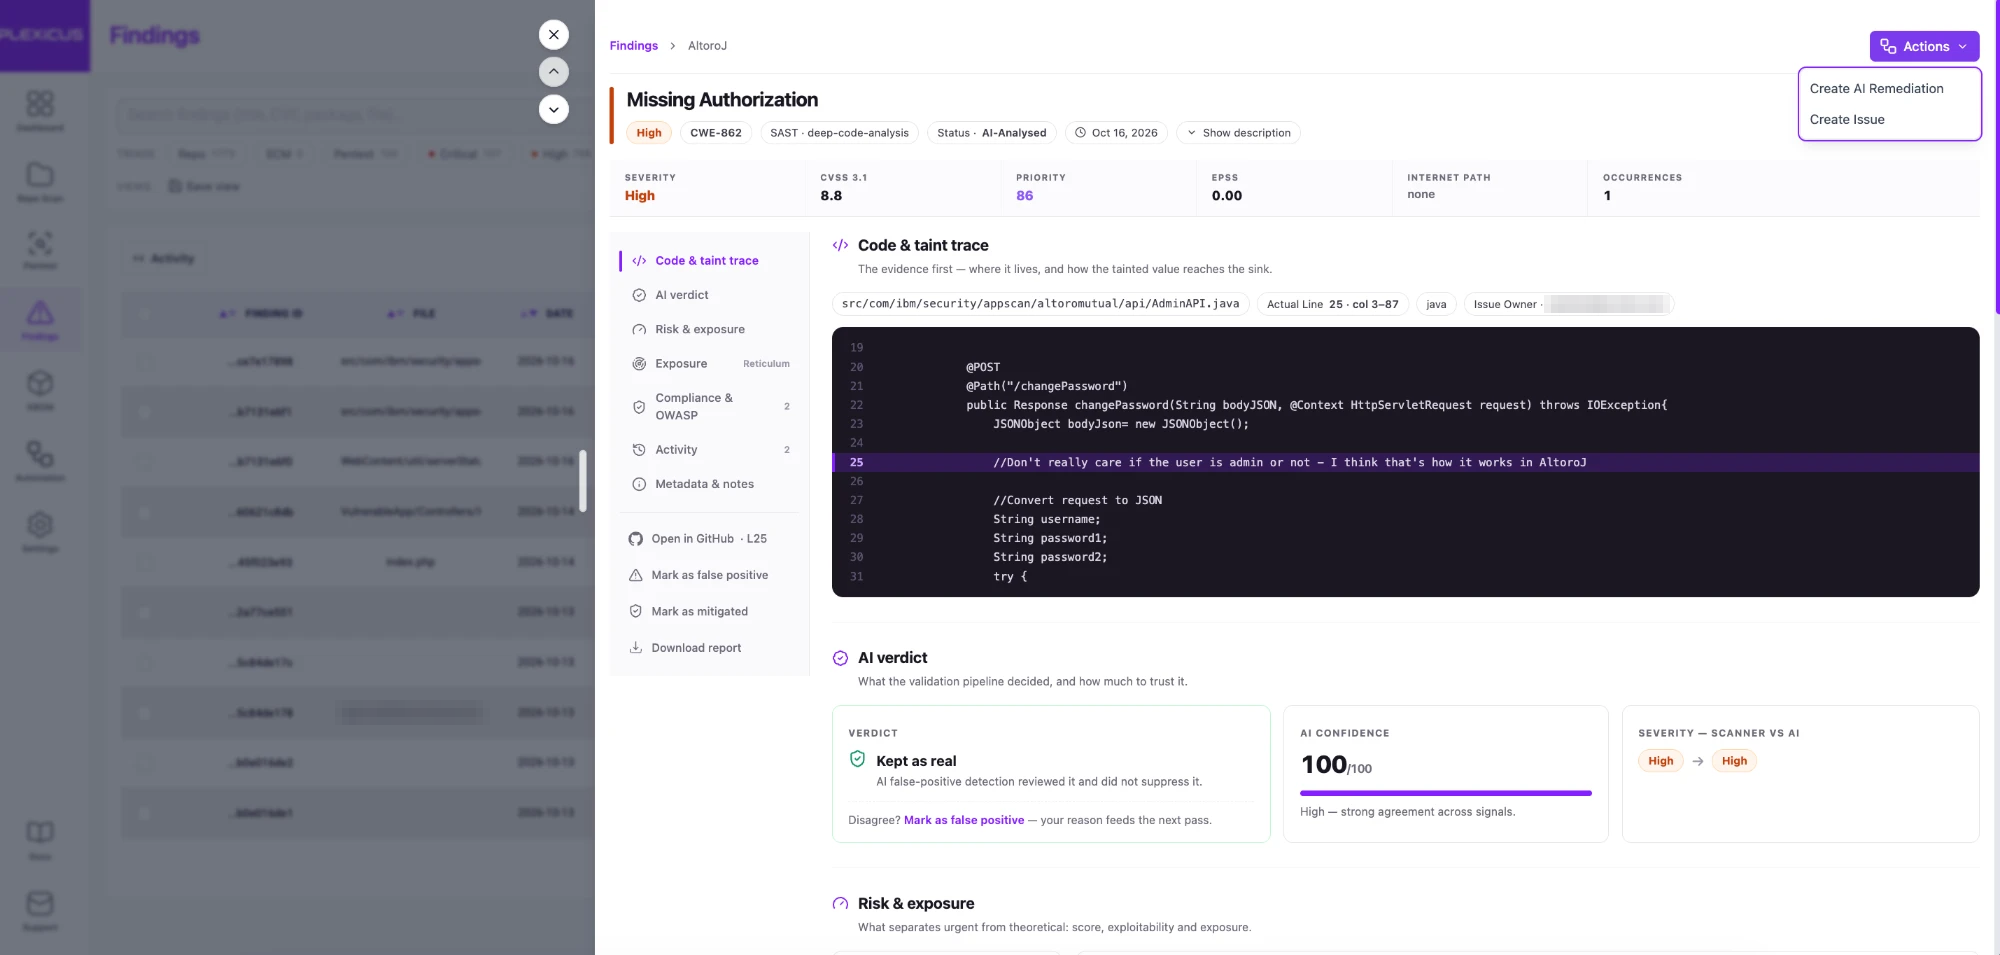
Screenshot: die Detailansicht eines Befunds zu fehlender Autorisierung (CWE-862) in einer Java-Demoanwendung in der Plexicus-Plattform. Sie zeigt den Abschnitt Code & taint trace, das KI-Urteil und Create AI Remediation im Aktionsmenü. Demodaten, aufgenommen im Oktober 2026; die E-Mail-Adresse des Issue-Owners ist verpixelt.
3. Eine Korrekturstrategie wählen
Für die meisten Schwachstellenklassen gibt es bewährte Korrekturmuster.
Parametrisierte Abfragen gegen Injection. Eine Eigentümerprüfung bei Autorisierung auf Objektebene. Ein Versions-Upgrade bei einer verwundbaren Abhängigkeit.
Die Strategie legt auch den Umfang fest. Die beste Korrektur ist meist die kleinste Änderung, die die Schwachstelle an ihrer Quelle beseitigt.
4. Änderung, Tests und Erklärung entwerfen
Das Ergebnis ist ein Diff, eine kurze Begründung, die jede geänderte Zeile mit dem Befund verknüpft, und Tests, die vor der Korrektur fehlgeschlagen wären.
Ein Regressionstest verhindert, dass derselbe Fehler in sechs Monaten zurückkehrt.
Hier wird eine KI-erzeugte Behebung in der Plexicus-Plattform geprüft.
Video: ein Clip aus dem Rundgang durch die Plexicus-Plattform. Im Dialog AI Remediation Details zu einem Command-Injection-Befund erklärt der Reiter Details die Schwachstelle und die Korrektur, der Reiter Code Changes zeigt den Diff von app.py, und der Clip endet damit, dass der Pull Request erstellt wird. Aufgenommen im Mai 2026.
5. Die automatisierten Prüfungen ausführen
Die Änderung durchläuft dieselbe CI-Pipeline wie jeder andere Pull Request: Build, Unit-Tests, Linter und bestehende Sicherheitsprüfungen.
Eine von der KI entworfene Korrektur bekommt keine Abkürzung. Wenn überhaupt, durchläuft sie jedes Mal die vollständige Pipeline.
6. Die Entscheidung an einen Menschen übergeben
Die Änderung kommt als Pull Request in dem Repository an, das Ihr Team bereits nutzt. Ein Reviewer liest Diff, Belege und Begründung und mergt, bearbeitet oder verwirft die Änderung dann.
Der Reviewer entscheidet über den Merge.
So sieht ein Befund aus, sobald eine Korrektur eingereicht wurde, in der Plexicus-Plattform.
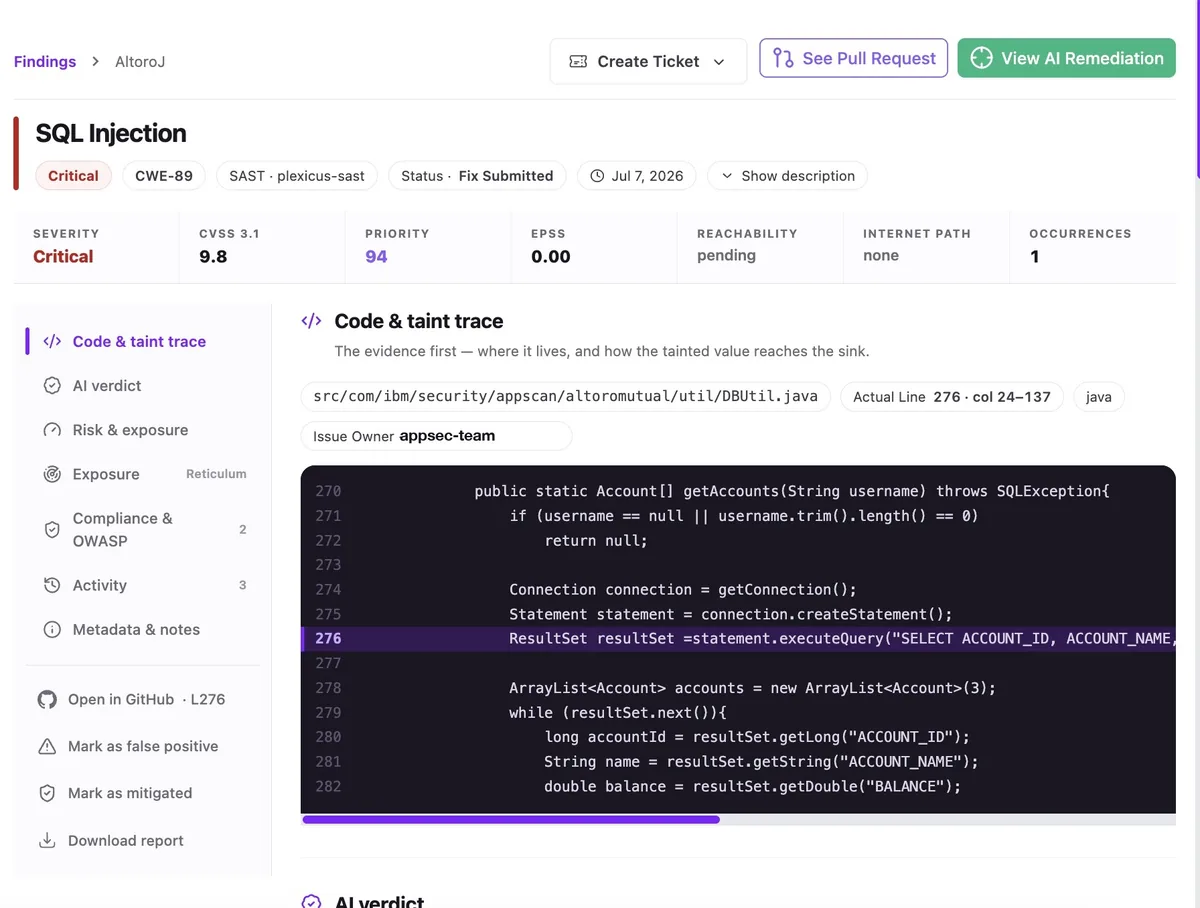
Screenshot: ein kritischer SQL-Injection-Befund (CWE-89) in einer Java-Demoanwendung, dargestellt in der Plexicus-Plattform mit dem Status Fix Submitted. Die Werkzeugleiste bietet Create Ticket, See Pull Request und View AI Remediation. Demodaten.
Und hier ist ein Pull Request zu einem Command-Injection-Befund, so wie er im Repository ankommt.
Video: ein Clip aus dem Rundgang durch die Plexicus-Plattform. Das Live-Statusprotokoll endet mit dem Erstellen des Pull Requests; auf GitHub wird er von einem Plexicus-Bot-Konto mit einem Commit und der Erklärung der Korrektur in der Beschreibung geöffnet, und danach mergt eine Person ihn. Diese Aufnahme zeigt keine CI-Prüfungen und keine Reviews am Pull Request. Aufgenommen im Mai 2026.
7. Gegen den ursprünglichen Nachweis erneut testen
Nach der Änderung wird der ursprüngliche Nachweis erneut ausgeführt. Funktioniert der Exploit noch, bleibt der Befund offen. Schlägt er fehl, lässt sich der Befund mit Belegen auf beiden Seiten schließen: vorher reproduzierbar, nachher nicht mehr.
Erst dieser letzte Schritt macht aus einer Codeänderung einen geschlossenen Befund.
Warum der Input ein validierter Befund sein muss
Es ist verlockend, einen Korrektur-Agenten auf die gesamte Ausgabe aller Scanner anzusetzen.
Das vervielfacht das Rauschen.
Jeder False Positive wird zu einem Pull Request. Jeder Pull Request kostet einen Reviewer Zeit. Nach einigen verworfenen Änderungen beginnen Reviewer, sie ungelesen freizugeben oder zu ignorieren, und das ist schlimmer als gar keine Automatisierung.
Der Start mit validierten Befunden verändert die Ökonomie des Reviews. Jede Änderung, die ein Reviewer sieht, gehört zu einem Problem, dessen Echtheit nachgewiesen wurde.
Das ist der Kern von Proof-Driven AppSec: No PoC, no finding. Dieselbe Regel gilt einen Schritt später. Kein validierter Befund, keine automatisierte Korrektur.
Mehr dazu, wie die Validierung funktioniert, finden Sie in unserer Einführung in AI Swarm Pentest. Sie beschreibt die unabhängige Reproduktion, bevor ein Befund als verifiziert präsentiert wird.
Warum das Ergebnis ein Pull Request sein muss und kein Push
Ein Pull Request ist der Kontrollpunkt, dem Ihre Engineering-Organisation bereits vertraut.
Er enthält einen Diff und führt die CI aus. Er hält fest, wer was wann freigegeben hat, und er lässt sich zurücknehmen.
Das Projekt OpenSSF Scorecard behandelt dies als grundlegende Praxis. Sein Code-Review-Check ermittelt, ob ein Projekt menschliches Code-Review verlangt, bevor Pull Requests gemergt werden, und stuft das Risiko, darauf zu verzichten, als hoch ein.
Dieser Maßstab sollte umso strenger gelten, wenn der Autor eine KI ist.
Ein KI-nativer Behebungsworkflow braucht deshalb nie direkten Schreibzugriff auf die Produktion. Er muss nur einen Branch und einen Pull Request öffnen können. Alles danach ist Ihr normaler Prozess.
Was die Forschung über KI-generierte Sicherheitskorrekturen sagt
Die Forschung zu KI-geschriebenen Sicherheitspatches ist ermutigend und ernüchternd zugleich. Vier Quellen sollten Sie kennen.
LLMs können einfache Fälle reparieren, echter Code ist schwieriger.
In „Examining Zero-Shot Vulnerability Repair with Large Language Models“, veröffentlicht auf dem IEEE Symposium on Security and Privacy 2023, testeten Pearce und Kollegen fünf kommerziell verfügbare Modelle, ein Open-Source-Modell und ein lokal trainiertes Modell an synthetischen, von Hand erstellten und realen Schwachstellenszenarien.
Zusammen reparierten die Modelle alle synthetischen und von Hand erstellten Szenarien. Bei historischen Beispielen aus der Praxis berichteten die Autoren von Schwierigkeiten, funktional korrekten Code zu erzeugen.
Lehre: Eine Korrektur, die kompiliert, ist noch keine Korrektur, die funktioniert.
Im großen Maßstab zählt auch eine moderate Erfolgsquote.
Googles technischer Bericht zu KI-gestütztem Patchen beschreibt eine Pipeline, die Gemini Korrekturen für von Sanitizern gefundene Bugs in C/C++, Java und Go erzeugen lässt und sie dann zum menschlichen Review vorlegt.
Laut Google hat der Ansatz 15 % der bei Unit-Tests entdeckten Sanitizer-Bugs erfolgreich behoben, was Hunderte gepatchte Bugs ergab. Es handelt sich um ein vom Unternehmen berichtetes Ergebnis aus Googles eigener Pipeline, nicht um eine unabhängige Replikation.
Lehre: Schon eine teilweise Automatisierungsquote nimmt echte Arbeit ab, solange Menschen prüfen, was ausgeliefert wird.
Patch-Qualität muss getestet werden, nicht nach Ähnlichkeit beurteilt.
In „Fixing Security Vulnerabilities with AI in OSS-Fuzz“ passten Forschende einen LLM-Agenten an, um von OSS-Fuzz gefundene Schwachstellen zu beheben. Laut dem Paper hat OSS-Fuzz mehr als 10.000 Schwachstellen in 1.000 oder mehr Projekten identifiziert.
Eines ihrer Ergebnisse ist direkt für das Design der Behebung relevant: Patches mit hohen Werten bei Code-Ähnlichkeitsmetriken scheiterten trotzdem, wenn die Exploit-Eingabe gegen sie ausgeführt wurde. Die Autoren folgern, dass die Korrektheit von Sicherheitspatches dynamische Eigenschaften wie die Testausführung berücksichtigen muss.
Lehre: Der Exploit ist Teil des Tests. Eine Korrektur ist erst korrekt, wenn der Nachweis nicht mehr funktioniert, so sehr der Diff auch einer bekannten Korrektur ähnelt.
Wettbewerbssysteme können in hohem Tempo finden und patchen.
Die Endergebnisse der AI Cyber Challenge der DARPA, bekannt gegeben am 8. August 2025, berichten, dass die teilnehmenden Systeme 54 eindeutige synthetische Schwachstellen in den 63 Challenges des Finales entdeckten und 43 davon patchten. Die Teams fanden zudem 18 echte, nicht synthetische Schwachstellen und lieferten 11 Patches für echte Schwachstellen. Laut DARPA dauerte das Einreichen eines Patches im Durchschnitt 45 Minuten.
Das sind Wettbewerbsergebnisse an realer Open-Source-Software, die für die Challenge ausgewählt wurde, unter den Bewertungsregeln des Wettbewerbs. Sie zeigen, was möglich ist, nicht was ein bestimmtes Team in seinem eigenen Code sehen wird.
Was die Belege nicht zeigen.
Keine dieser Quellen zeigt, dass KI jede Schwachstelle ohne Aufsicht beheben kann.
Sie zeigen, dass KI einen nützlichen Teil der Korrekturen entwerfen kann und dass die Korrektheit durch Ausführen des Nachweises geprüft werden muss. Nur Googles Produktionspipeline bindet einen Menschen ein; die anderen drei messen autonome Systeme unter Testbedingungen.
Deshalb ergänzt ein Produktionsworkflow zusätzlich menschliches Review. Genau so ist ein KI-nativer Behebungsworkflow aufgebaut.
Der Exploit ist der beste Regressionstest.
Die meisten Sicherheitskorrekturen werden verifiziert, indem man sie liest.
Ein Reviewer sieht sich den Diff an, erkennt eine parametrisierte Abfrage und gibt frei.
Das funktioniert bei vertrauten Mustern. Bei subtilen scheitert es: eine Autorisierungsprüfung, die erst nach dem Laden der Daten greift, ein Sanitizer, der eine Kodierung übersieht, ein Abhängigkeits-Upgrade, das eine verwundbare transitive Kopie zurücklässt.
Wenn der Befund mit einem funktionierenden Nachweis kam, ist die stärkste Prüfung einfach:
Proof reproduced before the fix:  YES
Proof reproduced after the fix:   NO
Regression tests:                 PASS
Reviewer approval:                YES
Dieses vierzeilige Protokoll ist ein stärkerer Beleg als Überlegungen zum Diff allein.
Ein Nachweis für eine vollständige Korrektur ist es nicht. Eine Änderung, die nur den ursprünglichen Payload blockiert, besteht die Wiederholung ebenfalls. Die Regressionstests sollten daher Varianten der Eingabe abdecken, etwa andere Kodierungen.
Es ist auch das Protokoll, das ein Auditor, ein Kunde oder eine Aufsichtsbehörde früher oder später verlangen wird.
Welche Arten von Fehlern kann KI-native Behebung beheben?
Nicht jeder Befund ist ein guter Kandidat. Die Eignung hängt davon ab, wie lokal die Korrektur ist und wie gut das Korrekturmuster verstanden ist.
Klassische Codefehler.
Injection, Cross-Site Scripting, Server-Side Request Forgery, unsichere Deserialisierung und schwache Kryptografie haben meist bekannte Korrekturmuster. Die OWASP Top 10
führen Injection als A05 und Kryptografische Fehler als A04.Stärken: Korrekturen betreffen oft nur eine Funktion, das Muster ist Standard, und ein Regressionstest ist leicht zu schreiben.
Grenzen: Derselbe Fehler kann an mehreren Stellen auftreten, und eine Korrektur an einer Aufrufstelle deckt die anderen nicht ab. Der Workflow sollte an anderen Stellen nach demselben Muster suchen. Das NIST SSDF nennt das, die Software auf ähnliche Schwachstellen zu prüfen, um eine ganze Klasse zu beseitigen.
Fehler in Zugriffskontrolle und Geschäftslogik.
Fehlerhafte Zugriffskontrolle ist A01 in den OWASP Top 10
. Sie umfasst Fehler wie fehlende Eigentümerprüfungen und Rechteausweitung. Fehler in der Geschäftslogik, etwa eine fehlende Ratenbegrenzung, liegen direkt daneben.Stärken: Ein validierter Befund zeigt genau, welcher Benutzer welches Objekt erreicht hat. Das macht die fehlende Prüfung konkret.
Grenzen: Die richtige Regel hängt von der geschäftlichen Absicht ab. Soll ein Team-Admin jedes Projekt im Unternehmen sehen oder nur die seines Teams?
Die KI kann die Prüfung entwerfen. Ein Mensch muss die Regel bestätigen.
Risiken durch Abhängigkeiten und die Lieferkette.
Verwundbare Versionen, Namen mit Typosquatting und Pakete, die nie hätten installiert werden dürfen.
Stärken: Versions-Upgrades und der Austausch von Paketen sind mechanisch, und Änderungen an Lockfiles sind leicht zu prüfen.
Grenzen: Upgrades auf eine neue Hauptversion können APIs brechen. Eine Korrektur kann neben dem Versionssprung Codeänderungen erfordern, und Tests sind hier wichtiger als irgendwo sonst.
Fehler, die beim Programmieren mit KI entstehen.
Halluzinierte Paketnamen, fest codierte Secrets, Senken für Prompt Injection und Autorisierungslücken in generiertem Code.
Stärken: Diese Fehler folgen oft erkennbaren Mustern und liegen in kürzlich geändertem Code. Das hält den Umfang der Korrektur klein.
Grenzen: Generierter Code hat womöglich überhaupt keine Tests. Die Behebung muss sie daher ergänzen, nicht nur den Code ändern.
Architekturfehler.
Ein System, das einer internen Netzwerkgrenze vertraut, oder ein Design, das Secrets auf den Client legt.
Stärken: Die Belege helfen einem Team trotzdem, das Problem zu verstehen und zu priorisieren.
Grenzen: Hier gibt es selten einen sicheren kleinen Diff. Das richtige Ergebnis ist eine klare Erklärung und ein Plan für das Team, kein automatisierter Pull Request.
Wann kann ein Auto-Fix-Pull-Request sicher gemergt werden?
„Sicher zu mergen“ ist das Urteil eines Reviewers. Diese Fragen machen das Urteil schneller und konsistenter.
- Wurde der Befund validiert? Gibt es Belege, dass die Schwachstelle echt und erreichbar war?
- Ist der Diff minimal? Hängt jede geänderte Zeile mit dem Befund zusammen?
- Ist die Begründung konkret? Nennt sie die Schwachstellenklasse, die Quellcodestelle und warum die Änderung die Schwachstelle beseitigt?
- Gibt es Regressionstests? Wären sie vor der Änderung fehlgeschlagen?
- Besteht die CI? Vollständig, ohne übersprungene Jobs.
- Schlägt der Nachweis nach der Korrektur fehl? Wurde der ursprüngliche Exploit oder die Reproduktion erneut ausgeführt?
- Ändert die Korrektur Verhalten, auf das sich Benutzer verlassen? Falls ja: Hat der Product Owner sie gesehen?
- Gibt es dasselbe Muster an anderer Stelle? Falls ja: Gibt es eine Folgeaufgabe?
Lautet eine Antwort „nein“ oder „unbekannt“, ist der Pull Request nicht bereit, so sauber der Diff auch aussieht.
Best Practices für KI-native Behebung
1. Belege einspeisen, keine Warnungen
Nur validierte Befunde sollten in die Behebungswarteschlange gelangen. Alles andere bleibt in der Triage.
2. Die Belege an der Änderung belassen
Der Pull Request sollte auf den Befund, seinen Nachweis und seinen Kontext verlinken. Ein Reviewer sollte nie ein anderes Tool öffnen müssen, um zu verstehen, warum es die Änderung gibt.
3. Die kleinste korrekte Korrektur bevorzugen
Kleine Diffs sind leichter zu prüfen, leichter zu testen und leichter zurückzunehmen. Refactorings gehören in separate Pull Requests.
4. Zu jeder Korrektur Tests verlangen
Eine Sicherheitskorrektur ohne Test kann beim nächsten Refactoring unbemerkt verschwinden.
5. Bestehende Review-Regeln nutzen
Branch-Schutz, verpflichtende Reviewer und CI-Gates sollten für von der KI entworfene Änderungen genauso gelten wie für menschliche.
6. Nach dem Merge erneut testen, nicht nur davor
Führen Sie den Nachweis gegen die bereitgestellte Änderung erneut aus. Eine Korrektur, die auf einem Branch funktioniert und nach dem Deployment versagt, ist keine Korrektur.
7. Grundursachen über die Zeit verfolgen
Erfassen Sie die Schwachstellenklasse jeder Korrektur. Kehrt dieselbe Klasse immer wieder, liegt das Problem weiter vorn: in einer Bibliothek, einer Vorlage oder einer Programmiergewohnheit.
8. Mit gut verstandenen Klassen beginnen
Beginnen Sie mit Schwachstellenklassen, für die es Standard-Korrekturmuster gibt. Erweitern Sie den Umfang, sobald die Reviewer dem Ergebnis vertrauen.
Häufige Fehler
Korrekturen für nicht validierte Befunde automatisieren. Reviewer gehen in Änderungen für Probleme unter, die nie existiert haben.
Die KI direkt auf einen geschützten Branch pushen lassen. Das entfernt genau die Kontrolle, die den gesamten Workflow vertrauenswürdig macht.
Eine Korrektur danach beurteilen, wie sie sich liest. Ähnlichkeit mit einer bekannten Korrektur ist keine Korrektheit, wie die OSS-Fuzz-Studie gezeigt hat.
Regressionstests weglassen, weil die CI grün ist. Eine grüne CI deckt nur ab, was die Tests prüfen.
Jeden Befund als per Code behebbar behandeln. Manche Probleme brauchen eine Designentscheidung, keinen Diff.
Erfolg an geöffneten Pull Requests messen. Die entscheidende Kennzahl sind Befunde, die mit bestandenem Retest geschlossen wurden.
Relevante Standards und Frameworks
KI-native Behebung ist eine neue Art, Arbeit zu erledigen, die bestehende Standards bereits beschreiben.
NIST Secure Software Development Framework.
NIST SP 800-218, das im Februar 2022 veröffentlichte Secure Software Development Framework (SSDF), enthält eine Praxisgruppe namens Respond to Vulnerabilities (RV). Ihre Aufgaben passen eng zum oben beschriebenen Workflow:
| SSDF-Aufgabe | Was sie verlangt | Wo sie im Workflow vorkommt |
|---|---|---|
RV.2.1 | Jede Schwachstelle analysieren, um genug Informationen über das Risiko für die Planung ihrer Behebung zu sammeln | Validierter Befund und Codekontext |
RV.2.2 | Risikoreaktionen für Schwachstellen planen und umsetzen | Entworfene Änderung und Review |
RV.3.1 | Identifizierte Schwachstellen analysieren, um ihre Grundursachen zu bestimmen | Grundursache und Schwachstellenklasse |
RV.3.2 | Die Grundursachen über die Zeit analysieren, um Muster zu erkennen | Verfolgung der Grundursachen über die Zeit |
RV.3.3 | Die Software auf ähnliche Schwachstellen prüfen, um eine Schwachstellenklasse zu beseitigen | Suche nach demselben Muster an anderer Stelle |
RV.3.4 | Den SDLC-Prozess prüfen und bei Bedarf anpassen, um ein erneutes Auftreten der Grundursache zu verhindern (oder unwahrscheinlicher zu machen) | Korrektur der Bibliothek, der Vorlage oder der Gewohnheit an der Quelle |
Das SSDF verlangt außerdem in PW.7.2, dass Ergebnisse aus Code-Review und Analyse sowie empfohlene Behebungen im Workflow oder Issue-Tracker des Entwicklungsteams festgehalten werden. Ein Pull Request mit angehängten Belegen erfüllt das von vornherein.
CISA KEV und BOD 26-04.
Für Bundesbehörden legt BOD 26-04 die oben beschriebenen Behebungsfristen fest, und der KEV-Status ist einer ihrer vier Faktoren. Für alle anderen ist der KEV-Katalog eine praktische Prioritätenliste: Ist bekannt, dass eine Schwachstelle ausgenutzt wird, kommt sie an die Spitze der Behebungswarteschlange.
OWASP Top 10
.Die OWASP Top 10
liefern ein gemeinsames Vokabular für die Fehlerklassen, mit denen Behebungsworkflows am häufigsten zu tun haben: Fehlerhafte Zugriffskontrolle, Sicherheitsfehlkonfiguration, Fehler in der Softwarelieferkette, Kryptografische Fehler, Injection und weitere.EU Cyber Resilience Act.
Der CRA verankert den Umgang mit Schwachstellen gesetzlich für Produkte mit digitalen Elementen, die in der EU verkauft werden. Ein Behebungsprotokoll, das Befund, Korrektur, Review und Retest zeigt, ist genau die Art von Beleg, die dieser Prozess brauchen wird.
Ein praktisches Beispiel
Stellen Sie sich eine Rechnungs-API vor, die mit Hilfe eines KI-Programmierassistenten gebaut wurde.
Ein autorisierter Pentest stellt fest, dass ein Benutzer die Rechnung eines anderen Kunden herunterladen kann, indem er die ID in der URL ändert:
GET /api/invoices/8812/pdf     (account A, owns invoice 8812)    200 OK
GET /api/invoices/8813/pdf     (account A, invoice of account B) 200 OK
Die zweite Anfrage hätte abgelehnt werden müssen. Der Befund wird unabhängig reproduziert und als validiert markiert, und beide Anfragen und Antworten bleiben als Belege erhalten.
Codekontext.
Die Route führt zu einem einzigen Handler:
@app.get("/api/invoices/<int:invoice_id>/pdf")
@login_required
def invoice_pdf(invoice_id):
    invoice = Invoice.query.get_or_404(invoice_id)
    return render_pdf(invoice)
Die Schwachstellenklasse ist fehlende Autorisierung bei einem vom Benutzer kontrollierten Schlüssel, CWE-639. Der Benutzer ist authentifiziert. Die Eigentümerschaft wird nie geprüft.
Entworfene Änderung.
Der vorgeschlagene Diff ergänzt die fehlende Prüfung an der Stelle, an der das Objekt geladen wird:
 def invoice_pdf(invoice_id):
-    invoice = Invoice.query.get_or_404(invoice_id)
+    invoice = Invoice.query.filter_by(
+        id=invoice_id, account_id=current_user.account_id
+    ).first_or_404()
     return render_pdf(invoice)
Die Rückgabe von 404 statt 403 verhindert außerdem, dass die Existenz der anderen Rechnung bestätigt wird.
Tests.
Zwei Tests gehören zur Änderung. Dabei ist client_a eine Projekt-Fixture: ein Test-Client, der bereits als Benutzer von Konto A angemeldet ist.
def test_owner_can_download_invoice(client_a, invoice_a):
    assert client_a.get(f"/api/invoices/{invoice_a.id}/pdf").status_code == 200

def test_other_account_cannot_download_invoice(client_a, invoice_b):
    assert client_a.get(f"/api/invoices/{invoice_b.id}/pdf").status_code == 404
Der zweite Test schlägt mit dem alten Code fehl und besteht mit dem neuen.
Review und Retest.
Der Pull Request erklärt den Befund, verlinkt die Belege, zeigt Diff und Tests und markiert eine Frage für den Reviewer: Gibt es weitere Rechnungsrouten, etwa für E-Mail oder Export, die Rechnungen auf dieselbe Weise laden?
Der Reviewer prüft das, findet eine weitere Route und verlangt dort dieselbe Korrektur.
Nach Merge und Deployment werden die ursprünglichen Anfragen erneut ausgeführt:
GET /api/invoices/8812/pdf     (account A, owns invoice 8812)    200 OK
GET /api/invoices/8813/pdf     (account A, invoice of account B) 404 Not Found
Der Befund wird mit Nachweisen auf beiden Seiten geschlossen.
Was KI-native Behebung nicht ist
Sie ist kein Agent mit Schreibzugriff auf die Produktion.
Sie ist kein Ersatz für Code-Review.
Sie ist keine Garantie, dass sich jeder Befund automatisch beheben lässt.
Sie ist kein Grund, Tests auszulassen, weil die KI den Code „verstanden“ hat.
Und sie ist kein Grund, Grundursachen nicht mehr zu beheben. Taucht derselbe Fehler jede Woche auf, ist die Antwort eine sicherere Bibliothek oder eine bessere Vorlage, nicht eine schnellere Korrektur.
Wo Plexicus ansetzt
Plexicus ist um einen geschlossenen Kreislauf aufgebaut: validieren, verstehen, beheben und die Korrektur vor dem Merge verifizieren.
Validieren. AI Swarm Pentest erkundet eine autorisierte Anwendung, API oder Codebasis innerhalb eines vereinbarten Scopes. Jeder Befund enthält reproduzierbare Belege, und kann ein zweiter Durchlauf das Ergebnis nicht reproduzieren, wird der Befund als unverifiziert markiert oder verworfen.
Verstehen. Deep Code Analysis verfolgt den betroffenen Codepfad. So sehen Engineers die Endpunkte, Parameter und Geschäftslogik, die ein Befund berührt, sowie die Daten, die er erreichen kann, und die Rolle, die ihn auslösen kann.
Beheben. Plexicus Remediation nimmt einen verifizierten Befund und bereitet den Behebungskontext und eine vorgeschlagene Änderung vor. Betroffener Ablauf, Reichweite, Schwachstellenklasse und Begründung werden in die vorgeschlagene Änderung gebündelt. Der prüfungsfertige Diff erklärt den ursprünglichen Befund inline, und Regressionstests und Hinweise sind enthalten, wo sie relevant sind.
Übergeben. Die Änderung landet in Ihrem bestehenden Repository, mit zugewiesenem Reviewer und einem an die CI angebundenen Retest-Hook, und Ihr Team verifiziert sie vor dem Merge. Plexicus nennt GitHub, GitLab und Bitbucket für Repositories. Ihr Team mergt oder verwirft mit Belegen.
Kontrolle behalten. Plexicus pusht nie in die Produktion, und Ihr Team entscheidet über den Merge. Laut der Seite zu AI Swarm Pentest kommen Vorschläge als Pull Requests oder separate Patch-Dateien.
Plexicus beschreibt vier Arten von Korrekturen, die es vorbereitet: Fehler, die beim Entwickeln mit KI-Programmierwerkzeugen entstehen, klassische Befunde wie SQL Injection und Cross-Site Scripting, Fehler in der Geschäftslogik wie Broken Object Level Authorization sowie Risiken in der Lieferkette wie Abhängigkeiten mit Typosquatting, inklusive Versions-Pinning und Lockfile-Updates.
Das ist Proof-Driven AppSec auf der letzten Meile: ein geschlossener Kreislauf mit PR, in dem jede Änderung die Belege mitführt, aus denen sie entstanden ist.
Wenn Sie noch am Anfang stehen, zeigt unser vollständiger Leitfaden zur Anwendungssicherheit, wo die Behebung in einem modernen AppSec-Programm sitzt, und unsere Einführung in Deep Code Analysis erklärt, warum Codekontext wichtig ist, bevor eine Korrektur entworfen wird. Ein durchgearbeitetes Korrekturmuster finden Sie unter SQL-Injection-Behebung automatisieren.
Häufig gestellte Fragen
Was ist der Unterschied zwischen KI-nativer Behebung und Auto-Remediation?
Auto-Remediation bedeutet oft, eine vordefinierte Aktion automatisch anzuwenden, etwa einen Patch oder eine Konfigurationsänderung. KI-native Behebung entwirft eine Codeänderung für einen bestimmten validierten Befund und übergibt sie einem Menschen zum Review, bevor irgendetwas gemergt wird.
Pusht KI-native Behebung Änderungen in die Produktion?
Das sollte sie nicht. Das Ergebnis ist ein Pull Request oder eine Patch-Datei, die über Ihren normalen Prozess geprüft und gemergt wird. Plexicus gibt an, nie in die Produktion zu pushen.
Kann KI Schwachstellen korrekt beheben?
Manchmal, und die Forschung zeigt, wie man es erkennt. Laut Google hat seine Pipeline mit menschlichem Review 15 % der bei Unit-Tests entdeckten Sanitizer-Bugs behoben. Die OSS-Fuzz-Studie zeigt, dass Patches durch Ausführen des Exploits geprüft werden müssen, nicht danach, wie ähnlich sie einer bekannten Korrektur sehen.
Warum mit validierten Befunden statt mit Scanner-Ausgaben beginnen?
Weil jeder nicht validierte Befund, der zum Pull Request wird, Review-Zeit kostet und womöglich nichts behebt. Durch die Validierung verdient jede Änderung die Aufmerksamkeit eines Reviewers.
Welche Tests sollten zu einer Sicherheitskorrektur gehören?
Mindestens ein Test, der mit dem alten Code fehlschlägt und mit dem neuen besteht, plus ein Test, der bestätigt, dass legitime Nutzung weiter funktioniert. Testen Sie bei Fehlern in der Zugriffskontrolle sowohl den Eigentümer als auch ein anderes Konto.
Ersetzt KI-native Behebung Entwickler oder Security Engineers?
Nein. Sie übernimmt die repetitiven Teile: reproduzieren, lokalisieren, entwerfen und testen. Menschen entscheiden weiterhin, was das korrekte Verhalten ist und ob die Änderung gemergt wird.
Welche Schwachstellen sind gute Kandidaten?
Fehler mit lokalen, gut verstandenen Korrekturmustern, etwa Injection, fehlende Eigentümerprüfungen und verwundbare Abhängigkeitsversionen. Architekturfehler brauchen meist einen Plan, keinen automatisierten Diff.
Wie hängt das mit dem NIST SSDF zusammen?
Die SSDF-Praktiken unter Respond to Vulnerabilities verlangen, jede Schwachstelle zu analysieren, eine Reaktion umzusetzen, Grundursachen zu finden und an anderer Stelle nach demselben Fehler zu suchen. Ein KI-nativer Behebungsworkflow ist eine Möglichkeit, diese Aufgaben bei höherem Volumen zu erfüllen.
Wie messen Sie, ob es funktioniert?
Zählen Sie die Befunde, die mit bestandenem Retest geschlossen wurden, und die Zeit von der Validierung bis zum Merge. Die Zahl geöffneter Pull Requests allein ist kein nützliches Maß.
Kann sie Code beheben, den KI-Programmierassistenten geschrieben haben?
Ja, und gerade dieser Code braucht es oft. Generierter Code kann klassische Fehler enthalten und ohne Tests ankommen, daher sollte die Korrektur Tests ergänzen und den Code ändern.
Den Kreislauf mit Belegen schließen
Jede Korrektur sollte belegen, dass der Befund echt war, zeigen, warum die Änderung wirkt, und zeigen, dass der Angriff gestoppt ist.
Plexicus Remediation entdecken →
Sie möchten einen ersten Blick auf Ihren eigenen Code werfen? Nutzen Sie das kostenlose SAST-Tool, einen statischen Scan Ihres GitHub-Quellcodes.