Was ist Deep Code Analysis? SAST-False-Positives mit Erreichbarkeitsanalyse reduzieren
SAST-False-Positives verdecken echte Bugs, und ein LLM-Wrapper ändert daran nichts. Deep Code Analysis beweist per Erreichbarkeitsanalyse, welche Findings real und erreichbar sind.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
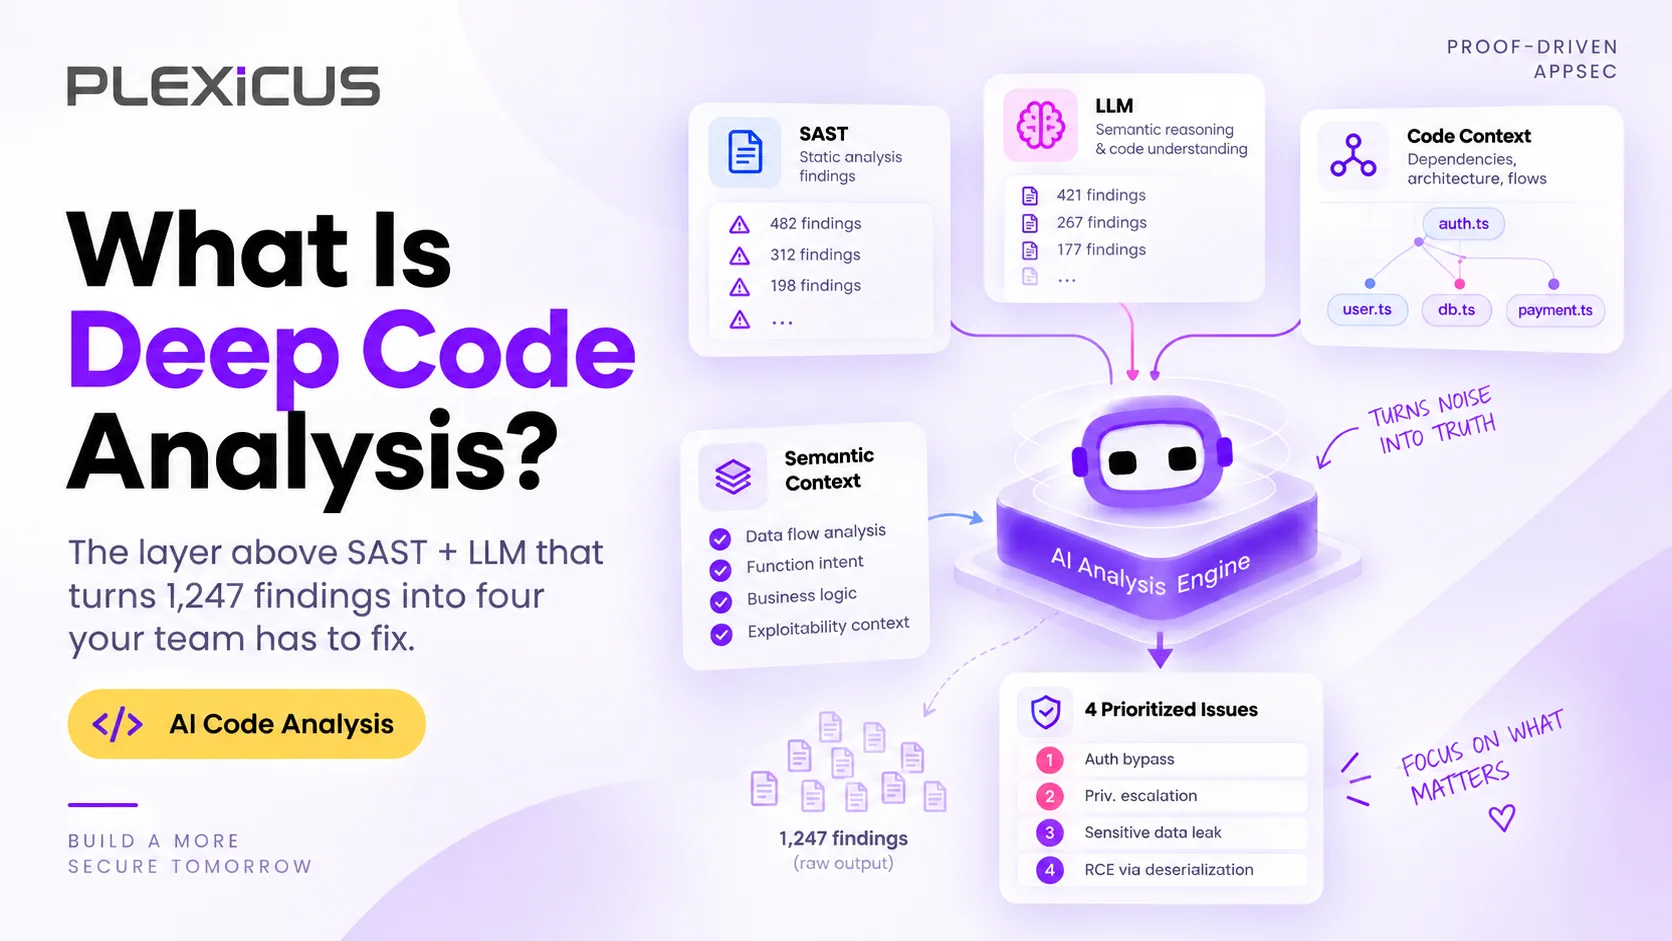
AI Swarm Pentest ansehenDeep Code Analysis reduziert SAST-False-Positives an der Quelle: Sie baut ein strukturelles Modell Ihrer Anwendung, bindet per Erreichbarkeitsanalyse jedes Finding an einen realen Pfad von einem exponierten Endpunkt zu einer verwundbaren Senke und spielt diesen Pfad erneut ab, bevor jemand triagiert. Musterbasiertes SAST zeigt Ihnen, was gefährlich aussieht; die Erreichbarkeitsanalyse zeigt, was ein Angreifer tatsächlich treffen kann.
Wenn Sie jemals ein SAST-Dashboard geöffnet, zum Ende einer 12.000-zeiligen CSV gescrollt und gedacht haben “Ich werde das alles nie triagieren”, verstehen Sie bereits das Problem, für dessen Lösung Deep Code Analysis gebaut wurde. Sie verstehen auch, warum es nicht reicht, ein Large Language Model auf dieselbe Regex-Engine zu setzen.
Dieser Leitfaden erklärt, was Deep Code Analysis tatsächlich ist, warum SAST plus LLM-Wrapper Sie immer noch mit Tausenden nicht behebbaren Findings zurücklässt, und was sich ändert, wenn Sie eine strukturelle Schicht vor Ihre Scanner setzen. Wenn Sie den Unterschied zwischen SAST und DAST und die Rolle von SCA bereits kennen, springen Sie zu dem Abschnitt, der beschreibt, wie die Schicht darüber aussieht.
Die Kurzfassung
Deep Code Analysis ist die Praxis, ein strukturelles Modell der Hosts, Endpunkte, Parameter und Fähigkeiten Ihrer Anwendung aufzubauen und dann jedes Sicherheits-Finding an einen konkreten Punkt in diesem Modell zu binden. Ein Finding ohne Erreichbarkeitspfad, Fähigkeitsklasse und Zeilennummer ist kein Finding. Es ist Rauschen.
Das unterscheidet die Praxis von Legacy-SAST und von den “SAST + LLM”-Wrapper-Produkten, die 2024–2025 den Markt fluteten. Beide sind im Kern Pattern-Matcher. Der eine nutzt Regex. Der andere nutzt einen Transformer, der die Regex-Ausgabe in besserem Englisch zusammenfasst.
Keiner von beiden beantwortet die einzige Frage, die Ihrem Security-Team wichtig ist:
Von den Tausenden von Schwachstellen, die mein Scanner gerade gefunden hat, welche wenigen kann ein Angreifer tatsächlich gegen den Produktionscode ausnutzen, den wir letzten Dienstag ausgeliefert haben?
Deep Code Analysis beantwortet diese Frage. Alles andere ist Klempnerei.
Warum SAST-False-Positives entstehen
SAST — Static Application Security Testing — ist seit Anfang der 2000er das Arbeitspferd der Anwendungssicherheit. Die Kategorie hat sich ihren Platz verdient. Aber die Engines haben sich nicht viel verändert. Die meisten funktionieren immer noch so:
- Sie parsen die Quelldatei.
- Sie wenden eine Reihe von regulären Ausdrücken oder AST-Besuchern an, die nach bekanntermaßen schlechten Mustern suchen (
eval,innerHTML,string.format, hartcodierte Anmeldedaten, schwache Kryptografie und einige hundert weitere). - Sie emittieren ein Finding mit CVSS-Score, CWE, Dateipfad und Zeilennummer.
Dieses Modell erzeugt Rauschen in einem Ausmaß, das die Forschung wiederholt gemessen hat. Eine ISSTA-2024-Studie zu fünf SAST-Tools mit 815 realen schwachstellenverursachenden Commits ergab, dass mindestens 76 % der Warnungen in verwundbaren Funktionen für die Schwachstelle irrelevant waren, während 22 % der Schwachstellen unentdeckt blieben. Ein ICSE-2022-Paper zur Erkennung von SAST-Fehlalarmen beginnt mit derselben Feststellung: Die große Zahl an Fehlalarmen ist eine Hürde für die Einführung. Genau deshalb gibt es Projekte wie den OWASP Benchmark und NISTs Static Analysis Tool Exposition (SATE): Sie messen, wie genau Tools echte, ausnutzbare Fehler von Rauschen trennen.
Hinter diesen Zahlen stehen drei strukturelle Probleme, die keine noch so “KI-erweiterte” Hülle übertünchen kann.
Problem 1 — Pattern-Matcher lesen keinen Code
Eine Regex sieht eval(input) und markiert es. Sie sieht nicht, dass input bereits zwei Funktionen weiter oben in der Aufrufkette bereinigt wurde. Sie sieht nicht, dass dieser konkrete Zweig nur von einem Konfigurationsendpunkt aus erreichbar ist, der an localhost gebunden ist. Sie sieht nicht die Guard-Klausel, die Ihr Senior-Engineer vor sechs Monaten hinzugefügt hat.
Das Ergebnis: Die meisten SAST-Findings sind unerreichbar, niedrig in der Auswirkung oder bereits mitigiert — genau das ist ein SAST-False-Positive in der Praxis meist. Die interessanten Fehler — Broken Object Level Authorization, fehlende Rate Limits, ein Business-Logic-Fehler im neuen Stripe-Webhook — sind genau die, die die Regex nicht trifft. Autorisierungsfehler waren die größte Klasse in unserem Scan von 14.213 KI-gestützten Pull Requests (Englisch).
Problem 2 — Es gibt keine Erreichbarkeitsanalyse
Ein Finding auf Zeile 117 von src/routes/users.js ist bedeutungslos, ohne zu wissen, wie Nutzereingaben dorthin gelangen, was sie tun, wenn sie ankommen, und ob die Route überhaupt exponiert ist.
Legacy-SAST stoppt am Call-Site. Es kann Ihnen nicht sagen:
- Welche HTTP-Route diese Funktion bedient
- Ob die Route öffentlich oder nur hinter einem VPN exponiert ist
- Ob die Authentifizierung vor dem Call-Site läuft
- Ob der Eingabeparameter tatsächlich vom Nutzer kontrolliert wird
- Ob der Datensenke, die er erreicht (eine Datenbank, eine Shell, eine Datei), von diesem konkreten Einstiegspunkt ausnutzbar ist
Sie bekommen ein Finding. Sie bekommen keinen Pfad.
Problem 3 — Es gibt kein Fähigkeitsmodell
Eine Datei zu lesen ist nicht dasselbe wie Identitätserlangung. Netzwerk-Reach ist nicht dasselbe wie Code-Ausführung. Eine parametrisierte Abfrage zu erreichen ist nicht dasselbe wie eine nicht bereinigte zu erreichen.
Legacy-SAST kollabiert diese Unterscheidungen in einen einzigen Schweregrad-Score. Es behandelt jedes readFile gleich, unabhängig davon, ob die Datei ein statisches Asset oder ein privater Schlüssel ist. Das macht die Prioritätenliste nutzlos.
Was das Aufsetzen eines LLMs auf SAST nicht behoben hat
2024 war die offensichtliche Antwort auf das SAST-Rauschen, ein Large Language Model hinzuzufügen. Den Scanner in einen Agent einwickeln. Das Modell den Befund zusammenfassen, einen Patch vorschlagen oder die Findings nach “realer Ausnutzbarkeit” ordnen lassen.
Das half bei einer Sache: Die Wand aus CSV-Text wurde zu einer Wand aus lesbaren Zusammenfassungen. Es löste keines der drei strukturellen Probleme oben. Es machte sie nur lesbarer.
Machine-Learning-Filter für SAST-Alarme stoßen in der Forschung an eine ähnliche Grenze: Die oben genannte ICSE-2022-Studie zeigte, dass frühere, nahezu perfekte Ergebnisse bei der ML-basierten Fehlalarmerkennung durch Mängel in der Evaluation überhöht waren.
Die harten Grenzen bleiben:
- LLMs führen Code nicht zuverlässig aus. Wenn ein LLM ein Snippet “reviewt”, pattern-matcht es auf Tokens. Es führt das Programm nicht aus. Es kann nicht beweisen, dass das Snippet erreichbar ist, nur dass es aussieht wie die Art von Snippet, die es oft ist.
- LLMs halluzinieren Korrekturen. Wenn ein LLM gebeten wird, eine Schwachstelle zu patchen, schreibt es die Call-Site manchmal so um, dass sie kompiliert, aber nicht mehr der ursprünglichen Geschäftslogik entspricht. Ein menschlicher Reviewer muss das erkennen. Die meisten Teams können nicht jeden KI-vorgeschlagenen Patch reviewen.
- LLMs erben SASTs blinde Flecken. Wenn der zugrundeliegende Scanner die Broken Object Level Authorization nicht sieht, wird keine Menge nachträglicher Zusammenfassung sie hervorbringen.
Das Ergebnis der “SAST + LLM”-Welle war ein überzeugenderes, polierteres und immer noch unbegründetes Signal. Der Auditor kann das Finding immer noch nicht erneut ausführen. Der Entwickler weiß immer noch nicht, ob er dem vorgeschlagenen Patch vertrauen soll. Der CISO bekommt immer noch ein Dashboard voller grüner Häkchen, die in der Produktion nichts bedeuten.
Das erzeugte die Nachfrage nach Deep Code Analysis als Kategorie.
Was Deep Code Analysis tatsächlich ist
Deep Code Analysis hat einen anderen Ausgangspunkt. Statt “scan die Datei auf schlechte Muster” lautet die Frage “was ist diese Anwendung, von oben bis unten, und was kann was erreichen?”.
Konkret hat die Praxis vier Verschiebungen:
1. Aufbau eines strukturellen Modells der Anwendung
Die erste Passage geht die gesamte Codebasis (und das IaC, das die Runtime definiert) durch und erzeugt ein strukturelles Modell der Anwendung:
- Hosts — Dienste, serverlose Funktionen, Drittanbieter-APIs
- Endpunkte — HTTP-Routen, gRPC-Methoden, Message-Queue-Handler
- Parameter — jede Eingabe, die eine Endpunktgrenze überschreitet
- Fähigkeiten — was jeder Knoten lesen, schreiben, ausführen, exfiltrieren oder eskalieren kann
Das Modell ist die Quelle der Wahrheit. Findings sind Positionen darin, nicht Zeilen in einer Datei.
2. Bindung jedes Findings an einen Pfad per Erreichbarkeitsanalyse
Wenn die Engine ein Finding vorschlägt (ob aus einem Pattern, einem erlernten Modell oder einer von Menschen verfassten Regel), muss sie Folgendes anhängen:
- Den Erreichbarkeitspfad — Endpunkt, Parameter, Handler, Senke
- Die Fähigkeitsklasse — Lesen, Schreiben, Impersonation, RCE, Exfiltration
- Die Zeilennummer — für den menschlichen Reviewer
Ein Finding ohne alle drei wird verworfen. Das ist das Gegenteil von Legacy-SAST, das ein Finding emittiert, sobald es ein Pattern trifft, und die Pfadentdeckung dem Menschen überlässt.
3. Erreichbarkeit mit einer unabhängigen Passage verifizieren
Das ist der entscheidende Unterschied. Die Engine, die ein Finding vorschlägt, ist nicht dieselbe, die es bestätigt. Eine zweite Passage spielt den vorgeschlagenen Exploit gegen eine in einer Sandbox isolierte Kopie des Ziels erneut ab. Nur Findings, die sich reproduzieren lassen, werden behalten.
Es ist dieselbe Logik wie die wissenschaftliche Methode. Eine Behauptung ist kein Finding, bis sie einen unabhängigen Test überlebt.
4. Dem Engineer ein reproduzierbares Artefakt übergeben
Jedes überlebende Finding wird mit Evidenz ausgeliefert, die ein Auditor ausführen kann, ein Entwickler ausführen kann und ein CI-Gate ausführen kann. Eine Anfrage, ein Skript oder ein Sandbox-Zustand.
Wenn ein Finding nicht reproduziert werden kann, ist es kein Finding.
Die Audit-Spur, die ein Auditor tatsächlich lesen kann
Die Ausgabe von Deep Code Analysis ist für die Leute strukturiert, die die Arbeit nachgelagert verteidigen müssen. Für jedes Finding enthält der Bericht:
| Feld | Was es dem Auditor sagt |
|---|---|
| Graphknoten | Welcher Host, Endpunkt, Parameter |
| Erreichbarkeitspfad | Die vollständige Kette von Anfrage zu Senke |
| Fähigkeitsklasse | Lesen, Schreiben, Impersonation, RCE, Exfiltration |
| Verifiziert durch | Welche unabhängige Passage es reproduziert hat |
| Evidenzreferenz | Die Anfrage, der Job oder der Sandbox-Zustand zur erneuten Ausführung |
| Zeilen | Genauer Dateipfad und Zeilennummer |
| Tainted via | Wie die Nutzereingabe durch das System fließt |
Ein Auditor, der das liest, kann das Finding erneut ausführen, die Trace prüfen und die Schwere bestätigen. Er muss nicht auf das Wort des Anbieters vertrauen.
Warum die reinen LLM-Tools nicht aufholen können
Die Versuchung ist, anzunehmen, dass der “SAST + LLM”-Wrapper mit besseren Foundation-Modellen irgendwann gleichwertig zu Deep Code Analysis wird. Wird er nicht, aus drei Gründen:
- LLMs bauen keine strukturellen Modelle. Sie konsumieren sie als Eingabe. Ohne den vorgelagerten Schritt des Modellaufbaus fasst das LLM flachen Text zusammen und erfindet den Pfad zwischen zwei Knoten.
- LLMs können ihre eigenen Findings nicht verifizieren. Der Verifikationsschritt erfordert, tatsächlich Code gegen das Ziel auszuführen. LLMs können Code nicht zuverlässig ausführen, und ihre Selbstkonsistenzprüfungen sind schwächer als eine unabhängige Reproduktions-Passage.
- LLMs halluzinieren die Geschäftslogik. Ein LLM weiß nicht, dass
/api/users/:iddie Eigentümerschaft am Datensatz erzwingen soll, bevor es ihn zurückgibt. Das strukturelle Modell kodiert diese Einschränkung auf Endpunktebene. Das Sprachmodell kann sie nicht aus Token-Statistiken ableiten.
Deep Code Analysis ersetzt das LLM nicht. Sie gibt dem LLM die strukturierte Eingabe, die es braucht, um nützlich zu sein — und sie gibt dem Engineer die Wahrheit, die er braucht, um den Vorschlägen des Modells zu vertrauen.
Wie Deep Code Analysis mit AI Swarm Pentest zusammenspielt
Bei Plexicus ist Deep Code Analysis die erste Hälfte der Schleife. AI Swarm Pentest ist die zweite. Zusammen sehen sie so aus:
- Deep Code Analysis baut das strukturelle Modell auf und schlägt Findings vor.
- AI Swarm Pentest sondiert jedes vorgeschlagene Finding innerhalb des vereinbarten Scopes.
- Eine unabhängige Passage spielt den ursprünglichen Exploit gegen den vorgeschlagenen Patch erneut ab und fordert Evidenz.
- Nur Findings, die beide Passagen überleben — vorschlagen und verifizieren — landen im Bericht.
Was überlebt, ist klein, präzise und reproduzierbar. Ihr Team behebt eine Handvoll Dinge, statt Tausende zu triagieren. Ihr Auditor spielt eine Handvoll Reproduktionen erneut ab, statt ein 90-seitiges PDF zu lesen. Was danach mit diesen Findings passiert, beschreibt das Playbook zur autonomen Remediation (Englisch).
Das ist die Messlatte. Alles andere ist Rauschen.
Die praktische Frage: Ist das nur Marketing?
Die ehrliche Antwort ist: Vor einem Jahr war es teilweise Marketing. Die Kategorie hatte keinen Namen, die Produkte, die behaupteten, es zu tun, wickelten Regex-Engines in LLM-Zusammenfassungen ein, und der Beweis für “tief” war ein längeres PDF.
2026 ist die Praxis auf vier operative Signale konvergiert:
- Das Werkzeug kann “ist das erreichbar?” mit einem Pfad beantworten, nicht mit einer Vermutung. Wenn Ihr aktueller Scanner das nicht kann, macht er keine Deep Code Analysis.
- Das Werkzeug kann “was ist die Fähigkeitsklasse?” mit einer echten Taxonomie beantworten. Nicht CVSS. Nicht “hoch/mittel/niedrig”. Eine Fähigkeit.
- Das Werkzeug kann ein reproduzierbares Artefakt für jedes überlebende Finding erzeugen. Ausführbar von einem Auditor, einem CI-Gate und einem Entwickler.
- Das Werkzeug kombiniert Vorschlagen und Verifizieren. Wer das Finding vorschlägt, ist nicht dasselbe wie das, was es bestätigt.
Wenn Sie Anbieter vergleichen, wenden Sie diese vier Prüfungen auf jede Shortlist an, auch auf die Tools in unserem Überblick über SAST-Tools für sichere Entwicklung. Wenn Ihr aktueller Stack alle vier erfüllt, haben Sie bereits Deep Code Analysis — egal wie der Anbieter es nennt. Wenn er drei erfüllt, sind Sie nahe dran. Wenn er zwei oder weniger erfüllt, haben Sie ein SAST-Dashboard mit besserem Marketingtext.
Wo Sie anfangen
Wenn Sie den Unterschied sehen wollen, brauchen Sie keine sechsmonatige Evaluierung. Wählen Sie ein Repository, einen Branch, einen produktionsähnlichen Build. Führen Sie Ihren aktuellen Scanner aus. Zählen Sie die Findings. Führen Sie dann eine Deep Code Analysis-Passage gegen dasselbe Ziel aus. Zählen Sie die Findings, die eine unabhängige Reproduktion überleben.
Der Abstand zwischen diesen beiden Zahlen ist das Budget, das Sie für Triage ausgegeben haben, die nie hätte stattfinden müssen.
Häufig gestellte Fragen
Was verursacht SAST-False-Positives?
Die meisten SAST-False-Positives entstehen durch Mustererkennung ohne Kontext. Das Tool markiert einen riskant aussehenden Aufruf wie eval oder eine zusammengesetzte Query, ohne zu prüfen, ob Benutzereingaben ihn erreichen, ob sie vorher bereinigt werden oder ob die Route überhaupt exponiert ist. Eine ISSTA-2024-Studie ergab, dass mindestens 76 % der SAST-Warnungen in verwundbaren Funktionen für die eigentliche Schwachstelle irrelevant waren.
Was ist Erreichbarkeitsanalyse in der Anwendungssicherheit?
Die Erreichbarkeitsanalyse bestimmt, ob angreiferkontrollierte Eingaben tatsächlich von einem exponierten Einstiegspunkt wie einer HTTP-Route oder einem Message-Handler zu einer verwundbaren Senke gelangen, etwa einer Datenbankabfrage, einem Shell-Aufruf oder einem Dateizugriff. Ein Finding mit erreichbarem Pfad ist prinzipiell ausnutzbar; eines ohne Pfad ist meist Rauschen und kann herabgestuft oder verworfen werden.
Wie reduziert man SAST-False-Positives?
Regeln feinjustieren und bekanntes Rauschen unterdrücken hilft, aber die dauerhafte Lösung ist, für jedes Finding Kontext zu verlangen: einen Erreichbarkeitspfad vom Einstiegspunkt zur Senke, eine Fähigkeitsklasse, die beschreibt, was der Angreifer gewinnt, und eine unabhängige Reproduktion. Findings, die diese Prüfungen nicht bestehen, werden verworfen, bevor sie in der Queue eines Entwicklers landen.
Kann ein LLM SAST-False-Positives beheben?
Nur teilweise. Ein LLM kann SAST-Ausgaben zusammenfassen und priorisieren, führt aber keinen Code aus. Es kann also nicht beweisen, dass ein Finding erreichbar ist, und übernimmt die blinden Flecken des zugrunde liegenden Scanners. LLMs funktionieren am besten, wenn sie ein strukturelles Modell der Anwendung erhalten und ihre Schlüsse durch eine unabhängige Reproduktion geprüft werden.
Ersetzt Deep Code Analysis SAST?
Nein. Deep Code Analysis sitzt über SAST, DAST und SCA. Scanner und Regeln können weiterhin Findings vorschlagen; Deep Code Analysis baut das strukturelle Modell der Anwendung, bindet jedes Finding an einen Erreichbarkeitspfad und eine Fähigkeitsklasse und behält nur Findings, die ein unabhängiger Durchlauf reproduzieren kann. Das Ergebnis ist eine deutlich kürzere, überprüfbare Liste für Engineers und Auditoren.
Weiterführende Lektüre:
- Deep Code Analysis — Produktseite
- 78 % der KI-generierten PRs enthalten eine Schwachstelle — wie die tatsächliche Fehlerrate in der Produktion aussieht
- Das autonome Remediation-Playbook — was passiert, nachdem ein Finding die Reproduktion überlebt hat