AI Swarm Pentest: Vom einzelnen KI-Pentester zum orchestrierten Team aus Angriffsagenten
Wie spezialisierte Angriffsagenten Kontext teilen, Hypothesen hinterfragen und Angriffswege im Proof-Driven-AppSec-Workflow von Plexicus unabhängig überprüfen.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
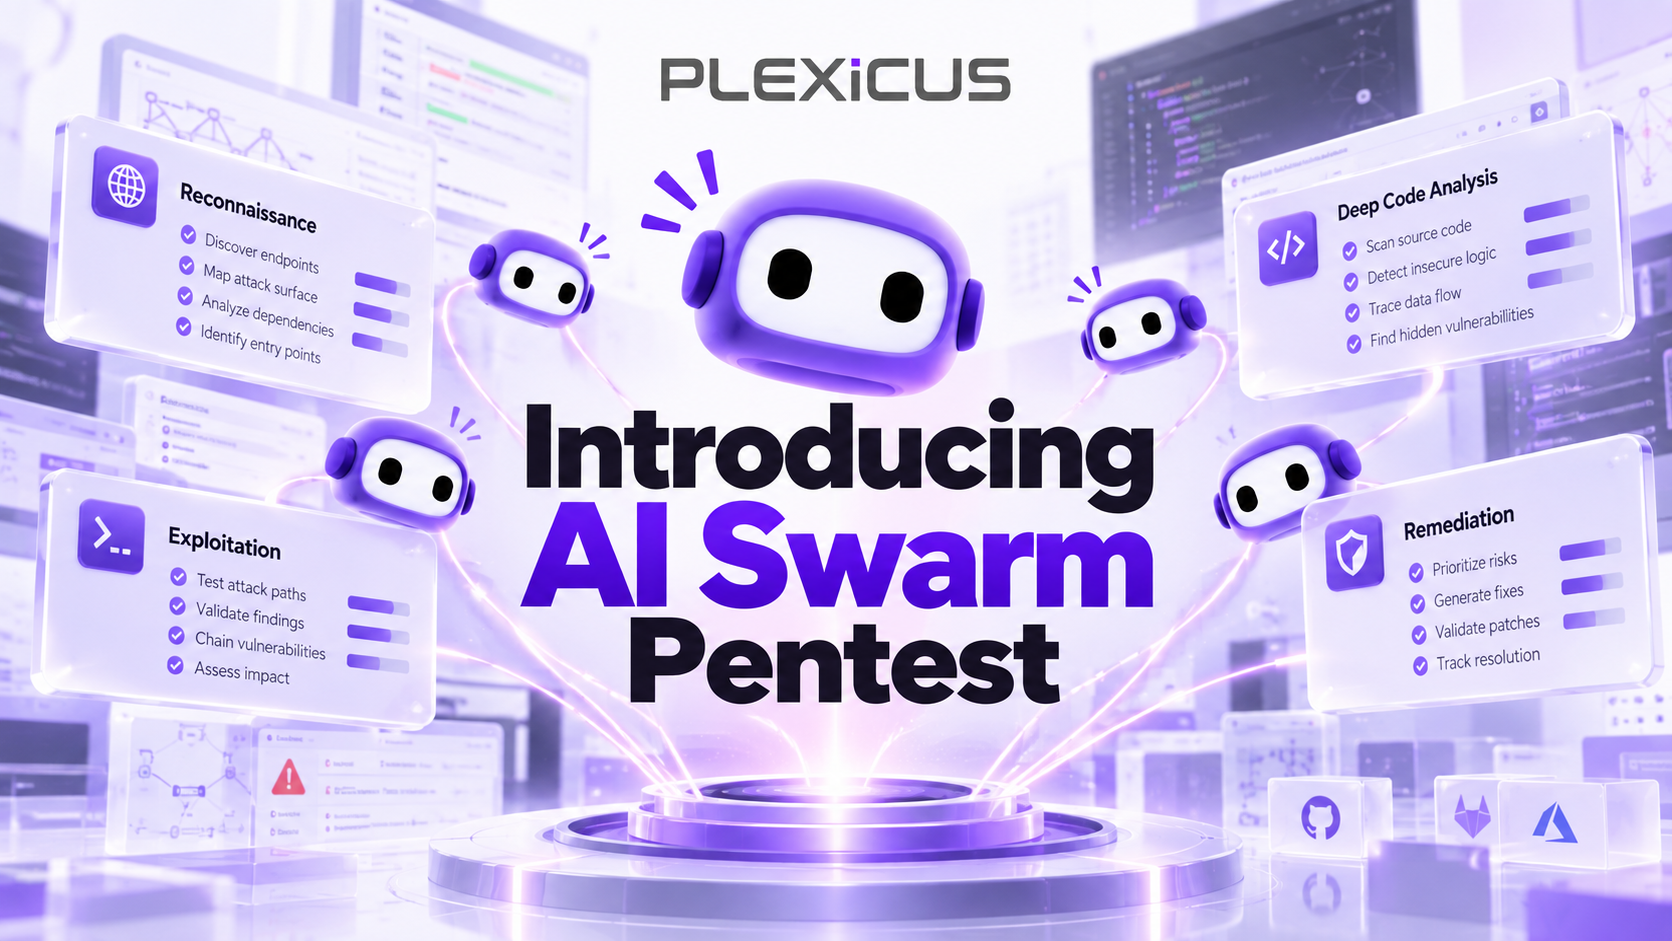
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenDie Softwareentwicklung wird zunehmend agentisch.
KI-Systeme können heute Code generieren, prüfen, refaktorieren, testen und bereitstellen. Anwendungen verändern sich schneller, APIs werden zahlreicher, und Sicherheitsteams sollen mehr Software validieren, ohne dass ihre Teams proportional wachsen.
Aus demselben Grund beginnt sich auch das Penetration Testing zu verändern.
Die erste Welle von KI-Sicherheitstools half Menschen vor allem dabei, schneller zu arbeiten: eine Schwachstelle erklären, einen Payload erzeugen, Scanner-Ausgaben zusammenfassen oder den nächsten Pentest-Schritt vorschlagen.
Die nächste Welle wurde autonomer. Statt auf jeden einzelnen Befehl eines Menschen zu warten, konnte ein KI-Agent eine Anwendung erkunden, mit Endpunkten interagieren, Hypothesen testen, Antworten analysieren und entscheiden, was als Nächstes zu versuchen ist.
Doch Autonomie schafft ein weiteres Problem:
Ein Penetrationstest ist keine einzelne Aufgabe.
Er besteht aus einer langen Kette von Entscheidungen.
Ein Angreifer muss vielleicht erst einen Endpunkt entdecken, die Authentifizierung verstehen, eine Objektreferenz finden, Berechtigungsgrenzen testen, zusätzlichen Kontext gewinnen, mehrere Payload-Varianten ausprobieren, das Ergebnis mit einer weiteren Schwachstelle verknüpfen und schließlich nachweisen, dass der vollständige Angriffsweg tatsächlich funktioniert.
Genau hier setzt AI Swarm Pentest an.
AI Swarm Pentest behandelt Penetrationstests nicht als ein langes Gespräch zwischen einem Modell und einem Ziel. Stattdessen versteht es den Test als orchestrierte Sicherheitsuntersuchung, in der spezialisierte Fähigkeiten erkunden, Schlussfolgerungen ziehen, Kontext teilen, die Arbeit der anderen überprüfen und Angriffshypothesen in Belege verwandeln.
Das Ziel lautet nicht einfach:
Mehr Schwachstellen finden.
Die nützlichere Frage ist:
Welche Angriffswege sind real, was kann ein Angreifer tatsächlich erreichen, und welche Belege braucht das Engineering-Team, um zu handeln?
Dieser Unterschied steht im Zentrum von Plexicus AI Swarm Pentest. Plexicus beschreibt AI Swarm Pentest als Verfahren zur Validierung ausnutzbarer Angriffswege über autorisierte Anwendungen, APIs und Quellcode hinweg – mit unterstützenden Belegen und unabhängiger Überprüfung, bevor ein Befund als verifiziert präsentiert wird.
Motion-Graphic zu AI Swarm Pentest auf YouTube ansehen.
Zunächst: Was bedeutet „KI-Pentesting“ eigentlich?
Für KI-gestützte Penetrationstests gibt es keine allgemeingültige Definition.
Ein Schwachstellenscanner mit einer von einem LLM erzeugten Erklärung kann als KI-Sicherheit vermarktet werden.
Auch ein Pentester, der Claude oder ein anderes Modell als Copiloten nutzt, kann seinen Workflow als KI-Pentesting bezeichnen.
Am anderen Ende des Spektrums können autonome Systeme mit Anwendungen interagieren, Werkzeuge auswählen, Payloads erzeugen, Antworten analysieren, ihre Strategie ändern, Schwachstellen ausnutzen und mit begrenztem menschlichem Eingreifen Belege erstellen.
Diese Systeme sind nicht gleichwertig.
Auch Anbieter autonomer Pentesting-Plattformen erkennen diesen Unterschied an. XBOW beschreibt KI-Pentesting beispielsweise als Spektrum, das ein LLM mit einem Scanner, menschlich geführte und durch KI unterstützte Tests sowie autonome Systeme mit koordinierten spezialisierten Agenten umfassen kann.
Bevor wir über AI Swarm Pentest sprechen, sollten wir daher vier Konzepte unterscheiden.
| Ansatz | Hauptentscheidungsträger | Typisches Verhalten | Hauptergebnis |
|---|---|---|---|
| Traditioneller DAST / Scanner | Regeln und Signaturen | Sendet vorgegebene Prüfungen und gleicht sie mit bekannten Mustern ab | Mögliche Schwachstellen |
| KI-unterstütztes Pentesting | Menschlicher Pentester | KI erklärt, empfiehlt, schreibt Befehle oder analysiert Ergebnisse | Vom Menschen validierte Befunde |
| Autonomes KI-Pentesting | KI-Agent oder Agentensystem | Erkundet Ziele, wählt Aktionen und passt sich an Ergebnisse an | Autonome Befunde und Angriffsbelege |
| AI Swarm Pentesting | Orchestriertes Agentensystem | Mehrere Fähigkeiten erkunden, korrelieren, Kontext teilen, Hypothesen hinterfragen und Angriffswege überprüfen | Verifizierte Angriffswege mit Belegen |
Die Grenzen sind nicht absolut.
Eine ausgereifte autonome Pentesting-Plattform kann intern bereits mehrere Agenten einsetzen. Deshalb sollte „Swarm“ nicht einfach als „mehr als ein KI-Agent“ verstanden werden.
Der entscheidende Unterschied liegt in der Organisation der Agenten.
Was ist AI Swarm Pentest?
AI Swarm Pentest ist ein agentischer Ansatz für Penetrationstests, bei dem spezialisierte Sicherheitsfähigkeiten als orchestriertes System arbeiten, statt den gesamten Einsatz nacheinander einem einzigen universell einsetzbaren KI-Agenten zu überlassen.
Stellen Sie sich den Unterschied vor, ob ein sehr guter Security Engineer allein eine Anwendung untersucht oder ob ein koordiniertes Sicherheitsteam denselben Auftrag erhält.
Eine Person könnte die Angriffsfläche erfassen.
Eine andere konzentriert sich auf die Authentifizierung.
Eine weitere untersucht die Autorisierung.
Eine andere prüft APIs.
Jemand anderes versucht, ein interessantes Verhalten in einen reproduzierbaren Exploit zu verwandeln.
Und eine weitere Person versucht unabhängig, den Befund nachzustellen, bevor das Team ihn meldet.
Entscheidend ist nicht bloß, dass mehrere Personen arbeiten.
Sie brauchen ein gemeinsames Verständnis des Ziels.
Entdeckt ein Agent, dass
/api/invoices/{id}
nach der Authentifizierung erreichbar ist, sollte ein anderer Agent nicht zwingend alles von Grund auf neu entdecken müssen.
Stellt der erste Agent außerdem fest, dass Rechnungs-IDs fortlaufend vergeben werden, kann die Autorisierungsprüfung diese Information als neue Hypothese nutzen.
Wird bei einer weiteren Aktion eine Mandantenkennung sichtbar, kann diese Beobachtung auch an anderer Stelle relevant werden.
So wird der Pentest zu einem sich ständig weiterentwickelnden Angriffsgraphen statt zu einer Sammlung isolierter Prompts.
Die Beschreibung des für den 15. Oktober 2026 angekündigten APIAddicts-Vortrags von José Ramón Palanco stellt spezialisierte Skills, MCP und ein graphorientiertes Angriffsgedächtnis als Ansatz vor. Es handelt sich um eine für den Vortrag vorgeschlagene Proof-of-Concept-Architektur.
Das ist eine deutlich bessere Analogie zu einem echten Offensive-Security-Einsatz als:
Prompt → KI → Schwachstellenbericht.
Warum ein einzelner KI-Agent nicht immer ausreicht
Große Sprachmodelle sind erstaunlich leistungsfähige Assistenten für Sicherheitsaufgaben.
Doch Penetrationstests legen mehrere ihrer Schwächen gleichzeitig offen.
Ein Pentest ist:
lang laufend,
zustandsbehaftet,
werkzeugintensiv,
ungewiss,
konfrontativ
und auf Belege angewiesen, die über viele frühere Aktionen hinweg gesammelt wurden.
Die PentestGPT-Studie dokumentierte dieses Problem früh. Die Forschenden stellten fest, dass LLMs bei einzelnen Pentest-Teilaufgaben wie der Bedienung von Tools, der Interpretation von Ausgaben und dem Vorschlagen weiterer Aktionen hilfreich sind. Ein zusammenhängendes Verständnis des gesamten Einsatzes aufrechtzuerhalten, blieb jedoch schwierig. Deshalb teilte PentestGPT die Verantwortlichkeiten in miteinander interagierende Module auf, statt eine einzige Modellinstanz mit allem zu beauftragen.
Spätere Forschung identifizierte weiterhin Herausforderungen bei Enumeration, Ausnutzung, Rechteausweitung, Kontextverwaltung und autonomem Schlussfolgern über den gesamten Ablauf.
Neuere Forschung zu Multi-Agent-Systemen weist in dieselbe Richtung.
Das Forschungssystem ARTEMIS nutzt beispielsweise dynamische Subagenten und eine automatisierte Schwachstellen-Triage. In einer Untersuchung eines realen Universitätsnetzwerks berichteten die Forschenden von Vorteilen bei systematischer Enumeration und paralleler Ausnutzung. Zugleich beobachteten sie wichtige Einschränkungen, darunter False Positives und Schwierigkeiten bei manchen GUI-lastigen Arbeitsabläufen. Diese Ergebnisse sind im Rahmen der Ziele, Bewertungsregeln und des Budgets dieser Studie zu beurteilen.
Die Lehre lautet nicht: „Mehrere Agenten lösen Pentests automatisch.“
Das tun sie nicht.
Die Lehre ist, dass komplexe Offensive-Security-Arbeit davon profitiert, Verantwortlichkeiten aufzuteilen und zugleich einen gemeinsamen Zustand sowie Überprüfung beizubehalten.
Vom Einzelagenten zum Swarm
Ein vereinfachter autonomer KI-Pentester könnte so aussehen:
Ziel
  ↓
KI-Agent
  ↓
Aufklärung
  ↓
Hypothese
  ↓
Exploit
  ↓
Bericht
Das kann erstaunlich gut funktionieren.
Doch alles hängt davon ab, dass derselbe Schlussfolgerungsprozess den Kontext bewahrt, Prioritäten setzt, Werkzeuge bedient, Tool-Ausgaben verarbeitet, Sackgassen vermeidet, Ergebnisse validiert und den Einsatz dokumentiert.
Eine Swarm-orientierte Architektur sieht konzeptionell anders aus:
                         ┌────────────────────┐
                         │ Autorisierter Scope│
                         │ + Einsatzregeln    │
                         └─────────┬──────────┘
                                   │
                                   ▼
                         ┌────────────────────┐
                         │ Swarm-Orchestrator │
                         └─────────┬──────────┘
                                   │
                ┌──────────────────┼──────────────────┐
                ▼                  ▼                  ▼
       ┌────────────────┐ ┌────────────────┐ ┌────────────────┐
       │ Angriffsfläche /│ │ Auth / Logik   │ │ Ausnutzung     │
       │ Aufklärung      │ │ Fähigkeit      │ │ Fähigkeit      │
       └───────┬────────┘ └───────┬────────┘ └───────┬────────┘
               │                  │                  │
               └──────────────────┼──────────────────┘
                                  ▼
                       ┌──────────────────────┐
                       │ Gemeinsamer Angriffs-│
                       │ kontext / Graph /    │
                       │ Belege               │
                       └──────────┬───────────┘
                                  │
                                  ▼
                       ┌──────────────────────┐
                       │ Unabhängige          │
                       │ Überprüfung          │
                       └──────────┬───────────┘
                                  │
                                  ▼
                       ┌──────────────────────┐
                       │ Verifizierter Befund │
                       │ + Belege             │
                       └──────────┬───────────┘
                                  │
                                  ▼
                       ┌──────────────────────┐
                       │ Menschliche Prüfung  │
                       │ + Behebung           │
                       └──────────────────────┘
Der Architekturwechsel ist subtil, aber wichtig.
Die Arbeitseinheit ist nicht mehr nur der Prompt.
Sie wird zur Mission.
So funktioniert AI Swarm Pentest
Auf hoher Ebene lässt sich ein AI Swarm Pentest als sieben miteinander verbundene Phasen verstehen:
-
Die autorisierte Mission definieren. Ziel, Umgebung, gegebenenfalls Zugangsdaten, Grenzen, Zeitrahmen und Einsatzregeln werden vor Testbeginn festgelegt. Bei Plexicus werden Scope und Regeln vor dem Einsatz vereinbart; das System ist darauf ausgelegt, innerhalb dieses autorisierten Scopes zu bleiben.
-
Die Angriffsfläche der Anwendung erfassen. Das System erkundet erreichbare Anwendungen, APIs, Routen, Parameter, Authentifizierungszustände, Formulare und weitere relevante Angriffsflächen, statt lediglich eine feste Signatursammlung abzufeuern. Die Plexicus-Dokumentation grenzt dieses Verhalten von DAST ab: KI-Pentest-Agenten können mit Anwendungen interagieren, Formulare ausfüllen, authentifizierte Sitzungen verwenden und komplexere Angriffsketten verfolgen.
-
Angriffshypothesen formulieren. Beobachtungen werden in Fragen übersetzt. Lässt sich diese Kennung ändern? Ist dieser interne Endpunkt von außen erreichbar? Kann eine Rollengrenze umgangen werden? Lassen sich zwei für sich genommen moderate Schwachstellen kombinieren?
-
Erkundung delegieren. Relevante Fähigkeiten untersuchen diese Hypothesen. Manche Pfade enden schnell. Andere liefern neue Informationen, die für den restlichen Swarm nützlich werden.
-
Belege zu Angriffswegen verknüpfen. Statt Befunde als isolierte Warnungen zu behandeln, können Beobachtungen Beziehungen bilden: Benutzer → Endpunkt → Objekt → Berechtigung → verwundbare Operation → sensible Ressource.
-
Den Befund unabhängig überprüfen. Eine Entdeckung ist nicht automatisch ein Beweis. Plexicus erklärt, dass als verifiziert präsentierte Befunde separat reproduziert werden und nicht belegte Hypothesen verworfen werden können, statt sie nur für einen längeren Bericht aufzunehmen.
-
Die Belege an Menschen übergeben. Das Ergebnis umfasst Kontext zu Auswirkungen, technische Belege, Priorisierung und die für die Behebung erforderlichen Informationen. Änderungen an Produktionssystemen werden nicht automatisch angewendet; die endgültige Entscheidung bleibt bei den menschlichen Teams.
Diese letzte Phase ist wichtig.
Das Ziel autonomer Pentests sollte nicht die autonome Erzeugung von Schwachstellen sein.
Es sollte eine autonome Untersuchung mit überprüfbaren Belegen sein.
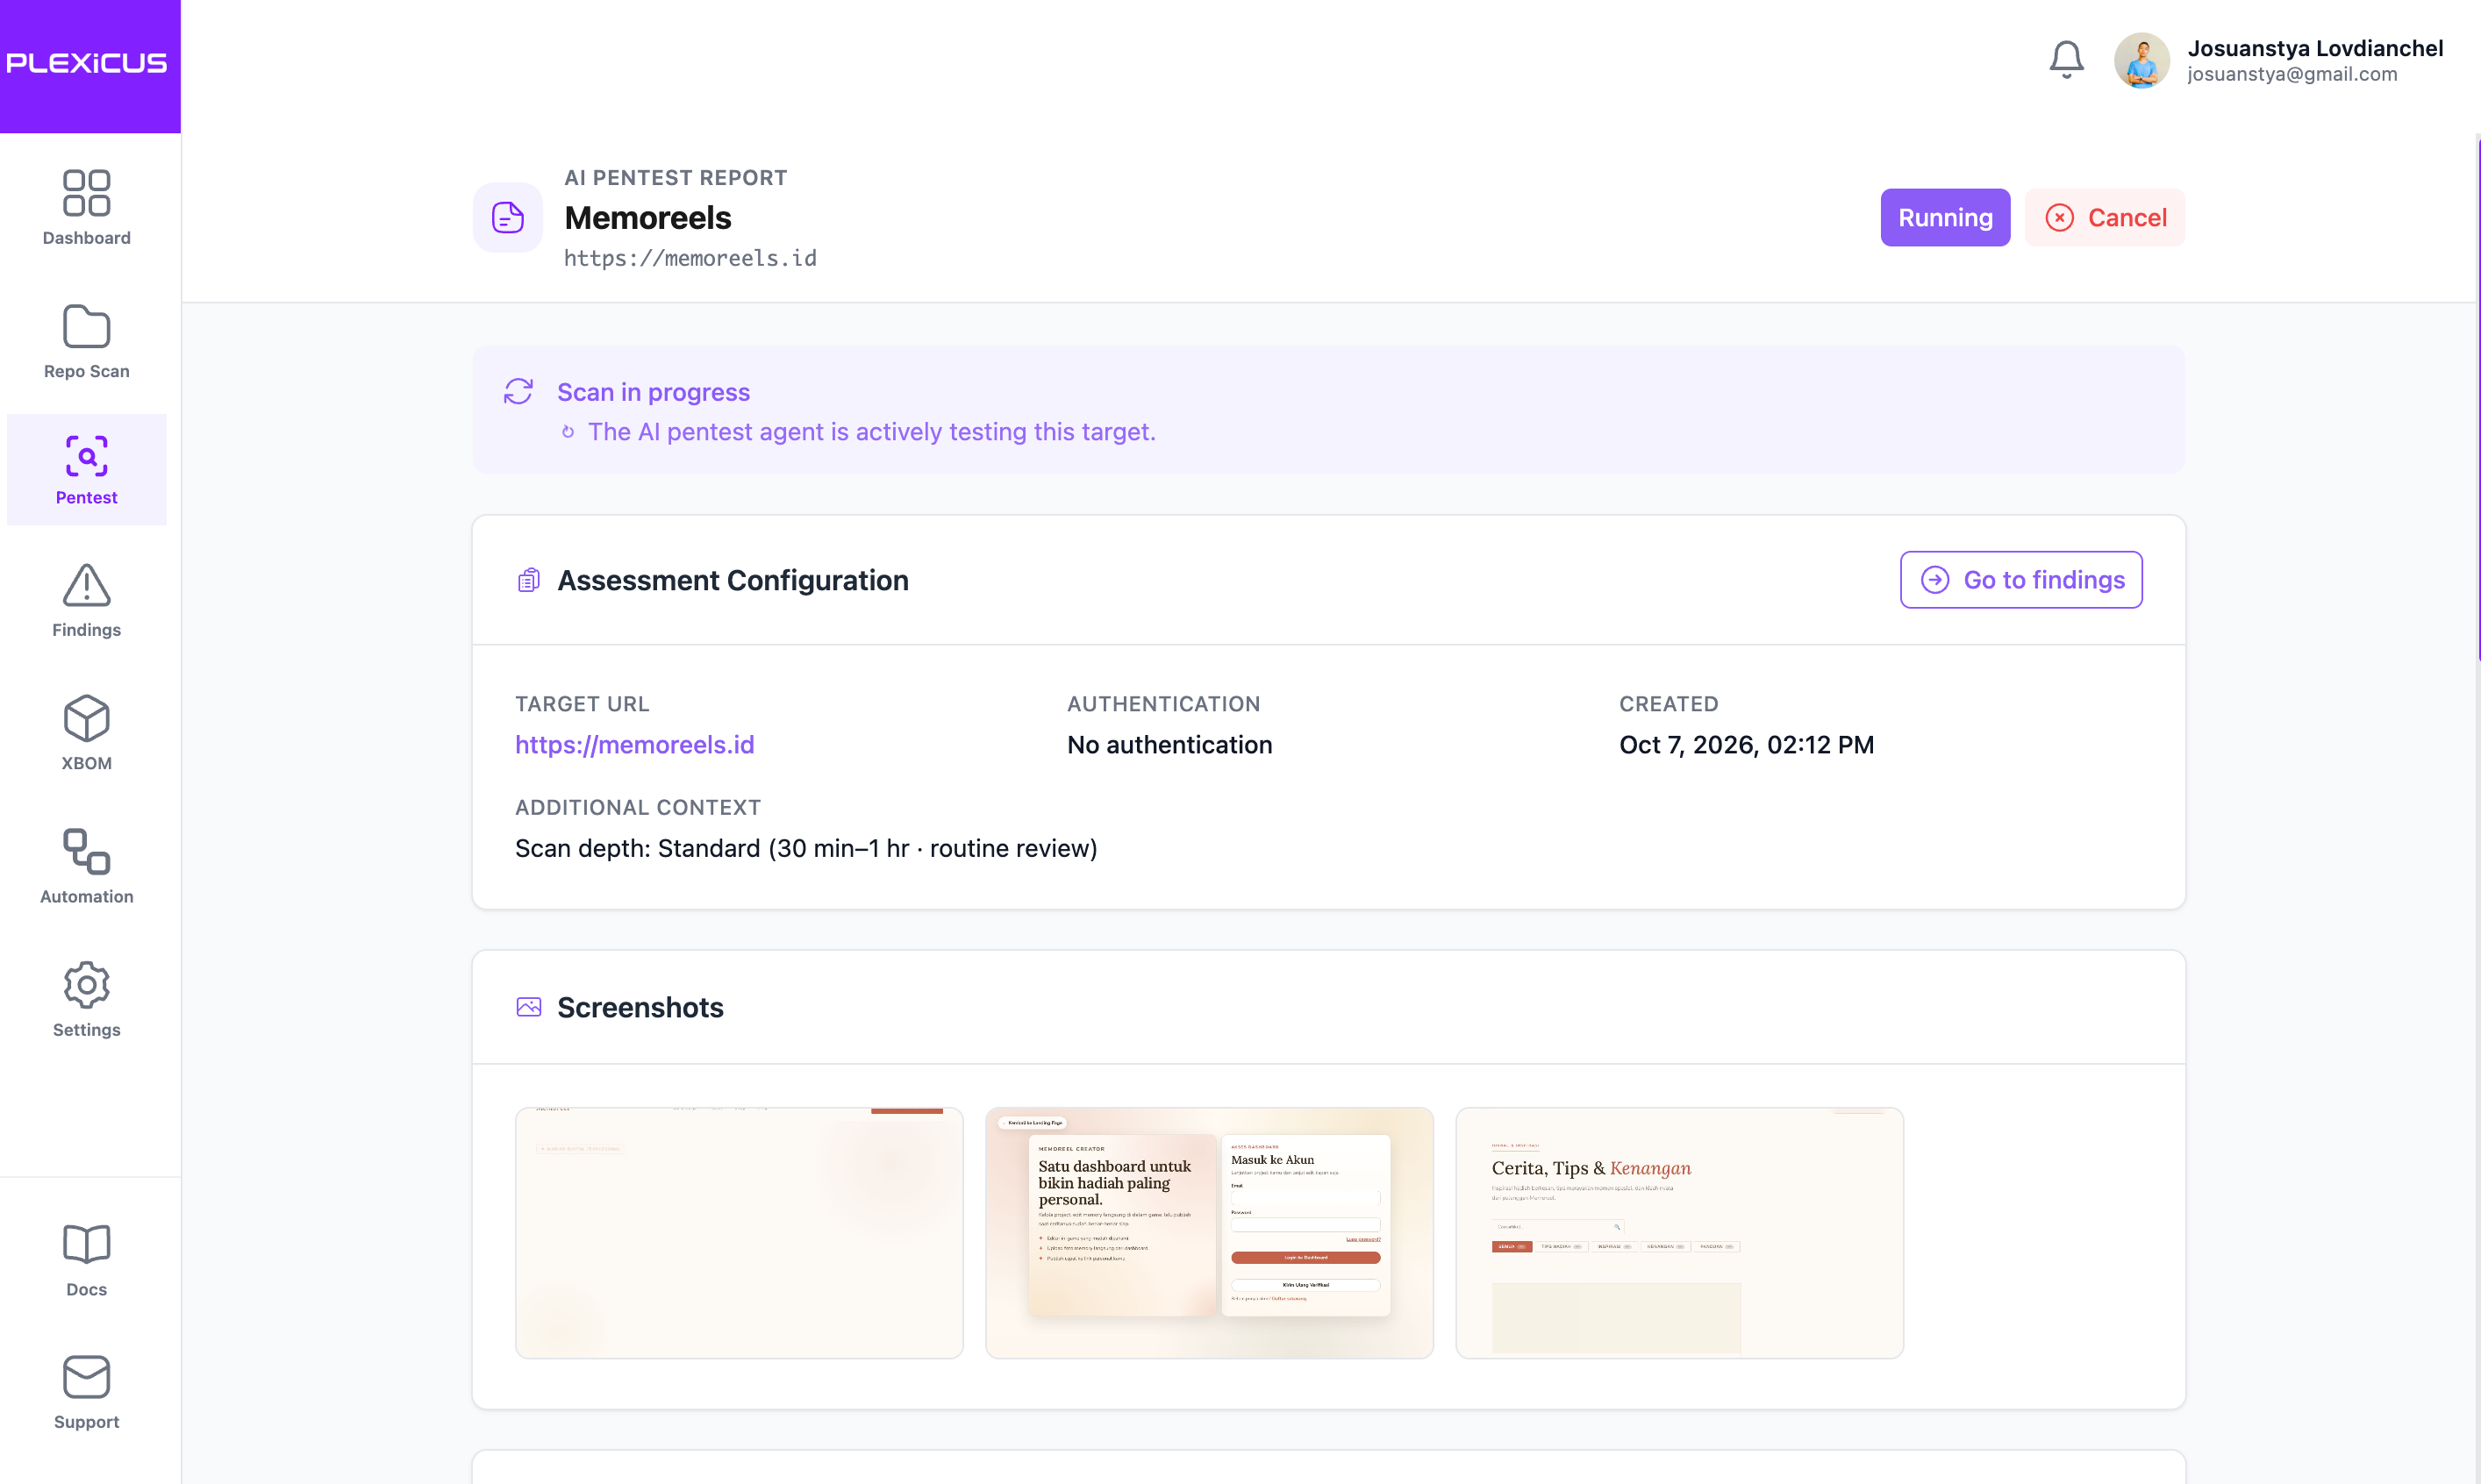
Die Testübersicht zeigt die Konfiguration und aufgenommene Screenshots des Zielsystems während des laufenden Pentests.
AI Swarm Pentest im Vergleich zu traditionellem DAST
DAST bleibt nützlich.
Doch DAST und AI Swarm Pentest beantworten unterschiedliche Fragen.
Ein herkömmlicher dynamischer Scanner eignet sich hervorragend dazu, große Mengen von Zielen wiederholt auf bekannte Schwachstellenklassen zu prüfen.
Er kann fragen:
Reagiert dieser Parameter auf einen bekannten SQL-Injection-Test?
Ein agentischer Pentester kann eine Frage stellen, die eher so lautet:
Was macht dieser Endpunkt, welche Annahmen trifft die Anwendung über den Aufrufer, und kann ich diese Annahmen manipulieren, um etwas zu erreichen, das ich nicht erreichen sollte?
Die Plexicus-Dokumentation veranschaulicht diesen Unterschied direkt. Im DAST-Modus sendet das System automatisierte Prüfungen auf Probleme wie HTTP-Sicherheitsfehlkonfigurationen und bekannte Exploit-Muster. AI Pentest erkundet Anwendungen interaktiv, unterstützt authentifizierte Abläufe und versucht komplexe Angriffsketten sowie Schwachstellen in der Geschäftslogik.
Dieser Unterschied ist wichtig, weil viele reale Anwendungsschwachstellen kontextabhängig sind.
Das Problem lautet möglicherweise nicht:
Parameter X akzeptiert Payload Y.
Sondern vielmehr:
Ein Benutzer mit niedrigen Rechten kann in Ablauf A die Kennung X erhalten, sie an API B übergeben, die Eigentümerprüfung umgehen und auf die Ressource eines anderen Mandanten zugreifen.
Keine einzelne Anfrage muss ungewöhnlich wirken.
Die Beziehung zwischen den Anfragen ist die Schwachstelle.
Genau hier wird das Schlussfolgern über den Angriffsstatus wertvoll.
AI Swarm Pentest im Vergleich zu einem „normalen“ KI-Pentest
Das ist der wichtigste Unterschied – und zugleich der, der sich am leichtesten zu stark vereinfachen lässt.
Ein gewöhnlicher autonomer KI-Pentest folgt häufig einem Agentenzyklus:
beobachten → schlussfolgern → handeln → beobachten → wiederholen.
Dieser Ansatz kann leistungsfähig sein.
Doch je größer der Einsatz wird, desto mehr muss der Agent gleichzeitig behalten, was er gelernt hat, Prioritäten festlegen, Werkzeuge bedienen, den Authentifizierungszustand erhalten, zahlreiche Hypothesen untersuchen, unergiebige Pfade aufgeben und echten Erfolg von irreführenden Ausgaben unterscheiden.
Eine Swarm-Architektur kann diese Verantwortlichkeiten verteilen.
| Dimension | Typischer KI-Pentest mit Einzelagent | AI Swarm Pentest |
|---|---|---|
| Schlussfolgern | Vorwiegend ein Schlussfolgerungszyklus | Orchestrierte spezialisierte Fähigkeiten |
| Erkundung | Häufig sequenziell | Mehrere Hypothesen können parallel untersucht werden |
| Kontext | Agentenkonversation / Arbeitsgedächtnis | Gemeinsamer Missionskontext und Angriffsbeziehungen |
| Spezialisierung | Universell einsetzbarer Pentest-Agent | Fähigkeiten können sich auf Teile der Mission spezialisieren |
| Fehlgeschlagene Pfade | Werden vom selben Agenten verwaltet | Können isoliert werden, ohne die gesamte Untersuchung zu verlieren |
| Angriffsketten | Der Agent muss den Langzeitkontext bewahren | Befunde lassen sich über einen gemeinsamen Zustand verknüpfen |
| Validierung | Wird möglicherweise vom entdeckenden Agenten durchgeführt | Unabhängige Reproduktion kann eine eigene Phase sein |
| Ergebnis | Befund / Bericht | Belegter Angriffsweg und Übergabe |
| Rolle des Menschen | Abhängig von der Implementierung | Scope, Schutzvorgaben, Prüfung und endgültige Entscheidung bleiben explizit |
Diese Tabelle beschreibt jedoch Architekturansätze und keine starren Branchenklassen.
Einige moderne autonome Pentesting-Produkte verwenden bereits spezialisierte Agenten und Validatoren. XBOW beschreibt öffentlich beispielsweise die Koordination spezialisierter Agenten und den Einsatz von Validator-Agenten zur Bestätigung der Ausnutzbarkeit.
Die entscheidende Frage für Käufer sollte daher nie lauten:
„Hat das System mehrere Agenten?“
Eine bessere Frage ist:
„Wie koordiniert das System sie, erhält den Zustand, überprüft Befunde, begrenzt den Scope und verwandelt Ergebnisse in Belege, denen mein Team vertrauen kann?“
Beim Swarm geht es um Koordination, nicht um die Anzahl der Agenten
Stellen Sie sich vor, Sie setzen 100 KI-Agenten auf eine Anwendung an.
Wenn jeder unabhängig dieselben Endpunkte scannt und dann einen eigenen Bericht erstellt, haben Sie technisch gesehen viele Agenten.
Einen nützlichen Swarm haben Sie damit nicht zwangsläufig.
Ein Swarm wird dann nützlich, wenn das Wissen, das eine Fähigkeit entdeckt, die Entscheidungen einer anderen beeinflussen kann.
Angenommen, eine Erkundungsfähigkeit entdeckt:
POST /api/projects/{project_id}/export
Der authentifizierte Benutzer scheint zum folgenden Mandanten zu gehören:
tenant_A
Eine andere Fähigkeit entdeckt eine Projekt-ID, die zu folgendem Mandanten gehört:
tenant_B
Eine Fähigkeit zur Autorisierungsprüfung kombiniert die Beobachtungen.
Sie setzt die zweite Kennung in die erste Anfrage ein.
Die Antwort ist unerwartet erfolgreich.
Anschließend reproduziert eine Prüffähigkeit die Sequenz in einem sauberen Zustand.
Jetzt hat das System etwas deutlich Nützlicheres als:
Mögliche IDOR-Schwachstelle entdeckt.
Es verfügt über eine Angriffskette:
Benutzer mit niedrigen Rechten
        ↓
Authentifizierter Projektexport-Endpunkt
        ↓
Vom Angreifer kontrollierte Projektkennung
        ↓
Fehlende Prüfung der Mandantenzugehörigkeit
        ↓
Mandantenübergreifender Projektexport
        ↓
Offenlegung sensibler Daten
Und jeder Schritt kann mit Belegen versehen werden.
Das ist der Unterschied zwischen dem Erkennen einer Anomalie und dem Nachweis eines Angriffswegs.
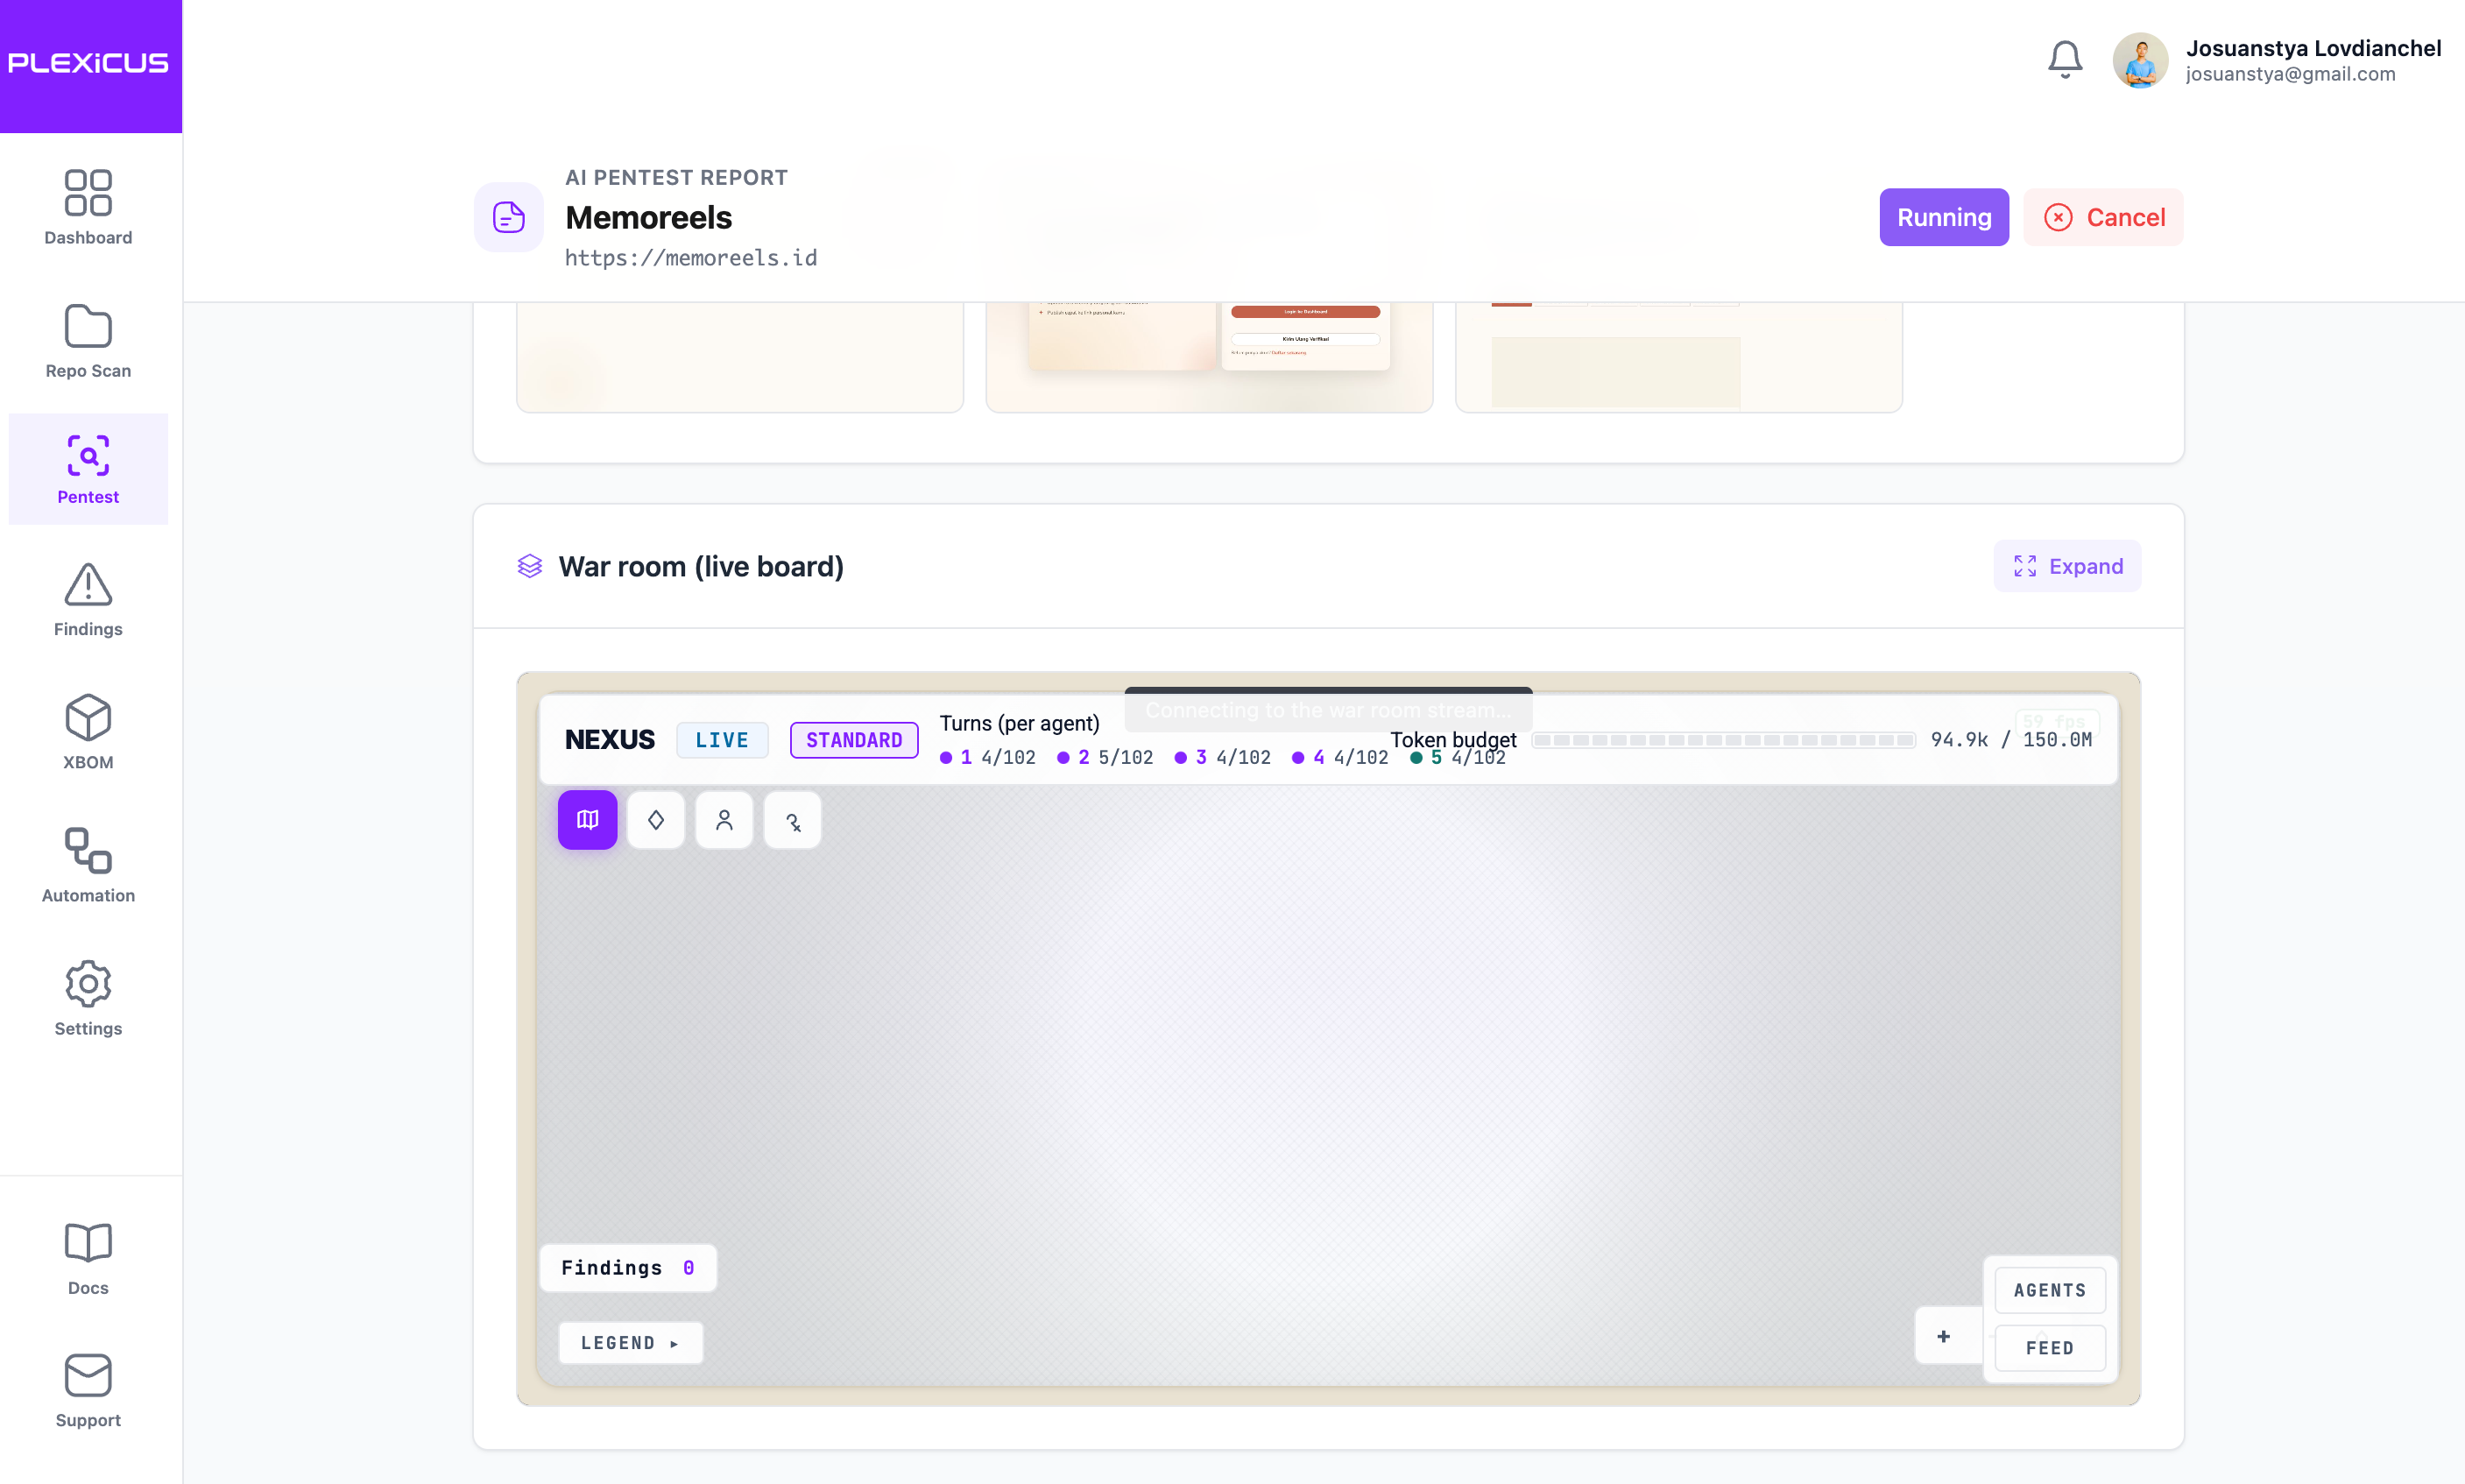
Das eingebettete War-room-Live-Board ist während des Verbindungsaufbaus zum Stream zu sehen.
Gemeinsamer Kontext verändert, was KI untersuchen kann
Bei lang laufenden Penetrationstests entsteht sehr viel vorübergehendes Wissen.
Ein Agent stellt vielleicht fest, dass:
ein Endpunkt ein bestimmtes Token erfordert,
ein Benutzer zu einer bestimmten Rolle gehört,
ein Parameter ein Backend-Objekt steuert,
ein Dienst einen internen Hostnamen offenlegt,
ein fehlgeschlagener Payload trotzdem die Version eines Frameworks verrät
oder ein Authentifizierungsablauf Zugangsdaten erzeugt, die an anderer Stelle nützlich sind.
Bleiben solche Beobachtungen im lokalen Kontext des entdeckenden Agenten gefangen, ist ihr Wert begrenzt.
Eine gemeinsame Angriffsrepräsentation ermöglicht es, Informationen anzusammeln.
Die Beschreibung des für den 15. Oktober angekündigten Vortrags APIAddicts Days 2026 schlägt einen Plexicus-Proof-of-Concept vor, der spezialisierte Skills, MCP und eine graphorientierte Datenbank als Angriffsgedächtnis kombiniert. Die vorgeschlagene Repräsentation verknüpft Assets, Schwachstellen und Ausnutzungspfade.
Graphartige Repräsentationen passen gut zu Offensive Security, weil Angriffe selbst Graphen sind.
Ein Knoten kann Folgendes darstellen:
Benutzer
Endpunkt
Zugangsdaten
Repository
Dienst
Rolle
Schwachstelle
Asset
Geheimnis
Eine Kante kann Folgendes darstellen:
KANN_ZUGREIFEN
AUTHENTIFIZIERT_SICH_BEI
RUFT_AUF
IST_EIGENTÜMER_VON
LEGT_OFFEN
HÄNGT_AB_VON
UMGEHT
FÜHRT_ZU
Die interessante Sicherheitsfrage lautet dann:
Welcher neue Pfad ergibt sich aus diesen Beziehungen?
Das kommt dem Denken erfahrener Angreifer deutlich näher.
Überprüfung ist wichtiger als Generierung
Generative KI bringt in der offensiven Sicherheit ein offensichtliches Problem mit sich:
Sie kann selbstbewusst falsch liegen.
Ein Modell kann eine Antwort falsch interpretieren.
Ein Befehl kann einen unerwarteten Erfolgscode liefern.
Eine Anwendung kann sich inkonsistent verhalten.
Ein Payload kann scheinbar funktionieren, obwohl seine tatsächliche Auswirkung anders ist, als der Agent annimmt.
Deshalb darf ein KI-Pentesting-System nicht gleichsetzen:
„Das Modell glaubt, eine Schwachstelle gefunden zu haben“
mit:
„Eine Schwachstelle wurde verifiziert.“
Die Branche für offensive KI nähert sich dieser Erkenntnis zunehmend an.
XBOW beschreibt öffentlich den Einsatz von Validator-Agenten und die Anforderung eines Nachweises, bevor validierte Befunde gemeldet werden.
Plexicus setzt dasselbe übergeordnete Prinzip innerhalb seines Proof-Driven-AppSec-Modells um: Als verifiziert präsentierte Befunde brauchen reproduzierbare Belege und eine separate Bestätigung. Kann ein zweiter Durchlauf das Ergebnis nicht reproduzieren, bleibt der Befund laut Plexicus unverifiziert oder wird verworfen.
Das verändert das Optimierungsziel.
Ein schwaches KI-Sicherheitssystem optimiert auf:
Wie viele Schwachstellen können wir generieren?
Ein nachweisgestütztes System sollte optimieren auf:
Wie viele relevante Angriffswege können wir mit belastbaren Belegen nachweisen?
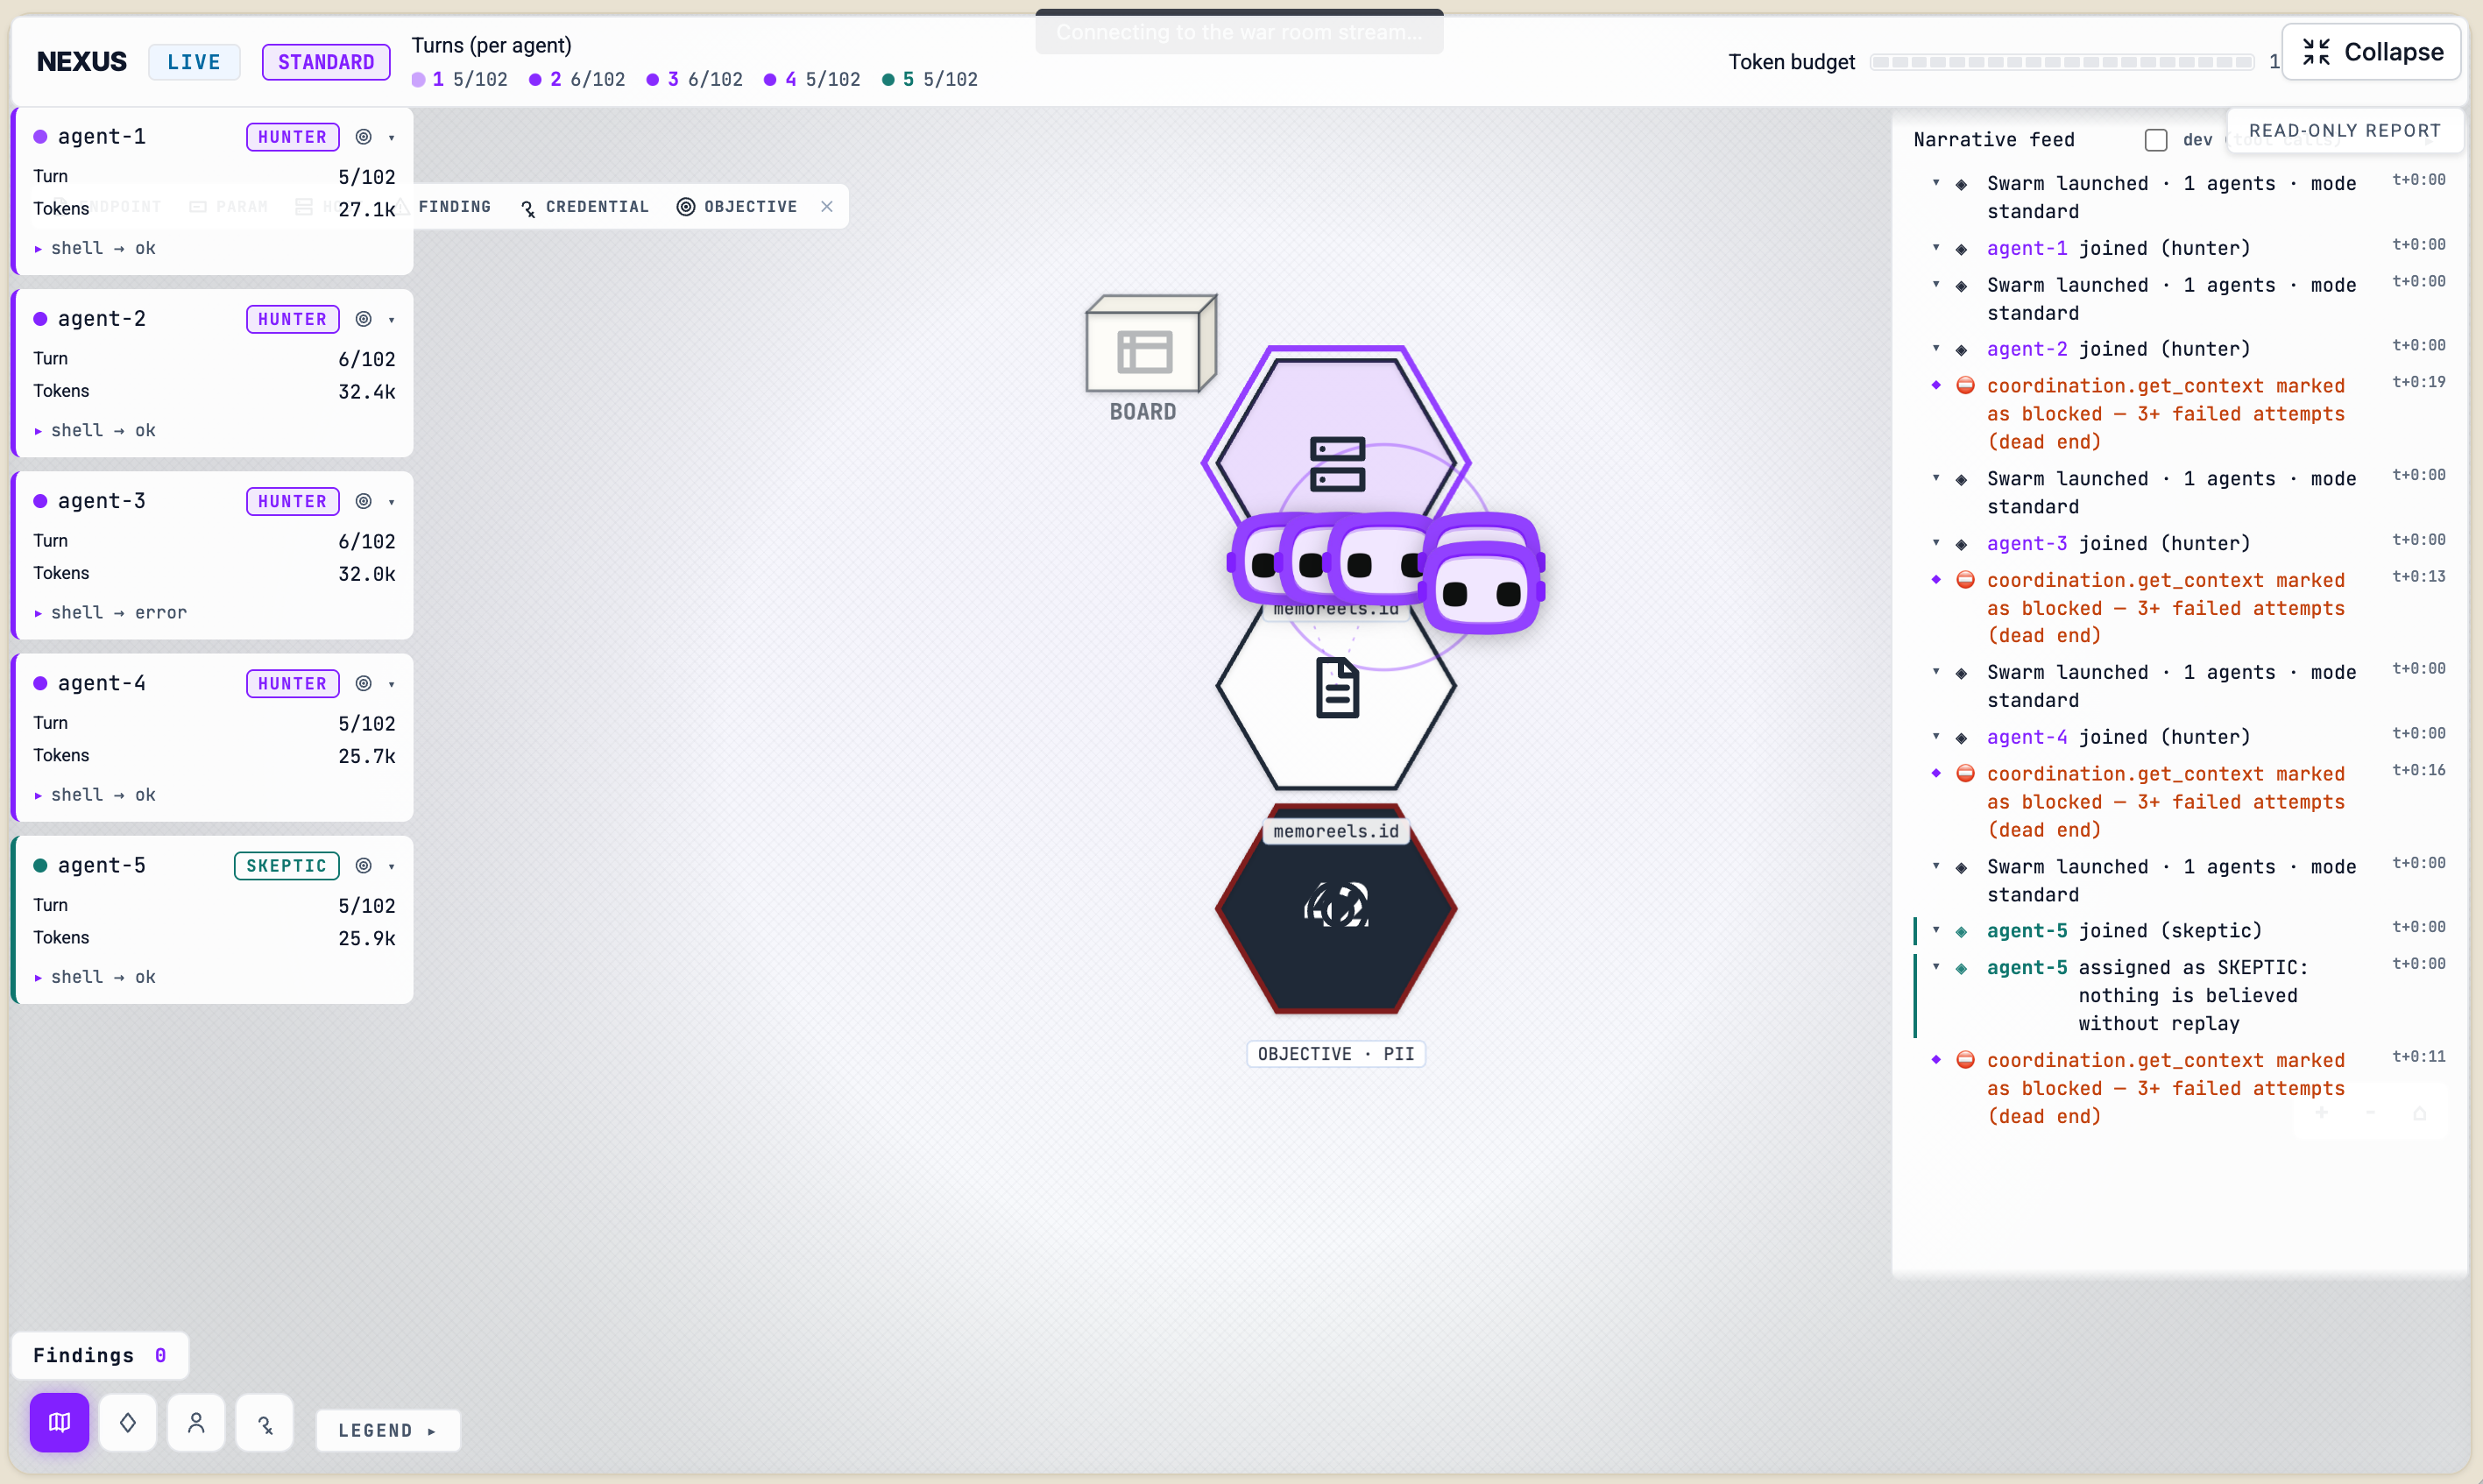
Das erweiterte Board zeigt vier Hunter-Agenten und einen Skeptic-Agenten, die Aktivität jedes Agenten und den Ereignisfeed. Diese Momentaufnahme zeigt null Befunde und blockierte Versuche; sie belegt keinen verifizierten Exploit.
Warum Angriffsketten wichtiger sind als die Anzahl der Warnungen
Sicherheitsteams leiden selten unter einem Mangel an Warnungen.
Ein modernes Unternehmen kann bereits Ergebnisse aus folgenden Quellen erhalten:
SAST,
SCA,
DAST,
Cloud-Scannern,
Containernscannern,
Secret-Scannern,
CSPM,
Abhängigkeitsanalysen,
Bug-Bounty-Programmen
und manuellen Penetrationstests.
Die schwierigere Aufgabe besteht darin, zu entscheiden, was wirklich wichtig ist.
Betrachten Sie drei isolierte Befunde:
Ein öffentlich erreichbarer Endpunkt gibt eine Dienstkennung preis.

Ein interner Dienst akzeptiert ein nicht validiertes Redirect-Ziel.

Ein privilegierter Endpunkt vertraut Anfragen, die von diesem Dienst stammen.
Für sich genommen wirkt möglicherweise keiner davon katastrophal.
Zusammen ergibt sich:
Externer Angreifer
      ↓
Öffentlicher Endpunkt
      ↓
Ermittlung eines internen Dienstes
      ↓
SSRF- / Routing-Primitiv
      ↓
Vertrauenswürdige interne Anfrage
      ↓
Privilegierter Endpunkt
Das Risiko entsteht durch den Angriffspfad, nicht allein durch die einzelnen Befunde.
Deshalb positioniert Plexicus AI Swarm Pentest rund um validierte Angriffswege statt um eine endlose Liste möglicher Probleme.
Warum heißt es „Swarm“?
Das Wort kann wie Marketingjargon klingen.
Es sollte nicht bedeuten: „Wir haben viele Agenten gestartet.“
In einem nützlichen Security-Swarm sollten die Fähigkeiten zu einer gemeinsamen Mission beitragen.
Das passende Bild ist ein koordiniertes Pentest-Team:
                     Mission
                        │
           ┌────────────┼────────────┐
           │            │            │
       Erkunden       Denken       Ausnutzen
           │            │            │
           └────────────┼────────────┘
                        │
                Gemeinsamer Kontext
                        │
           ┌────────────┼────────────┐
           │                         │
       Hinterfragen              Überprüfen
           │                         │
           └────────────┬────────────┘
                        │
                      Belege
Verschiedene Fähigkeiten können unterschiedliche Teile des Angriffs verfolgen.
Doch sie sind keine voneinander unabhängigen Forschenden, die unverbundene Notizen verfassen.
Sie tragen alle zu einer gemeinsamen, sich weiterentwickelnden Repräsentation des Ziels bei.
Die Intelligenz des Systems entsteht daher nicht nur durch das Modell, sondern auch durch die Orchestrierung darum herum.
Das ist besonders wichtig, je leistungsfähiger Open-Weight-Modelle werden.
Die Beschreibung des kommenden Vortrags bei APIAddicts Days 2026 stellt eine verwandte Frage: Wie können Orchestrierung, spezialisierte Skills, MCP-Tools und dauerhaftes Angriffsgedächtnis ein Open-Weight-Modell dabei unterstützen, ein autorisiertes Ziel zu untersuchen?
AI Swarm Pentest im Proof-Driven-AppSec-Workflow
Penetrationstests sind nützlich.
Doch eine ausnutzbare Schwachstelle zu entdecken, ist erst der Anfang des Engineering-Workflows.
Jemand muss den betroffenen Code verstehen.
Jemand muss Erreichbarkeit und geschäftliche Auswirkungen bewerten.
Jemand muss die sicherste Behebung bestimmen.
Jemand muss sie implementieren.
Jemand muss die Änderung prüfen.
Und jemand sollte verifizieren, dass der ursprüngliche Exploit nicht mehr funktioniert.
Deshalb positioniert Plexicus AI Swarm Pentest als Bestandteil eines umfassenderen Proof-Driven-AppSec-Workflows.
Das Modell lässt sich so zusammenfassen:
VALIDIEREN
AI Swarm Pentest
      │
      │ ausnutzbarer Pfad + Belege
      ▼
VERSTEHEN
Deep Code Analysis
      │
      │ Codekontext + Auswirkung
      ▼
BEHEBEN
Geprüfte Behebung
      │
      │ Lösungsvorschlag
      ▼
ERNEUT TESTEN
Lässt sich der Angriff noch reproduzieren?
Die aktuelle Plattformbeschreibung von Plexicus bezeichnet dies als Validate → Understand → Remediate: AI Swarm Pentest erkundet autorisierte Angriffswege, Deep Code Analysis ergänzt Codekontext, und die Behebung kann prüfungsfertige Änderungen samt anschließendem Retest bereitstellen.
Diese Verbindung ist wichtig.
Ohne sie besteht das Risiko, dass autonomes Pentesting ein altes Sicherheitsproblem in neuer Form erzeugt:
Mehr Befunde, als Engineering-Teams beheben können.
Was AI Swarm Pentest nicht ist
AI Swarm Pentest ist kein Schwachstellenscanner mit KI-generierten Beschreibungen.
Es ist kein Chatbot, der erklärt, wie ein Angreifer etwas theoretisch ausnutzen könnte.
Es ist keine Erlaubnis für einen autonomen Agenten, beliebige Infrastrukturen anzugreifen.
Es ist keine Garantie, dass jede Schwachstelle entdeckt wird.
Und es soll menschliches Urteilsvermögen bei Sicherheitsentscheidungen nicht ersetzen.
Plexicus beschreibt AI Swarm Pentest ausdrücklich als Einsatz mit festgelegtem Scope und vereinbarten Einsatzregeln, menschlichen Entscheidungspunkten, unabhängiger Überprüfung und ohne automatische Änderungen an Produktionssystemen.
Diese Schutzvorgaben sind keine Einschränkungen, die beseitigt werden sollten.
Sie machen autonome offensive Sicherheit in professionellen Umgebungen erst nutzbar.
Kann AI Swarm Pentest menschliche Pentester ersetzen?
Nicht vollständig.
Und das sollte auch nicht das unmittelbare Ziel sein.
Menschliche Pentester bleiben besonders wertvoll, wenn Tests ungewöhnliche Kreativität, tiefes Organisationswissen, soziale Schlussfolgerungen, physischen Zugang, mehrdeutige Geschäftsprozesse oder ein Urteilsvermögen erfordern, das nicht sicher an Software delegiert werden kann.
KI hat andere Vorteile.
Maschinen können große Angriffsflächen systematisch erfassen.
Sie können Aufgaben ohne Ermüdung wiederholen.
Sie können zahlreiche Hypothesen verfolgen.
Sie können Änderungen erneut testen.
Und sie können bestimmte Formen paralleler Erkundung in einem Umfang durchführen, der mit menschlicher Arbeit nur teuer nachzubilden wäre.
Forschung, die KI-Agenten mit menschlichen Cybersicherheitsexperten vergleicht, zeigt bereits diese Mischung aus Stärken und Einschränkungen. Multi-Agent-Systeme können bei systematischer Enumeration und paralleler Ausnutzung gut abschneiden, haben aber weiterhin Schwierigkeiten mit manchen GUI-lastigen Aufgaben und erzeugen ohne ausreichende Überprüfung mehr False Positives.
Die realistischere Zukunft lautet daher nicht:
KI gegen Pentester
Sondern:
KI übernimmt skalierbare Erkundung
        +
Überprüfung reduziert Störmeldungen
        +
Menschen kontrollieren Scope und Urteilsentscheidungen
        +
Sicherheitsexperten untersuchen schwierige Grenzfälle
Plexicus erklärt ebenfalls, dass AI Swarm Pentest wiederholte Erkundung, Korrelation und Reproduktion automatisiert, ohne menschlichen Kontext und die endgültige Entscheidungsbefugnis zu entfernen.
Wo AI Swarm Pentest besonders nützlich sein kann
Der Ansatz wird besonders interessant für Unternehmen, deren Softwareoberfläche sich schneller verändert, als regelmäßige manuelle Tests sinnvoll abdecken können.
Ein Team veröffentlicht möglicherweise täglich Änderungen an Anwendungen.
APIs können zwischen zwei Pentest-Zyklen entstehen und wieder verschwinden.
KI-generierter Code kann den Entwicklungsdurchsatz deutlich erhöhen.
Neue Abhängigkeiten und Dienste kommen vielleicht kontinuierlich hinzu.
Ein traditioneller jährlicher Pentest bleibt wertvoll, bildet aber nur eine Momentaufnahme.
Agentisches Testen eröffnet die Möglichkeit, häufiger offensive Sicherheitsprüfungen durchzuführen.
Nicht nur:
„Hat unser Scanner etwas gefunden?“
Sondern:
„Kann ein Angreifer diesen Angriffsweg nach der letzten Änderung noch reproduzieren?“
Das ist ein wichtiger Wechsel von periodischer Schwachstellensuche hin zu kontinuierlicher Sicherheitsvalidierung.
Ein praktisches Beispiel
Stellen Sie sich eine SaaS-Anwendung vor, die mit KI erstellt wurde.
Die Anwendung enthält:
Web-Frontend
Authentifizierungsdienst
Abrechnungs-API
Projekt-API
Dateispeicher
Administrations-API
Ein herkömmlicher Scanner entdeckt einige Sicherheitsheader und eine veraltete Abhängigkeit.
Nützliche Informationen – aber nicht unbedingt das Risiko mit der höchsten Priorität.
Während eines AI Swarm Pentest entdeckt die Erkundungsphase:
GET /api/projects/{project_id}
Ein normaler Benutzer kann sein eigenes Projekt abrufen.
Der Swarm hält die Beziehung fest:
USER_A → OWNS → PROJECT_123
Eine weitere Beobachtung zeigt:
PROJECT_456 → OWNED_BY → USER_B
Es entsteht eine Autorisierungshypothese.
Die zuständige Fähigkeit sendet authentifiziert als Benutzer A:
GET /api/projects/456
Der Server gibt Metadaten zurück.
Interessant – aber noch nicht ausreichend.
Die Untersuchung geht weiter.
Die zurückgegebenen Metadaten enthalten:
export_id: EXP-8821
Eine andere Fähigkeit entdeckt:
GET /api/exports/{export_id}/download
Die Anfrage ist erfolgreich.
Das heruntergeladene Archiv enthält private Projektdaten von Benutzer B.
Der Angriffsweg sieht nun so aus:
Benutzer A
  ↓
Projektkennung manipulieren
  ↓
Metadaten von Projekt B lesen
  ↓
Exportkennung entdecken
  ↓
Export herunterladen
  ↓
Mandantenübergreifende Offenlegung von Daten
Nun wiederholt die Überprüfungsphase die Kette unabhängig.
Lässt sich der Exploit reproduzieren, kann das System jedem Schritt Belege zuordnen.
Deep Code Analysis kann anschließend die fehlende Autorisierungskontrolle im Code nachverfolgen.
Ein Behebungsworkflow kann eine mandantengebundene Validierung vorschlagen.
Nach der Prüfung kann der ursprüngliche Exploit erneut ausgeführt werden.
Schlägt er fehl:
Angriff vor der Behebung reproduziert: JA
Angriff nach der Behebung reproduziert: NEIN
Das ist ein wesentlich aussagekräftigeres Sicherheitsartefakt als:
Mögliche IDOR-Schwachstelle – Hoch
Das wichtigste Ergebnis ist der Nachweis
Generative KI wird die Erstellung von Sicherheitshypothesen extrem günstig machen.
Das ist zugleich leistungsfähig und gefährlich.
Ein Modell kann Hunderte plausible Erklärungen dafür erzeugen, warum eine Anwendung verwundbar sein könnte.
Doch AppSec-Teams brauchen keine Hunderte plausiblen Erklärungen.
Sie brauchen Gewissheit.
Sie müssen wissen:
Was hast du erreicht?

Wie hast du es erreicht?

Lässt es sich reproduzieren?

Welche Auswirkungen hat es?

Wo entsteht das verwundbare Verhalten?

Was sollten wir ändern?

Hat die Behebung den Angriff tatsächlich gestoppt?
Deshalb werden Belege wichtiger – nicht unwichtiger –, wenn KI leistungsfähiger wird.
Je autonomer Sicherheit wird, desto stärker muss ihre Verifizierungsschicht sein.
Die Zukunft des Pentestings ist nicht ein einzelnes größeres Modell
Fortschritte in der KI wurden mehrere Jahre lang häufig anhand der Modellgröße beschrieben.
Ein intelligenteres Modell lieferte bessere Antworten.
Pentesting zeigt, warum dieses Denkmodell unvollständig ist.
Offensive Security ist nicht bloß ein Schlussfolgerungs-Benchmark.
Sie ist ein Systemproblem.
Die KI braucht Werkzeuge.
Sie braucht Gedächtnis.
Sie braucht Berechtigungen.
Sie braucht Zustand.
Sie braucht eine Repräsentation der Umgebung.
Sie muss wissen, wann sie weiter erkunden sollte.
Sie muss wissen, wann sie aufhören sollte.
Sie muss eine vielversprechende Hypothese von einem nachgewiesenen Exploit unterscheiden.
Und sie braucht einen Mechanismus, mit dem ein anderer Prozess ihre Schlussfolgerungen hinterfragen kann.
Das bedeutet: Die Zukunft autonomer Penetrationstests könnte ebenso stark von Architektur und Orchestrierung abhängen wie von der rohen Modellintelligenz.
Die Entwicklung könnte ungefähr so aussehen:
Sicherheitsscanner
      ↓
KI-Sicherheitsassistent
      ↓
Autonomer Pentest-Agent
      ↓
Multi-Agent-Pentesting
      ↓
Orchestrierter AI Swarm
      ↓
Proof-Driven AppSec
Jede Stufe ersetzt nicht zwangsläufig die vorherige.
Scanner bleiben nützlich.
Menschliche Pentester bleiben nützlich.
Einzelagentensysteme bleiben nützlich.
Die Frage ist, welche Architektur am besten zur Komplexität und Häufigkeit des Sicherheitsproblems passt, das geprüft wird.
AI Swarm Pentest bei Plexicus
Plexicus AI Swarm Pentest basiert auf einem einfachen Prinzip:
Hören Sie nicht bei der Erkennung möglicher Schwachstellen auf. Zeigen Sie, was ein Angreifer tatsächlich erreichen kann.
Innerhalb eines autorisierten Scopes untersucht Plexicus das Verhalten von Anwendungen und APIs, formuliert und testet Angriffshypothesen, verknüpft relevante Beobachtungen und hält unterstützende Belege an den Befunden fest.
Als verifiziert präsentierte Befunde durchlaufen eine unabhängige Reproduktion.
Anschließend wird das Ergebnis mit dem restlichen Proof-Driven-AppSec-Workflow von Plexicus verknüpft. Teams können dort Codekontext ergänzen, Auswirkungen nachvollziehen, eine Behebung prüfen und das Ergebnis erneut validieren.
Ziel ist nicht, den größtmöglichen Pentest-Bericht zu erstellen.
Security- und Engineering-Teams sollen etwas Nützlicheres erhalten:
Einen validierten Angriffsweg.
Belege dafür, warum er real ist.
Kontext zu den betroffenen Bereichen.
Und einen klaren Weg zur Behebung.
Häufig gestellte Fragen
Ist AI Swarm Pentest dasselbe wie automatisiertes Schwachstellenscanning?
Nein.
Ein Scanner führt gewöhnlich vorgegebene Prüfungen oder Probes aus und meldet übereinstimmendes Verhalten. AI Swarm Pentest nutzt agentisches Schlussfolgern, um ein autorisiertes Ziel zu erkunden, Hypothesen zu formulieren, mit dem Verhalten der Anwendung zu interagieren und Angriffswege zu untersuchen.
Plexicus bietet sowohl DAST- als auch AI-Pentest-Modi an und dokumentiert sie getrennt.
Ist AI Swarm Pentest einfach eine Gruppe von LLMs, die gleichzeitig laufen?
Nein.
Parallelität allein erzeugt kein nützliches Swarm-Verhalten.
Entscheidend sind Orchestrierung, spezialisierte Verantwortlichkeiten, gemeinsamer Angriffskontext, kontrollierte Ausführung und Überprüfung.
Braucht jeder Agent ein anderes KI-Modell?
Nein.
Die Spezialisierung von Agenten und die Spezialisierung von Modellen sind zwei verschiedene Dinge.
Mehrere Agenten können dasselbe zugrunde liegende Modell verwenden und trotzdem unterschiedliche Missionen, Werkzeuge, Berechtigungen, Kontexte oder Prüfaufgaben erhalten.
Umgekehrt kann eine Orchestrierungsschicht für verschiedene Aufgaben unterschiedliche Modelle auswählen.
Ist das „Swarm“-Konzept einzigartig für Plexicus?
Multi-Agent-Sicherheitssysteme sind nicht einzigartig für Plexicus.
Auch akademische Systeme und kommerzielle autonome Pentesting-Plattformen verwenden Multi-Agent-Architekturen, spezialisierte Agenten oder Validator-Agenten.
Plexicus verwendet AI Swarm Pentest als Bezeichnung für die eigene Umsetzung dieses Ansatzes im umfassenderen Proof-Driven-AppSec-Workflow. Im Mittelpunkt stehen gemeinsamer Angriffskontext, Belege, unabhängige Überprüfung, Codeanalyse und Behebung.
Kann AI Swarm Pentest Schwachstellen in der Geschäftslogik finden?
Agentisches Testen eignet sich besonders für Geschäftslogik- und mehrstufige Schwachstellen, weil es mit Workflows interagieren kann, statt sich ausschließlich auf feste Signaturen zu verlassen.
Die Plexicus-Dokumentation erklärt, dass AI Pentest authentifizierte Abläufe testen und komplexe Angriffsketten sowie Schwachstellen in der Geschäftslogik entdecken kann.
Greift AI Swarm Pentest Produktionssysteme automatisch an?
Tests müssen innerhalb eines ausdrücklich autorisierten Scopes und vereinbarter Einsatzregeln bleiben.
Plexicus erklärt, dass der Einsatz scope-kontrolliert ist und Produktionssysteme nicht automatisch verändert.
Beseitigt es False Positives?
Kein autonomes Sicherheitssystem sollte das versprechen.
Das Ziel ist, Unsicherheit durch Reproduzierbarkeit und Belege zu verringern.
Bei Plexicus muss ein Befund eine separate Überprüfungsphase bestehen, bevor er als verifiziert präsentiert wird.
Ersetzt AI Swarm Pentest manuelle Penetrationstests?
Nein.
Es verändert, welche Teile eines Penetrationstests sich automatisieren und im Maschinemaßstab wiederholen lassen.
Menschliche Expertise bleibt wichtig für den Scope, die Interpretation, besondere Grenzfälle und die endgültigen Entscheidungen.
Vom Finden von Schwachstellen zum Nachweis von Angriffswegen
KI erleichtert das Generieren von Code.
Sie erleichtert auch das Generieren von Angriffen.
Die Sicherheitsvalidierung muss sich entsprechend weiterentwickeln.
Die Antwort kann nicht einfach ein weiterer Scanner mit einer weiteren Warteschlange voller Warnungen sein.
Und ein LLM zu diesem Scanner hinzuzufügen, löst das Problem nicht automatisch.
Den Workflow verändert die Fähigkeit, dynamisch zu untersuchen:
Erkunden.
Eine Hypothese formulieren.
Sie testen.
Erkenntnisse teilen.
Sie mit einer anderen Beobachtung verknüpfen.
Die Schlussfolgerung hinterfragen.
Den Angriff reproduzieren.
Die Belege aufbewahren.
Das ist die Idee hinter AI Swarm Pentest.
Nicht eine KI, die vorgibt, ein ganzes Red Team zu sein.
Sondern ein orchestriertes System, das an einer gemeinsamen, autorisierten Sicherheitsmission arbeitet.
Und vor allem:
Ohne reproduzierbaren Nachweis kein verifizierter Befund.
Sehen Sie, was ein Angreifer tatsächlich erreichen kann
Plexicus AI Swarm Pentest untersucht autorisierte Angriffswege in Anwendungen und APIs, validiert ihre Ausnutzbarkeit und liefert Ihrem Team überprüfbare Belege, auf deren Grundlage es handeln kann.
Den Angriffsweg validieren. Die Auswirkungen verstehen. Mit Belegen beheben.