Was ist SAST? Der vollständige Leitfaden zu Static Application Security Testing für 2026
Ein vollständiger Leitfaden zu SAST im Jahr 2026: wie statische Analyse funktioniert, was sie findet und übersieht, warum sie False Positives erzeugt und wie aus einem Befund ein Nachweis wird.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenJede Sicherheitslücke in Ihrer eigenen Software beginnt als Codezeile.
Statische Anwendungssicherheitstests gehören zu den ältesten automatisierten Methoden, nach diesen Zeilen zu suchen, bevor jemand das Programm ausführt.
SAST analysiert Quellcode, Bytecode oder Binärdateien, ohne die Anwendung auszuführen, und meldet Codemuster und Datenflüsse, die zu einer Schwachstelle führen können, zusammen mit der Datei und der Zeile, in der sie liegen.
OWASP beschreibt diese Tools genauso: Werkzeuge zur Quellcodeanalyse, auch SAST-Tools genannt, analysieren Quellcode oder kompilierte Versionen von Code, um Sicherheitsfehler zu finden. OWASP
Die Idee ist einfach. Die Praxis ist es nicht.
Ein SAST-Tool kann ein gefährliches Muster in Sekunden markieren. Es kann Ihnen nicht immer sagen, ob ein Angreifer dieses Muster erreichen kann, welche Daten dahinter liegen oder ob die Warnung echt ist.
Diese Lücke wiegt 2026 schwerer. In seinem Data Breach Investigations Report 2026 stellte Verizon fest, dass die Ausnutzung von Schwachstellen mit 31 % zum häufigsten Erstzugangsvektor bei den analysierten Sicherheitsverletzungen geworden ist, nach 20 % im Vorjahr.
Dieser Leitfaden erklärt, was SAST ist, wie es funktioniert, was es findet und was es übersieht, wie Sie ein Tool bewerten und wie Sie aus einem statischen Befund Belege machen, auf die Ihr Team reagieren kann.
Was ist SAST?
Static Application Security Testing (SAST), auf Deutsch statische Anwendungssicherheitstests, ist eine White-Box-Testmethode, die den Code einer Anwendung untersucht, ohne ihn auszuführen, um Schwächen zu finden, die zu Sicherheitslücken werden könnten.
„White-Box“ bedeutet, dass das Tool das Innere der Anwendung sieht: die Quelldateien, die Funktionen, die Variablen und wie Daten zwischen ihnen fließen.
„Statisch“ bedeutet, dass nichts ausgeführt wird. Das Tool liest und modelliert den Code so, wie es ein Compiler tut, und wendet dann Sicherheitsregeln auf dieses Modell an.
Ein typischer SAST-Befund beantwortet vier Fragen:
- Welche Schwäche gefunden wurde, meist einer CWE-Kennung zugeordnet, etwa CWE-89 (SQL Injection).
- Wo sie liegt: Datei, Zeile und der Codeausschnitt.
- Wie nicht vertrauenswürdige Daten sie erreichen, wenn das Tool einen Datenfluss verfolgt.
- Wie schwer sie nach Einschätzung des Tools wiegt.
OWASP nennt diese Ortsangabe als eine der Hauptstärken der Methode: Die SAST-Ausgabe hebt den problematischen Code mit Dateiname, Position, Zeilennummer und sogar dem betroffenen Ausschnitt hervor. OWASP
Deshalb nutzen Entwickler sie weiterhin. Ein Befund, der auf Zeile 276 einer Datei zeigt, lässt sich leichter bearbeiten als ein Bericht, der sagt: „Die Login-Seite ist verwundbar“.
Was kann ein SAST-Tool analysieren?
Je nach Tool arbeitet SAST mit einer oder mehreren dieser Eingaben:
- Quellcode, die häufigste Eingabe: Java, Python, JavaScript, Go, C#, PHP und so weiter.
- Bytecode, etwa kompilierte Java-Klassen oder .NET-Assemblies.
- Binärdateien, wenn kein Quellcode verfügbar ist.
- Infrastruktur- und Konfigurationsdateien, bei Tools, die die statische Analyse auf Terraform, Dockerfiles oder Kubernetes-Manifeste ausweiten.
Manche Tools brauchen Code, der kompiliert. OWASP merkt an, dass viele SAST-Tools Schwierigkeiten haben, Code zu analysieren, der sich nicht kompilieren lässt, und dass Analysten oft die richtigen Bibliotheken, Build-Anweisungen oder die vollständige Codebasis fehlen. OWASP
Ist SAST dasselbe wie statische Codeanalyse?
Fast.
Statische Codeanalyse ist die allgemeine Technik: jedes automatisierte Lesen von Code, ohne ihn auszuführen, einschließlich Stilprüfungen, Bug-Findern und Typprüfern.
SAST ist statische Codeanalyse mit einem Sicherheitsziel. Es nutzt dieselben Compilertechniken, aber seine Regeln suchen nach Schwachstellen, nicht nach Formatierung oder Performance.
Warum SAST 2026 wichtig ist
SAST ist nicht neu. Vier Entwicklungen machen es heute relevanter, nicht weniger relevant.
1. Ausgenutzte Schwachstellen sind der häufigste Weg hinein
Der DBIR 2026 von Verizon beziffert die Ausnutzung von Schwachstellen auf 31 % der analysierten Sicherheitsverletzungen. Der Missbrauch von Zugangsdaten, der bisherige Spitzenreiter, fiel auf 13 %, auch weil Verizon Pretexting jetzt als eigenen Vektor zählt. Verizon DBIR
Nicht jede ausgenutzte Schwachstelle ist ein Programmierfehler in Ihrer eigenen Anwendung: Die Zahl des Berichts umfasst Schwachstellen in jeder Software, auch in Produkten von Drittanbietern.
Der Teil, der in Ihrem eigenen Code steckt, ist aber der Teil, den nur Ihr Team beheben kann, und SAST ist die erste automatisierte Prüfung, die ihn liest.
2. Die ältesten Fehlerklassen stehen immer noch ganz oben
Die 2025 CWE Top 25 Most Dangerous Software Weaknesses, veröffentlicht vom CWE-Programm bei MITRE, führen Cross-Site Scripting (CWE-79) auf Platz eins und SQL Injection (CWE-89) auf Platz zwei.
Beides sind Injection-Fehler, für deren Erkennung SAST gebaut wurde.
Im März 2024 veröffentlichten CISA und FBI gemeinsam einen Secure by Design Alert zur Beseitigung von SQL Injection. Darin heißt es, dass SQL Injection trotz zwei Jahrzehnten Dokumentation und wirksamer Gegenmaßnahmen weiterhin eine verbreitete Schwachstellenklasse ist.
3. Immer mehr Code wird von KI-Assistenten geschrieben
KI-Programmierassistenten schreiben Code schneller, als Menschen ihn prüfen können.
In seinem 2026 GenAI Code Security Report, veröffentlicht im Juli 2026, berichtete Veracode, dass rund 44 % der getesteten Aufgaben zur KI-Codegenerierung Code mit einer bekannten Schwachstelle erzeugten. Die durchschnittliche Sicherheits-Bestehensquote über alle Modelle lag bei 56 %, kaum verändert gegenüber 55 % im ersten Bericht. Es handelt sich um vom Unternehmen berichtete Ergebnisse eines Sicherheitsanbieters, nicht um eine unabhängige Replikation.
Wie hoch die genaue Quote in Ihrer Codebasis auch ist: Mehr generierter Code bedeutet mehr Code, den jemand oder etwas prüfen muss.
4. Frameworks für sichere Entwicklung verlangen Codeanalyse
Das Secure Software Development Framework (SP 800-218) des NIST enthält eine Praxis, menschenlesbaren Code zu prüfen und/oder zu analysieren, um Schwachstellen zu identifizieren, damit sie vor der Veröffentlichung der Software behoben werden können.
Die Aufgabe PW.7.2 verlangt von Teams, das Code-Review oder die Codeanalyse auf Basis ihrer Standards für sicheres Programmieren durchzuführen und alle gefundenen Probleme und empfohlenen Behebungen im Workflow oder Issue-Tracker des Teams festzuhalten und zu triagieren.
SAST ist ein gängiger Weg, die Hälfte „Codeanalyse“ dieser Aufgabe in großem Maßstab zu erfüllen.
SAST vs. DAST
SAST und DAST sind die beiden bekanntesten Testmethoden, und sie betrachten eine Anwendung von entgegengesetzten Seiten.
| SAST | DAST | |
|---|---|---|
| Blickwinkel | Von innen: liest den Code | Von außen: sendet Anfragen an eine laufende Anwendung |
| Voraussetzung | Quellcode, Bytecode oder Binärdateien | Eine bereitgestellte, laufende Anwendung |
| Zeitpunkt | Ab dem ersten Commit | Nachdem die Anwendung gebaut und in einer Testumgebung bereitgestellt wurde |
| Meldet | Datei, Zeile und Codepfad | URL, Anfrage, Antwort und beobachtetes Verhalten |
| Stark bei | Injection-Mustern, unsicheren APIs, Datenflussproblemen | Laufzeitverhalten, Konfiguration, Serverantworten |
| Schwach bei | Laufzeitkontext, Konfiguration, Nachweis der Ausnutzbarkeit | Lokalisieren der verwundbaren Zeile, Code, den der Crawler nie erreicht |
SAST sagt Ihnen, wo eine Schwäche liegen könnte. DAST sagt Ihnen, was die laufende Anwendung tatsächlich tut.
Keines ersetzt das andere. Einen ausführlicheren Vergleich finden Sie in SAST vs. DAST: der Unterschied und warum Sie beides nutzen sollten.
SAST vs. SCA
Software Composition Analysis (SCA) betrachtet den Code, den Sie nicht geschrieben haben.
Sie inventarisiert Open-Source-Pakete und andere Komponenten von Drittanbietern und gleicht deren Versionen mit bekannten Schwachstellen ab.
SAST betrachtet den Code, den Sie selbst geschrieben haben: Ihre Funktionen, Ihre Abfragen, Ihre Handler.
| SAST | SCA | |
|---|---|---|
| Umfang | Eigener Code | Komponenten von Drittanbietern und ihre Versionen |
| Findet | Programmierfehler, oft ohne CVE | Bekannte Schwachstellen, meist mit CVE |
| Typische Korrektur | Ihren Code ändern | Die Komponente aktualisieren, ersetzen oder patchen |
Sie brauchen beides. Eine verwundbare Bibliothek und ein Injection-Fehler in Ihrem eigenen Handler sind unterschiedliche Probleme mit unterschiedlichen Korrekturen.
SAST vs. manuelles Code-Review
Das SSDF des NIST zieht diese Grenze klar. In der Aufgabe PW.7.1 bedeutet Code-Review, dass eine Person den Code direkt ansieht, um Probleme zu finden, und Codeanalyse, dass Tools eingesetzt werden, um Probleme im Code zu finden, entweder vollständig automatisiert oder zusammen mit einer Person. NIST SP 800-218
Beides ergänzt sich:
- SAST ist schnell, wiederholbar und unermüdlich. Es liest jede Zeile bei jedem Commit.
- Ein menschlicher Reviewer versteht die Absicht. Er bemerkt, dass ein Endpunkt „Konto löschen“ nie prüft, wer die Anfrage stellt.
SAST ist am besten eingesetzt, wenn es Reviewer von der Suche nach bekannten Mustern entlastet, damit sie ihre Aufmerksamkeit auf Design und Logik richten können.
So funktioniert SAST
Jede SAST-Engine ist anders, aber die meisten folgen denselben sechs Phasen.
1. Den Code in ein Modell übersetzen
Das Tool liest jede Datei und wandelt sie in eine strukturierte Darstellung um, meist einen abstrakten Syntaxbaum (AST) und dann eine Zwischendarstellung, die näher an dem liegt, was ein Compiler nutzt.
Zuerst kommt die lexikalische Analyse. OWASP beschreibt sie als Umwandlung der Quellcodesyntax in Tokens, um den Code zu abstrahieren und leichter bearbeitbar zu machen. OWASP
2. Kontrollfluss und Datenfluss aufbauen
Als Nächstes ermittelt das Tool, wie das Programm ausgeführt werden kann.
Ein Kontrollflussgraph stellt den Code als Basisblöcke dar, die durch die Sprünge zwischen ihnen verbunden sind. Die Datenflussanalyse verfolgt dann, wie sich Werte durch diese Blöcke bewegen. OWASP
Bessere Engines tun das über Funktionen, Dateien und Module hinweg (interprozedurale Analyse), weil echte Schwachstellen selten in eine einzige Funktion passen.
3. Quellen, Senken und Sanitizer markieren
Hier kommt die Sicherheit ins Spiel.
- Quellen (Sources) sind Stellen, an denen nicht vertrauenswürdige Daten eintreten: Anfrageparameter, Header, Dateien, Nachrichten.
- Senken (Sinks) sind gefährliche Operationen: eine SQL-Abfrage, ein Shell-Befehl, eine HTML-Antwort, ein Dateipfad.
- Sanitizer und sichere APIs machen Daten für eine bestimmte Senke sicher oder halten sie aus dem gefährlichen Teil des Aufrufs heraus: Ausgabekodierung, Pfadnormalisierung, parametrisierte Abfragen.
4. Die Regeln ausführen
Die Engine wendet ihr Regelwerk auf das Modell an.
Manche Regeln sind einfache Muster („diese schwache Hashfunktion wird aufgerufen“). Andere sind Taint-Regeln: OWASP beschreibt die Taint-Analyse so, dass sie Variablen identifiziert, die mit vom Benutzer kontrollierbaren Eingaben belastet (tainted) sind, und sie bis zu einer verwundbaren Funktion verfolgt, der Senke; erreicht der belastete Wert die Senke, ohne bereinigt zu werden, wird er markiert. OWASP
Hier ist der klassische Fall in Java:
// Source: an attacker-controlled request parameter
String username = request.getParameter("username");

// Sink: the value is concatenated into a SQL string
String sql = "SELECT * FROM accounts WHERE username = '" + username + "'";
ResultSet rs = statement.executeQuery(sql);
Eine Taint-Regel sieht, dass username ohne Sanitizer dazwischen von getParameter in executeQuery fließt, und meldet eine SQL Injection (CWE-89) in der Zeile der Abfrage.
Die Korrektur beseitigt die gefährliche Senke. Eine parametrisierte Abfrage übergibt den Wert als Daten, nie als SQL-Text:
String sql = "SELECT * FROM accounts WHERE username = ?";
PreparedStatement ps = connection.prepareStatement(sql);
ps.setString(1, username);
ResultSet rs = ps.executeQuery();
5. Den Befund melden
Jeder Befund erhält einen Schwachstellentyp (meist eine CWE), einen Ort, einen Schweregrad und bei besseren Tools den Pfad von der Quelle zur Senke.
OWASP nennt die Interoperabilität der Ausgabe als Auswahlkriterium und verweist auf SARIF, das Static Analysis Results Interchange Format. SARIF 2.1.0 ist ein OASIS-Standard, der ein gemeinsames Format für die Ausgabe statischer Analysetools definiert. Ergebnisse verschiedener Scanner lassen sich dann von denselben Dashboards und Code-Hosts lesen.
So erscheint ein Befund aus einer SAST-Quelle in der Plexicus-Plattform, mit seiner Codestelle:
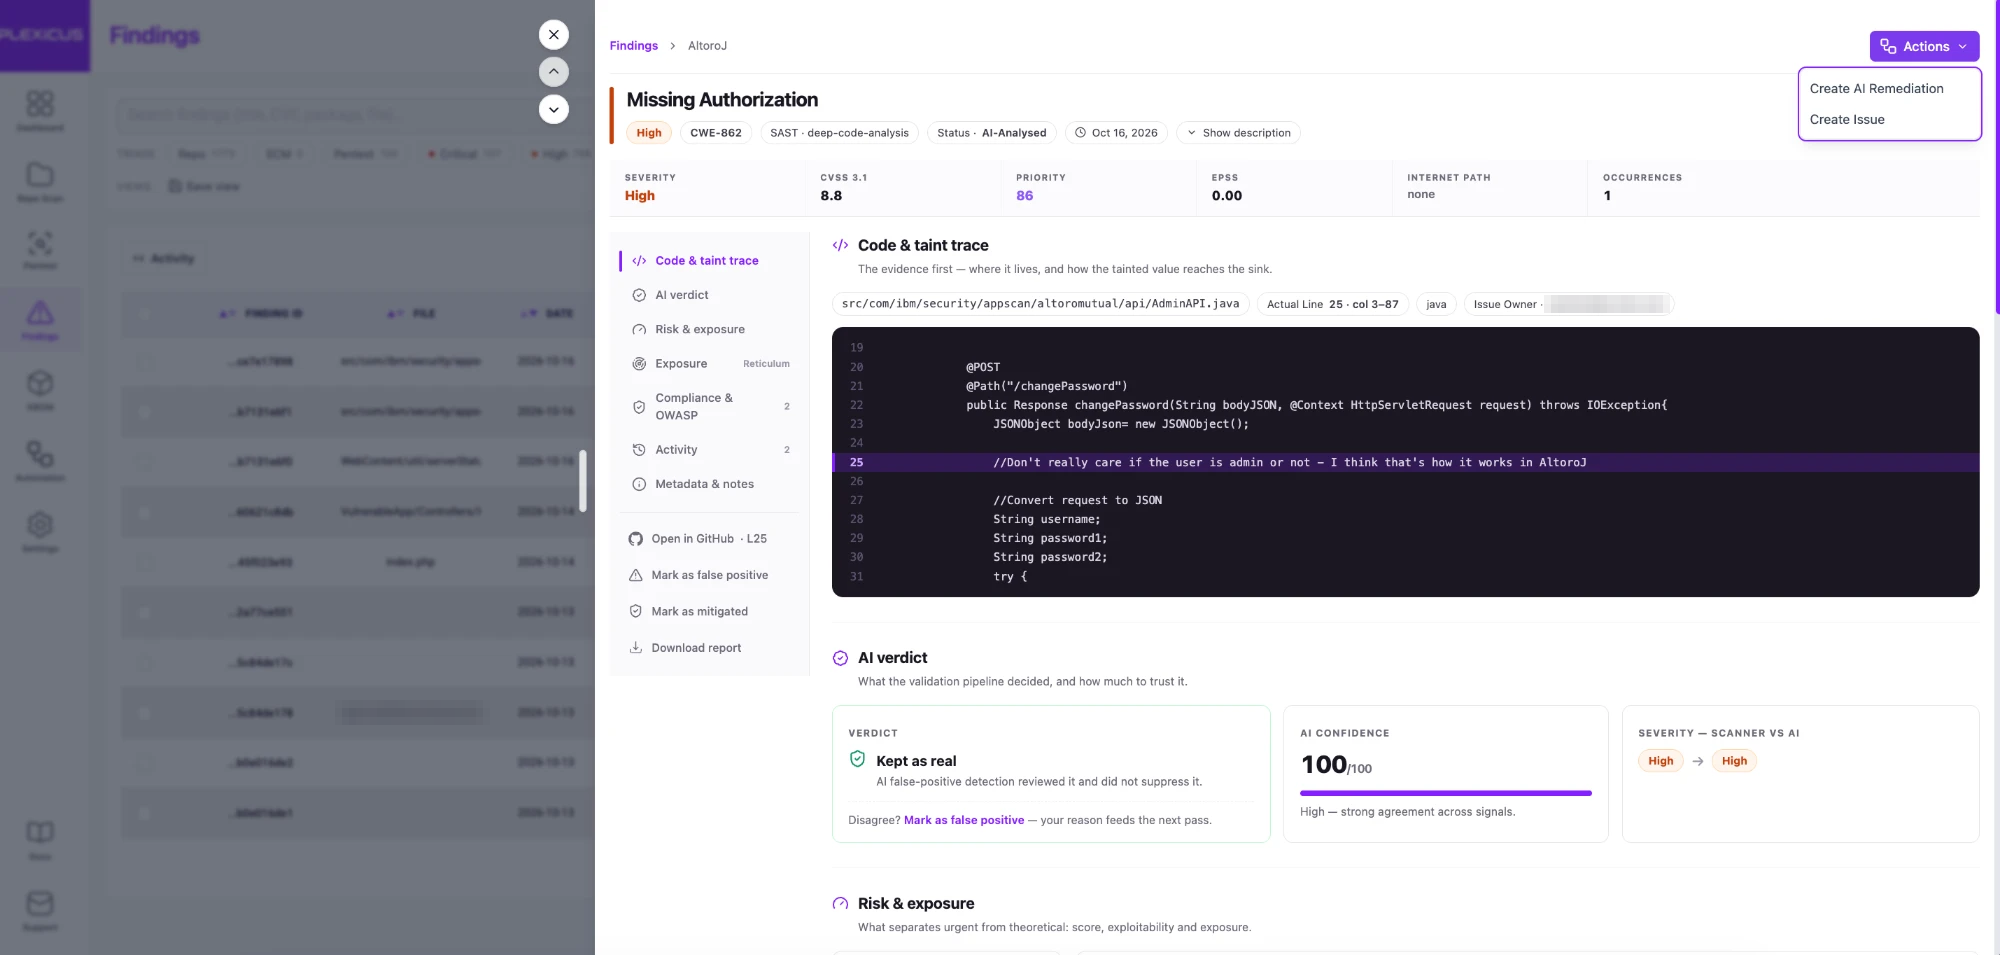
Screenshot: die Detailansicht eines Befunds zu fehlender Autorisierung (CWE-862) in einer Java-Demoanwendung in der Plexicus-Plattform, mit der Quellenbezeichnung SAST und dem geöffneten Abschnitt Code & taint trace an der markierten Zeile. Das Panel mit dem KI-Urteil und das Menü Actions sind sichtbar. Demodaten, aufgenommen im Oktober 2026; die E-Mail-Adresse des Issue-Owners ist verpixelt.
6. Triage
Eine Person oder ein zweiter automatisierter Durchlauf entscheidet, was jeder Befund bedeutet.
Ist er echt, und ist er erreichbar? Ist er relevant, und wer ist für die Korrektur zuständig?
An der Triage entscheidet sich, ob die meisten SAST-Programme gelingen oder scheitern. Ein Tool, das Befunde schneller erzeugt, als das Team sie triagieren kann, erzeugt einen Rückstand, keine Sicherheit.
Techniken der statischen Analyse
SAST-Engines kombinieren einige der folgenden Techniken. Jede wägt Geschwindigkeit, Präzision und Tiefe anders ab.
Mustererkennung (Pattern Matching)
Die Engine durchsucht den Syntaxbaum, manchmal auch den Rohtext, nach bekannt schlechten Konstrukten: einem Aufruf einer schwachen Verschlüsselung, fest codierten Zugangsdaten, einer deaktivierten Zertifikatsprüfung.
Stärken: schnell, Regeln sind leicht zu schreiben und leicht zu erklären.
Grenzen: kein Verständnis dafür, woher Daten kommen; daher markiert sie sichere Verwendungen und übersieht unsichere, die anders aussehen.
Datenfluss- und Taint-Analyse
Die Engine verfolgt Werte von Quellen zu Senken durch das ganze Programm, wie im Java-Beispiel oben.
Stärken: findet Injection-Fehler zusammen mit dem Pfad, der sie erklärt; weniger Warnungen bei Code, der nie nicht vertrauenswürdige Eingaben sieht.
Grenzen: langsamer; die Präzision hängt davon ab, wie gut das Tool Frameworks, Bibliotheken und Sanitizer modelliert; sehr große Programme erzwingen Näherungen.
Semantische und strukturelle Modelle
Manche Engines bauen ein reichhaltigeres Modell der Anwendung: ihre Endpunkte, Parameter, den Aufrufgraphen und die Rollen, die jeden Pfad erreichen können.
Stärken: kann eine Schwäche mit dem Endpunkt verknüpfen, der sie offenlegt, und mit den Daten dahinter, und genau das braucht die Triage.
Grenzen: schwerer zu bauen und trotzdem ein Modell. Es beschreibt, was der Code tun könnte, nicht was ein Angreifer getan hat.
KI-gestützte Analyse
Neuere Tools ergänzen große Sprachmodelle, um Befunde zu erklären, Korrekturen vorzuschlagen oder Rauschen zu filtern.
Stärken: gut lesbare Erklärungen; kann Code einordnen, den Regeln nur schlecht beschreiben.
Grenzen: Ein Sprachmodell, das einen Ausschnitt liest, stellt für sich genommen nicht fest, wie sich eine Schwäche auf die laufende Anwendung auswirkt. Es braucht weiterhin die strukturellen Fakten und idealerweise einen Nachweis.
Warum es nicht reicht, ein Sprachmodell an die Mustererkennung anzuschrauben, erklärt Was ist Deep Code Analysis? genauer.
Was SAST gut findet
OWASP nennt Pufferüberläufe und SQL Injection als Beispiele bekannter Schwachstellen, die SAST-Tools identifizieren, und merkt an, dass sie gut skalieren: Sie lassen sich auf viel Software und wiederholt ausführen, etwa bei nächtlichen Builds oder in der Continuous Integration. OWASP
In der Praxis ist SAST am stärksten bei Fehlern, die im Code selbst sichtbar sind:
| Schwäche | CWE | Warum SAST sie sieht |
|---|---|---|
| Cross-Site Scripting | CWE-79 | nicht vertrauenswürdige Daten fließen ohne Kodierung in eine HTML-Antwort |
| SQL Injection | CWE-89 | nicht vertrauenswürdige Daten fließen in einen Abfragestring |
| OS Command Injection | CWE-78 | nicht vertrauenswürdige Daten fließen in einen Shell-Aufruf |
| Path Traversal | CWE-22 | nicht vertrauenswürdige Daten fließen in einen Dateipfad |
| Code Injection | CWE-94 | nicht vertrauenswürdige Daten fließen in einen Evaluator |
| Out-of-Bounds-Schreibzugriff | CWE-787 | unsichere Speicheroperationen in C und C++ |
| Verwendung fest codierter Zugangsdaten | CWE-798 | ein Secret steht als Literal im Code |
Die ersten sechs dieser Schwächen stehen in den CWE Top 25 von 2025. MITRE CWE
Was SAST übersieht
OWASP benennt die Grenzen direkt. Seine Liste der SAST-Schwächen umfasst: OWASP
- Viele Schwachstellentypen sind automatisch schwer zu finden, darunter Authentifizierungsprobleme, Fehler in der Zugriffskontrolle und unsichere Verwendung von Kryptografie.
- Aktuelle Tools können nur einen relativ kleinen Prozentsatz der Sicherheitsfehler in Anwendungen automatisch identifizieren.
- Viele False Positives.
- Sie sind häufig nicht in der Lage, Konfigurationsprobleme zu finden, weil diese nicht im Code abgebildet sind.
- Es ist schwer nachzuweisen, dass ein identifiziertes Problem eine tatsächliche Schwachstelle ist.
Diese Grenzen decken sich mit den OWASP Top 10
. Ihre erste Kategorie ist Fehlerhafte Zugriffskontrolle (Broken Access Control), ihre zweite Sicherheitsfehlkonfiguration (Security Misconfiguration): genau die beiden Risikoarten, mit denen sich statische Analyse am schwersten tut.Drei weitere blinde Flecken ergeben sich aus der Funktionsweise von SAST:
Geschäftslogik
Ein statisches Tool weiß nicht, dass ein Benutzer nur seine eigenen Rechnungen herunterladen darf. Prüft der Code eine Sitzung, aber nicht die Eigentümerschaft, sieht jede Zeile in Ordnung aus.
Laufzeit und Umgebung
Header, die ein Proxy setzt, ein Feature-Flag in der Produktion, eine zu freizügige Cloud-Einstellung: Nichts davon steht in dem Repository, das das Tool liest.
Ausnutzbarkeit
Ein belasteter Pfad im Code ist eine Hypothese. Ob ein Angreifer ihn aus dem Internet erreichen kann, mit welchen Rechten und was er ihm verschafft, ist eine andere Frage.
SAST beantwortet die Frage „Wo könnte das schiefgehen?“. Es beantwortet nicht die Frage „Kann uns das tatsächlich jemand antun?“.
Warum SAST False Positives erzeugt
Ein False Positive ist ein Befund, der keine echte Schwachstelle ist.
OWASP erklärt die Grundursache: Das Tool kann sich der Integrität und Sicherheit von Daten oft nicht sicher sein, während sie von der Eingabe bis zur Ausgabe durch die Anwendung fließen, und es kann Daten nicht durch Closed-Source-Komponenten oder externe Systeme verfolgen. OWASP
Also muss die Engine sich entscheiden. Kann sie nicht nachweisen, dass ein Pfad sicher ist, kann sie schweigen und einen False Negative riskieren oder melden und einen False Positive riskieren. Ein Sicherheitstool, das in dieser Situation meldet, erzeugt genau die False Positives, die OWASP beschreibt.
Häufige Ursachen:
- Eigene Sanitizer, die das Tool nicht erkennt.
- Framework-Magie: Dependency Injection, Annotationen oder ORMs, die das Tool nicht modelliert.
- Toter Code oder Testcode, der in der Produktion nie läuft.
- Fehlender Kontext: Die Eingabe wird bereits von einem Gateway validiert, das das Tool nicht sehen kann.
Was heißt „zu viele“?
Google hat eine der klarsten Antworten veröffentlicht. In „Lessons from Building Static Analysis Tools at Google“ (Communications of the ACM, 2018) definieren die Engineers des Unternehmens einen effektiven False Positive als ein Problem, auf das Entwickler nach dem Sehen nicht mit einer positiven Maßnahme reagiert haben, selbst wenn das Problem technisch korrekt war.
Die Prüfungen im Code-Review müssen weniger als 10 % effektive False Positives erzeugen, und steigt der Anteil der Klicks auf „Not useful“ für einen Analyzer über 10 %, deaktiviert das Team diesen Analyzer, bis seine Autoren ihn verbessert haben. Das ist Googles interne Praxis, berichtet von den eigenen Engineers.
Die Lehre für jedes Team: Entwickler, nicht Tool-Autoren, entscheiden, ob ein Tool genau ist. Ein Befund, auf den niemand reagiert, kostet Aufmerksamkeit und behebt nichts.
Auch False Negatives zählen
Ein stilles Tool ist kein sicheres Tool.
Ein False Negative ist eine echte Schwachstelle, die das Tool übersehen hat. Einen Scanner so lange zu justieren, bis er nichts Unbequemes mehr meldet, ist der einfachste Weg zu einem sauberen Dashboard und einer unsicheren Anwendung.
So bewerten Sie ein SAST-Tool
Die Auswahlkriterien von OWASP sind eine gute erste Checkliste: OWASP
- Unterstützung Ihrer Programmiersprachen.
- Fähigkeit, die Schwachstellen zu erkennen, die Ihnen wichtig sind, etwa die OWASP Top Ten.
- Genauigkeit: Raten von False Positives und False Negatives sowie der Score im OWASP Benchmark.
- Verständnis der Bibliotheken und Frameworks, die Sie nutzen.
- Ob es baubaren Quellcode braucht und ob es auf Binärdateien laufen kann.
- IDE-Plugins, einfache Einrichtung und Integration in CI/CD.
- Interoperabilität der Ausgabe, zum Beispiel SARIF.
Erst öffentliche Benchmarks nutzen, dann Ihren eigenen Code
Drei öffentliche Ressourcen helfen Ihnen, Tools anhand einer bekannten Ground Truth zu vergleichen:
- OWASP Benchmark. Eine ausführbare Testsuite für Java und Python, die Geschwindigkeit und Genauigkeit von Tools zur Schwachstellenerkennung prüfen soll, mit Scorecard-Generatoren für gängige Tools. Ihr Ziel ist, dass jede Schwachstelle, die sie bewertet, tatsächlich ausnutzbar ist. OWASP Benchmark
- Juliet Test Suites. Geschrieben vom NSA Center for Assured Software und gehostet im Software Assurance Reference Dataset des NIST. Allein die aktuelle Juliet-Suite für C und C++ umfasst 64.099 Testfälle, gegliedert nach 118 CWEs. NIST SARD
- NIST SATE. Die Static Analysis Tool Exposition ist eine wiederkehrende, nicht wettbewerbsorientierte Studie zur Wirksamkeit statischer Analysetools. Laut NIST ist ihr Zweck nicht, das „beste“ Tool zu küren, weil Tools unterschiedliche Stärken haben. Sechs Ausgaben haben stattgefunden, die Ergebnisse der letzten wurden im September 2019 veröffentlicht. NIST SATE
Benchmarks sind synthetisch. Der Test, der zählt, ist Ihr eigenes Repository: Führen Sie jeden Kandidaten auf demselben Code aus, lassen Sie dann einen Engineer eine Stichprobe der Befunde triagieren und zählen Sie, wie viele zu einer echten Korrektur führen.
Eine Liste von Tools für den Einstieg in diesen Vergleich finden Sie in unserer Übersicht der SAST-Tools für sichere Entwicklung.
Best Practices für SAST
1. Mit einem kleinen, vertrauenswürdigen Regelwerk beginnen
Aktivieren Sie die Regeln, auf die Ihr Team reagieren wird: Injection, unsichere Deserialisierung, fest codierte Secrets, schwache Kryptografie. Erweitern Sie das Regelwerk, sobald die ersten Befunde behoben werden.
2. Neue Befunde in Pull Requests prüfen, den Rest als Baseline erfassen
Entwickler nehmen Feedback zu dem Code an, den sie gerade geschrieben haben. Einen Pull-Request-Kommentar mit 400 Problemen aus dem Jahr 2019 ignorieren sie.
Scannen Sie daher jeden Pull Request nur auf neue Befunde und erfassen Sie die bestehenden als Baseline, die Sie nach Risiko und nach eigenem Zeitplan abarbeiten.
SAST ist am nützlichsten, wenn es dort läuft, wo Entwickler bereits arbeiten. Eine gängige Aufteilung:
IDE            -> instant feedback while typing
Pull request   -> scan only the changed code, comment on the diff
CI pipeline    -> full rule set, block on agreed severities
Scheduled scan -> whole repository, new rules, old code
OWASP merkt an, dass Tools, die in die IDE wandern, Entwicklern sofortiges Feedback zu Problemen geben, die sie womöglich gerade einführen, und dass das sehr nützlich ist, verglichen damit, Schwachstellen erst viel später zu finden. OWASP
3. Dem Tool Ihren Code beibringen
Registrieren Sie Ihre eigenen Sanitizer, Validatoren und Framework-Wrapper. Jeder registrierte Eintrag beseitigt eine ganze Familie von False Positives.
4. Effektive False Positives messen
Übernehmen Sie Googles Idee: Messen Sie, wie oft Entwickler auf einen Befund reagieren. Eine Regel, auf die niemand reagiert, muss korrigiert oder entfernt werden.
5. Nach Erreichbarkeit und Exponierung priorisieren
Eine SQL Injection in einem aus dem Internet erreichbaren Endpunkt ist nicht dasselbe wie eine in einem internen Batch-Skript. Ordnen Sie Befunde danach, was sie erreichen kann und was sie selbst erreichen können.
6. Im Workflow der Entwickler festhalten und triagieren
Genau das verlangt das NIST in PW.7.2: Befunde und empfohlene Behebungen werden im Workflow oder Issue-Tracker des Teams festgehalten und triagiert. Ein PDF-Bericht, der einmal pro Quartal per E-Mail verschickt wird, erfüllt das wahrscheinlich nicht.
7. Vor der Eskalation validieren, nach der Korrektur erneut testen
Bevor ein statischer Befund zu einem kritischen Ticket wird, versuchen Sie, ihn nachzuweisen. Ein reproduzierter Exploit oder zumindest ein bestätigter erreichbarer Pfad verändert, wie schnell ein Team handelt.
Eine Korrektur ist nicht erledigt, wenn der Pull Request gemergt ist. Führen Sie die Analyse und idealerweise den Nachweis erneut aus, um zu bestätigen, dass die Schwäche verschwunden ist und die Korrektur sie nicht an eine andere Stelle verschoben hat.
Häufige Fehler bei SAST
Fehler 1: Die Zahl der Befunde als Kennzahl behandeln
Mehr Befunde bedeuten nicht mehr Sicherheit. Zählen Sie stattdessen behobene, validierte Probleme und die Zeit bis zur Behebung.
Fehler 2: Am ersten Tag jede Regel aktivieren
Das Ergebnis sind Tausende Befunde, die auf einmal triagiert werden müssen, und ein Team, das lernt, das Tool zu ignorieren.
Fehler 3: Builds wegen nicht verifizierter Befunde blockieren
Ein Gate, das bei False Positives fehlschlägt, wird umgangen. Blockieren Sie nur bei Regeln, die sich bewährt haben.
Fehler 4: Annehmen, dass ein sauberer Scan eine sichere Anwendung bedeutet
Laut der eigenen Liste von OWASP sind Probleme bei Zugriffskontrolle und Authentifizierung für SAST automatisch schwer zu finden, und Konfigurationsprobleme bleiben häufig unentdeckt. Ein sauberer SAST-Bericht sagt wenig über sie aus.
Fehler 5: Die Korrektur auf „später“ verschieben
Ein Befund ohne Verantwortlichen und ohne vorgeschlagene Änderung ist eine Notiz, keine Sicherheitskontrolle.
SAST und KI-generierter Code
KI-Programmierassistenten verändern die Menge, nicht die Art des Problems.
Die Schwächen in generiertem Code sind die bekannten: Injection, fehlende Autorisierung, schwache Kryptografie, Secrets im Code. Der erste Bericht von Veracode zu dem Thema, eine 2025 veröffentlichte Anbieterstudie, fand Cross-Site Scripting unter den häufigsten Problemen in den generierten Beispielen, die getestet wurden. Veracode
Was sich ändert, ist das Tempo. Wenn ein Entwickler einen 200-zeiligen Vorschlag in Sekunden übernimmt, findet das Review, das früher beim Tippen stattfand, überhaupt nicht statt.
Drei Anpassungen helfen:
- Dort scannen, wo der Code übernommen wird. Scans in der IDE und im Pull Request werden wichtiger, wenn Code in großen Blöcken ankommt.
- Den Assistenten nicht seine eigene Arbeit benoten lassen. Das Tool, das den Code geschrieben hat, ist keine unabhängige Prüfung dieses Codes.
- Den Nachweis im Kreislauf behalten. Generierter Code, der „richtig aussieht“, verdient dieselbe Validierung wie jeder andere Code.
Standards und Frameworks, die Codeanalyse verlangen
NIST SSDF (SP 800-218)
Die aktuelle finale Ausgabe wurde im Februar 2022 veröffentlicht. Die Praxis PW.7 behandelt das Prüfen oder Analysieren von menschenlesbarem Code, und die Aufgabe PW.7.2 verlangt, dass Befunde festgehalten und triagiert werden. NIST
Das NIST veröffentlichte am 17. Dezember 2025 den Entwurf einer Überarbeitung, SP 800-218 Rev. 1; die Kommentierungsfrist endete am 30. Januar 2026, und er ist weiterhin ein Entwurf. NIST
OWASP Top 10
Die aktuelle Ausgabe der Awareness-Liste von OWASP. Injection ist A05, Fehlerhafte Zugriffskontrolle ist A01. SAST deckt einen Teil der Liste gut und einen anderen Teil schlecht ab, wie oben gezeigt. OWASP
CWE Top 25 (2025)
Die Rangliste der gefährlichsten Softwareschwächen von MITRE. CWE-Kennungen geben Tools eine gemeinsame Sprache: Ein Befund, der CWE-89 zugeordnet ist, bedeutet in jedem Tool SQL Injection. MITRE CWE
OWASP ASVS
Der Application Security Verification Standard, dessen neueste stabile Version 5.0.0 ist, listet detaillierte Anforderungen an die Sicherheitsverifizierung auf. Manche lassen sich durch Lesen des Codes prüfen, andere brauchen Tests oder ein Review. OWASP ASVS
SARIF
Das OASIS-Standardformat für Ergebnisse statischer Analysen. Damit können Sie Scanner austauschen oder kombinieren, ohne Ihr Reporting neu aufzubauen. Version 2.1.0 ist der verabschiedete Standard; ein Committee Draft der nächsten Version wurde im Oktober 2026 veröffentlicht. OASIS
Vom SAST-Befund zum Nachweis
Hier ist die ehrliche Zusammenfassung zu SAST.
Es ist das beste Werkzeug, das Sie haben, um jede Zeile Ihres Codes jeden Tag zu lesen.
Nach Aussage von OWASP selbst ist es zugleich ein Werkzeug, das nur einen relativ kleinen Anteil der Sicherheitsfehler automatisch findet, False Positives erzeugt und sich schwertut nachzuweisen, dass das Gefundene ausnutzbar ist.
Ein Penetrationstest steht am anderen Ende: Er versucht, das laufende System so auszunutzen, wie es ein Angreifer tun würde.
Wo SAST sagt „dieser Codepfad könnte SQL Injection ermöglichen“, sagt ein Pentest „wir haben diese Datensätze über diese Anfrage ausgelesen“. Das ist der Unterschied zwischen einer Hypothese und einem Nachweis.
Die Frage lautet also nicht „SAST oder etwas anderes“. Sie lautet, was nach dem Befund passiert:
Static finding    -> "this code path might be vulnerable"
Code context      -> "this is the endpoint, the data and the role behind it"
Validation        -> "here is the evidence that it can be exploited"
Reviewed fix      -> "here is the change, with the reasoning and a test"
Re-test           -> "the proof no longer reproduces"
Diese Kette nennen wir Proof-Driven AppSec. Ihre Regel ist kurz: no PoC, no finding.
Ein statischer Alarm ist der Punkt, an dem die Arbeit beginnt. Belege sind das, was ein Team in Bewegung bringt.
Wo Plexicus ansetzt
Plexicus behandelt SAST als erstes Signal und ergänzt dann Kontext, Nachweis und Korrektur.
Mit einem Scan beginnen. Das kostenlose SAST-Tool scannt Ihren GitHub-Quellcode mit reinem Lesezugriff. Laut Plexicus wird kein Code gespeichert und keiner für KI-Training genutzt.
Der Bericht listet die erkannten Schwachstellen mit einer Aufschlüsselung nach Schweregrad, CVE-Referenzen und CVSS-Bewertung auf. Der kostenlose Scan verbindet sich heute mit GitHub; GitLab und Bitbucket sind als „demnächst verfügbar“ aufgeführt.
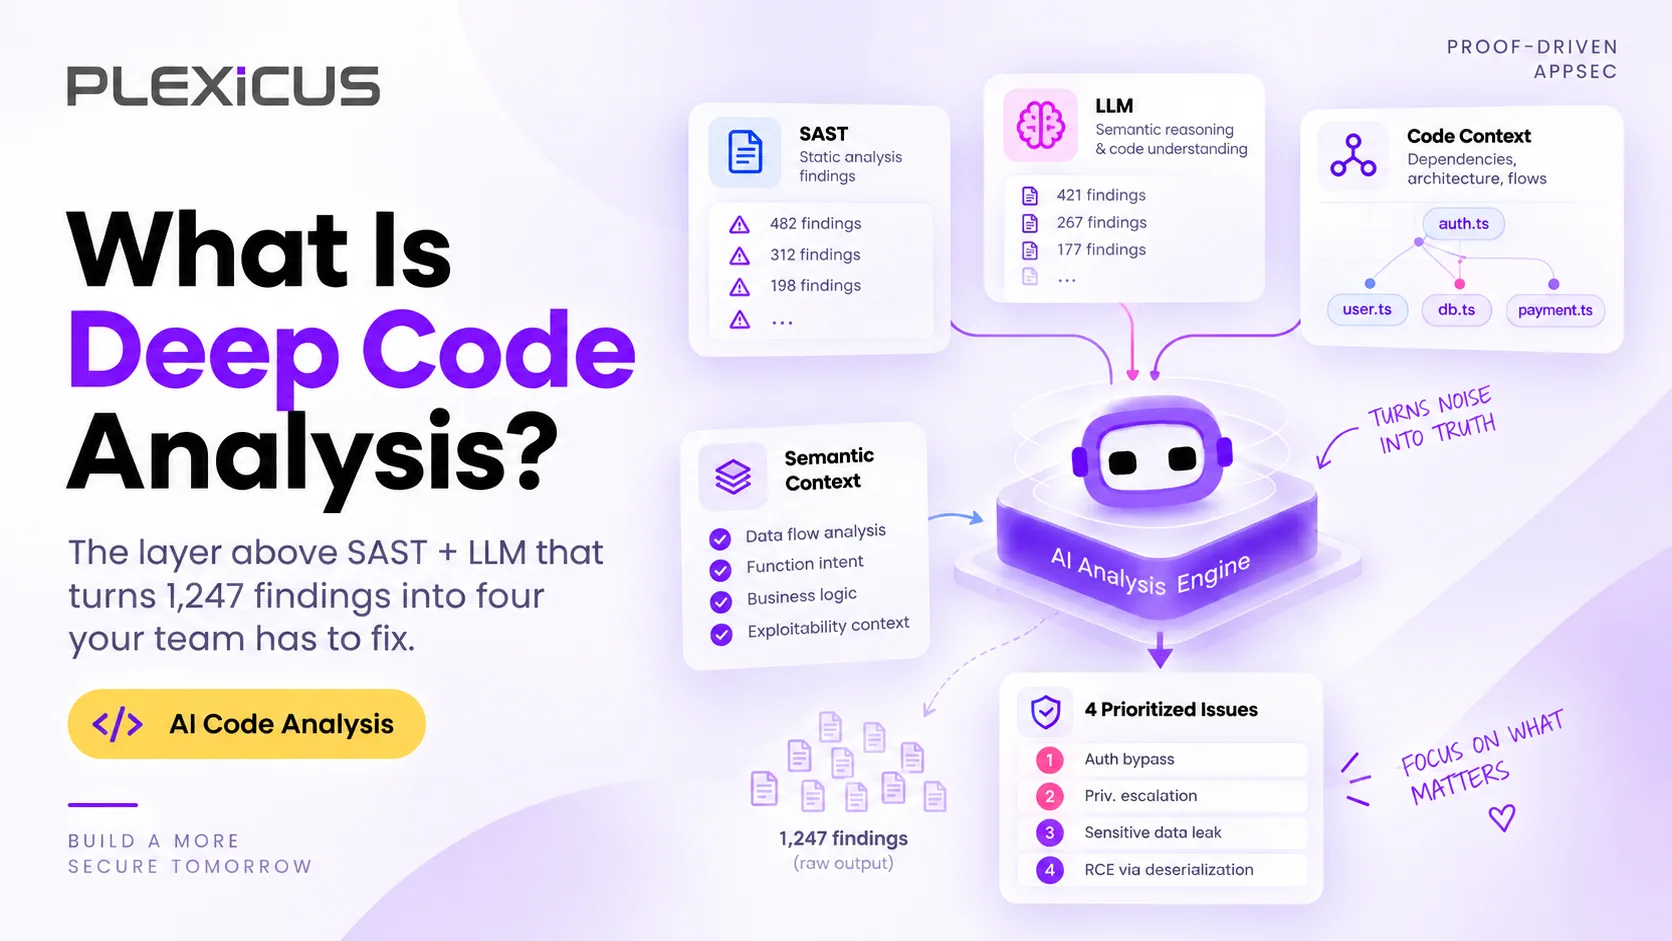
Kontext ergänzen. Deep Code Analysis verbindet Code, Datenfluss und geschäftliche Auswirkungen. Die Produktseite benennt den Unterschied klar: SAST kann ein Muster markieren und ein Sprachmodell kann Code erklären, aber keines von beiden stellt fest, wie sich eine Schwäche auf die Anwendung auswirkt.
Deep Code Analysis verfolgt den betroffenen Codepfad, sodass Engineers die Endpunkte, Parameter und Geschäftslogik sehen, die ein Befund berührt, verknüpft jeden Befund mit den Daten, die er erreichen kann, und der Rolle, die ihn auslösen kann, und ordnet die Schwachstellenklasse einer CWE zu. Die Seite nennt 12 Sprachen: JavaScript, TypeScript, Python, Go, Java, Rust, Ruby, PHP, C#, Swift, Kotlin und Scala.
Nachweisen. Deep Code Analysis ergänzt den Kontext, und AI Swarm Pentest validiert die Befunde mit der höchsten Priorität. AI Swarm Pentest validiert ausnutzbare Pfade in Ihrer Anwendung, Ihrer API und Ihrem Quellcode innerhalb eines autorisierten Scopes, mit unabhängiger Verifizierung und ohne automatische Änderungen an der Produktion. Unsere Einführung in AI Swarm Pentest erklärt, wie der Schwarm von Agenten arbeitet.
Beheben. Sobald ein Befund verifiziert ist, bereitet Plexicus Remediation den Behebungskontext und eine vorgeschlagene Änderung vor. Für klassische SAST-Befunde wie SQL Injection, XSS, SSRF, unsichere Deserialisierung und schwache Kryptografie bereitet Plexicus geprüfte Patches mit angehängten Regressionstests vor, wo sie relevant sind, und ein Retest-Hook ist an die CI angebunden. Ihr Team behält die Kontrolle über den Merge: Plexicus pusht nie in die Produktion.
So sieht ein statischer SQL-Injection-Befund aus, sobald eine Korrektur vorgeschlagen wurde:
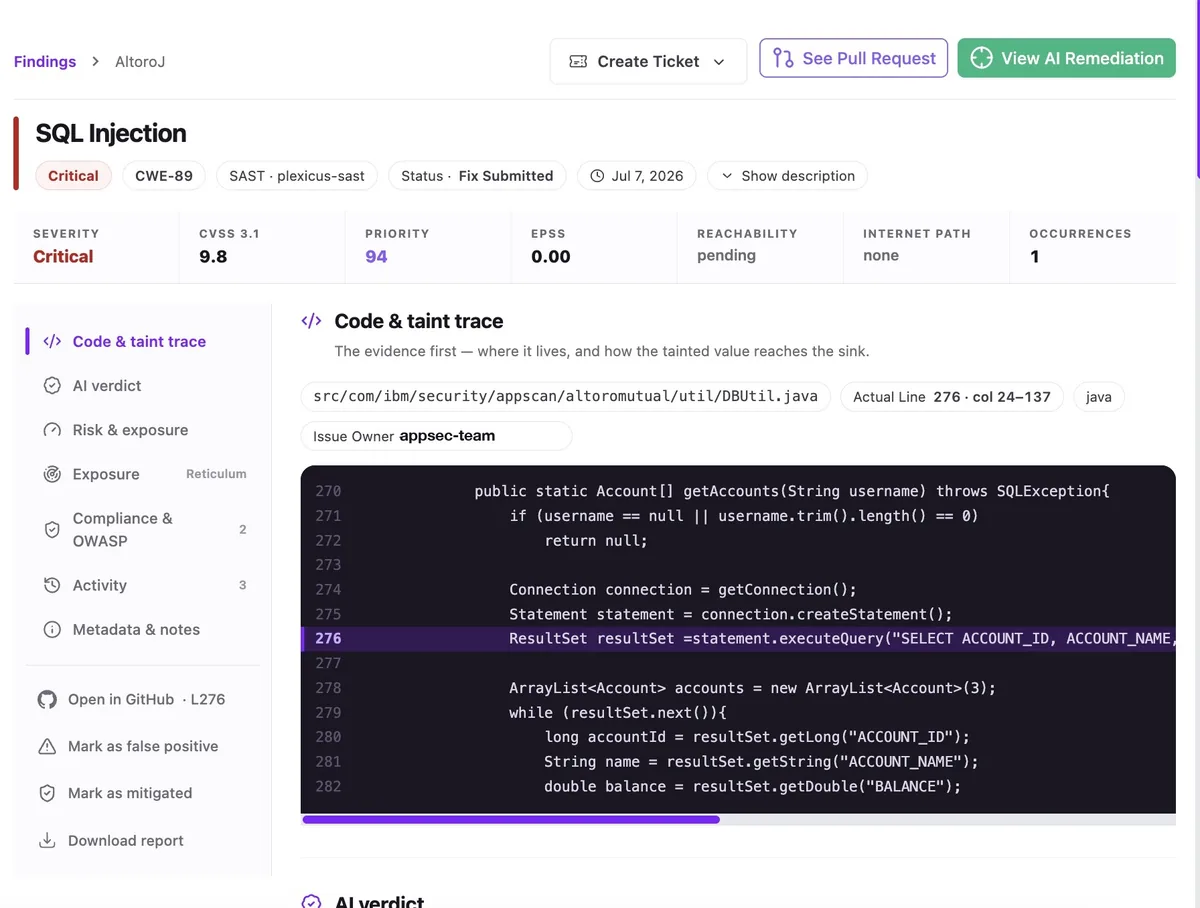
Screenshot: ein kritischer SQL-Injection-Befund (CWE-89) in einer Java-Demoanwendung mit der Quellenbezeichnung SAST und dem Status Fix Submitted, dargestellt in der Plexicus-Plattform. Die Werkzeugleiste bietet Create Ticket, See Pull Request und View AI Remediation. Demodaten aus einer früheren Version der Plexicus-Oberfläche, Juli 2026.
Zusammengenommen ist das ein geschlossener Kreislauf mit PR: ein statisches Signal, Kontext, Belege für das, was zählt, und dann eine geprüfte Änderung, über deren Merge Ihr Team entscheidet.
Wo SAST in einem vollständigen Programm sitzt, zeigt unser vollständiger Leitfaden zur Anwendungssicherheit. Was nach der Validierung passiert, erklärt Einführung in KI-native Behebung.
Häufig gestellte Fragen
Wofür steht SAST?
SAST steht für Static Application Security Testing, also statische Anwendungssicherheitstests: die Analyse des Codes einer Anwendung auf Sicherheitsschwächen, ohne ihn auszuführen.
Was ist der Unterschied zwischen SAST und DAST?
SAST liest den Code von innen, ohne ihn auszuführen. DAST testet eine laufende Anwendung von außen, indem es Anfragen sendet. SAST lokalisiert die Zeile, DAST zeigt das echte Laufzeitverhalten.
Was ist der Unterschied zwischen SAST und SCA?
SAST analysiert den Code, den Ihr Team geschrieben hat. SCA inventarisiert Komponenten von Drittanbietern und Open-Source-Komponenten und gleicht deren Versionen mit bekannten Schwachstellen ab.
Welche Schwachstellen kann SAST finden?
SAST ist am stärksten bei Fehlern, die im Code sichtbar sind: SQL Injection, Cross-Site Scripting, Command Injection, Path Traversal, Code Injection, unsichere Speicheroperationen und fest codierte Zugangsdaten.
Was kann SAST nicht finden?
Laut OWASP tut sich SAST schwer mit Authentifizierungsproblemen, Fehlern in der Zugriffskontrolle, unsicherer Verwendung von Kryptografie und Konfigurationsproblemen, und es tut sich schwer nachzuweisen, dass ein Befund ausnutzbar ist. Fehler in der Geschäftslogik sind für SAST ebenfalls weitgehend unsichtbar.
Warum erzeugt SAST so viele False Positives?
Kann ein Tool nicht nachweisen, dass Daten auf dem Weg von der Eingabe zur Ausgabe sicher sind, meldet es sie meist. Eigene Sanitizer, Frameworks, die das Tool nicht modelliert, und fehlender Laufzeitkontext sind die häufigsten Ursachen.
Wie reduzieren Sie SAST-False-Positives?
Beginnen Sie mit einem kleinen Regelwerk, registrieren Sie Ihre Sanitizer und Framework-Wrapper, scannen Sie in Pull Requests nur neuen Code, messen Sie, wie oft Entwickler auf Befunde reagieren, und validieren Sie Befunde mit hohem Schweregrad, bevor Sie sie eskalieren.
Ist SAST für die Compliance vorgeschrieben?
Frameworks wie das NIST SSDF verlangen Code-Review oder Codeanalyse mit festgehaltenen und triagierten Befunden, nennen aber kein bestimmtes Tool. SAST ist ein gängiger Weg, den Teil Codeanalyse in großem Maßstab zu erfüllen.
Reicht SAST allein aus?
Nein. SAST ist eine Schicht. Ein Programm braucht außerdem SCA für Abhängigkeiten, Laufzeittests und eine Möglichkeit nachzuweisen, welche Befunde ausnutzbar sind, bevor das Team Zeit in ihre Behebung steckt.
Jeder statische Befund muss sich beweisen
Lesen Sie jede Zeile mit SAST und investieren Sie die Zeit Ihres Teams dann nur in das, was sich nachweisen lässt.
Plexicus Deep Code Analysis entdecken →
Sie möchten einen ersten Blick auf Ihren eigenen Code werfen? Nutzen Sie das kostenlose SAST-Tool, einen statischen Scan Ihres GitHub-Quellcodes.