Apresentando a remediação nativa de IA: da descoberta validada à correção revisada
Como uma descoberta validada se torna um pull request pronto para revisão, com evidências, testes de regressão e reteste, e por que o merge continua com a sua equipe.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestEncontrar vulnerabilidades nunca foi tão barato.
Corrigi-las não acompanhou o ritmo.
Scanners, pentests e agentes de IA agora produzem descobertas mais rápido do que as equipes de engenharia conseguem lê-las. O backlog cresce. O risco continua em produção.
A remediação nativa de IA é a prática de transformar uma descoberta de segurança validada em uma alteração de código pronta para revisão, com as evidências, o raciocínio e os testes anexados, para que uma pessoa possa fazer o merge com confiança e um reteste possa comprovar que a correção funcionou.
Não é um bot que envia patches direto para produção.
É a última etapa de um ciclo fechado: comprovar o problema, entendê-lo no código, propor a alteração, deixar uma pessoa decidir e, então, comprovar que o problema desapareceu.
A necessidade é mensurável. No Data Breach Investigations Report 2026, a Verizon constatou que a exploração de vulnerabilidades se tornou o vetor de acesso inicial mais comum, presente em 31% das violações da sua base de dados com vetor de acesso inicial conhecido. O mesmo relatório mostrou que apenas 26% das Known Exploited Vulnerabilities (KEV) da CISA encontradas nos ambientes das organizações foram totalmente remediadas em 2025, contra 38% no ano anterior, e o tempo mediano até a resolução completa subiu para 43 dias.
Os invasores estão aproveitando a distância entre “encontrado” e “corrigido”. A remediação nativa de IA existe para fechar essa distância sem abrir mão do controle.
O que é remediação nativa de IA?
A remediação nativa de IA é um fluxo de remediação projetado em torno da IA desde o início: o sistema lê uma descoberta validada, reúne o contexto de código ao redor dela, redige uma correção mínima com testes e uma explicação, abre essa correção como um pull request para revisão humana e retesta a prova original depois da alteração.
Três palavras dessa definição fazem a maior parte do trabalho.
Validada. A entrada é uma descoberta que já se mostrou real, não um alerta bruto. Se o problema não pode ser reproduzido, ainda não há nada para corrigir.
Pronta para revisão. A saída é uma alteração que um desenvolvedor consegue avaliar em minutos: um diff pequeno, o motivo pelo qual ele resolve a fraqueza, os testes que a cobrem e os locais do código-fonte envolvidos.
Retestada. A correção não termina quando entra no merge. Ela termina quando a prova original deixa de funcionar.
Remova qualquer uma dessas três e o resultado fica mais fraco.
Sem validação, você automatiza correções para problemas que talvez nem existam.
Sem revisão, você entrega acesso de escrita a um modelo.
Sem reteste, você tem uma alteração que parece certa e talvez não seja.
Por que a remediação é o gargalo em 2026
A detecção escalou primeiro. A remediação, não.
Os números de fontes independentes apontam na mesma direção.
Os dados de aplicação de patches.
O DBIR 2026 mediu a remediação de vulnerabilidades listadas no KEV que scanners encontraram nos ambientes das organizações, com dados agregados de mais de 13.000 organizações. Três resultados se destacam:
- Apenas 26% dessas vulnerabilidades do KEV foram totalmente remediadas em 2025, contra 38% no ano anterior.
- O tempo mediano até a resolução completa passou de 32 para 43 dias.
- A organização mediana tinha 16 vulnerabilidades do KEV para corrigir, contra 11 no ano anterior, o que o relatório chama de quase 50% a mais.
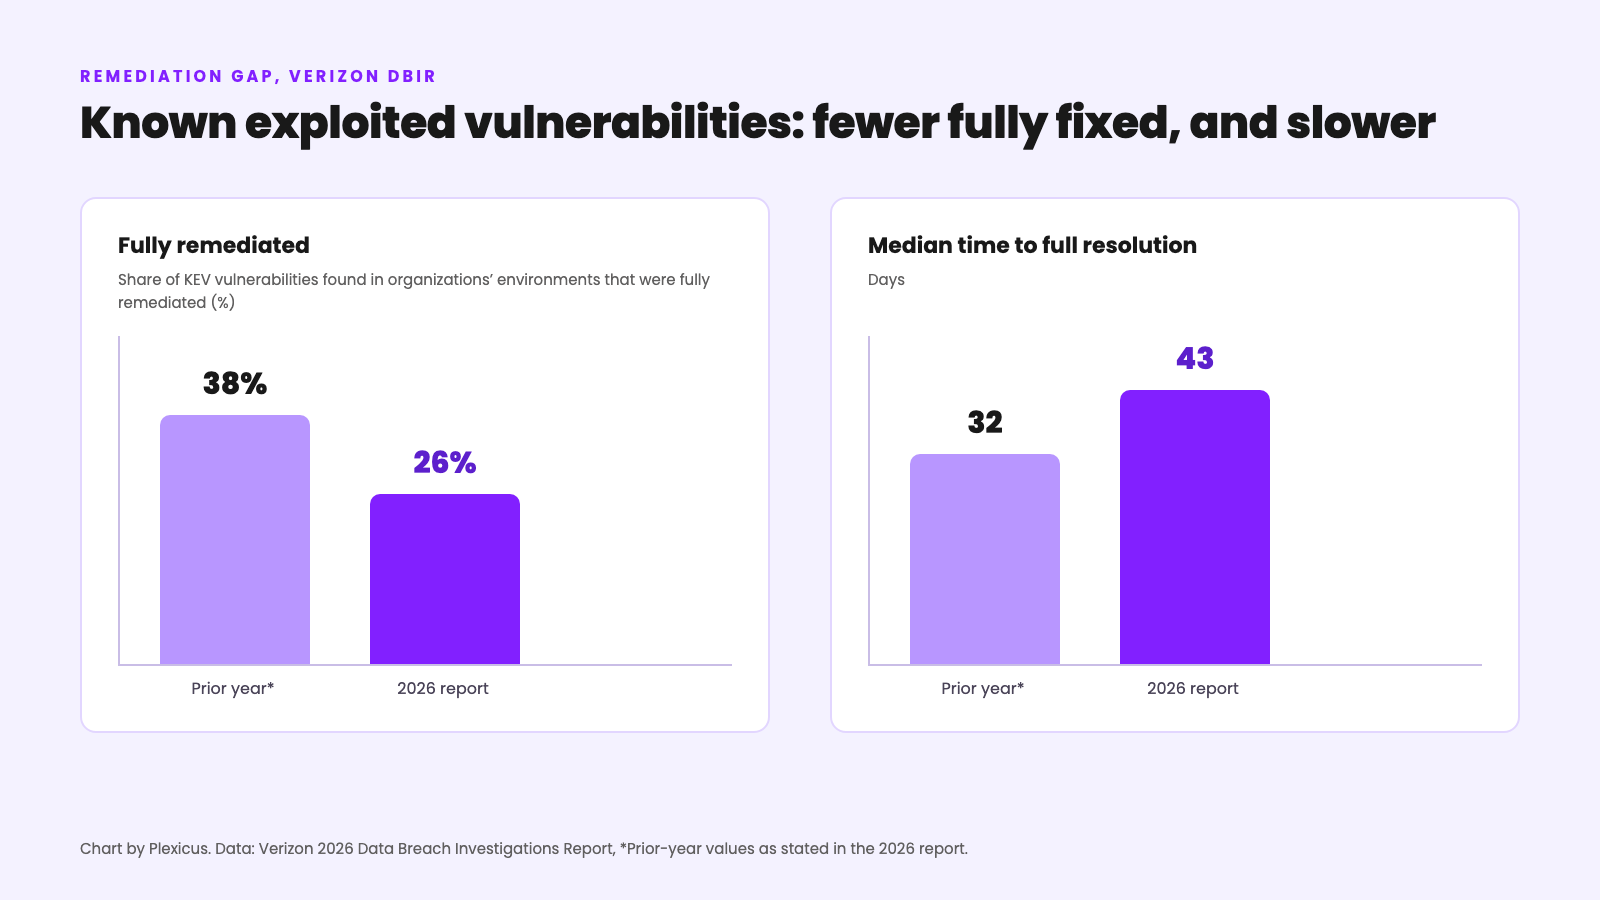
Gráfico elaborado pela Plexicus a partir dos números publicados no Verizon Data Breach Investigations Report 2026; os valores do ano anterior são os que o próprio relatório apresenta para comparação.
Esses números descrevem a aplicação de patches em vulnerabilidades conhecidas nos ambientes das organizações, não correções em código próprio de aplicações. Mesmo assim, mostram o formato do problema: a fila cresce mais rápido do que as equipes conseguem fechá-la.
Os prazos.
Para as agências federais dos EUA, o prazo não é uma questão de preferência. A Binding Operational Directive (BOD) 26-04 da CISA, emitida em 10 de junho de 2026, revogou a BOD 22-01 e substituiu os prazos padrão do KEV dessa diretiva por prazos de remediação baseados em risco para as agências civis do poder executivo federal.
Quatro fatores definem o prazo de cada ativo:
- Se ele está exposto publicamente.
- Se a vulnerabilidade consta do catálogo KEV.
- Se um adversário consegue automatizar todas as etapas necessárias para explorá-la.
- Se uma exploração bem-sucedida dá controle parcial ou total do ativo.
Os prazos mudam quando esses fatos mudam: o prazo de uma vulnerabilidade fica mais curto quando a CISA a inclui no catálogo KEV. As agências já devem remediar as vulnerabilidades do KEV até as datas limite do catálogo KEV e cumprir os prazos completos para toda vulnerabilidade com ID de CVE em até 180 dias após a emissão.
Na Europa, o Cyber Resilience Act entrou em vigor em 10 de dezembro de 2024. Segundo a Comissão Europeia, suas obrigações de notificação se aplicam a partir de 11 de setembro de 2026 e as obrigações principais a partir de 11 de dezembro de 2027. Fabricantes de produtos com elementos digitais agora precisam notificar vulnerabilidades exploradas ativamente.
A regulação não escreve patches. Mas reduz o tempo que uma equipe pode gastar decidindo se vai escrevê-los.
O código que está sendo escrito.
O volume de código novo também está mudando. O 2025 GenAI Code Security Report da Veracode testou mais de 100 grandes modelos de linguagem em tarefas de programação e relatou que 45% das amostras de código falharam em testes de segurança e introduziram fraquezas do OWASP Top 10. São resultados divulgados pelo próprio fornecedor, com o conjunto de testes da Veracode, e não uma replicação independente.
Mesmo com essa ressalva, a direção é clara. Ferramentas de programação com IA aumentam a quantidade de código que chega à revisão. Parte desse código traz as mesmas falhas clássicas que as equipes de segurança corrigem há vinte anos.
O volume de divulgações.
A metodologia do CWE Top 25 de 2025 do MITRE analisou 39.080 registros de CVE publicados entre 1º de junho de 2024 e 1º de junho de 2025. Isso é um ano de registros de CVE publicados, antes de contar o que seus próprios scanners e testes encontram no seu próprio código.
Mais descobertas, prazos mais curtos, mais código. A restrição não é mais enxergar o problema. É fechá-lo.
O que “nativa de IA” significa e o que não significa
“Nativa de IA” é um termo fácil de usar mal, então vale ser preciso.
Um fluxo de remediação nativa de IA é aquele em que a IA faz parte do projeto do pipeline: ela recebe evidências estruturadas, trabalha sobre o repositório real, produz uma saída estruturada e é verificada por testes e por uma pessoa.
Isso é diferente de acoplar uma janela de chat a um scanner.
Também é diferente de autonomia sem limites.
A IA redige. Os testes verificam. As pessoas decidem. Um reteste confirma.
Nesse sentido, “nativa de IA” descreve onde a IA fica no ciclo, não quanta autoridade ela tem.
Quanto mais trabalho a IA faz, mais evidências e revisão o fluxo precisa ao redor dela.
Remediação nativa de IA vs. gerenciamento automatizado de patches
O gerenciamento automatizado de patches e os bots de atualização de dependências resolvem muito bem um problema mais restrito.
A documentação do GitHub sobre atualizações de segurança do Dependabot descreve o padrão: quando uma dependência tem um aviso de segurança publicado, o Dependabot verifica se consegue atualizá-la para uma versão corrigida sem quebrar o grafo de dependências e, então, abre um pull request que atualiza a dependência para a versão mínima que inclui o patch.
É um fluxo valioso. Mantenha-o.
Mas ele responde a uma pergunta: existe uma versão mais recente deste pacote sem a vulnerabilidade conhecida?
O pull request de atualização de versão, por si só, não responde:
- Seu código realmente chama a função vulnerável?
- A falha está no seu próprio código, e não em uma biblioteca?
- A correção exige mudar a forma como sua aplicação chama a biblioteca?
- O problema real é uma verificação de autorização que nunca foi escrita?
A remediação nativa de IA parte de uma entrada diferente. Ela começa com uma descoberta validada na sua aplicação, incluindo código próprio, e pode propor alterações nesse código, não apenas em um manifesto.
As duas abordagens funcionam bem juntas. Uma atualização de versão costuma ser a correção certa. Às vezes, não basta.
Remediação nativa de IA vs. sugestões de código com IA
Sugestões de IA no editor ou em um pull request ajudam o desenvolvedor que já está olhando para o problema.
Elas são úteis. Também são outra coisa.
Uma sugestão inline geralmente parte de um alerta de scanner ou de um prompt do desenvolvedor. Ela propõe uma edição. O desenvolvedor decide se o alerta era real e se a edição está correta.
A remediação nativa de IA antecipa duas dessas decisões e as torna explícitas:
- A descoberta é real? O fluxo só aceita descobertas validadas com evidências.
- A correção funciona? O fluxo anexa testes e executa novamente a prova original.
O desenvolvedor continua revisando a alteração. Só que revisa com mais contexto e menos adivinhação.
Remediação nativa de IA vs. remediação manual
A remediação manual é a referência e continua sendo a ferramenta certa para os problemas mais difíceis.
Um engenheiro sênior entende a intenção do design, as convenções da equipe e as regras de negócio que nenhum relatório de descobertas contém. Para uma falha com raiz na arquitetura, uma pessoa deve liderar.
A fraqueza da remediação manual não é a qualidade. É a vazão e a consistência.
Cada descoberta exige alguém para reproduzi-la, localizá-la, entendê-la, desenhar uma correção, escrever testes e abrir um pull request. Esse trabalho disputa espaço com o roadmap do produto, e o roadmap costuma vencer.
A remediação nativa de IA assume a parte repetitiva dessa sequência e mantém a decisão com o engenheiro.
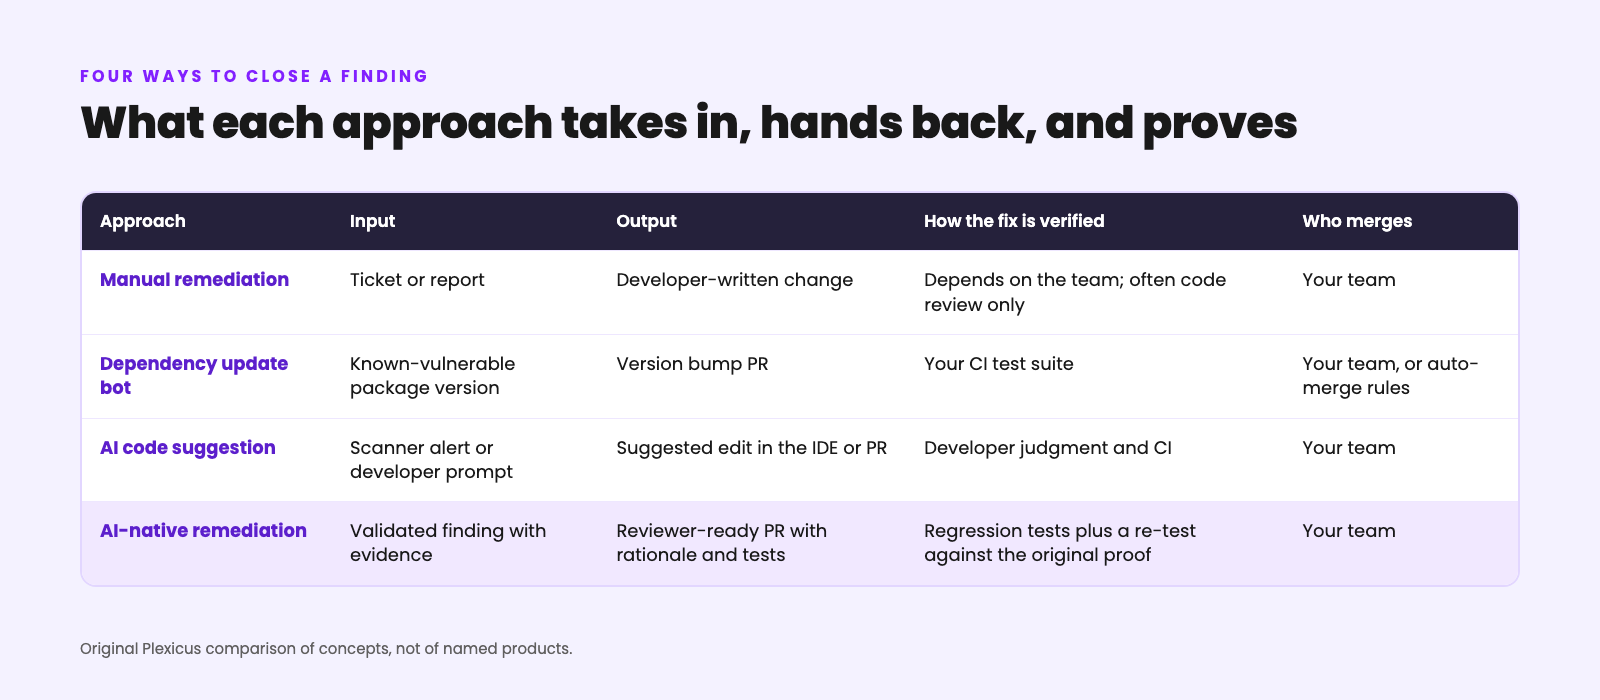
Comparação original da Plexicus entre as quatro abordagens como conceitos; ela não descreve nenhum produto específico.
Como funciona a remediação nativa de IA
Um fluxo completo tem sete etapas. Cada uma entrega à seguinte um artefato específico. O diagrama abaixo agrupa essas etapas em cinco passos.
Validated finding + evidence
        ↓
Code context and root cause
        ↓
Fix strategy
        ↓
Drafted change + tests + rationale
        ↓
Automated checks (CI)
        ↓
Human review and merge decision
        ↓
Re-test against the original proof
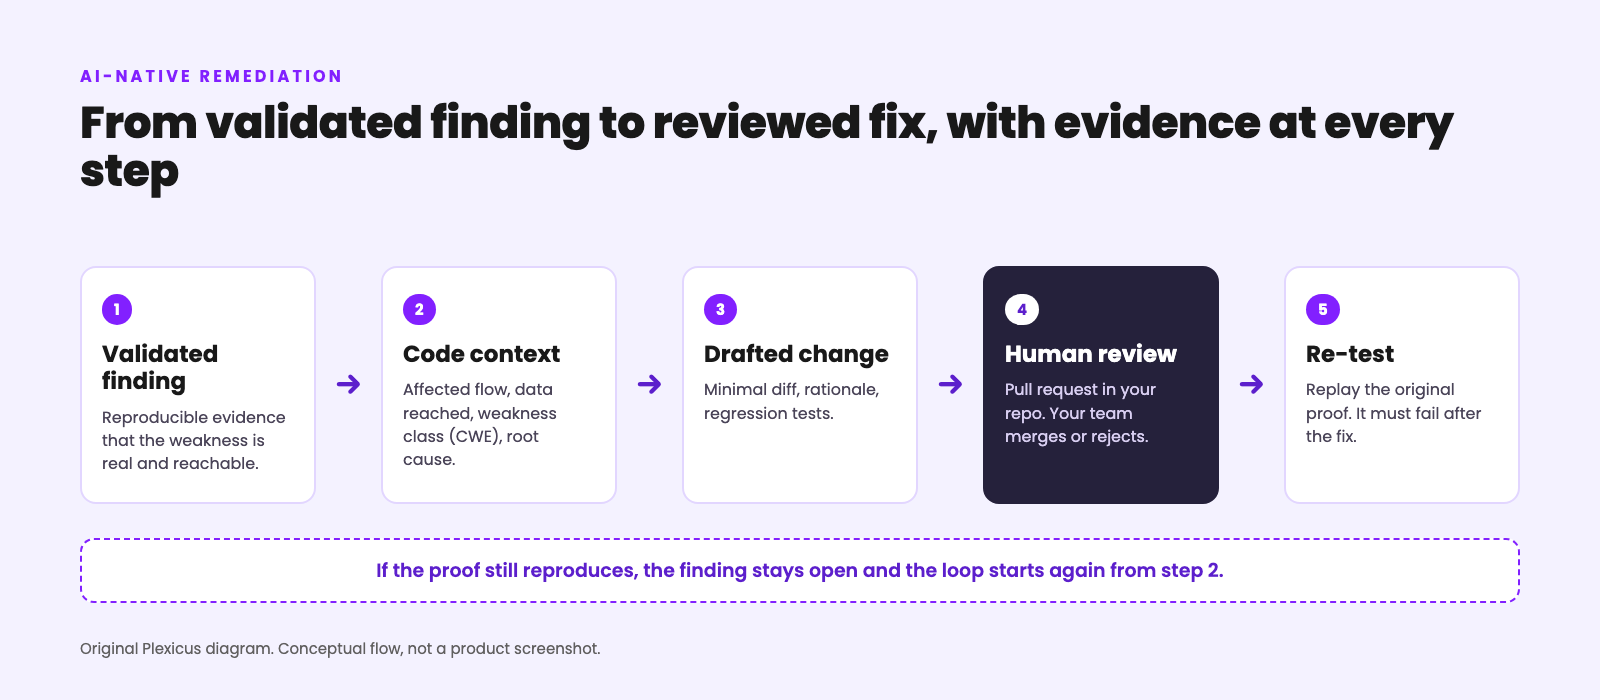
Diagrama original da Plexicus do ciclo de remediação; é um fluxo conceitual, não uma captura de tela do produto.
1. Partir de uma descoberta validada
A entrada é uma descoberta com evidências: a solicitação que acionou a falha, a resposta que a comprovou, os dados que foram alcançados, o papel de acesso que conseguiu alcançá-los.
Uma descoberta sem evidências é uma hipótese. Remediar com base em uma hipótese desperdiça tempo de revisão e corrói a confiança em todos os pull requests seguintes.
2. Reunir o contexto de código e a causa raiz
O sistema rastreia a descoberta até o código: o endpoint, o handler, a função, o parâmetro e o fluxo de dados entre eles.
Ele também identifica a classe da fraqueza, normalmente como uma entrada CWE, por exemplo CWE-89 para injeção de SQL. A classe importa porque o padrão de correção depende dela.
Veja o contexto de código de uma descoberta na plataforma da Plexicus.
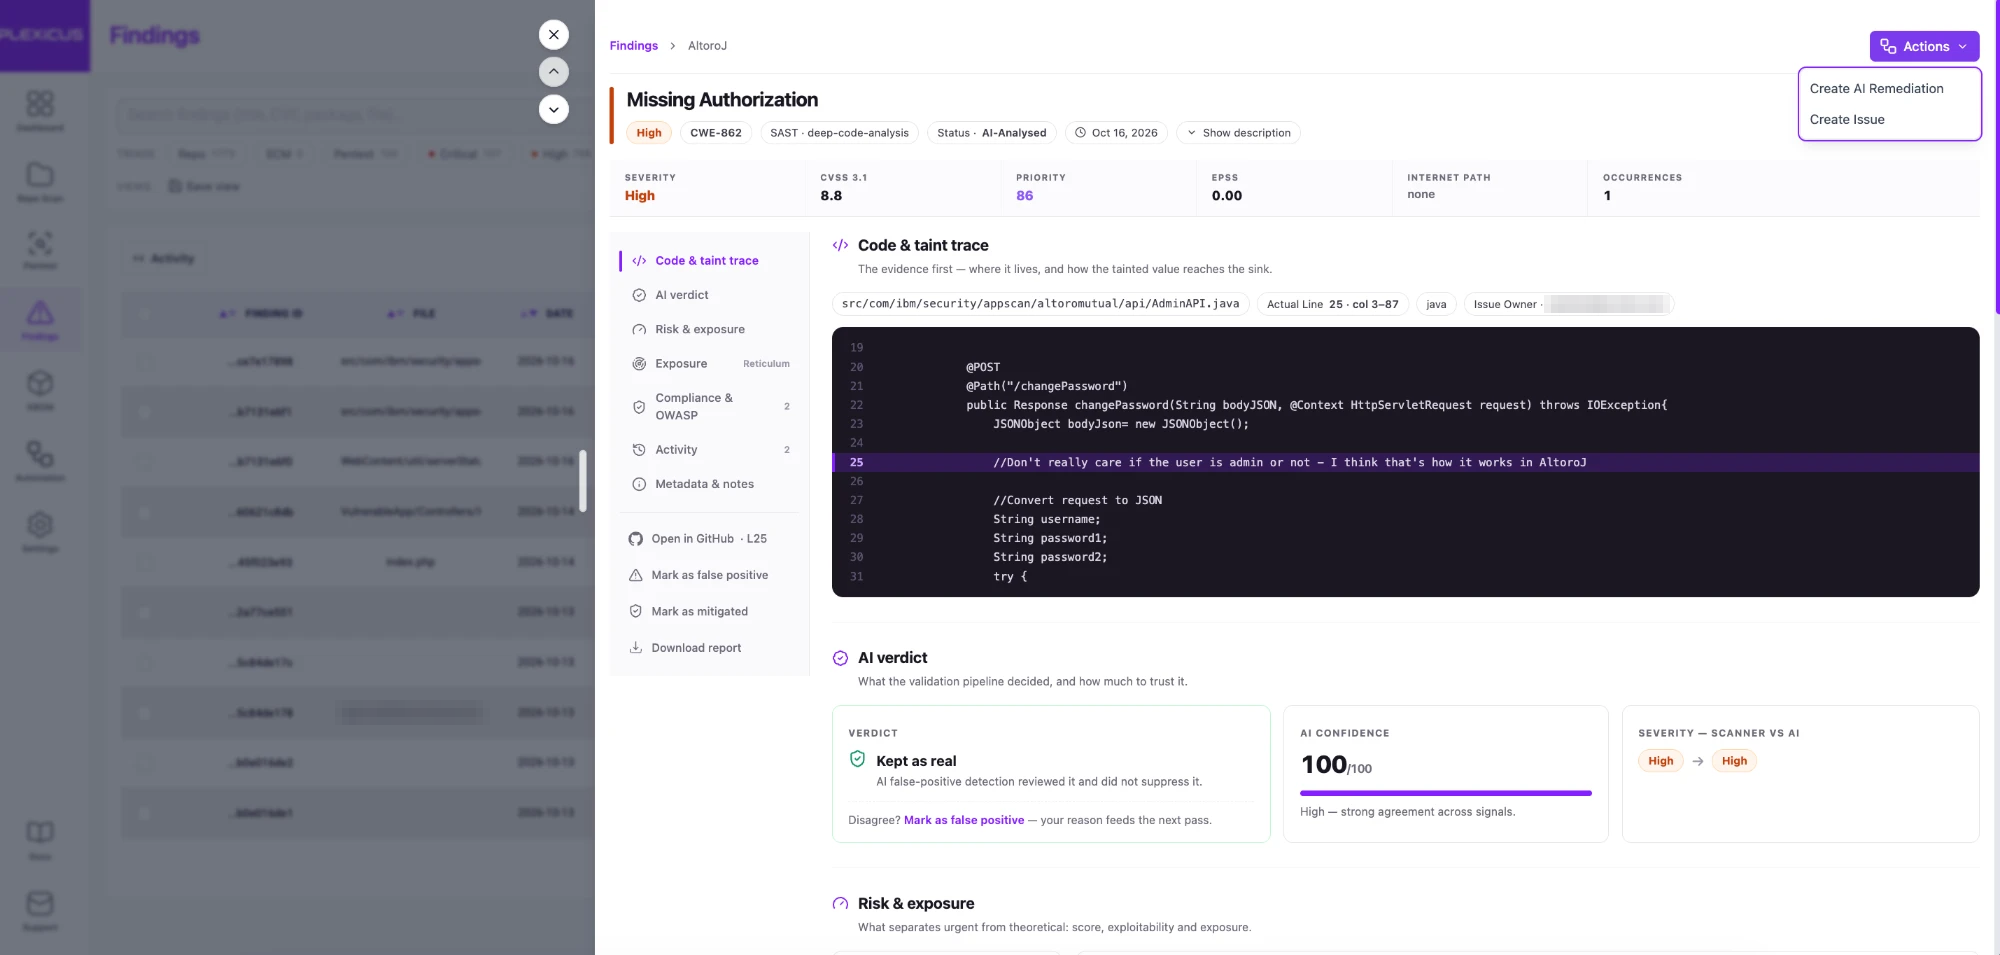
Captura de tela: o detalhe de uma descoberta de autorização ausente (CWE-862) em uma aplicação Java de demonstração, na plataforma da Plexicus. Mostra a seção Code & taint trace, o veredito de IA e Create AI Remediation no menu de ações. Dados de demonstração, capturados em outubro de 2026; o endereço de e-mail do responsável pela issue está pixelado.
3. Escolher uma estratégia de correção
A maioria das classes de fraqueza tem padrões de correção comprovados.
Consultas parametrizadas para injeção. Uma verificação de propriedade para autorização no nível do objeto. Uma atualização de versão para uma dependência vulnerável.
A estratégia também define o escopo. A melhor correção geralmente é a menor alteração que elimina a fraqueza na origem.
4. Redigir a alteração, os testes e a explicação
A saída é um diff, uma justificativa curta que liga cada linha alterada à descoberta e testes que teriam falhado antes da correção.
Um teste de regressão é o que impede que a mesma falha volte daqui a seis meses.
Veja uma remediação gerada por IA sendo revisada na plataforma da Plexicus.
Vídeo: um trecho do passo a passo da plataforma da Plexicus. Na caixa de diálogo AI Remediation Details de uma descoberta de injeção de comandos, a aba Details explica a vulnerabilidade e a correção, a aba Code Changes mostra o diff de app.py, e o trecho termina com a criação do pull request. Gravado em maio de 2026.
5. Executar as verificações automatizadas
A alteração passa pelo mesmo pipeline de CI que qualquer outro pull request: build, testes unitários, linters e as verificações de segurança existentes.
Uma correção redigida por IA não ganha atalho. Pelo contrário: ela passa pelo pipeline completo todas as vezes.
6. Entregar a decisão a uma pessoa
A alteração chega como um pull request no repositório que sua equipe já usa. Um revisor lê o diff, as evidências e a justificativa e, então, faz o merge, edita ou rejeita.
O merge é responsabilidade do revisor.
Veja como fica uma descoberta depois que uma correção é enviada, na plataforma da Plexicus.
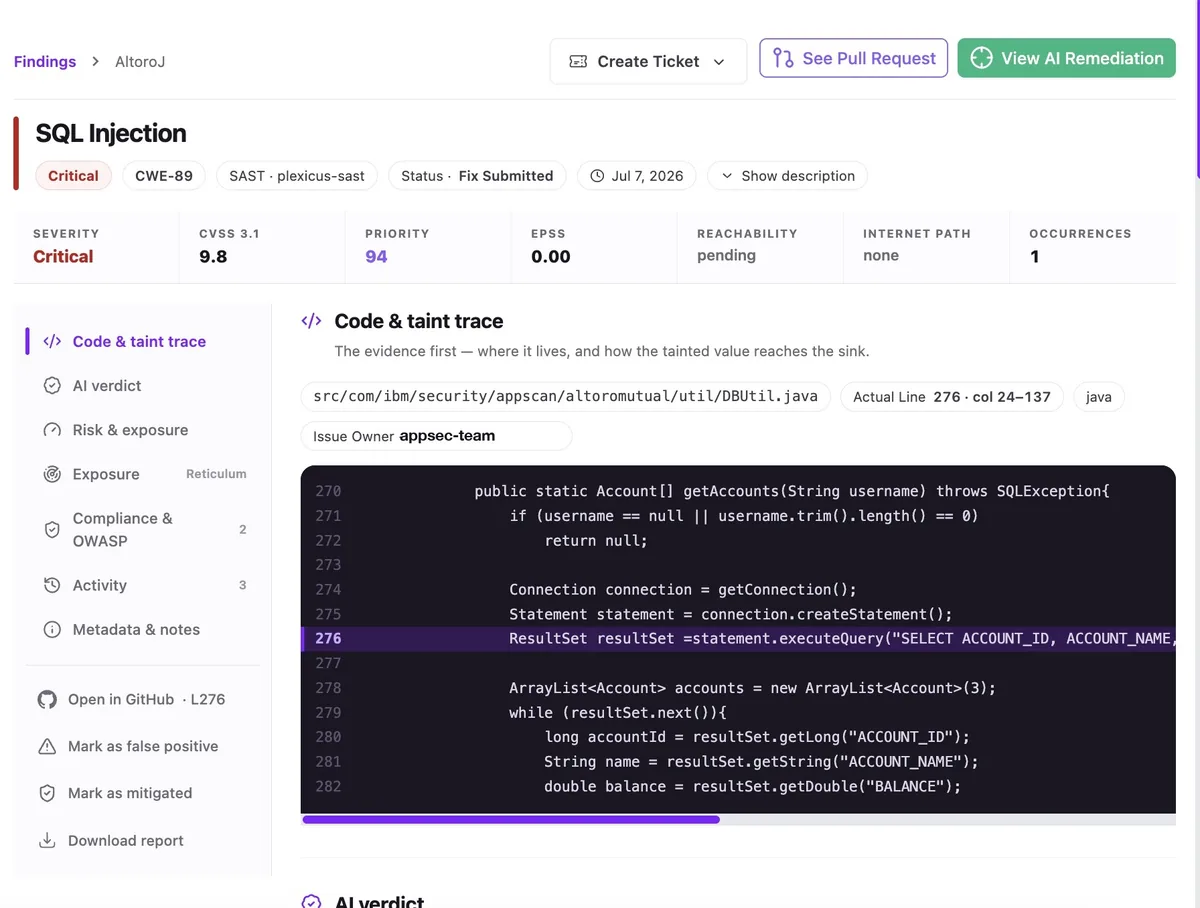
Captura de tela: uma descoberta crítica de injeção de SQL (CWE-89) em uma aplicação Java de demonstração, exibida na plataforma da Plexicus com o status Fix Submitted. A barra de ferramentas oferece Create Ticket, See Pull Request e View AI Remediation. Dados de demonstração.
E aqui está um pull request para uma descoberta de injeção de comandos, como ele chega ao repositório.
Vídeo: um trecho do passo a passo da plataforma da Plexicus. O log de status ao vivo termina com a criação do pull request; no GitHub, ele é aberto por uma conta bot da Plexicus com um commit e a explicação da correção na descrição, e depois uma pessoa faz o merge dele. Esta gravação não mostra verificações de CI nem revisões no pull request. Gravado em maio de 2026.
7. Retestar contra a prova original
Depois da alteração, a prova original é executada novamente. Se o exploit ainda funcionar, a descoberta continua aberta. Se falhar, a descoberta pode ser fechada com evidências dos dois lados: ela se reproduzia antes e não se reproduz depois.
Essa última etapa é o que transforma uma alteração de código em uma descoberta fechada.
Por que a entrada precisa ser uma descoberta validada
É tentador apontar um agente de correção para toda a saída de todos os scanners.
Isso multiplica o ruído.
Cada falso positivo vira um pull request. Cada pull request consome o tempo de um revisor. Depois de algumas alterações rejeitadas, os revisores começam a aprovar ou ignorar sem ler, o que é pior do que não ter automação nenhuma.
Partir de descobertas validadas muda a economia da revisão. Cada alteração que um revisor vê está ligada a um problema que se mostrou real.
Esse é o núcleo do Proof-Driven AppSec: No PoC, no finding. A mesma regra vale uma etapa depois. Sem descoberta validada, sem correção automatizada.
Para saber mais sobre como a validação funciona, veja nosso artigo sobre o AI Swarm Pentest, que explica a reprodução independente antes de uma descoberta ser apresentada como verificada.
Por que a saída precisa ser um pull request, não um push
O pull request é o ponto de controle em que sua organização de engenharia já confia.
Ele contém um diff e executa o CI. Registra quem aprovou o quê e quando, e pode ser revertido.
O projeto OpenSSF Scorecard trata isso como uma prática básica. Sua verificação Code-Review determina se um projeto exige revisão humana de código antes do merge de pull requests e classifica como alto o risco de pular essa etapa.
Esse padrão deve valer com mais força, e não menos, quando o autor é uma IA.
Por isso, um fluxo de remediação nativa de IA nunca precisa de acesso de escrita direto à produção. Ele precisa conseguir abrir um branch e um pull request. Tudo o que vem depois é o seu processo normal.
O que a pesquisa diz sobre correções de segurança geradas por IA
A pesquisa sobre patches de segurança escritos por IA é encorajadora e preocupante ao mesmo tempo. Vale conhecer quatro fontes.
LLMs conseguem corrigir casos simples; código real é mais difícil.
Em “Examining Zero-Shot Vulnerability Repair with Large Language Models”, publicado no IEEE Symposium on Security and Privacy de 2023, Pearce e colegas testaram cinco modelos comerciais, um modelo de código aberto e um modelo treinado localmente em cenários de vulnerabilidade sintéticos, criados manualmente e do mundo real.
Em conjunto, os modelos corrigiram todos os cenários sintéticos e criados manualmente. Em exemplos históricos do mundo real, os autores relataram dificuldades para gerar código funcionalmente correto.
Lição: uma correção que compila não é o mesmo que uma correção que funciona.
Em escala, uma taxa de sucesso modesta ainda importa.
O relatório técnico do Google sobre patches com IA descreve um pipeline que pede ao Gemini para gerar correções para bugs encontrados por sanitizers em C/C++, Java e Go e depois apresenta essas correções para revisão humana.
O Google relata que a abordagem corrigiu com sucesso 15% dos bugs de sanitizer descobertos durante testes unitários, o que resultou em centenas de bugs corrigidos. É um resultado divulgado pela própria empresa, com o pipeline do Google, e não uma replicação independente.
Lição: mesmo uma taxa parcial de automação elimina trabalho real, desde que pessoas revisem o que vai para produção.
A qualidade do patch precisa ser testada, não julgada por semelhança.
Em “Fixing Security Vulnerabilities with AI in OSS-Fuzz”, pesquisadores adaptaram um agente de LLM para corrigir vulnerabilidades encontradas pelo OSS-Fuzz, que, segundo o artigo, identificou mais de 10.000 vulnerabilidades em 1.000 projetos ou mais.
Uma das conclusões é diretamente relevante para o projeto da remediação: patches com pontuação alta em métricas de semelhança de código ainda falharam quando a entrada do exploit foi executada contra eles. Os autores concluem que a corretude de patches de segurança precisa considerar atributos dinâmicos, como a execução de testes.
Lição: o exploit faz parte do teste. Uma correção só está certa quando a prova deixa de funcionar, por mais que o diff se pareça com uma correção conhecida.
Sistemas de competição conseguem encontrar e corrigir com rapidez.
Os resultados finais do AI Cyber Challenge da DARPA, anunciados em 8 de agosto de 2025, informam que os sistemas competidores descobriram 54 vulnerabilidades sintéticas únicas nos 63 desafios da competição final e corrigiram 43 delas. As equipes também encontraram 18 vulnerabilidades reais, não sintéticas, e forneceram 11 patches para vulnerabilidades reais. A DARPA relata uma média de 45 minutos para enviar um patch.
São resultados de competição em software de código aberto real escolhido para o desafio, segundo as regras de pontuação da competição. Eles mostram o que é possível, não o que uma equipe qualquer verá no próprio código.
O que as evidências não comprovam.
Nenhuma dessas fontes mostra que a IA consegue corrigir todas as vulnerabilidades sem supervisão.
Elas mostram que a IA consegue redigir uma parcela útil das correções e que a corretude precisa ser verificada executando a prova. Só o pipeline de produção do Google coloca uma pessoa no ciclo; as outras três medem sistemas autônomos em condições de teste.
Por isso, um fluxo de produção acrescenta revisão humana. Esse é exatamente o projeto de um fluxo de remediação nativa de IA.
O exploit é o melhor teste de regressão.
A maioria das correções de segurança é verificada pela leitura.
Um revisor olha o diff, reconhece uma consulta parametrizada e aprova.
Isso funciona para padrões conhecidos. Falha nos sutis: uma verificação de autorização colocada depois que os dados já foram carregados, um sanitizer que deixa passar uma codificação, uma atualização de dependência que mantém uma cópia transitiva vulnerável no lugar.
Quando a descoberta veio com uma prova funcional, a verificação mais forte é simples:
Proof reproduced before the fix:  YES
Proof reproduced after the fix:   NO
Regression tests:                 PASS
Reviewer approval:                YES
Esse registro de quatro linhas é uma evidência mais forte do que apenas raciocinar sobre o diff.
Ele não prova que a correção está completa. Uma alteração que bloqueia apenas o payload original também passa na repetição, então os testes de regressão devem incluir variações da entrada, como outras codificações.
Também é o registro que um auditor, um cliente ou um regulador vai acabar pedindo.
Que tipos de falha a remediação nativa de IA consegue corrigir?
Nem toda descoberta é uma boa candidata. A adequação depende de quão local é a correção e de quão bem o padrão de correção é compreendido.
Falhas clássicas de código.
Injeção, cross-site scripting, server-side request forgery, desserialização insegura e criptografia fraca normalmente têm padrões de correção bem conhecidos. O OWASP Top 10
lista Injection como A05 e Cryptographic Failures como A04.Pontos fortes: as correções costumam ficar restritas a uma função, o padrão é conhecido e é fácil escrever um teste de regressão.
Limitações: a mesma falha pode aparecer em mais de um lugar, e a correção em um ponto de chamada não cobre os outros. O fluxo deve procurar o mesmo padrão em outras partes, o que o SSDF do NIST chama de revisar o software em busca de vulnerabilidades semelhantes para erradicar uma classe.
Falhas de controle de acesso e de lógica de negócios.
Broken Access Control é a categoria A01 do OWASP Top 10
. Ela abrange falhas como verificações de propriedade ausentes e escalonamento de privilégios. Falhas de lógica de negócios, como a ausência de limite de taxa, ficam ao lado dela.Pontos fortes: uma descoberta validada mostra exatamente qual usuário alcançou qual objeto, o que torna concreta a verificação ausente.
Limitações: a regra correta depende da intenção do negócio. Um administrador de equipe deve ver todos os projetos da organização ou apenas os da própria equipe?
A IA pode redigir a verificação. Uma pessoa precisa confirmar a regra.
Exposição em dependências e na cadeia de suprimentos.
Versões vulneráveis, nomes criados por typosquatting e pacotes que nunca deveriam ter sido instalados.
Pontos fortes: atualizações de versão e substituições de pacotes são mecânicas, e alterações em lockfiles são fáceis de revisar.
Limitações: atualizações de versão principal podem quebrar APIs. Uma correção pode exigir alterações de código junto com a atualização de versão, e os testes importam aqui mais do que em qualquer outro lugar.
Falhas introduzidas ao programar com IA.
Nomes de pacotes alucinados, segredos fixos no código, pontos vulneráveis a prompt injection e lacunas de autorização em código gerado.
Pontos fortes: essas falhas costumam seguir padrões reconhecíveis e ficam em código alterado recentemente, o que mantém pequeno o escopo da correção.
Limitações: o código gerado pode não ter nenhum teste, então a remediação precisa acrescentá-los, e não apenas alterar o código.
Falhas de arquitetura.
Um sistema que confia em um limite de rede interna, ou um design que coloca segredos no cliente.
Pontos fortes: as evidências ainda ajudam a equipe a entender e priorizar o problema.
Limitações: raramente existe um diff pequeno e seguro para elas. A saída certa é uma explicação clara e um plano para a equipe, não um pull request automatizado.
Quando um pull request de correção automática é seguro para merge?
“Seguro para merge” é um julgamento do revisor. Estas perguntas tornam esse julgamento mais rápido e consistente.
- A descoberta foi validada? Há evidências de que a fraqueza era real e alcançável?
- O diff é mínimo? Cada linha alterada tem relação com a descoberta?
- A justificativa é específica? Ela cita a classe da fraqueza, o local no código-fonte e por que a alteração a elimina?
- Há testes de regressão? Eles teriam falhado antes da alteração?
- O CI passa? Todo ele, sem jobs ignorados.
- A prova falha depois da correção? O exploit ou a reprodução original foi executado novamente?
- A correção muda um comportamento do qual os usuários dependem? Se sim, o product owner já viu?
- O mesmo padrão aparece em outros lugares? Se sim, existe um acompanhamento?
Se qualquer resposta for “não” ou “desconhecido”, o pull request não está pronto, por mais limpo que o diff pareça.
Boas práticas para remediação nativa de IA
1. Alimente com evidências, não com alertas
Só descobertas validadas devem entrar na fila de remediação. Todo o resto fica na triagem.
2. Mantenha as evidências anexadas à alteração
O pull request deve ter links para a descoberta, sua prova e seu contexto. Um revisor nunca deveria precisar abrir outra ferramenta para entender por que a alteração existe.
3. Prefira a menor correção correta
Diffs pequenos são mais fáceis de revisar, testar e reverter. Refatorações vão em pull requests separados.
4. Exija testes em toda correção
Uma correção de segurança sem teste é uma correção que pode desaparecer silenciosamente na próxima refatoração.
5. Use suas regras de revisão atuais
Proteção de branch, revisores obrigatórios e gates de CI devem valer para alterações redigidas por IA exatamente como valem para as feitas por pessoas.
6. Reteste depois do merge, não só antes
Execute a prova novamente contra a alteração implantada. Uma correção que funciona em um branch e falha depois da implantação não é uma correção.
7. Acompanhe as causas raiz ao longo do tempo
Registre a classe de fraqueza de cada correção. Se a mesma classe continuar voltando, o problema está antes, em uma biblioteca, um template ou um hábito de programação.
8. Comece por classes bem compreendidas
Comece com classes de fraqueza que têm padrões de correção conhecidos. Amplie o escopo quando os revisores confiarem no resultado.
Erros comuns
Automatizar correções para descobertas não validadas. Os revisores se afogam em alterações para problemas que nunca existiram.
Deixar a IA fazer push direto em um branch protegido. Isso remove o único controle que torna todo o fluxo confiável.
Julgar uma correção pela forma como ela se lê. Semelhança com uma correção conhecida não é corretude, como mostrou o estudo do OSS-Fuzz.
Pular testes de regressão porque o CI está verde. O CI verde só cobre o que os testes verificam.
Tratar toda descoberta como algo que se corrige com código. Alguns problemas exigem uma decisão de design, não um diff.
Medir o sucesso por pull requests abertos. A métrica que importa são as descobertas fechadas com um reteste aprovado.
Normas e frameworks aplicáveis
A remediação nativa de IA é uma nova forma de fazer um trabalho que as normas existentes já descrevem.
NIST Secure Software Development Framework.
O NIST SP 800-218, o Secure Software Development Framework (SSDF) publicado em fevereiro de 2022, tem um grupo de práticas chamado Respond to Vulnerabilities (RV). Suas tarefas correspondem de perto ao fluxo acima:
| Tarefa do SSDF | O que ela pede | Onde aparece no fluxo |
|---|---|---|
RV.2.1 | Analisar cada vulnerabilidade para reunir informações suficientes sobre o risco e planejar sua remediação | Descoberta validada e contexto de código |
RV.2.2 | Planejar e implementar respostas de risco para as vulnerabilidades | Alteração redigida e revisão |
RV.3.1 | Analisar as vulnerabilidades identificadas para determinar suas causas raiz | Causa raiz e classe da fraqueza |
RV.3.2 | Analisar as causas raiz ao longo do tempo para identificar padrões | Acompanhamento das causas raiz ao longo do tempo |
RV.3.3 | Revisar o software em busca de vulnerabilidades semelhantes para erradicar uma classe de vulnerabilidades | Busca do mesmo padrão em outros lugares |
RV.3.4 | Revisar o processo de SDLC e, se for o caso, atualizá-lo para evitar (ou reduzir a probabilidade de) que a causa raiz se repita | Correção da biblioteca, do template ou do hábito na origem |
O SSDF também pede, na PW.7.2, que os resultados de revisão e análise de código e as remediações recomendadas sejam registrados no fluxo de trabalho ou no issue tracker da equipe de desenvolvimento. Um pull request com evidências anexadas faz isso por design.
CISA KEV e BOD 26-04.
Para as agências federais, a BOD 26-04 define os prazos de remediação descritos anteriormente, e o status KEV é um de seus quatro fatores. Para todos os demais, o catálogo KEV é uma lista prática de prioridades: se uma vulnerabilidade é sabidamente explorada, ela vai para o início da fila de remediação.
OWASP Top 10
. oferece um vocabulário comum para as classes de falhas que os fluxos de remediação mais tratam: Broken Access Control, Security Misconfiguration, Software Supply Chain Failures, Cryptographic Failures, Injection e outras.Cyber Resilience Act da UE.
O CRA leva o tratamento de vulnerabilidades para a lei no caso de produtos com elementos digitais vendidos na UE. Um registro de remediação que mostre a descoberta, a correção, a revisão e o reteste é o tipo de evidência de que esse processo de tratamento vai precisar.
Um exemplo prático
Imagine uma API de faturamento criada com a ajuda de um assistente de programação com IA.
Um pentest autorizado descobre que um usuário consegue baixar a fatura de outro cliente alterando o ID na URL:
GET /api/invoices/8812/pdf     (account A, owns invoice 8812)    200 OK
GET /api/invoices/8813/pdf     (account A, invoice of account B) 200 OK
A segunda solicitação deveria ter sido recusada. A descoberta é reproduzida de forma independente e marcada como validada, com as duas solicitações e respostas guardadas como evidência.
Contexto de código.
Rastrear a rota leva a um único handler:
@app.get("/api/invoices/<int:invoice_id>/pdf")
@login_required
def invoice_pdf(invoice_id):
    invoice = Invoice.query.get_or_404(invoice_id)
    return render_pdf(invoice)
A classe da fraqueza é a ausência de autorização em uma chave controlada pelo usuário, CWE-639. O usuário está autenticado. A propriedade nunca é verificada.
Alteração redigida.
O diff proposto acrescenta a verificação ausente no ponto em que o objeto é carregado:
 def invoice_pdf(invoice_id):
-    invoice = Invoice.query.get_or_404(invoice_id)
+    invoice = Invoice.query.filter_by(
+        id=invoice_id, account_id=current_user.account_id
+    ).first_or_404()
     return render_pdf(invoice)
Retornar 404 em vez de 403 também evita confirmar que a outra fatura existe.
Testes.
Dois testes acompanham a alteração. Aqui, client_a é uma fixture do projeto: um cliente de teste já autenticado como usuário da conta A.
def test_owner_can_download_invoice(client_a, invoice_a):
    assert client_a.get(f"/api/invoices/{invoice_a.id}/pdf").status_code == 200

def test_other_account_cannot_download_invoice(client_a, invoice_b):
    assert client_a.get(f"/api/invoices/{invoice_b.id}/pdf").status_code == 404
O segundo teste falha no código antigo e passa no novo.
Revisão e reteste.
O pull request explica a descoberta, inclui o link para as evidências, mostra o diff e os testes e levanta uma pergunta para o revisor: existem outras rotas de fatura, como e-mail ou exportação, que carregam faturas da mesma forma?
O revisor verifica, encontra mais uma rota e pede a mesma correção nela.
Depois do merge e da implantação, as solicitações originais são executadas novamente:
GET /api/invoices/8812/pdf     (account A, owns invoice 8812)    200 OK
GET /api/invoices/8813/pdf     (account A, invoice of account B) 404 Not Found
A descoberta é fechada com prova dos dois lados.
O que a remediação nativa de IA não é
Não é um agente com acesso de escrita à produção.
Não substitui a revisão de código.
Não garante que toda descoberta possa ser corrigida automaticamente.
Não é uma forma de pular testes porque a IA “entendeu” o código.
E não é motivo para parar de corrigir as causas raiz. Se a mesma falha aparece toda semana, a resposta é uma biblioteca mais segura ou um template melhor, não um corretor mais rápido.
Onde a Plexicus se encaixa
A Plexicus é construída em torno de um ciclo fechado: validar, entender, remediar e, então, verificar a correção antes do merge.
Validar. O AI Swarm Pentest explora uma aplicação, API ou código-fonte autorizado dentro de um escopo acordado. Toda descoberta inclui evidências reproduzíveis e, se uma segunda execução não conseguir reproduzir o resultado, a descoberta é marcada como não verificada ou descartada.
Entender. O Deep Code Analysis rastreia o caminho de código afetado, para que os engenheiros vejam os endpoints, os parâmetros e a lógica de negócios que uma descoberta toca, junto com os dados que ela alcança e o papel de acesso que pode acioná-la.
Remediar. O Plexicus Remediation recebe uma descoberta verificada e prepara o contexto de remediação e uma alteração sugerida. O fluxo afetado, o alcance, a classe da fraqueza e a justificativa são reunidos na alteração proposta. O diff pronto para revisão explica a descoberta original inline, e testes de regressão e notas são incluídos quando relevantes.
Entregar. A alteração chega ao seu repositório atual com atribuição de revisor e um gancho de reteste conectado ao CI, e sua equipe a verifica antes do merge. A Plexicus lista GitHub, GitLab e Bitbucket para repositórios. Sua equipe faz o merge ou rejeita com evidências.
Manter o controle. A Plexicus nunca faz push para produção, e sua equipe decide se faz o merge. A página do AI Swarm Pentest acrescenta que as propostas chegam como pull requests ou arquivos de patch separados.
A Plexicus descreve quatro tipos de correção que prepara: falhas introduzidas ao desenvolver com ferramentas de programação com IA, descobertas clássicas como injeção de SQL e cross-site scripting, falhas de lógica de negócios como broken object-level authorization e exposição na cadeia de suprimentos, como dependências com typosquatting, com fixação de versões e atualização de lockfiles.
Esse é o Proof-Driven AppSec aplicado à última milha: um ciclo fechado com PR, em que cada alteração carrega as evidências que a originaram.
Se você está em um estágio anterior, nosso guia completo de segurança de aplicações mostra onde a remediação se encaixa em um programa moderno de AppSec, e nosso artigo sobre deep code analysis explica por que o contexto de código importa antes de redigir uma correção. Para ver um padrão de correção na prática, leia como automatizar a remediação de injeção de SQL.
Perguntas frequentes
Qual é a diferença entre remediação nativa de IA e remediação automática?
A remediação automática geralmente significa aplicar uma ação predefinida de forma automática, como um patch ou uma mudança de configuração. A remediação nativa de IA redige uma alteração de código para uma descoberta validada específica e a entrega a uma pessoa para revisão antes de qualquer merge.
A remediação nativa de IA envia alterações para produção?
Não deveria. A saída é um pull request ou um arquivo de patch, revisado e integrado pelo seu processo normal. A Plexicus afirma que nunca faz push para produção.
A IA consegue corrigir vulnerabilidades corretamente?
Às vezes, e a pesquisa mostra como saber. O Google relata que seu pipeline corrigiu 15% dos bugs de sanitizer descobertos durante testes unitários, com revisão humana. O estudo do OSS-Fuzz mostra que os patches precisam ser verificados executando o exploit, não pela semelhança com uma correção conhecida.
Por que partir de descobertas validadas e não da saída de scanners?
Porque cada descoberta não validada que vira um pull request consome tempo de revisão e talvez não corrija nada. A validação faz com que cada alteração mereça a atenção de um revisor.
Quais testes devem acompanhar uma correção de segurança?
Pelo menos um teste que falhe no código antigo e passe no novo, mais um teste que confirme que o uso legítimo continua funcionando. Para falhas de controle de acesso, teste tanto o dono quanto uma conta diferente.
A remediação nativa de IA substitui desenvolvedores ou engenheiros de segurança?
Não. Ela assume as partes repetitivas: reproduzir, localizar, redigir e testar. As pessoas continuam decidindo qual é o comportamento correto e se a alteração entra no merge.
Quais vulnerabilidades são boas candidatas?
Falhas com padrões de correção locais e bem compreendidos, como injeção, verificações de propriedade ausentes e versões vulneráveis de dependências. Falhas de arquitetura geralmente exigem um plano, não um diff automatizado.
Qual é a relação com o NIST SSDF?
As práticas Respond to Vulnerabilities do SSDF pedem que as equipes analisem cada vulnerabilidade, implementem uma resposta, encontrem as causas raiz e procurem a mesma falha em outros lugares. Um fluxo de remediação nativa de IA é uma forma de executar essas tarefas em maior volume.
Como medir se funciona?
Conte as descobertas fechadas com um reteste aprovado e o tempo entre a validação e o merge. O número de pull requests abertos, sozinho, não é uma medida útil.
Ela consegue corrigir código escrito por assistentes de programação com IA?
Sim, e esse código muitas vezes precisa disso. Código gerado pode trazer falhas clássicas e chegar sem testes, então a correção deve acrescentar testes além de alterar o código.
Feche o ciclo com evidências
Toda correção deve provar que a descoberta era real, mostrar por que a alteração funciona e mostrar que o ataque parou.
Conheça o Plexicus Remediation →
Quer uma primeira visão do seu próprio código? Execute a ferramenta SAST gratuita, uma análise estática do seu código-fonte no GitHub.