Apresentando AI Swarm Pentest: de um pentester de IA a uma equipe orquestrada de agentes de ataque
Como capacidades especializadas de ataque compartilham contexto, desafiam hipóteses e verificam caminhos de ataque de forma independente no fluxo Proof-Driven AppSec da Plexicus.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestO desenvolvimento de software está ficando cada vez mais orientado por agentes de IA.
Sistemas de IA agora podem gerar, revisar, refatorar, testar e implantar código. As aplicações mudam mais rapidamente, as APIs se multiplicam e as equipes de segurança precisam validar mais software sem aumentar os times na mesma proporção.
O teste de invasão começa a mudar pelo mesmo motivo.
A primeira onda de ferramentas de segurança com IA ajudava principalmente as pessoas a trabalhar mais rápido: explicar uma vulnerabilidade, gerar um payload, resumir o resultado de um scanner ou sugerir a próxima etapa do pentest.
A onda seguinte se tornou mais autônoma. Em vez de esperar que uma pessoa emitisse cada comando, um agente de IA podia explorar uma aplicação, interagir com endpoints, testar hipóteses, analisar respostas e decidir o que tentar em seguida.
Mas a autonomia cria outro problema:
Um teste de invasão não é uma única tarefa.
É uma longa cadeia de decisões.
Um invasor pode precisar descobrir um endpoint, entender a autenticação, identificar uma referência a um objeto, testar limites de autorização, obter contexto adicional, tentar várias versões de payload, correlacionar o resultado com outra fraqueza e, por fim, comprovar que todo o caminho de ataque realmente funciona.
É aí que entra o AI Swarm Pentest.
Em vez de tratar o teste de invasão como uma longa conversa entre um modelo e um alvo, o AI Swarm Pentest o trata como uma investigação de segurança orquestrada, na qual capacidades especializadas podem explorar, raciocinar, compartilhar contexto, verificar o trabalho umas das outras e transformar hipóteses de ataque em evidências.
O objetivo não é simplesmente:
Encontrar mais vulnerabilidades.
A pergunta mais útil é:
Quais caminhos de ataque são reais, o que um invasor consegue de fato alcançar e de quais evidências a equipe de engenharia precisa para agir?
Essa distinção está no centro do AI Swarm Pentest da Plexicus. A Plexicus descreve o AI Swarm Pentest como uma solução que valida caminhos exploráveis em aplicações, APIs e código-fonte autorizados, com evidências e verificação independente antes de apresentar uma descoberta como verificada.
Assista à animação do AI Swarm Pentest no YouTube.
Primeiro: o que significa exatamente “pentest com IA”?
Não existe uma definição universalmente aceita de teste de invasão com IA.
Um scanner de vulnerabilidades com uma explicação gerada por LLM pode ser comercializado como segurança com IA.
Um pentester que usa Claude ou outro modelo como copiloto também pode chamar seu fluxo de trabalho de pentest com IA.
No outro extremo, sistemas autônomos podem interagir com aplicações, escolher ferramentas, gerar payloads, analisar respostas, mudar de estratégia, explorar vulnerabilidades e produzir evidências com pouca intervenção humana.
Esses sistemas não são equivalentes.
Até os fornecedores que desenvolvem plataformas de pentest autônomo reconhecem essa distinção. A XBOW, por exemplo, descreve o pentest com IA como um espectro que pode incluir um LLM conectado a um scanner, testes liderados por humanos e ampliados por IA e sistemas autônomos que coordenam agentes especializados.
Por isso, antes de falar sobre AI Swarm Pentest, é útil separar quatro conceitos.
| Abordagem | Principal responsável pela decisão | Comportamento típico | Resultado principal |
|---|---|---|---|
| DAST / scanner tradicional | Regras e assinaturas | Envia sondas predeterminadas e identifica padrões conhecidos | Vulnerabilidades potenciais |
| Pentest assistido por IA | Pentester humano | A IA explica, recomenda, escreve comandos ou analisa resultados | Descobertas validadas por humanos |
| Pentest autônomo com IA | Agente de IA ou sistema de agentes | Explora alvos, escolhe ações e se adapta aos resultados | Descobertas autônomas e evidências de ataque |
| Pentest com enxame de IA | Sistema de agentes orquestrado | Várias capacidades exploram, correlacionam e compartilham contexto, desafiam hipóteses e verificam caminhos de ataque | Caminhos de ataque verificados com evidências |
As fronteiras não são absolutas.
Uma plataforma sofisticada de pentest autônomo pode já usar vários agentes internamente. Portanto, “enxame” não deve ser entendido simplesmente como “mais de um agente de IA”.
A diferença importante está em como esses agentes são organizados.
O que é AI Swarm Pentest?
AI Swarm Pentest é uma abordagem de teste de invasão baseada em agentes de IA, na qual capacidades especializadas de segurança operam como um sistema orquestrado, em vez de depender de um único agente de uso geral para conduzir todo o trabalho sequencialmente.
Pense na diferença entre pedir a um engenheiro de segurança altamente capacitado para investigar uma aplicação sozinho e entregar a mesma missão a uma equipe de segurança coordenada.
Uma pessoa pode mapear a superfície de ataque.
Outra se concentra na autenticação.
Outra investiga autorizações.
Outra examina APIs.
Outra tenta transformar um comportamento interessante em um exploit reproduzível.
Outra tenta reproduzir a descoberta de forma independente antes que a equipe a reporte.
O ponto principal não é apenas que várias pessoas estejam trabalhando.
Elas precisam ter uma compreensão compartilhada do alvo.
Se um agente descobre que:
/api/invoices/{id}
pode ser acessado após a autenticação, outro agente não deveria necessariamente ter de redescobrir tudo desde o início.
Se o primeiro agente também descobre que os IDs das faturas são sequenciais, a capacidade de testar autorizações pode usar essa informação como uma nova hipótese.
Se outra ação revelar um identificador de tenant, essa observação pode ser relevante em outra parte.
O pentest se transforma em um grafo de ataque em constante evolução, em vez de uma coleção de prompts isolados.
A descrição da próxima apresentação de José Ramón Palanco na APIAddicts Days, em 15 de outubro de 2026 propõe habilidades especializadas, MCP e memória de ataque orientada a grafos. Essa é uma arquitetura de prova de conceito proposta para a palestra.
Essa analogia se aproxima muito mais de uma operação real de segurança ofensiva do que:
Prompt → IA → relatório de vulnerabilidades.
Por que um agente de IA nem sempre basta
Os grandes modelos de linguagem são assistentes de segurança muito capazes.
Mas o teste de invasão expõe várias de suas limitações ao mesmo tempo.
Um pentest é:
longo,
que mantém estado,
intensivo no uso de ferramentas,
incerto,
adversarial,
e depende de evidências coletadas ao longo de muitas ações anteriores.
O artigo do PentestGPT documentou esse problema desde cedo. Os pesquisadores descobriram que os LLMs eram úteis em tarefas pontuais de pentest, como operar ferramentas, interpretar resultados e propor as próximas ações, mas que manter uma visão integrada de toda a operação continuava difícil. Por isso, o PentestGPT separou as responsabilidades em módulos que interagem, em vez de pedir a uma única instância do modelo que gerenciasse tudo.
Pesquisas posteriores continuaram apontando desafios em enumeração, exploração, elevação de privilégios, gerenciamento de contexto e raciocínio autônomo de ponta a ponta.
Pesquisas mais recentes sobre sistemas multiagentes apontam na mesma direção.
O sistema de pesquisa ARTEMIS, por exemplo, usa subagentes dinâmicos e triagem automática de vulnerabilidades. Em um estudo realizado em condições reais em uma rede universitária, os pesquisadores relataram vantagens em enumeração sistemática e exploração paralela, mas também observaram limitações importantes, incluindo falsos positivos e dificuldades em alguns fluxos de trabalho que dependem muito de interfaces gráficas. Esses resultados devem ser avaliados considerando os alvos, as regras de pontuação e o orçamento daquele estudo.
A lição não é que “vários agentes resolvem o pentest automaticamente”.
Eles não resolvem.
A lição é que trabalhos complexos de segurança ofensiva se beneficiam da divisão de responsabilidades, desde que mantenham estado compartilhado e verificação.
De um único agente a um enxame
Um pentester autônomo com IA simplificado poderia ser assim:
Alvo
  ↓
Agente de IA
  ↓
Reconhecimento
  ↓
Hipótese
  ↓
Exploração
  ↓
Relatório
Isso pode funcionar muito bem.
Mas tudo depende do mesmo ciclo de raciocínio para preservar o contexto, decidir prioridades, operar ferramentas, evitar becos sem saída, lidar com resultados de ferramentas, validar descobertas e documentar a operação.
Uma arquitetura orientada a enxame tem uma estrutura conceitualmente diferente:
                         ┌──────────────────────────┐
                         │ Escopo autorizado       │
                         │ + Regras de engajamento │
                         └────────────┬─────────────┘
                                      │
                                      ▼
                         ┌──────────────────────────┐
                         │ Orquestrador do enxame   │
                         └────────────┬─────────────┘
                                      │
          ┌───────────────────────────┼───────────────────────────┐
          ▼                           ▼                           ▼
 ┌────────────────────┐    ┌────────────────────┐    ┌────────────────────┐
 │ Superfície / recon.│    │ Autenticação /     │    │ Exploração         │
 │ Capacidade         │    │ lógica Capacidade  │    │ Capacidade         │
 └─────────┬──────────┘    └─────────┬──────────┘    └─────────┬──────────┘
           │                         │                         │
           └─────────────────────────┼─────────────────────────┘
                                     ▼
                         ┌──────────────────────────┐
                         │ Contexto de ataque      │
                         │ compartilhado / grafo / │
                         │ evidências              │
                         └────────────┬─────────────┘
                                      │
                                      ▼
                         ┌──────────────────────────┐
                         │ Verificação             │
                         │ independente            │
                         └────────────┬─────────────┘
                                      │
                                      ▼
                         ┌──────────────────────────┐
                         │ Descoberta verificada   │
                         │ + evidências            │
                         └────────────┬─────────────┘
                                      │
                                      ▼
                         ┌──────────────────────────┐
                         │ Revisão humana +        │
                         │ correção                │
                         └──────────────────────────┘
A mudança arquitetural é sutil, mas importante.
A unidade de trabalho deixa de ser apenas o prompt.
Ela passa a ser a missão.
Como funciona o AI Swarm Pentest
Em linhas gerais, um AI Swarm Pentest pode ser entendido como sete etapas conectadas:
-
Definir a missão autorizada. O alvo, o ambiente, as credenciais, se necessárias, os limites, o período e as regras de engajamento são definidos antes do início dos testes. Na Plexicus, o escopo e as regras são acordados antes do trabalho, e o sistema foi projetado para permanecer dentro desse escopo autorizado.
-
Mapear a superfície da aplicação. O sistema explora aplicações e APIs acessíveis, rotas, parâmetros, estados de autenticação, formulários e outras superfícies de ataque relevantes, em vez de apenas disparar um conjunto fixo de assinaturas. A documentação da Plexicus diferencia esse comportamento do DAST: seus agentes de pentest com IA podem interagir com aplicações, preencher formulários, usar sessões autenticadas e investigar cadeias de ataque mais complexas.
-
Gerar hipóteses de ataque. Observações são transformadas em perguntas. É possível alterar este identificador? Este endpoint interno pode ser acessado externamente? É possível contornar um limite de papel de acesso? Duas fraquezas moderadas, quando combinadas, podem gerar algo maior?
-
Delegar a exploração. As capacidades relevantes investigam essas hipóteses. Alguns caminhos terminam rapidamente. Outros geram novas informações úteis para o restante do enxame.
-
Conectar evidências em caminhos de ataque. Em vez de tratar descobertas como alertas isolados, as observações podem se tornar relações: usuário → endpoint → objeto → permissão → operação vulnerável → recurso sensível.
-
Verificar a descoberta de forma independente. Descobrir algo não significa automaticamente provar. A Plexicus afirma que as descobertas apresentadas como verificadas passam por reprodução separada e que hipóteses sem sustentação podem ser descartadas, em vez de incluídas apenas para deixar o relatório mais longo.
-
Entregar as evidências às pessoas. O resultado inclui contexto de impacto, evidências técnicas, priorização e as informações necessárias para corrigir o problema. Alterações em produção não são aplicadas automaticamente; a decisão final continua com as equipes humanas.
Essa última etapa importa.
O objetivo do pentest autônomo não deve ser gerar vulnerabilidades de forma autônoma.
Deve ser conduzir investigações autônomas com provas que possam ser revisadas.
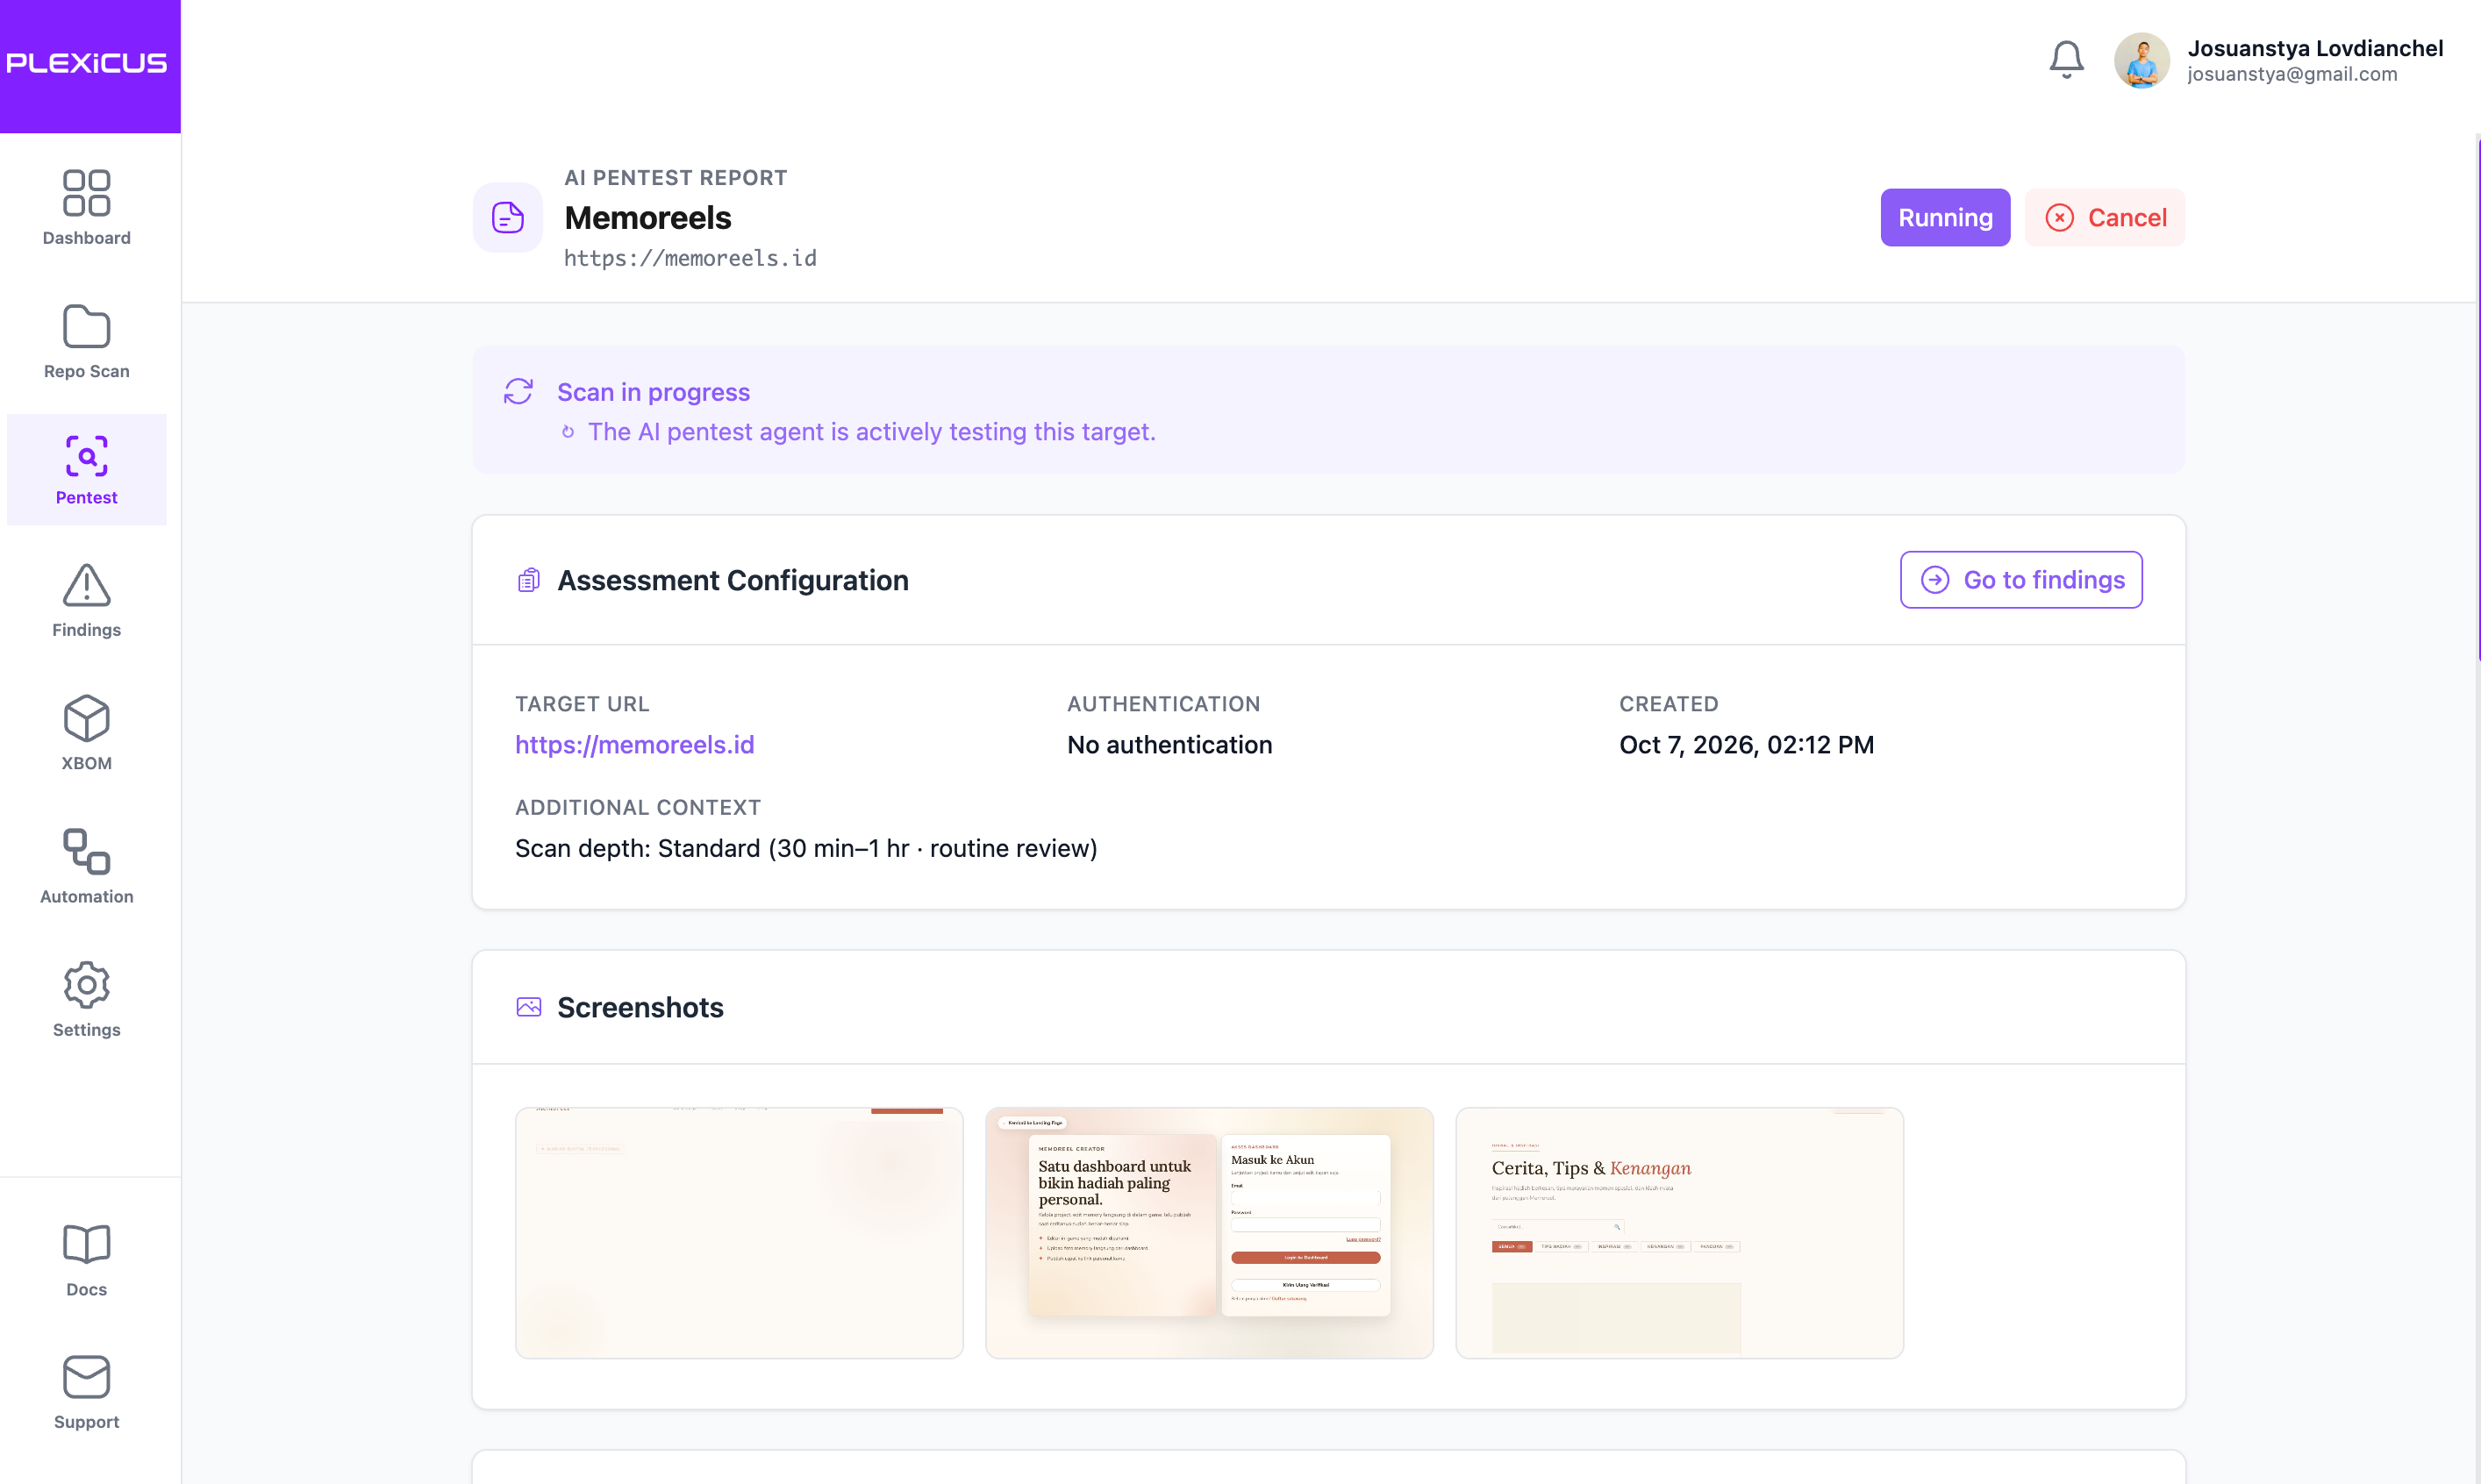
A visão geral da avaliação mostra a configuração e as capturas do alvo enquanto o pentest está em execução.
AI Swarm Pentest vs. DAST tradicional
O DAST continua sendo útil.
Mas DAST e AI Swarm Pentest respondem a perguntas diferentes.
Um scanner dinâmico convencional é muito bom em verificar repetidamente um grande número de alvos em busca de classes conhecidas de fraquezas.
Ele pode perguntar:
Este parâmetro reage a uma sonda conhecida de injeção de SQL?
Um pentester que usa agentes de IA pode perguntar algo mais próximo de:
O que este endpoint faz, que suposições a aplicação faz sobre quem o chama e consigo manipular essas suposições para alcançar algo a que eu não deveria ter acesso?
A documentação da Plexicus mostra essa diferença diretamente. O modo DAST envia sondas automatizadas para problemas como configurações incorretas de segurança HTTP e padrões de exploração conhecidos; o AI Pentest explora aplicações de modo interativo, oferece suporte a fluxos autenticados e tenta cadeias de ataque complexas e vulnerabilidades de lógica de negócios.
Essa distinção importa porque muitas vulnerabilidades reais de aplicações dependem do contexto.
O problema talvez não seja:
O parâmetro X aceita o payload Y.
Pode ser algo como:
Um usuário com poucos privilégios pode obter o identificador X no fluxo A, enviá-lo à API B, contornar a validação de propriedade e acessar o recurso de outro tenant.
Nenhuma solicitação isolada necessariamente parece extraordinária.
A relação entre as solicitações é a vulnerabilidade.
É exatamente aí que o raciocínio sobre o estado do ataque se torna valioso.
AI Swarm Pentest vs. um pentest “comum” de IA
Essa é a distinção mais importante — e também a mais fácil de simplificar demais.
Um pentest autônomo comum de IA costuma seguir um ciclo de agente:
observar → raciocinar → agir → observar → repetir.
Essa abordagem pode ser poderosa.
Mas, à medida que a operação aumenta, o agente precisa se lembrar de tudo o que aprendeu, definir prioridades, operar ferramentas, manter o estado de autenticação, investigar várias hipóteses, abandonar caminhos improdutivos e distinguir sucesso real de resultados enganosos, tudo ao mesmo tempo.
Uma arquitetura de enxame pode distribuir essas responsabilidades.
| Dimensão | Pentest típico com agente único de IA | AI Swarm Pentest |
|---|---|---|
| Raciocínio | Principalmente um ciclo de raciocínio | Capacidades especializadas orquestradas |
| Exploração | Muitas vezes sequencial | Pode explorar várias hipóteses em paralelo |
| Contexto | Conversa / memória de trabalho do agente | Contexto compartilhado da missão e relações de ataque |
| Especialização | Agente de pentest de uso geral | Capacidades podem se especializar em partes da missão |
| Caminhos sem resultado | Gerenciados pelo mesmo agente | Podem ser isolados sem perder toda a investigação |
| Cadeias de ataque | O agente precisa preservar contexto por longos períodos | As descobertas podem ser conectadas por estado compartilhado |
| Validação | Pode ser feita pelo agente que descobriu o problema | A reprodução independente pode ser uma etapa separada |
| Resultado | Descoberta / relatório | Caminho de ataque comprovado com evidências e encaminhamento |
| Papel humano | Depende da implementação | Escopo, limites, revisão e decisão final permanecem explícitos |
No entanto, esta tabela descreve padrões arquiteturais, não categorias rígidas do setor.
Alguns produtos modernos de pentest autônomo já usam agentes especializados e validadores. A XBOW, por exemplo, descreve publicamente a coordenação de agentes especializados e o uso de agentes validadores para confirmar a explorabilidade.
Por isso, a pergunta mais importante para quem compra não deve ser:
“Ele tem vários agentes?”
Uma pergunta melhor é:
“Como o sistema coordena esses agentes, preserva o estado, verifica descobertas, controla o escopo e transforma resultados em evidências confiáveis para a minha equipe?”
O enxame trata de coordenação, não da quantidade de agentes
Imagine usar 100 agentes de IA contra uma aplicação.
Se cada um deles examina os mesmos endpoints de forma independente e depois gera seu próprio relatório, tecnicamente você tem vários agentes.
Mas isso não significa necessariamente que tenha um enxame útil.
Um enxame se torna útil quando o conhecimento descoberto por uma capacidade pode influenciar as decisões de outra.
Suponha que uma capacidade de exploração descubra:
POST /api/projects/{project_id}/export
O usuário autenticado parece pertencer a:
tenant_A
Outra capacidade descobre o ID de um projeto que pertence a:
tenant_B
Uma capacidade de teste de autorização combina as observações.
Ela substitui o segundo identificador na primeira solicitação.
A resposta é inesperadamente bem-sucedida.
Em seguida, uma capacidade de verificação reproduz a sequência com um estado limpo.
Agora o sistema tem algo muito mais útil do que:
Possível IDOR detectado.
Ele tem uma cadeia de ataque:
Usuário com poucos privilégios
        ↓
Endpoint autenticado de exportação de projeto
        ↓
Identificador de projeto controlado pelo invasor
        ↓
Ausência de validação da propriedade do tenant
        ↓
Exportação de projeto entre tenants
        ↓
Exposição de dados sensíveis
E cada etapa pode incluir evidências.
Essa é a diferença entre detectar uma anomalia e demonstrar um caminho de ataque.
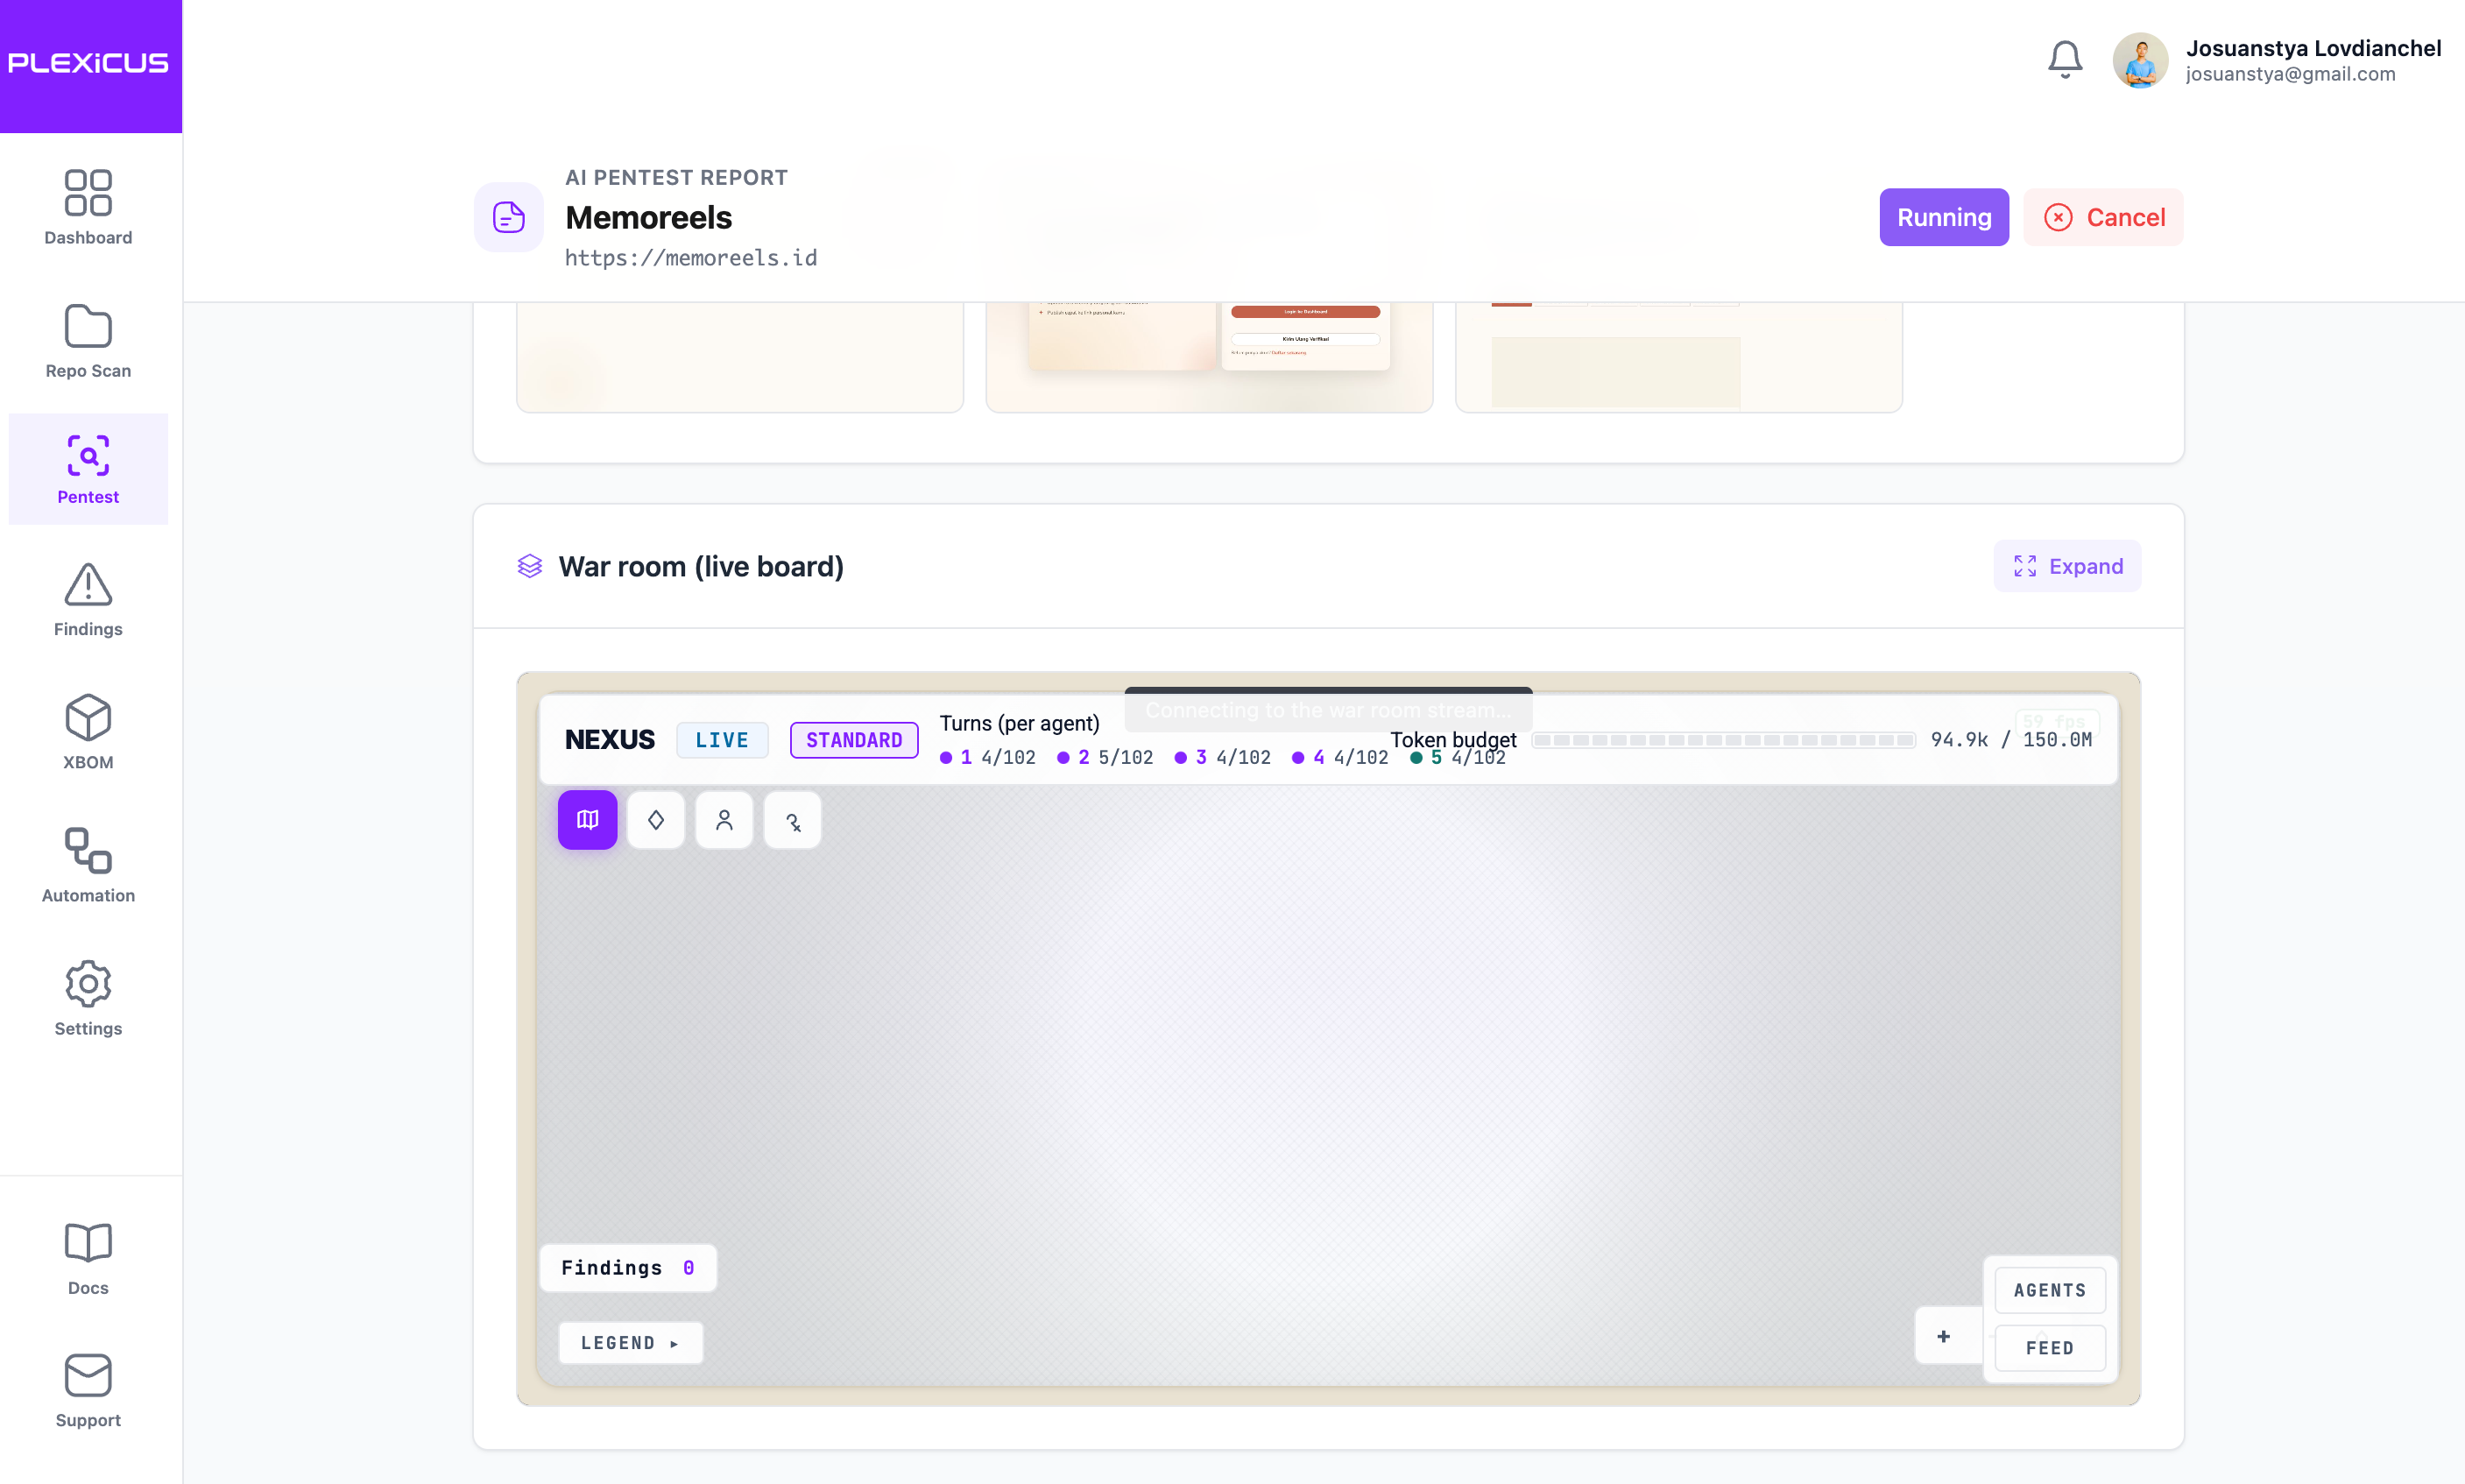
O painel ao vivo da War room integrado é mostrado durante a conexão ao fluxo.
O contexto compartilhado muda o que a IA pode investigar
Testes de invasão prolongados geram enormes quantidades de conhecimento temporário.
Um agente pode descobrir que:
um endpoint exige um token específico,
um usuário pertence a um papel de acesso,
um parâmetro controla um objeto no back-end,
um serviço expõe um hostname interno,
um payload que falhou ainda revelou a versão de um framework,
ou um fluxo de autenticação cria credenciais úteis em outro lugar.
Se essas observações ficarem presas ao contexto local do agente que as descobriu, seu valor será limitado.
Uma representação compartilhada do ataque permite acumular informações.
A descrição da palestra que acontecerá em 15 de outubro, na APIAddicts Days 2026, propõe uma prova de conceito da Plexicus que combina habilidades especializadas, MCP e um banco de dados orientado a grafos para memória de ataque. A representação proposta conecta ativos, vulnerabilidades e caminhos de exploração.
Representações em grafo fazem sentido para segurança ofensiva porque os próprios ataques são grafos.
Um nó pode representar:
Usuário
Endpoint
Credencial
Repositório
Serviço
Função
Vulnerabilidade
Ativo
Segredo
Uma aresta pode representar:
CAN_ACCESS
AUTHENTICATES_TO
CALLS
OWNS
EXPOSES
DEPENDS_ON
BYPASSES
LEADS_TO
A pergunta de segurança interessante passa a ser:
Que novo caminho surge a partir dessas relações?
Isso se aproxima muito mais da forma como invasores experientes raciocinam.
Verificar é mais importante do que gerar
A IA generativa traz um problema óbvio para a segurança ofensiva:
Ela pode estar errada com toda a confiança.
Um modelo pode interpretar uma resposta incorretamente.
Um comando pode retornar um código de sucesso inesperado.
Uma aplicação pode se comportar de maneira inconsistente.
Um payload pode parecer funcionar, mas o impacto real pode ser diferente da conclusão do agente.
Por isso, um sistema de pentest com IA não deve tratar como equivalentes:
“O modelo acha que encontrou uma vulnerabilidade”
e:
“Uma vulnerabilidade foi verificada.”
O setor de IA ofensiva está cada vez mais convergindo para essa ideia.
A XBOW descreve publicamente o uso de agentes validadores e exige provas antes de reportar descobertas como validadas.
A Plexicus aplica o mesmo princípio geral em seu modelo Proof-Driven AppSec: descobertas apresentadas como verificadas exigem evidências reproduzíveis e confirmação separada. Se uma segunda execução não consegue reproduzir o resultado, a Plexicus informa que a descoberta permanece não verificada ou é descartada, em vez de ser incluída apenas para deixar o relatório mais longo.
Isso muda o objetivo de otimização.
Um sistema fraco de segurança com IA otimiza:
Quantas vulnerabilidades conseguimos gerar?
Um sistema orientado por provas deveria otimizar:
Quantos caminhos de ataque relevantes conseguimos demonstrar com evidências defensáveis?
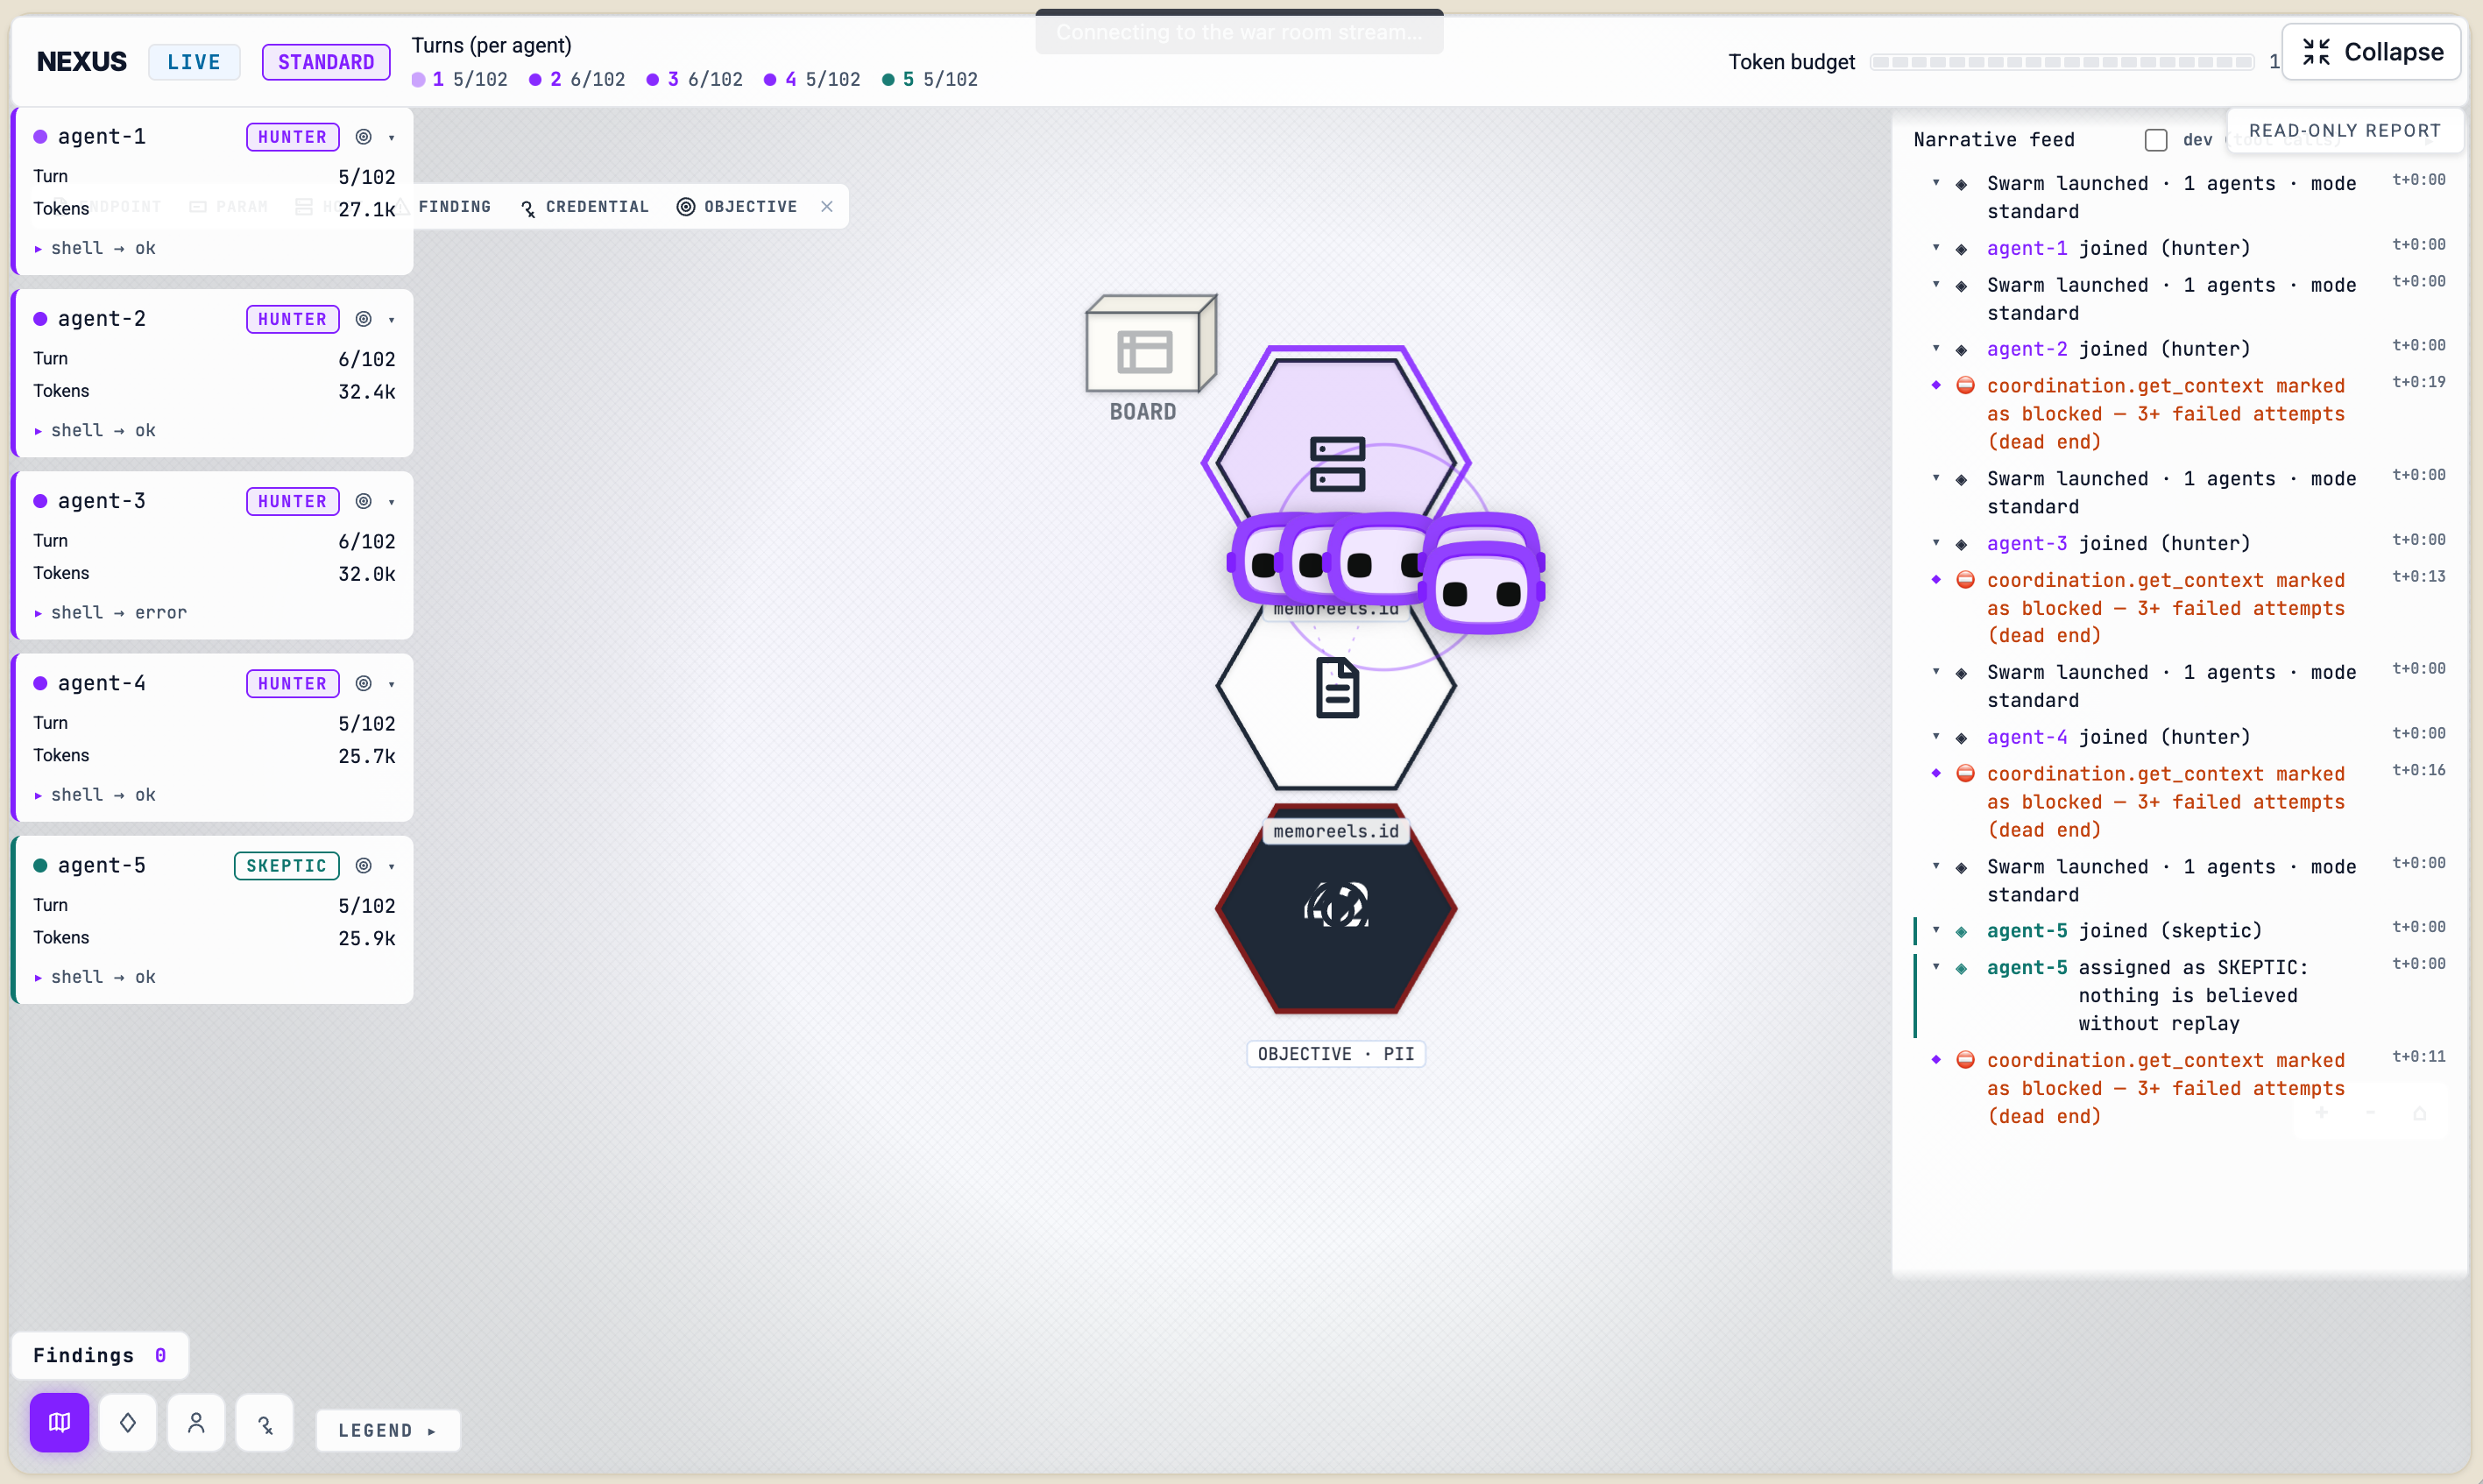
O painel ampliado mostra quatro agentes hunter e um skeptic, a atividade de cada agente e o feed narrativo. Esta captura mostra zero achados e tentativas bloqueadas; ela não demonstra um exploit verificado.
Por que cadeias de ataque importam mais do que a quantidade de alertas
As equipes de segurança raramente sofrem com a falta de alertas.
Uma organização moderna talvez já tenha resultados de:
SAST,
SCA,
DAST,
scanners de nuvem,
scanners de contêiner,
scanners de segredos,
CSPM,
inteligência sobre dependências,
bug bounty,
e testes de invasão manuais.
O problema mais difícil é decidir o que realmente importa.
Considere três descobertas isoladas:
Um endpoint acessível publicamente expõe o identificador de um serviço.

Um serviço interno aceita um destino de redirecionamento sem validação.

Um endpoint privilegiado confia em solicitações originadas desse serviço.
Separadamente, nenhuma delas necessariamente parece catastrófica.
Juntas:
Invasor externo
      ↓
Endpoint público
      ↓
Descoberta de serviço interno
      ↓
SSRF / primitiva de roteamento
      ↓
Solicitação interna confiável
      ↓
Endpoint privilegiado
O risco surge do caminho, não apenas das descobertas.
É por isso que a Plexicus posiciona o AI Swarm Pentest em torno de caminhos de ataque validados, em vez de uma lista interminável de problemas potenciais.
Mas por que chamar de “enxame”?
A palavra pode soar como jargão de marketing.
Não deveria significar “lançamos um monte de agentes”.
Em um enxame de segurança útil, as capacidades devem contribuir para uma missão comum.
O modelo mental é semelhante ao de uma equipe coordenada de pentest:
                     Missão
                        │
           ┌────────────┼────────────┐
           │            │            │
        Explorar     Raciocinar    Explorar falhas
           │            │            │
           └────────────┼────────────┘
                        │
                 Contexto compartilhado
                        │
           ┌────────────┼────────────┐
           │                         │
      Questionar                   Verificar
           │                         │
           └────────────┬────────────┘
                        │
                    Evidências
Capacidades diferentes podem investigar partes diferentes do ataque.
Mas elas não são pesquisadores independentes que escrevem notas sem relação entre si.
Elas contribuem para a mesma representação do alvo, que está sempre evoluindo.
A inteligência do sistema, portanto, vem não apenas do modelo, mas também da orquestração ao seu redor.
Esse ponto é especialmente importante à medida que os modelos de pesos abertos melhoram.
A descrição da palestra que acontecerá na APIAddicts propõe uma questão relacionada: como a orquestração, habilidades especializadas, ferramentas MCP e memória de ataque persistente podem ajudar um modelo de pesos abertos a investigar um alvo autorizado.
AI Swarm Pentest dentro do Proof-Driven AppSec
O pentest é útil.
Mas descobrir uma vulnerabilidade explorável ainda é apenas o começo do fluxo de trabalho de engenharia.
Alguém precisa entender o código afetado.
Alguém precisa avaliar a alcançabilidade e o impacto nos negócios.
Alguém precisa determinar a correção mais segura.
Alguém precisa implementá-la.
Alguém precisa revisar a alteração.
E alguém deve verificar se o exploit original deixou de funcionar.
É por isso que a Plexicus posiciona o AI Swarm Pentest como um componente de um fluxo mais amplo de Proof-Driven AppSec.
O modelo pode ser resumido assim:
VALIDAR
AI Swarm Pentest
      │
      │ caminho explorável + evidências
      ▼
ENTENDER
Deep Code Analysis
      │
      │ contexto do código + impacto
      ▼
CORRIGIR
Remediação revisada
      │
      │ correção proposta
      ▼
RETESTAR
O ataque ainda é reproduzido?
A plataforma atual da Plexicus descreve o fluxo como Validar → Entender → Corrigir: o AI Swarm Pentest explora caminhos de ataque autorizados, o Deep Code Analysis acrescenta contexto no nível do código, e a correção pode gerar alterações prontas para revisão, seguidas de um novo teste.
Essa conexão é importante.
Sem ela, o pentest autônomo corre o risco de criar uma nova versão de um antigo problema de segurança:
mais descobertas do que as equipes de engenharia conseguem corrigir.
O que o AI Swarm Pentest não é
O AI Swarm Pentest não é apenas um scanner de vulnerabilidades com descrições geradas por IA.
Não é um chatbot que diz como um invasor poderia explorar algo em teoria.
Não é permissão para um agente autônomo atacar qualquer infraestrutura.
Não é uma garantia de que todas as vulnerabilidades serão descobertas.
E não foi criado para eliminar o julgamento humano das decisões de segurança.
A Plexicus descreve explicitamente o AI Swarm Pentest como uma operação com escopo definido, regras de engajamento acordadas, pontos de decisão humana, verificação independente e sem modificações automáticas nos sistemas de produção.
Esses limites não são restrições que devam ser removidas.
Eles fazem parte do que torna a segurança ofensiva autônoma utilizável em um ambiente profissional.
O AI Swarm Pentest pode substituir pentesters humanos?
Não completamente.
E esse não deveria ser o objetivo imediato.
Pentesters humanos continuam sendo especialmente valiosos quando os testes exigem criatividade incomum, profundo contexto organizacional, raciocínio social, acesso físico, processos de negócios ambíguos ou julgamento sobre consequências que não podem ser delegadas com segurança a um software.
A IA tem vantagens diferentes.
Máquinas podem enumerar sistematicamente grandes superfícies.
Podem repetir tarefas sem fadiga.
Podem investigar muitas hipóteses.
Podem retestar depois de alterações.
E podem fazer certos tipos de exploração paralela em uma escala que seria cara de reproduzir com trabalho humano.
Pesquisas que comparam agentes de IA e profissionais de cibersegurança já mostram essa combinação de pontos fortes e limitações. Sistemas multiagentes podem ter bom desempenho em enumeração sistemática e exploração paralela, mas ainda podem enfrentar dificuldades em algumas tarefas que dependem muito de interfaces gráficas e produzir mais falsos positivos sem verificação suficiente.
Portanto, o futuro mais realista não é:
IA versus pentester
É:
A IA realiza exploração escalável
        +
A verificação reduz o ruído
        +
As pessoas controlam o escopo e exercem julgamento
        +
Especialistas em segurança investigam os casos difíceis
A Plexicus também afirma que o AI Swarm Pentest automatiza a exploração repetitiva, a correlação e a reprodução, sem remover o contexto humano nem a tomada de decisão final.
Onde o AI Swarm Pentest pode ser especialmente útil
A abordagem se torna particularmente interessante para organizações cuja superfície de software muda mais rápido do que testes manuais periódicos conseguem acompanhar.
Uma equipe pode lançar alterações na aplicação todos os dias.
APIs podem surgir e desaparecer entre ciclos de pentest.
Código gerado por IA pode aumentar bastante a velocidade de desenvolvimento.
Novas dependências e serviços podem ser introduzidos continuamente.
Um pentest anual tradicional continua sendo valioso, mas representa apenas um retrato daquele momento.
Testes baseados em agentes permitem avançar em direção a uma validação ofensiva mais frequente.
Não apenas:
“Nosso scanner encontrou alguma coisa?”
Mas:
“Um invasor ainda consegue reproduzir esse caminho de ataque depois da alteração mais recente?”
Essa é uma mudança importante: sair da descoberta periódica de vulnerabilidades e avançar para a validação contínua de segurança.
Um exemplo prático
Imagine uma aplicação SaaS gerada por IA.
A aplicação contém:
Interface web
Serviço de autenticação
API de cobrança
API de projetos
Armazenamento de arquivos
API administrativa
Um scanner tradicional detecta alguns cabeçalhos de segurança e uma dependência desatualizada.
Informação útil, mas não necessariamente o problema de maior risco.
Durante um AI Swarm Pentest, a etapa de exploração descobre:
GET /api/projects/{project_id}
Um usuário comum consegue consultar seu próprio projeto.
O enxame registra a relação:
USER_A → OWNS → PROJECT_123
Outra observação revela:
PROJECT_456 → OWNED_BY → USER_B
Uma hipótese sobre autorização é criada.
A capacidade relevante envia:
GET /api/projects/456
autenticada como Usuário A.
O servidor retorna metadados.
Interessante, mas ainda não é suficiente.
A investigação continua.
Os metadados retornados contêm:
export_id: EXP-8821
Outra capacidade descobre:
GET /api/exports/{export_id}/download
A solicitação é bem-sucedida.
O arquivo baixado inclui os dados privados do projeto do Usuário B.
O caminho de ataque passa a ser:
Usuário A
  ↓
Alterar o identificador do projeto
  ↓
Ler os metadados do projeto do Usuário B
  ↓
Descobrir o identificador da exportação
  ↓
Baixar a exportação
  ↓
Exposição de dados entre tenants
A etapa de verificação repete a cadeia de forma independente.
Se o exploit for reproduzido, o sistema poderá anexar evidências a cada etapa.
O Deep Code Analysis pode então rastrear a ausência do controle de autorização.
Um fluxo de correção pode propor a validação do escopo do tenant.
Após a revisão, o exploit original pode ser repetido.
Se falhar:
Ataque reproduzido antes da correção: SIM
Ataque reproduzido depois da correção: NÃO
Esse é um artefato de segurança muito mais forte do que:
Possível IDOR — Alto
A prova é o resultado mais importante
A IA tornará extremamente barato gerar hipóteses de segurança.
Isso é poderoso e perigoso ao mesmo tempo.
Um modelo pode gerar centenas de explicações plausíveis sobre por que uma aplicação talvez seja vulnerável.
Mas as equipes de AppSec não precisam de centenas de explicações plausíveis.
Elas precisam de confiança.
Precisam saber:
O que você alcançou?

Como chegou até lá?

É possível reproduzir?

Qual é o impacto?

De onde vem o comportamento vulnerável?

O que devemos alterar?

A correção realmente impediu o ataque?
Por isso, à medida que a IA se torna mais capaz, as evidências ficam mais importantes, não menos.
Quanto mais autônoma for a segurança, mais forte precisará ser sua camada de verificação.
O futuro do pentest não é um modelo ainda maior
Durante vários anos, o progresso da IA foi frequentemente descrito pelo tamanho dos modelos.
Um modelo mais inteligente produzia respostas melhores.
O pentest mostra por que essa visão é incompleta.
Segurança ofensiva não é apenas um benchmark de raciocínio.
É um problema de sistemas.
A IA precisa de ferramentas.
Precisa de memória.
Precisa de permissões.
Precisa de estado.
Precisa de uma representação do ambiente.
Precisa saber quando explorar.
Precisa saber quando parar.
Precisa distinguir uma hipótese promissora de um exploit demonstrado.
E precisa de um mecanismo para que outro processo questione suas conclusões.
Isso significa que o futuro do teste de invasão autônomo pode depender tanto de arquitetura e orquestração quanto da inteligência bruta do modelo.
A evolução se parece com isto:
Scanner de segurança
      ↓
Assistente de segurança com LLM
      ↓
Agente de pentest autônomo
      ↓
Pentest multiagente
      ↓
Enxame de IA orquestrado
      ↓
Proof-Driven AppSec
Cada etapa não necessariamente substitui a anterior.
Scanners continuam sendo úteis.
Pentesters humanos continuam sendo úteis.
Sistemas de agente único continuam sendo úteis.
A pergunta é qual arquitetura combina melhor com a complexidade e a frequência do problema de segurança que está sendo testado.
AI Swarm Pentest na Plexicus
O AI Swarm Pentest da Plexicus foi criado em torno de um princípio simples:
Não pare ao detectar o que talvez seja vulnerável. Demonstre o que um invasor realmente consegue alcançar.
Dentro de um escopo autorizado, a Plexicus explora o comportamento de aplicações e APIs, formula e testa hipóteses de ataque, conecta observações relevantes e mantém as evidências junto às descobertas.
As descobertas apresentadas como verificadas passam por uma etapa independente de reprodução.
O resultado se conecta ao restante do fluxo Proof-Driven AppSec da Plexicus, no qual as equipes podem acrescentar contexto do código, entender o impacto, revisar a correção e verificar o resultado novamente.
O objetivo não é gerar o maior relatório de pentest.
É dar às equipes de segurança e engenharia algo mais útil:
Um caminho de ataque validado.
Evidências que mostram por que ele é real.
Contexto que explica o que ele afeta.
E um caminho claro para corrigi-lo.
Perguntas frequentes
AI Swarm Pentest é o mesmo que uma varredura automatizada de vulnerabilidades?
Não.
Um scanner normalmente executa verificações ou sondas predeterminadas e reporta os comportamentos correspondentes. O AI Swarm Pentest usa agentes de IA para explorar um alvo autorizado, formular hipóteses, interagir com o comportamento da aplicação e investigar caminhos de ataque.
A Plexicus oferece modos DAST e AI Pentest e os documenta separadamente.
AI Swarm Pentest é só um conjunto de LLMs rodando ao mesmo tempo?
Não.
Paralelismo, por si só, não cria um comportamento de enxame útil.
Os elementos essenciais são orquestração, responsabilidades especializadas, contexto de ataque compartilhado, execução controlada e verificação.
Cada agente precisa de um modelo de IA diferente?
Não.
Especialização de agente e especialização de modelo são conceitos diferentes.
Vários agentes podem usar o mesmo modelo subjacente e receber missões, ferramentas, permissões, contexto ou responsabilidades de validação diferentes.
Por outro lado, uma camada de orquestração pode escolher modelos diferentes para tarefas diferentes.
O conceito de “enxame” é exclusivo da Plexicus?
Sistemas de segurança multiagentes não são exclusivos da Plexicus.
Sistemas acadêmicos e plataformas comerciais de pentest autônomo também usam arquiteturas multiagentes, agentes especializados ou agentes validadores.
A Plexicus usa AI Swarm Pentest para descrever sua implementação dessa abordagem dentro do fluxo mais amplo Proof-Driven AppSec, com foco em contexto de ataque compartilhado, evidências, verificação independente, análise de código e correção.
O AI Swarm Pentest consegue encontrar vulnerabilidades de lógica de negócios?
Testes baseados em agentes são especialmente relevantes para vulnerabilidades de lógica de negócios e de várias etapas, pois podem interagir com fluxos de trabalho em vez de depender apenas de assinaturas fixas.
A documentação da Plexicus afirma que seu AI Pentest pode testar fluxos autenticados e descobrir cadeias de ataque complexas e falhas de lógica de negócios.
O AI Swarm Pentest ataca a produção automaticamente?
Os testes devem permanecer dentro de um escopo explicitamente autorizado e das regras de engajamento acordadas.
A Plexicus afirma que suas operações são controladas por escopo e não modificam automaticamente sistemas de produção.
Ele elimina falsos positivos?
Nenhum sistema de segurança autônomo deveria prometer isso.
O objetivo é reduzir a incerteza por meio de reprodutibilidade e evidências.
Na Plexicus, uma descoberta precisa passar por uma etapa separada de verificação antes de ser apresentada como verificada.
O AI Swarm Pentest substitui o pentest manual?
Não.
Ele muda quais partes do teste de invasão podem ser automatizadas e repetidas em escala de máquina.
A experiência humana continua importante para definir o escopo, interpretar resultados, investigar casos específicos difíceis e tomar as decisões finais.
De encontrar vulnerabilidades a comprovar caminhos de ataque
A IA está facilitando a geração de código.
Também está facilitando a geração de ataques.
A validação de segurança precisa evoluir de acordo.
A resposta não pode ser simplesmente mais um scanner produzindo outra fila de alertas.
E acrescentar um LLM a esse scanner não resolve o problema automaticamente.
O que muda o fluxo de trabalho é a capacidade de investigar dinamicamente:
Explorar.
Formular uma hipótese.
Testá-la.
Compartilhar o que foi aprendido.
Conectar isso a outra observação.
Questionar a conclusão.
Reproduzir o ataque.
Manter as evidências.
Essa é a ideia por trás do AI Swarm Pentest.
Não é uma IA fingindo ser uma equipe Red Team inteira.
É um sistema orquestrado trabalhando em uma única missão de segurança autorizada.
E, acima de tudo:
Sem prova reproduzível, não há descoberta verificada.
Veja o que um invasor realmente consegue alcançar
O AI Swarm Pentest da Plexicus explora caminhos de ataque autorizados em aplicações e APIs, valida o que é explorável e fornece evidências que sua equipe pode revisar e usar.
Valide o caminho. Entenda o impacto. Corrija com evidências.