O que é SAST? O guia completo de testes estáticos de segurança de aplicações para 2026
Um guia completo de SAST em 2026: como a análise estática funciona, o que ela encontra e o que deixa passar, por que gera falsos positivos e como transformar uma descoberta em prova.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestTodo bug de segurança no seu próprio software começa como uma linha de código.
O teste estático de segurança de aplicações é uma das formas automatizadas mais antigas de procurar essas linhas antes que alguém execute o programa.
O SAST analisa código-fonte, bytecode ou binários sem executar a aplicação e aponta padrões de código e fluxos de dados que podem levar a uma vulnerabilidade, junto com o arquivo e a linha onde estão.
A OWASP descreve essas ferramentas da mesma forma: ferramentas de análise de código-fonte, também conhecidas como ferramentas SAST, analisam o código-fonte ou versões compiladas do código para ajudar a encontrar falhas de segurança. OWASP
A ideia é simples. A prática, não.
Uma ferramenta SAST consegue sinalizar um padrão perigoso em segundos. Nem sempre consegue dizer se um invasor alcança esse padrão, quais dados estão por trás dele ou se o alerta é real.
Essa lacuna pesa mais em 2026. No Data Breach Investigations Report 2026, a Verizon constatou que a exploração de vulnerabilidades se tornou o vetor de acesso inicial mais comum nas violações que analisou, com 31%, contra 20% no ano anterior.
Este guia explica o que é SAST, como funciona, o que encontra e o que deixa passar, como avaliar uma ferramenta e como transformar uma descoberta estática em evidências que sua equipe pode usar.
O que é SAST?
O teste estático de segurança de aplicações (SAST) é um método de teste de caixa-branca que inspeciona o código de uma aplicação, sem executá-lo, para encontrar fraquezas que podem se tornar vulnerabilidades de segurança.
“Caixa-branca” significa que a ferramenta enxerga o interior da aplicação: os arquivos-fonte, as funções, as variáveis e como os dados circulam entre eles.
“Estático” significa que nada é executado. A ferramenta lê e modela o código como um compilador faz e, então, aplica regras de segurança a esse modelo.
Uma descoberta típica de SAST responde a quatro perguntas:
- Qual fraqueza foi encontrada, normalmente mapeada para um identificador CWE, como CWE-89 (injeção de SQL).
- Onde ela está: arquivo, linha e o trecho de código.
- Como dados não confiáveis chegam até ela, quando a ferramenta rastreia um fluxo de dados.
- Qual a gravidade que a ferramenta atribui a ela.
A OWASP aponta esse detalhe de localização como um dos principais pontos fortes do método: a saída do SAST destaca o código problemático por nome de arquivo, local, número de linha e até o trecho afetado. OWASP
É por isso que os desenvolvedores continuam usando o SAST. Uma descoberta que aponta para a linha 276 de um arquivo é mais fácil de resolver do que um relatório que diz “a página de login está vulnerável”.
O que uma ferramenta SAST consegue analisar?
Dependendo da ferramenta, o SAST trabalha com uma ou mais destas entradas:
- Código-fonte, a entrada mais comum: Java, Python, JavaScript, Go, C#, PHP e assim por diante.
- Bytecode, como classes Java compiladas ou assemblies .NET.
- Binários, quando o código-fonte não está disponível.
- Arquivos de infraestrutura e de configuração, em ferramentas que estendem a análise estática para Terraform, Dockerfiles ou manifestos do Kubernetes.
Algumas ferramentas precisam de código que compile. A OWASP observa que muitas ferramentas SAST têm dificuldade para analisar código que não pode ser compilado e que os analistas muitas vezes não têm as bibliotecas certas, as instruções de build ou a base de código completa. OWASP
SAST é o mesmo que análise estática de código?
Quase.
A análise estática de código é a técnica ampla: qualquer leitura automatizada de código sem executá-lo, incluindo verificações de estilo, detectores de bugs e verificadores de tipos.
SAST é análise estática de código com um objetivo de segurança. Usa as mesmas técnicas de compiladores, mas suas regras procuram vulnerabilidades, não formatação ou desempenho.
Por que o SAST importa em 2026
O SAST não é novo. Quatro mudanças o tornam mais relevante agora, não menos.
1. Vulnerabilidades exploradas são a principal porta de entrada
O DBIR 2026 da Verizon coloca a exploração de vulnerabilidades em 31% das violações que analisou. O abuso de credenciais, o líder anterior, caiu para 13%, em parte porque a Verizon agora conta o pretexting como um vetor separado. Verizon DBIR
Nem toda vulnerabilidade explorada é uma falha de código na sua própria aplicação: o número do relatório abrange vulnerabilidades em qualquer software, incluindo produtos de terceiros.
Mas a parte que está no seu próprio código é a parte que só a sua equipe pode corrigir, e o SAST é a primeira verificação automatizada que a lê.
2. As classes de bugs mais antigas continuam no topo
O CWE Top 25 Most Dangerous Software Weaknesses de 2025, publicado pelo programa CWE do MITRE, coloca cross-site scripting (CWE-79) em primeiro lugar e injeção de SQL (CWE-89) em segundo.
As duas são falhas de injeção que o SAST foi criado para encontrar.
Em março de 2024, a CISA e o FBI emitiram um Secure by Design Alert conjunto sobre a eliminação da injeção de SQL. O alerta observa que a injeção de SQL continua sendo uma classe de vulnerabilidade comum, apesar de duas décadas de documentação e de mitigações eficazes.
3. Mais código é escrito por assistentes de IA
Assistentes de programação com IA escrevem código mais rápido do que as pessoas conseguem revisá-lo.
No 2026 GenAI Code Security Report, publicado em julho de 2026, a Veracode relatou que cerca de 44% das tarefas de geração de código com IA que testou produziram código com uma vulnerabilidade conhecida. A taxa média de aprovação em segurança entre os modelos foi de 56%, quase igual aos 55% do seu primeiro relatório. São resultados divulgados por um fornecedor de segurança, não uma replicação independente.
Seja qual for a taxa exata na sua base de código, mais código gerado significa mais código que alguém, ou algo, precisa verificar.
4. Frameworks de desenvolvimento seguro pedem análise de código
O Secure Software Development Framework (SP 800-218) do NIST inclui uma prática para revisar e/ou analisar código legível por humanos e identificar vulnerabilidades, para que sejam corrigidas antes de o software ser lançado.
A tarefa PW.7.2 pede que as equipes façam a revisão ou a análise de código com base nos seus padrões de codificação segura e registrem e façam a triagem de todos os problemas descobertos e das remediações recomendadas no fluxo de trabalho ou no issue tracker da equipe.
O SAST é uma forma comum de cumprir em escala a metade dessa tarefa que trata de “análise de código”.
SAST vs. DAST
SAST e DAST são os dois métodos de teste mais conhecidos e olham para uma aplicação de lados opostos.
| SAST | DAST | |
|---|---|---|
| Visão | Por dentro: lê o código | Por fora: envia solicitações a uma aplicação em execução |
| Precisa de | Código-fonte, bytecode ou binários | Uma aplicação implantada e em execução |
| Quando | Desde o primeiro commit | Depois que a aplicação é construída e implantada em um ambiente de teste |
| Relata | Arquivo, linha e caminho no código | URL, solicitação, resposta e comportamento observado |
| Forte em | Padrões de injeção, APIs inseguras, problemas de fluxo de dados | Comportamento em tempo de execução, configuração, respostas do servidor |
| Fraco em | Contexto de execução, configuração, comprovar a explorabilidade | Apontar a linha vulnerável, código que o crawler nunca alcança |
O SAST diz onde uma fraqueza pode estar. O DAST diz o que a aplicação em execução realmente faz.
Um não substitui o outro. Para uma comparação mais detalhada, veja SAST vs. DAST: a diferença e por que usar os dois.
SAST vs. SCA
A análise de composição de software (SCA) olha para o código que você não escreveu.
Ela faz o inventário de pacotes de código aberto e de outros componentes de terceiros e compara suas versões com vulnerabilidades conhecidas.
O SAST olha para o código que você escreveu: suas funções, suas consultas, seus handlers.
| SAST | SCA | |
|---|---|---|
| Escopo | Código próprio | Componentes de terceiros e suas versões |
| Encontra | Falhas de código, muitas vezes sem CVE | Vulnerabilidades conhecidas, normalmente com CVE |
| Correção típica | Alterar o seu código | Atualizar, substituir ou aplicar patch ao componente |
Você precisa dos dois. Uma biblioteca vulnerável e uma falha de injeção no seu próprio handler são problemas diferentes, com correções diferentes.
SAST vs. revisão manual de código
O SSDF do NIST traça essa linha com clareza. Na tarefa PW.7.1, revisão de código significa que uma pessoa olha diretamente para o código para encontrar problemas, e análise de código significa que ferramentas são usadas para encontrar problemas no código, de forma totalmente automatizada ou junto com uma pessoa. NIST SP 800-218
As duas se complementam:
- O SAST é rápido, repetível e incansável. Lê cada linha a cada commit.
- Um revisor humano entende a intenção. Percebe que um endpoint de “excluir conta” nunca verifica quem está pedindo.
O melhor uso do SAST é liberar os revisores da caça a padrões conhecidos, para que dediquem a atenção ao design e à lógica.
Como o SAST funciona
Cada motor de SAST é diferente, mas a maioria segue as mesmas seis etapas.
1. Transformar o código em um modelo
A ferramenta lê cada arquivo e o transforma em uma representação estruturada, normalmente uma árvore sintática abstrata (AST) e depois uma representação intermediária mais próxima da que um compilador usa.
A análise léxica vem primeiro. A OWASP a descreve como a conversão da sintaxe do código-fonte em tokens, para abstrair o código e facilitar sua manipulação. OWASP
2. Construir o fluxo de controle e o fluxo de dados
Em seguida, a ferramenta descobre como o programa pode ser executado.
Um grafo de fluxo de controle representa o código como blocos básicos ligados pelos saltos entre eles. A análise de fluxo de dados acompanha, então, como os valores circulam por esses blocos. OWASP
Os melhores motores fazem isso entre funções, arquivos e módulos (análise interprocedural), porque vulnerabilidades reais raramente cabem dentro de uma única função.
3. Marcar sources, sinks e sanitizers
É aqui que entra a segurança.
- Sources (fontes) são os pontos por onde entram dados não confiáveis: parâmetros de solicitação, cabeçalhos, arquivos, mensagens.
- Sinks são operações perigosas: uma consulta SQL, um comando de shell, uma resposta HTML, um caminho de arquivo.
- Sanitizers e APIs seguras tornam os dados seguros para um determinado sink ou os mantêm fora da parte perigosa da chamada: codificação de saída, normalização de caminhos, consultas parametrizadas.
4. Executar as regras
O motor aplica seu conjunto de regras ao modelo.
Algumas regras são padrões simples (“esta função de hash fraca é chamada”). Outras são regras de taint: a OWASP descreve a análise de taint como a identificação de variáveis contaminadas com entrada controlável pelo usuário e o rastreamento delas até uma função vulnerável, o sink; se o valor contaminado chega ao sink sem ser sanitizado, ele é sinalizado. OWASP
Este é o caso clássico em Java:
// Source: an attacker-controlled request parameter
String username = request.getParameter("username");

// Sink: the value is concatenated into a SQL string
String sql = "SELECT * FROM accounts WHERE username = '" + username + "'";
ResultSet rs = statement.executeQuery(sql);
Uma regra de taint vê username fluir de getParameter para executeQuery sem nenhum sanitizer no meio e relata uma injeção de SQL (CWE-89) na linha da consulta.
A correção elimina o sink perigoso. Uma consulta parametrizada envia o valor como dado, nunca como texto SQL:
String sql = "SELECT * FROM accounts WHERE username = ?";
PreparedStatement ps = connection.prepareStatement(sql);
ps.setString(1, username);
ResultSet rs = ps.executeQuery();
5. Relatar a descoberta
Cada descoberta recebe um tipo de fraqueza (normalmente um CWE), um local, uma gravidade e, nas melhores ferramentas, o rastro da source até o sink.
A OWASP lista a interoperabilidade da saída como critério de seleção e cita o SARIF, o Static Analysis Results Interchange Format. O SARIF 2.1.0 é um OASIS Standard que define um formato comum para a saída de ferramentas de análise estática. Assim, os resultados de scanners diferentes podem ser lidos pelos mesmos dashboards e plataformas de hospedagem de código.
Veja como uma descoberta de uma fonte SAST aparece na plataforma da Plexicus, com a sua localização no código:
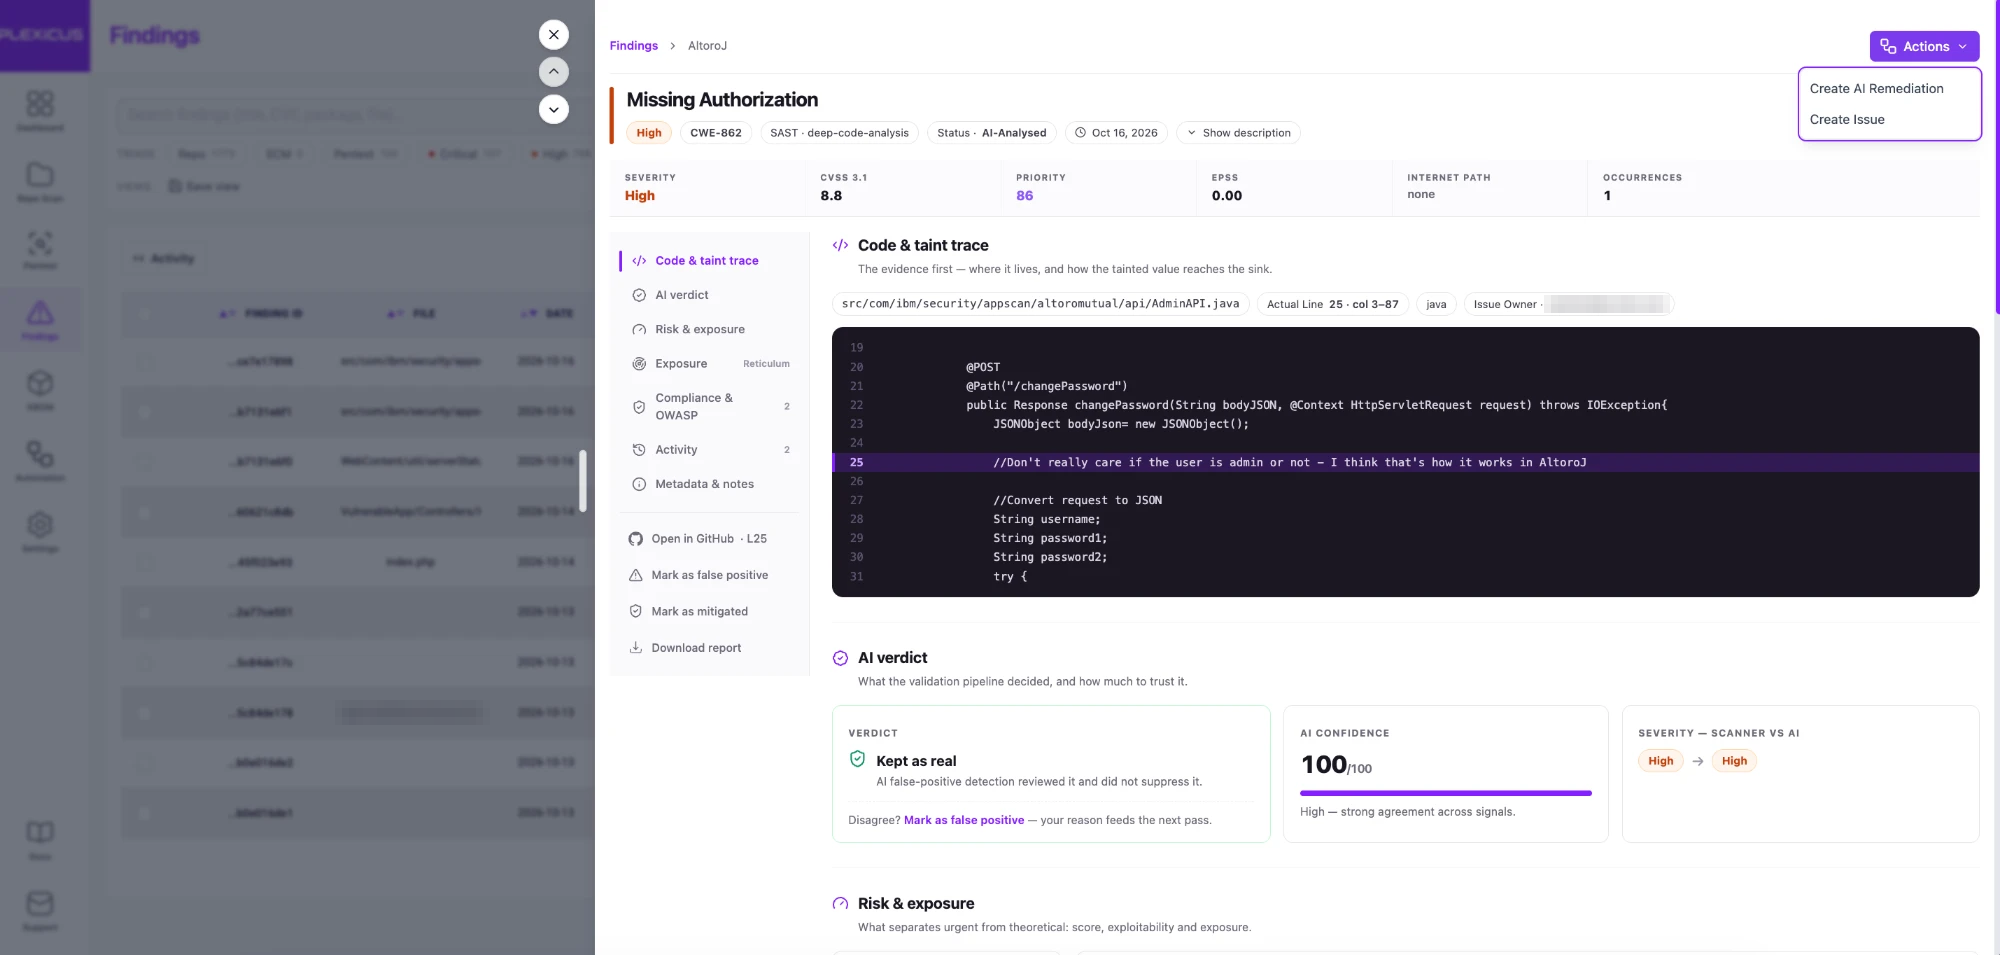
Captura de tela: a visualização de detalhe de uma descoberta de autorização ausente (CWE-862) em uma aplicação Java de demonstração, na plataforma da Plexicus, com o rótulo de fonte SAST e a seção Code & taint trace aberta na linha sinalizada. O painel do veredito de IA e o menu Actions estão visíveis. Dados de demonstração, capturados em outubro de 2026; o endereço de e-mail do responsável pela issue está pixelado.
6. Triagem
Uma pessoa, ou uma segunda passagem automatizada, decide o que cada descoberta significa.
É real e alcançável? Importa, e quem é o responsável pela correção?
A triagem é onde a maioria dos programas de SAST dá certo ou fracassa. Uma ferramenta que gera descobertas mais rápido do que a equipe consegue fazer a triagem gera backlog, não segurança.
Técnicas de análise estática
Os motores de SAST combinam algumas das técnicas abaixo. Cada uma tem um equilíbrio diferente entre velocidade, precisão e profundidade.
Correspondência de padrões
O motor procura na árvore sintática, ou às vezes no texto bruto, construções sabidamente ruins: uma chamada a uma cifra fraca, uma credencial fixa no código, uma verificação de certificado desativada.
Pontos fortes: rápida, regras fáceis de escrever, fácil de explicar.
Limitações: não entende de onde vêm os dados, então sinaliza usos seguros e deixa passar usos inseguros que parecem diferentes.
Análise de fluxo de dados e de taint
O motor acompanha os valores das sources até os sinks ao longo do programa, como no exemplo em Java acima.
Pontos fortes: encontra falhas de injeção junto com o caminho que as explica; menos alertas em código que nunca recebe entrada não confiável.
Limitações: mais lenta; a precisão depende de quão bem a ferramenta modela frameworks, bibliotecas e sanitizers; programas muito grandes obrigam a aproximações.
Modelos semânticos e estruturais
Alguns motores constroem um modelo mais rico da aplicação: seus endpoints, parâmetros, grafo de chamadas e os papéis de acesso que alcançam cada caminho.
Pontos fortes: consegue ligar uma fraqueza ao endpoint que a expõe e aos dados por trás dele, que é o que a triagem precisa.
Limitações: mais difícil de construir e continua sendo um modelo. Descreve o que o código poderia fazer, não o que um invasor fez.
Análise assistida por IA
Ferramentas mais recentes acrescentam grandes modelos de linguagem para explicar descobertas, sugerir correções ou filtrar ruído.
Pontos fortes: explicações legíveis; consegue raciocinar sobre código que as regras descrevem mal.
Limitações: um modelo de linguagem que lê um trecho de código não estabelece, por si só, como uma fraqueza afeta a aplicação em execução. Ainda precisa dos fatos estruturais e, idealmente, de prova.
Para entender melhor por que acoplar um modelo de linguagem à correspondência de padrões não basta, veja O que é Deep Code Analysis?.
O que o SAST encontra bem
A OWASP cita buffer overflows e injeção de SQL como exemplos de vulnerabilidades conhecidas que as ferramentas SAST identificam e observa que elas escalam bem: podem ser executadas em muito software e de forma repetida, como em builds noturnos ou na integração contínua. OWASP
Na prática, o SAST é mais forte em falhas visíveis no próprio código:
| Fraqueza | CWE | Por que o SAST a enxerga |
|---|---|---|
| Cross-site scripting | CWE-79 | dados não confiáveis fluem para uma resposta HTML sem codificação |
| Injeção de SQL | CWE-89 | dados não confiáveis fluem para uma string de consulta |
| Injeção de comandos do sistema operacional | CWE-78 | dados não confiáveis fluem para uma chamada de shell |
| Path traversal | CWE-22 | dados não confiáveis fluem para um caminho de arquivo |
| Injeção de código | CWE-94 | dados não confiáveis fluem para um avaliador |
| Escrita fora dos limites | CWE-787 | operações de memória inseguras em C e C++ |
| Uso de credenciais fixas no código | CWE-798 | um segredo literal aparece no código |
As seis primeiras dessas fraquezas aparecem no CWE Top 25 de 2025. MITRE CWE
O que o SAST deixa passar
A OWASP é direta sobre os limites. Sua lista de fraquezas do SAST inclui: OWASP
- Muitos tipos de vulnerabilidade são difíceis de encontrar automaticamente, incluindo problemas de autenticação, problemas de controle de acesso e uso inseguro de criptografia.
- As ferramentas atuais conseguem identificar automaticamente apenas uma porcentagem relativamente pequena das falhas de segurança de aplicações.
- Grande número de falsos positivos.
- Com frequência não conseguem encontrar problemas de configuração, porque eles não estão representados no código.
- É difícil provar que um problema identificado é uma vulnerabilidade real.
Esses limites coincidem com o OWASP Top 10
. Sua primeira categoria é Broken Access Control e a segunda é Security Misconfiguration: os dois tipos de risco com que a análise estática mais tem dificuldade.Mais três pontos cegos decorrem da forma como o SAST funciona:
Lógica de negócios
Uma ferramenta estática não sabe que um usuário só deveria baixar as próprias faturas. Se o código verifica a sessão, mas não a propriedade, todas as linhas parecem corretas.
Execução e ambiente
Cabeçalhos definidos por um proxy, uma feature flag em produção, uma configuração de nuvem permissiva: nada disso está no repositório que a ferramenta lê.
Explorabilidade
Um caminho contaminado no código é uma hipótese. Se um invasor consegue alcançá-lo pela internet, com quais privilégios e o que ganha com isso, é outra questão.
O SAST responde “onde isto pode dar errado?”. Não responde “alguém consegue mesmo fazer isto contra nós?”.
Por que o SAST gera falsos positivos
Um falso positivo é uma descoberta que não é uma vulnerabilidade real.
A OWASP explica a causa raiz: muitas vezes a ferramenta não tem certeza da integridade e da segurança dos dados enquanto eles circulam pela aplicação, da entrada à saída, e não consegue rastrear dados através de componentes de código fechado ou de sistemas externos. OWASP
Então o motor precisa escolher. Quando não consegue provar que um caminho é seguro, pode ficar em silêncio e arriscar um falso negativo ou relatar e arriscar um falso positivo. Uma ferramenta de segurança que relata nessa situação produz exatamente os falsos positivos que a OWASP descreve.
Causas comuns:
- Sanitizers personalizados que a ferramenta não reconhece.
- Mágica de frameworks: injeção de dependências, anotações ou ORMs que a ferramenta não modela.
- Código morto ou de teste que nunca roda em produção.
- Falta de contexto: a entrada já é validada por um gateway que a ferramenta não enxerga.
O que conta como “demais”?
O Google publicou uma das respostas mais claras. Em “Lessons from Building Static Analysis Tools at Google” (Communications of the ACM, 2018), seus engenheiros definem um falso positivo efetivo como um problema sobre o qual os desenvolvedores não tomaram nenhuma ação positiva depois de vê-lo, mesmo que o problema estivesse tecnicamente correto.
As verificações de revisão de código deles precisam ter menos de 10% de falsos positivos efetivos e, se a parcela de cliques em “Not useful” de um analisador passar de 10%, a equipe desativa esse analisador até que os autores o melhorem. Essa é a prática interna do Google, relatada pelos próprios engenheiros.
A lição para qualquer equipe: são os desenvolvedores, não os autores da ferramenta, que decidem se ela é precisa. Uma descoberta que ninguém resolve consome atenção e não corrige nada.
Falsos negativos também importam
Uma ferramenta silenciosa não é uma ferramenta segura.
Um falso negativo é uma vulnerabilidade real que a ferramenta deixou passar. Ajustar um scanner até ele não relatar nada incômodo é o jeito mais fácil de comprar um dashboard limpo e uma aplicação insegura.
Como avaliar uma ferramenta SAST
A lista de critérios de seleção da OWASP é um bom checklist inicial: OWASP
- Suporte às suas linguagens de programação.
- Capacidade de detectar as vulnerabilidades que importam para você, como as do OWASP Top Ten.
- Precisão: taxas de falsos positivos e de falsos negativos e a pontuação no OWASP Benchmark.
- Compreensão das bibliotecas e dos frameworks que você usa.
- Se precisa de código-fonte que compile e se consegue rodar sobre binários.
- Plugins para IDE, facilidade de configuração e integração com CI/CD.
- Interoperabilidade da saída, por exemplo SARIF.
Use benchmarks públicos e depois o seu próprio código
Três recursos públicos ajudam a comparar ferramentas com base em resultados conhecidos:
- OWASP Benchmark. Uma suíte de testes executável em Java e Python, criada para verificar a velocidade e a precisão de ferramentas de detecção de vulnerabilidades, com geradores de scorecards para ferramentas comuns. A intenção é que toda vulnerabilidade pontuada seja de fato explorável. OWASP Benchmark
- Suítes de teste Juliet. Escritas pelo NSA Center for Assured Software e hospedadas no Software Assurance Reference Dataset do NIST. Só a suíte Juliet atual para C e C++ reúne 64.099 casos de teste organizados em 118 CWEs. NIST SARD
- NIST SATE. A Static Analysis Tool Exposition é um estudo recorrente e não competitivo sobre a eficácia de ferramentas de análise estática. O NIST afirma que o objetivo não é escolher a “melhor” ferramenta, porque as ferramentas têm pontos fortes diferentes. Foram realizadas seis edições, a mais recente relatada em setembro de 2019. NIST SATE
Benchmarks são sintéticos. O teste que importa é o seu próprio repositório: rode cada candidata no mesmo código, peça a um engenheiro que faça a triagem de uma amostra das descobertas e conte quantas levam a uma correção real.
Para uma lista de ferramentas para começar essa comparação, veja nosso levantamento de ferramentas SAST para desenvolvimento seguro.
Boas práticas de SAST
1. Comece com um conjunto de regras pequeno e confiável
Ative as regras sobre as quais sua equipe vai agir: injeção, desserialização insegura, segredos fixos no código, criptografia fraca. Amplie quando as primeiras descobertas estiverem sendo corrigidas.
2. Bloqueie descobertas novas nos pull requests e trate o resto como linha de base
Os desenvolvedores aceitam feedback sobre o código que acabaram de escrever. Ignoram um comentário de pull request que lista 400 problemas de 2019.
Por isso, analise cada pull request apenas em busca de descobertas novas e registre as existentes como uma linha de base, que você reduz por risco no seu próprio ritmo.
O SAST é mais útil quando roda onde os desenvolvedores já trabalham. Uma organização comum:
IDE            -> instant feedback while typing
Pull request   -> scan only the changed code, comment on the diff
CI pipeline    -> full rule set, block on agreed severities
Scheduled scan -> whole repository, new rules, old code
A OWASP observa que ferramentas que chegam à IDE dão aos desenvolvedores feedback imediato sobre problemas que eles podem estar introduzindo, o que é muito útil em comparação com encontrar vulnerabilidades muito depois. OWASP
3. Ensine a ferramenta a conhecer o seu código
Registre seus sanitizers, validadores e wrappers de frameworks personalizados. Cada um que você registra elimina uma família inteira de falsos positivos.
4. Acompanhe os falsos positivos efetivos
Adote a ideia do Google: meça com que frequência os desenvolvedores agem sobre uma descoberta. Uma regra sobre a qual ninguém age precisa ser corrigida ou removida.
5. Priorize por alcançabilidade e exposição
Uma injeção de SQL em um endpoint exposto à internet não é o mesmo que uma em um script interno de processamento em lote. Classifique as descobertas pelo que as alcança e pelo que elas alcançam.
6. Registre e faça a triagem no fluxo de trabalho do desenvolvedor
É o que o NIST pede na PW.7.2: descobertas e remediações recomendadas registradas e triadas no fluxo de trabalho ou no issue tracker da equipe. Um relatório em PDF enviado por e-mail uma vez por trimestre dificilmente cumpre isso.
7. Valide antes de escalar e reteste depois da correção
Antes que uma descoberta estática vire um ticket crítico, tente prová-la. Um exploit reproduzido, ou pelo menos um caminho alcançável confirmado, muda a velocidade com que uma equipe age.
Uma correção não termina quando o pull request entra no merge. Execute a análise novamente, e idealmente a prova, para confirmar que a fraqueza desapareceu e que a correção não a deslocou para outro lugar.
Erros comuns com SAST
Erro 1: Tratar o número de descobertas como métrica
Mais descobertas não significam mais segurança. Conte os problemas corrigidos e validados e o tempo até a correção.
Erro 2: Ativar todas as regras no primeiro dia
O resultado são milhares de descobertas para triar de uma vez e uma equipe que aprende a ignorar a ferramenta.
Erro 3: Bloquear builds com descobertas não verificadas
Um gate que falha por falsos positivos acaba sendo contornado. Bloqueie apenas com regras que têm histórico comprovado.
Erro 4: Supor que uma análise limpa significa uma aplicação segura
A própria lista da OWASP diz que problemas de controle de acesso e de autenticação são difíceis para o SAST encontrar automaticamente e que problemas de configuração muitas vezes passam despercebidos. Um relatório de SAST limpo diz pouco sobre eles.
Erro 5: Deixar a correção para “depois”
Uma descoberta sem responsável e sem uma alteração proposta é uma anotação, não um controle de segurança.
SAST e código gerado por IA
Os assistentes de programação com IA mudam o volume do problema, não a sua natureza.
As fraquezas no código gerado são as conhecidas: injeção, autorização ausente, criptografia fraca, segredos no código. O primeiro relatório da Veracode sobre o tema, um estudo de fornecedor publicado em 2025, encontrou cross-site scripting entre os problemas mais frequentes nas amostras geradas que testou. Veracode
O que muda é o ritmo. Quando um desenvolvedor aceita uma sugestão de 200 linhas em segundos, a revisão que acontecia enquanto ele digitava simplesmente não acontece.
Três ajustes ajudam:
- Analise onde o código é aceito. Análises na IDE e nos pull requests importam mais quando o código chega em blocos grandes.
- Não deixe o assistente avaliar o próprio trabalho. A ferramenta que escreveu o código não é uma verificação independente dele.
- Mantenha a prova no ciclo. Código gerado que “parece certo” merece a mesma validação que qualquer outro código.
Normas e frameworks que pedem análise de código
NIST SSDF (SP 800-218)
A edição final atual foi publicada em fevereiro de 2022. A prática PW.7 trata da revisão ou análise de código legível por humanos, e a tarefa PW.7.2 pede que as descobertas sejam registradas e triadas. NIST
O NIST publicou uma revisão em rascunho, SP 800-218 Rev. 1, em 17 de dezembro de 2025; o período de comentários terminou em 30 de janeiro de 2026, e ela continua sendo um rascunho. NIST
OWASP Top 10
A edição atual da lista de conscientização da OWASP. Injection é A05; Broken Access Control é A01. O SAST cobre bem uma parte da lista e mal outra parte, como mostrado acima. OWASP
CWE Top 25 (2025)
A classificação do MITRE das fraquezas de software mais perigosas. Os identificadores CWE dão às ferramentas uma linguagem comum: uma descoberta mapeada para CWE-89 significa injeção de SQL em qualquer ferramenta. MITRE CWE
OWASP ASVS
O Application Security Verification Standard, cuja versão estável mais recente é a 5.0.0, lista requisitos detalhados de verificação de segurança. Alguns podem ser verificados lendo o código; outros exigem testes ou revisão. OWASP ASVS
SARIF
O formato padrão da OASIS para resultados de análise estática. Permite trocar ou combinar scanners sem reconstruir seus relatórios. A versão 2.1.0 é o padrão aprovado; um rascunho de comitê da próxima versão foi publicado em outubro de 2026. OASIS
Da descoberta de SAST à prova
Este é o resumo honesto do SAST.
É a melhor ferramenta que você tem para ler cada linha do seu código, todos os dias.
Também é, segundo a própria OWASP, uma ferramenta que encontra automaticamente apenas uma parcela relativamente pequena das falhas de segurança, gera falsos positivos e tem dificuldade para provar que o que encontrou é explorável.
Um teste de penetração fica na outra ponta: ele tenta explorar o sistema em execução como um invasor faria.
Onde o SAST diz “este caminho de código pode permitir injeção de SQL”, um pentest diz “extraímos estes registros por meio desta solicitação”. Essa é a diferença entre uma hipótese e uma prova.
Então a pergunta não é “SAST ou outra coisa”. É o que acontece depois da descoberta:
Static finding    -> "this code path might be vulnerable"
Code context      -> "this is the endpoint, the data and the role behind it"
Validation        -> "here is the evidence that it can be exploited"
Reviewed fix      -> "here is the change, with the reasoning and a test"
Re-test           -> "the proof no longer reproduces"
Essa cadeia é o que chamamos de Proof-Driven AppSec. A regra é curta: sem PoC, não há finding.
Um alerta estático é onde o trabalho começa. São as evidências que fazem uma equipe agir.
Onde a Plexicus se encaixa
A Plexicus trata o SAST como o primeiro sinal e depois acrescenta o contexto, a prova e a correção.
Comece com uma análise. A ferramenta SAST gratuita analisa seu código-fonte no GitHub com acesso somente leitura. A Plexicus afirma que não armazena código nem o usa para treinar IA.
O relatório lista as vulnerabilidades detectadas com a distribuição por gravidade, referências de CVE e pontuação CVSS. A análise gratuita se conecta hoje ao GitHub; GitLab e Bitbucket aparecem como em breve.
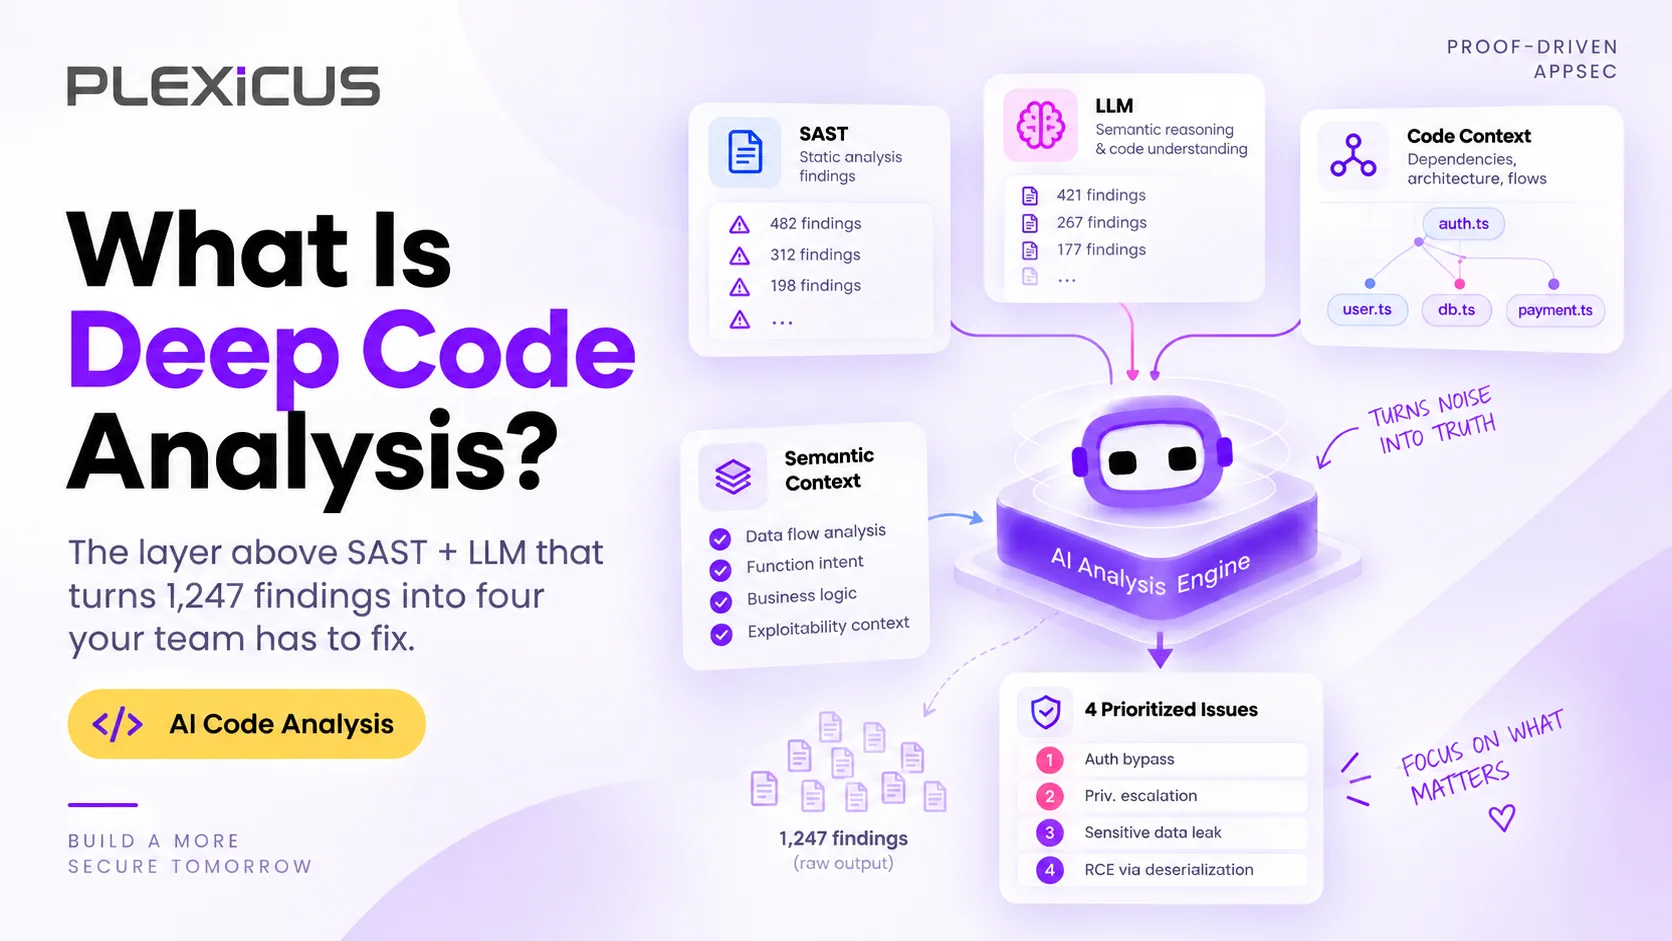
Acrescente contexto. O Deep Code Analysis conecta código, fluxo de dados e impacto no negócio. A página do produto explica a diferença sem rodeios: o SAST pode sinalizar um padrão e um modelo de linguagem pode explicar código, mas nenhum dos dois estabelece como uma fraqueza afeta a aplicação.
O Deep Code Analysis rastreia o caminho de código afetado, para que os engenheiros vejam os endpoints, os parâmetros e a lógica de negócios que uma descoberta toca, liga cada descoberta aos dados que ela alcança e ao papel de acesso que pode acioná-la e mapeia a classe da fraqueza para CWE. A página lista 12 linguagens: JavaScript, TypeScript, Python, Go, Java, Rust, Ruby, PHP, C#, Swift, Kotlin e Scala.
Prove. O Deep Code Analysis acrescenta o contexto e o AI Swarm Pentest valida as descobertas de maior prioridade. O AI Swarm Pentest valida caminhos exploráveis na sua aplicação, API e código-fonte dentro de um escopo autorizado, com verificação independente e sem alterações automáticas em produção. Nossa introdução ao AI Swarm Pentest explica como funciona o enxame de agentes.
Corrija. Depois que uma descoberta é verificada, o Plexicus Remediation prepara o contexto de remediação e uma alteração sugerida. Para descobertas clássicas de SAST, como injeção de SQL, XSS, SSRF, desserialização insegura e criptografia fraca, a Plexicus prepara patches revisados com testes de regressão anexados quando relevante, e um gancho de reteste é conectado ao CI. Sua equipe mantém o controle do merge: a Plexicus nunca faz push para produção.
Veja como fica uma descoberta estática de injeção de SQL depois que uma correção é proposta:
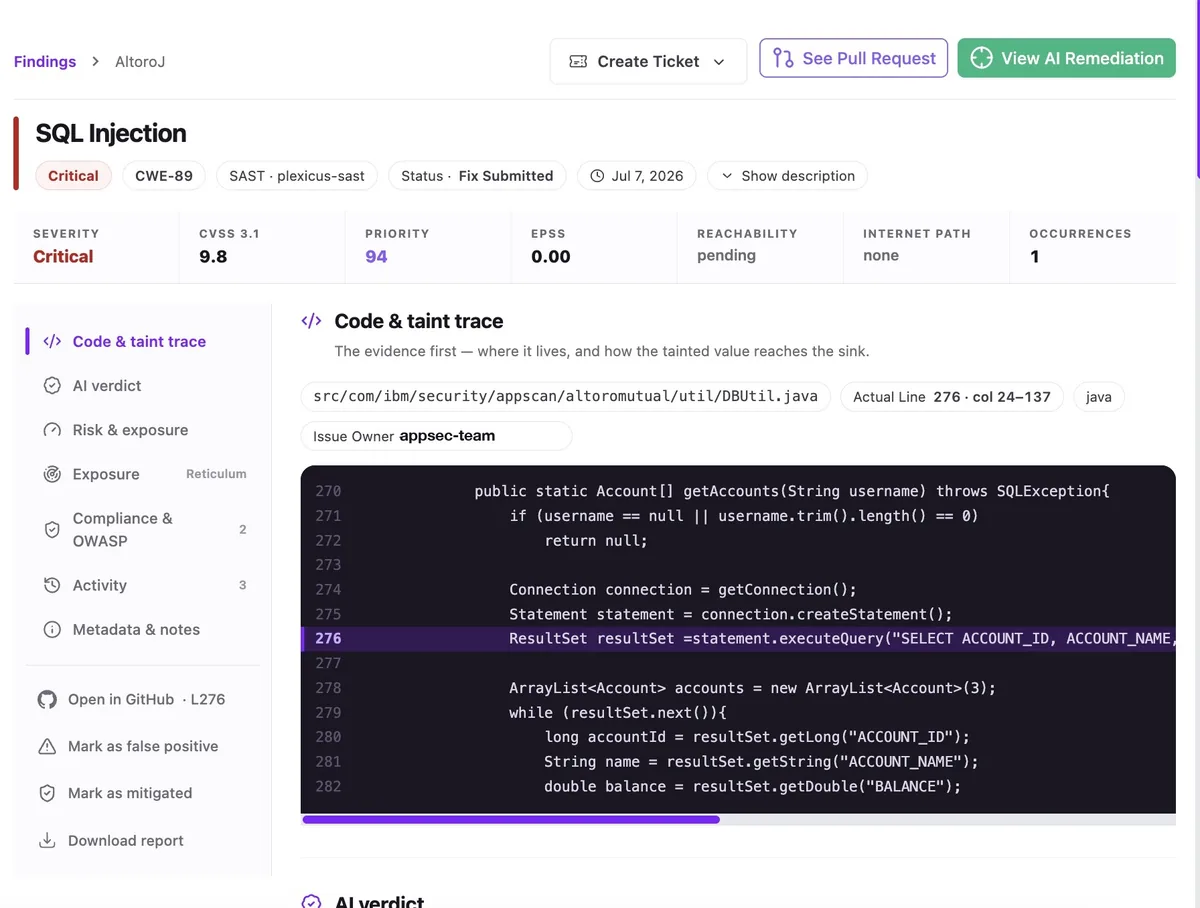
Captura de tela: uma descoberta crítica de injeção de SQL (CWE-89) em uma aplicação Java de demonstração, com o rótulo de fonte SAST e o status Fix Submitted, exibida na plataforma da Plexicus. A barra de ferramentas oferece Create Ticket, See Pull Request e View AI Remediation. Dados de demonstração de uma versão anterior da interface da Plexicus, julho de 2026.
Juntando tudo, isso é um ciclo fechado com PR: um sinal estático, contexto, evidências para o que importa e, então, uma alteração revisada que sua equipe decide se entra no merge.
Para ver onde o SAST se encaixa em um programa completo, leia nosso guia completo de segurança de aplicações. Para saber o que acontece depois da validação, veja Apresentando a remediação nativa de IA.
Perguntas frequentes
O que significa SAST?
SAST significa static application security testing, ou teste estático de segurança de aplicações: analisar o código de uma aplicação em busca de fraquezas de segurança sem executá-lo.
Qual é a diferença entre SAST e DAST?
O SAST lê o código por dentro, sem executá-lo. O DAST testa uma aplicação em execução por fora, enviando solicitações. O SAST aponta a linha; o DAST mostra o comportamento real em execução.
Qual é a diferença entre SAST e SCA?
O SAST analisa o código que sua equipe escreveu. O SCA faz o inventário de componentes de terceiros e de código aberto e compara suas versões com vulnerabilidades conhecidas.
Quais vulnerabilidades o SAST consegue encontrar?
O SAST é mais forte em falhas visíveis no código: injeção de SQL, cross-site scripting, injeção de comandos, path traversal, injeção de código, operações de memória inseguras e credenciais fixas no código.
O que o SAST não consegue encontrar?
Segundo a OWASP, o SAST tem dificuldade com problemas de autenticação, problemas de controle de acesso, uso inseguro de criptografia e problemas de configuração, e tem dificuldade para provar que uma descoberta é explorável. Falhas de lógica de negócios também ficam em grande parte invisíveis para ele.
Por que o SAST gera tantos falsos positivos?
Quando uma ferramenta não consegue provar que os dados estão seguros enquanto passam da entrada à saída, ela normalmente os relata. Sanitizers personalizados, frameworks que a ferramenta não modela e a falta de contexto de execução são as causas mais comuns.
Como reduzir os falsos positivos do SAST?
Comece com um conjunto de regras pequeno, registre seus sanitizers e wrappers de frameworks, analise apenas o código novo nos pull requests, acompanhe com que frequência os desenvolvedores agem sobre as descobertas e valide as descobertas de alta gravidade antes de escalá-las.
O SAST é obrigatório para compliance?
Frameworks como o SSDF do NIST pedem revisão ou análise de código, com as descobertas registradas e triadas, mas não exigem uma ferramenta específica. O SAST é uma forma comum de cumprir em escala a parte de análise de código.
O SAST basta sozinho?
Não. O SAST é uma camada. Um programa também precisa de SCA para as dependências, de testes em tempo de execução e de uma forma de provar quais descobertas são exploráveis antes que a equipe gaste tempo corrigindo-as.
Faça cada descoberta estática provar a si mesma
Leia cada linha com SAST e dedique o tempo da sua equipe apenas ao que pode ser provado.
Conheça o Plexicus Deep Code Analysis →
Quer uma primeira visão do seu próprio código? Execute a ferramenta SAST gratuita, uma análise estática do seu código-fonte no GitHub.