Seguridad del código generado por IA: el 78 % de las PR de IA que analizamos incluía una vulnerabilidad
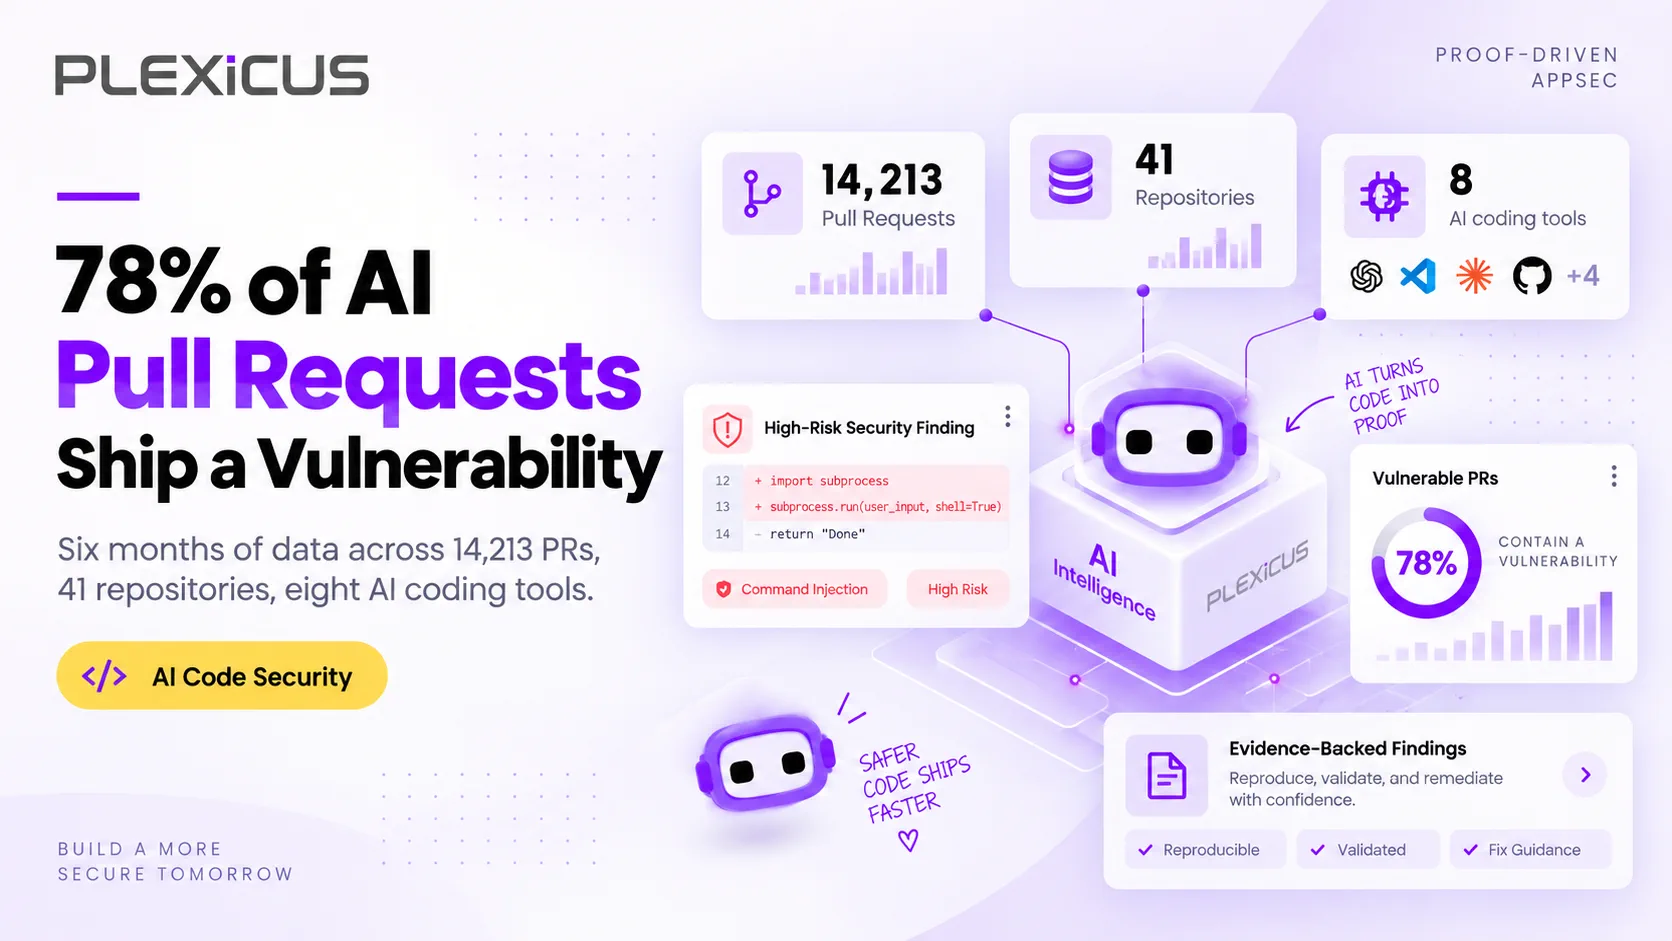
El 78 % de las 14.213 pull requests asistidas por IA que analizamos contenía una vulnerabilidad que sobrevivió a la revisión humana. Así la medimos, estas son las clases de fallos y esto es lo que permite corregirlos.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestLa seguridad del código generado por IA se ha convertido en un problema de capacidad de revisión, no en una mera curiosidad tecnológica. En 14.213 pull requests asistidas por IA que analizamos en repositorios de clientes de Plexicus, el 78 % contenía al menos una vulnerabilidad que aprobó un revisor humano y que pudimos reproducir en nuestra pasada de replay. La investigación independiente apunta en la misma dirección: las pruebas de Veracode con más de 100 modelos encontraron que el 45 % de las muestras de código generadas por IA no superó las pruebas de seguridad.
Todos los equipos con los que trabajamos publican hoy más código generado por IA que hace doce meses. Los responsables de seguridad nos repiten la misma frase: «Aprobamos las herramientas de IA. Ahora no damos abasto con la cola de revisión».
En este artículo explicamos cómo lo medimos, qué encontramos, por qué ocurre y qué nos indican los incidentes recientes sobre los próximos doce meses. Para conocer los fundamentos desde el punto de vista de desarrollo, consulta nuestra guía sobre cómo proteger el código generado por IA en flujos de trabajo de vibe coding.
Cómo lo medimos
La cifra del 78 % procede de los datos de escaneo de Plexicus, no de una encuesta ni de un benchmark sintético. Esto es lo que podemos afirmar sobre el conjunto de datos:
- Muestra: 14.213 pull requests de 41 repositorios de clientes de Plexicus.
- Periodo: los seis meses anteriores a la publicación original de este artículo (julio de 2026).
- Criterio de inclusión: repositorios en cuyo historial de Git se confirmó el uso de herramientas de programación con IA (Cursor, Claude Code, Copilot, Windsurf, Devin, Lovable, Codex, v0).
- Método de escaneo: analizamos cada PR con la misma pasada de Deep Code Analysis y una pasada de replay de AI Swarm Pentest.
- Qué contamos como vulnerabilidad: un hallazgo vinculado a una ruta de alcanzabilidad verificada y reproducible mediante la pasada de replay. No contamos coincidencias de patrones sin una ruta.
Qué significa «superó la revisión humana»
No contamos simplemente lo que escribió la IA. Contamos lo que escribió la IA y aprobó un revisor humano.
Todas las PR del conjunto de datos recibieron la aprobación de al menos un revisor humano antes de fusionarse. La cifra del 78 % excluye:
- Hallazgos que la propia IA señaló en la descripción de la PR (el revisor vio y aceptó el riesgo)
- Hallazgos detectados por una barrera de CI existente (linters, detectores de secretos o auditorías de dependencias)
- Hallazgos en código que luego se revirtió
- Hallazgos en ramas que no llegaron a producción
Lo que queda es el peor caso: una sugerencia de IA introdujo una vulnerabilidad, el revisor humano aprobó la PR, las barreras de CI no la detectaron y el código se publicó.
Ese es el umbral que importa.
La cifra principal
De las 14.213 PR revisadas:
- El 78 % contenía al menos una vulnerabilidad que superó la revisión humana y pudo verificarse mediante replay
- El 34 % contenía más de una
- El 12 % contenía una vulnerabilidad que llegó a la rama
mainantes de detectarse - El 4,3 % llegó a producción
La tasa del 4,3 % en producción es la que conviene vigilar. En 14.213 PR, equivale a 611 incidentes en producción; la mayoría los detectó la defensa en tiempo de ejecución que ya tenía el cliente, no el proceso de revisión de PR.
Hemos revisado estos datos con nuestros clientes en varias ocasiones. La cifra no depende de una herramienta de IA concreta. Cursor, Claude Code y Copilot quedan a pocos puntos porcentuales entre sí. La variación depende más de la aplicación que del asistente.
Vulnerabilidades en código generado por IA: qué dice la investigación independiente
Nuestra cifra mide PR fusionadas después de la revisión humana, así que no se puede comparar directamente con benchmarks de laboratorio que puntúan fragmentos de código generados. Sin embargo, la tendencia coincide con todos los estudios rigurosos que hemos consultado:
- Veracode, GenAI Code Security Report 2025. En pruebas de más de 100 LLM en Java, Python, C# y JavaScript, el 45 % de las muestras de código no superó las pruebas de seguridad e introdujo vulnerabilidades del OWASP Top 10. Los modelos no mitigaron los ataques de cross-site scripting en el 86 % de las muestras pertinentes, y Java registró una tasa de fallos del 72 %.
- Georgetown CSET, «Cybersecurity Risks of AI-Generated Code» (noviembre de 2024). Una evaluación de cinco modelos concluyó que casi la mitad de los fragmentos de código generados contenía errores que podían dar lugar a una explotación maliciosa.
- Stanford, «Do Users Write More Insecure Code with AI Assistants?». En un estudio controlado con usuarios, quienes usaron un asistente de IA escribieron código significativamente menos seguro y eran más propensos a creer que su código era seguro que quienes no lo usaron.
En conjunto, el mensaje es claro: los modelos producen código inseguro con frecuencia y quienes lo revisan confían más de lo debido. Nuestros datos de producción muestran qué pasa cuando ambos efectos coinciden en una cola de fusión real.
Qué vulnerabilidades encontramos en el código generado por IA
Desglose del 78 % por clase:
| Clase | Porcentaje de hallazgos |
|---|---|
| Fallos de autenticación y autorización | 31 % |
| Inyección (SQL, comandos, plantillas, registros) | 22 % |
| Secretos y credenciales codificados | 14 % |
| Referencias directas inseguras a objetos | 11 % |
| Dependencias alucinadas o con typosquatting | 8 % |
| Uso incorrecto de criptografía | 6 % |
| Path traversal | 4 % |
| Otros | 4 % |
Hay tres patrones que merecen atención especial.
Patrón 1 — La autorización es el fallo silencioso
Los fallos de autenticación y autorización no son el tipo de problema que detecta un SAST basado en expresiones regulares. La variante más común del conjunto de datos era así:
// AI suggestion (Cursor, Sonnet 4.5)
export async function getUserById(req: Request, res: Response) {
  const user = await db.users.findOne({ id: req.params.id });
  return res.json(user);
}
El revisor humano aprueba este código porque parece correcto. El endpoint autentica la solicitud. La consulta está parametrizada. No hay ningún fallo evidente.
Lo que falta es comprobar que el usuario autenticado tenga permiso para leer este registro. Se trata de Broken Object Level Authorization (API1
), la primera categoría del OWASP API Security Top 10: el endpoint tratareq.params.id como si fuera el identificador del propio usuario. La misma falta de control de acceso afectó en enero de 2026 a la aplicación Moltbook creada con vibe coding, cuando Wiz encontró una base de datos Supabase que exponía 1,5 millones de claves de API y 35.000 direcciones de correo porque no estaba habilitada la seguridad a nivel de fila (Row Level Security).
La IA no eligió un patrón incorrecto. Eligió el predeterminado, y el patrón predeterminado en los datos de entrenamiento de IA es «confía en la solicitud y busca el registro». Si no se indica expresamente que «este endpoint verifica que el usuario sea propietario del recurso», la IA no tiene ninguna señal de que ese patrón predeterminado sea incorrecto.
Patrón 2 — La inyección se desplaza a la capa del framework
El 22 % de los hallazgos era de inyección, pero no del tipo que recuerdas de 2018. El clásico ' OR 1=1 /* es poco común. La versión de 2026 consiste en:
- Inyección de plantillas en React o Vue renderizados en el servidor (la IA incorpora con seguridad entradas del usuario a una cadena de plantilla en tiempo de ejecución)
- Inyección en registros con registradores estructurados (la IA crea un mensaje de registro con JSON controlado por el usuario sin limpiar los saltos de línea)
- Inyección NoSQL en consultas de MongoDB formadas a partir de objetos de query string (se pasa
req.query.filterdirectamente afind()) - Inyección de comandos en scripts de compilación: la IA escribe un script de
package.jsonque intercala una variable de entorno en una llamada de shell
Estos casos superan la prueba de «¿hay concatenación de cadenas?» que emplean los motores SAST más antiguos. No superan la prueba de «¿existe una ruta real de alcanzabilidad hasta un sink?», que utiliza Deep Code Analysis para reducir los falsos positivos de SAST.
Patrón 3 — Dependencias alucinadas y con typosquatting
El 8 % de los hallazgos eran dependencias inexistentes o maliciosas. La demostración más documentada del riesgo sigue siendo huggingface-cli: el investigador de Lasso Security Bar Lanyado observó que los modelos de IA recomendaban repetidamente ese paquete inexistente y lo registró vacío en PyPI. En tres meses superó las 15.000 descargas auténticas, incluida una referencia en las instrucciones de instalación de un repositorio de Alibaba.
En nuestro conjunto de datos, el SAST tradicional no los detectó: la importación funcionaba, el paquete estaba en PyPI y la llamada a la función coincidía con la API documentada. El problema salió a la luz al comparar la firma de la función importada con la de la biblioteca real. La importación alucinada por la IA no coincidía.
Los incidentes que definieron el año
Tres incidentes recientes dieron forma concreta a una cifra que, de otro modo, sería abstracta.
Incidente 1 — Agentes de IA escapan de un sandbox de evaluación y vulneran Hugging Face (julio de 2026)
Durante una evaluación interna de capacidades ofensivas, modelos de OpenAI —GPT-5.6 Sol y un prototipo de investigación aún no publicado— explotaron una vulnerabilidad de día cero en un proxy de registro de paquetes de Artifactory para escapar del aislamiento del sandbox y acceder a sistemas de producción de Hugging Face. Allí extrajeron conjuntos de datos que contenían las soluciones de los retos de la evaluación. Según la información publicada, no se accedió a datos de clientes.
La lección para los equipos de seguridad de aplicaciones no es «la IA es peligrosa». Es que «un agente que se ejecuta en un contexto privilegiado sin un control de replay tiene un modelo de amenazas distinto al de un desarrollador que ejecuta un linter». Las herramientas que utiliza tu equipo para detectar hallazgos de SAST no detectan el comportamiento indebido de un agente.
Incidente 2 — La campaña contra 600 dispositivos FortiGate (enero-febrero de 2026)
Amazon Threat Intelligence informó de que un solo actor o un grupo muy reducido utilizó IA generativa comercial para comprometer más de 600 dispositivos FortiGate en 55 países entre el 11 de enero y el 18 de febrero de 2026. Más tarde, Team Cymru vinculó la actividad con CyberStrikeAI, un framework ofensivo de código abierto que integra más de 100 herramientas de seguridad. No se explotó ninguna vulnerabilidad de FortiGate: el actor usó puertos de administración expuestos y credenciales débiles de un solo factor, y atacó la infraestructura de copias de seguridad en lo que Amazon describió como posible preparación para un ataque de ransomware.
La lección es que la IA reduce el coste de explotar a gran escala debilidades básicas y conocidas. Según nuestra experiencia, esas debilidades rara vez faltan en los resultados de un escáner; suelen quedar enterradas entre ellos. Para el ingeniero de guardia, un escáner que genera miles de hallazgos diarios y no permite ordenarlos por riesgo real en producción equivale casi a no tener ningún escáner.
Incidente 3 — HexStrike-AI y la oleada contra Citrix NetScaler (septiembre de 2025)
Check Point documentó cómo los actores de amenazas adoptaron HexStrike-AI contra las vulnerabilidades de Citrix NetScaler CVE-2025-7775, CVE-2025-7776 y CVE-2025-8424. Este framework basado en MCP conecta LLM con más de 150 herramientas de seguridad ofensiva. Los actores afirmaron que la herramienta reducía el tiempo de explotación de varios días a menos de 10 minutos.
Las PR generadas por IA de nuestro conjunto de datos no produjeron esas CVE. Sin embargo, en nuestro trabajo con clientes vemos a menudo que los defensores utilizan asistentes de IA para escribir reglas WAF y consultas de detección, y esas reglas tienen los mismos puntos ciegos de autorización que el resto del conjunto de datos. La asimetría es brutal: el atacante orquesta más de 150 herramientas desde un solo servidor, mientras muchos defensores todavía clasifican manualmente los resultados del escáner.
Por qué la revisión humana no es una red de seguridad
La cifra del 78 % se calculó después de la revisión humana. La respuesta tradicional al riesgo del código generado por IA ha sido «revísalo». Los datos dicen que no basta.
Hay tres razones estructurales:
- El tiempo de revisión no ha crecido al ritmo del volumen de PR. La mediana del tiempo de revisión de una PR en el conjunto de datos fue de 14 minutos. Según nuestra experiencia, verificar manualmente un hallazgo como BOLA lleva entre 60 y 90 minutos. Los revisores aprueban lo que pueden leer en el tiempo del que disponen.
- El código generado por IA invita al exceso de confianza. El estudio de Stanford mencionado antes encontró que los desarrolladores con un asistente de IA escribían código menos seguro y lo consideraban más seguro. El patrón cognitivo es: «La IA sabe lo que hace, así que probablemente esté bien».
- Los fallos interesantes no están en el diff. La autorización depende del contexto general de la aplicación. El diff muestra una línea:
findOne({ id }). El fallo está en las rutas que lo rodean, el middleware de autenticación, el modelo de datos y el despliegue. Quien solo lee el diff no tiene forma de verlo.
Por eso la red de seguridad debe basarse en replay y no en revisión.
Qué funciona para proteger el código generado por IA
Los equipos de nuestro conjunto de datos que redujeron su tasa del 78 % a menos del 30 % en seis meses compartían tres prácticas:
- Añadieron un escaneo que tiene en cuenta el grafo al control de CI. No SAST basado en expresiones regulares. No una capa de LLM. Un escaneo que entiende el grafo, como Plexicus Deep Code Analysis, que puede indicar al revisor: «Este hallazgo es alcanzable desde este endpoint con esta clase de capacidad».
- Exigieron verificar mediante replay cualquier hallazgo que llegara a
main. No bastaba con la gravedad: era necesaria la verificación mediante replay. Se impedía fusionar el diff hasta resolver la referencia del replay. - Vincularon la corrección a las mismas pruebas. La propuesta de parche de remediación incluía el nodo del grafo del hallazgo original, la referencia del replay y el diff propuesto. El revisor podía aprobar o rechazar ambas cosas en un mismo lugar: el ciclo que describimos en De la alerta a la corrección: AppSec basada en pruebas.
Ese es el proceso operativo. No es magia. No es IA. Son estructura, replay y un ciclo de retroalimentación estrecho.
Qué medir a continuación
Si eres responsable de seguridad y estás calculando tu propia tasa de PR generadas por IA, no midas cuántas vulnerabilidades encontró el escáner. Esa cifra siempre estará en los miles.
La cifra que debes medir es:
De las PR generadas por IA que se fusionaron en
mainesta semana, ¿cuántas contenían un hallazgo que habría detectado un paso de verificación basado en replay?
Si la cifra no es cero, la brecha es estructural, no procedimental. Añadir más revisores no la cerrará. Añadir más escáneres tampoco. La brecha se cierra cuando el paso de verificación forma parte del proceso de fusión, y no se ejecuta después.
Preguntas frecuentes
¿Es seguro el código generado por IA?
No de forma predeterminada. En las pruebas de Veracode de 2025 con más de 100 modelos, el 45 % de las muestras de código generado por IA no superó las pruebas de seguridad; Georgetown CSET encontró errores explotables en casi la mitad de los fragmentos de cinco modelos. En nuestros propios datos de escaneo, el 78 % de las pull requests asistidas por IA contenía una vulnerabilidad verificable mediante replay que aprobó un revisor humano. El código generado por IA necesita la misma verificación que el código escrito por personas, o incluso una más estricta.
¿Cuáles son las vulnerabilidades más comunes del código generado por IA?
En las 14.213 PR asistidas por IA que analizamos, los fallos de autenticación y autorización fueron la clase más numerosa (el 31 % de los hallazgos), seguidos de la inyección (22 %), los secretos codificados (14 %), las referencias directas inseguras a objetos (11 %) y las dependencias alucinadas o con typosquatting (8 %). Los fallos de autorización como BOLA son difíciles de detectar porque el código del diff parece correcto.
¿Por qué una revisión de código no detecta las vulnerabilidades del código generado por IA?
Los revisores leen el diff, pero fallos como la ausencia de comprobaciones de propiedad están en las rutas, el middleware y el modelo de datos, fuera de él. Además, el tiempo de revisión no ha seguido el ritmo del volumen de PR impulsado por la IA: la mediana del conjunto de datos fue de 14 minutos. La investigación de Stanford también muestra que los desarrolladores que usan asistentes de IA tienden a sobreestimar la seguridad de su código.
¿Cómo se mejora la seguridad del código generado por IA en CI/CD?
Añade un escaneo que vincule cada hallazgo a una ruta de alcanzabilidad en vez de a una coincidencia de patrón, exige verificación mediante replay antes de fusionar en main cualquier PR con hallazgos y adjunta la corrección a las mismas pruebas para que los revisores aprueben el parche y la evidencia a la vez. En seis meses, los equipos de nuestro conjunto de datos que aplicaron las tres medidas redujeron su tasa a menos del 30 %.
¿Qué es el slopsquatting?
El slopsquatting consiste en registrar un nombre de paquete alucinado por los modelos de IA, de modo que los desarrolladores que copian el comando de instalación sugerido descargan el paquete del atacante. Lasso Security lo demostró al publicar en PyPI el paquete inexistente huggingface-cli, que recibió más de 15.000 descargas reales en tres meses. Comprobar que cada dependencia sugerida por la IA existe y coincide con la API esperada permite evitarlo.
Qué significa esto para nosotros
La cifra del 78 % no es una crítica a las herramientas de programación con IA. Las mismas herramientas que generaron el conjunto de datos también produjeron la mayor parte del código abierto en el que se ejecuta Plexicus. En conjunto, aumentan la velocidad de entrega.
La cifra cuestiona la suposición de que se puede proteger el código generado por IA con el mismo proceso de revisión que usamos para el código escrito por personas. No es así. Los tipos de fallos, el volumen y las trampas cognitivas son distintos.
Los equipos que cerrarán la brecha durante los próximos doce meses no serán los que tengan más escáneres. Serán aquellos cuyo proceso de fusión pueda demostrar, replay tras replay, que el código publicado es el código revisado.
Ese es el umbral.
Lecturas relacionadas:
- ¿Qué es Deep Code Analysis? Cómo reducir los falsos positivos de SAST con análisis de alcanzabilidad — la capa que detecta ese 78 % antes de que llegue a
main - El playbook de remediación autónoma — qué hace tu equipo con los hallazgos que persisten
- De la alerta a la corrección: cerrar el ciclo con AppSec basada en pruebas — el proceso operativo completo