O playbook de remediação autônoma: da detecção a um PR em menos de 60 segundos
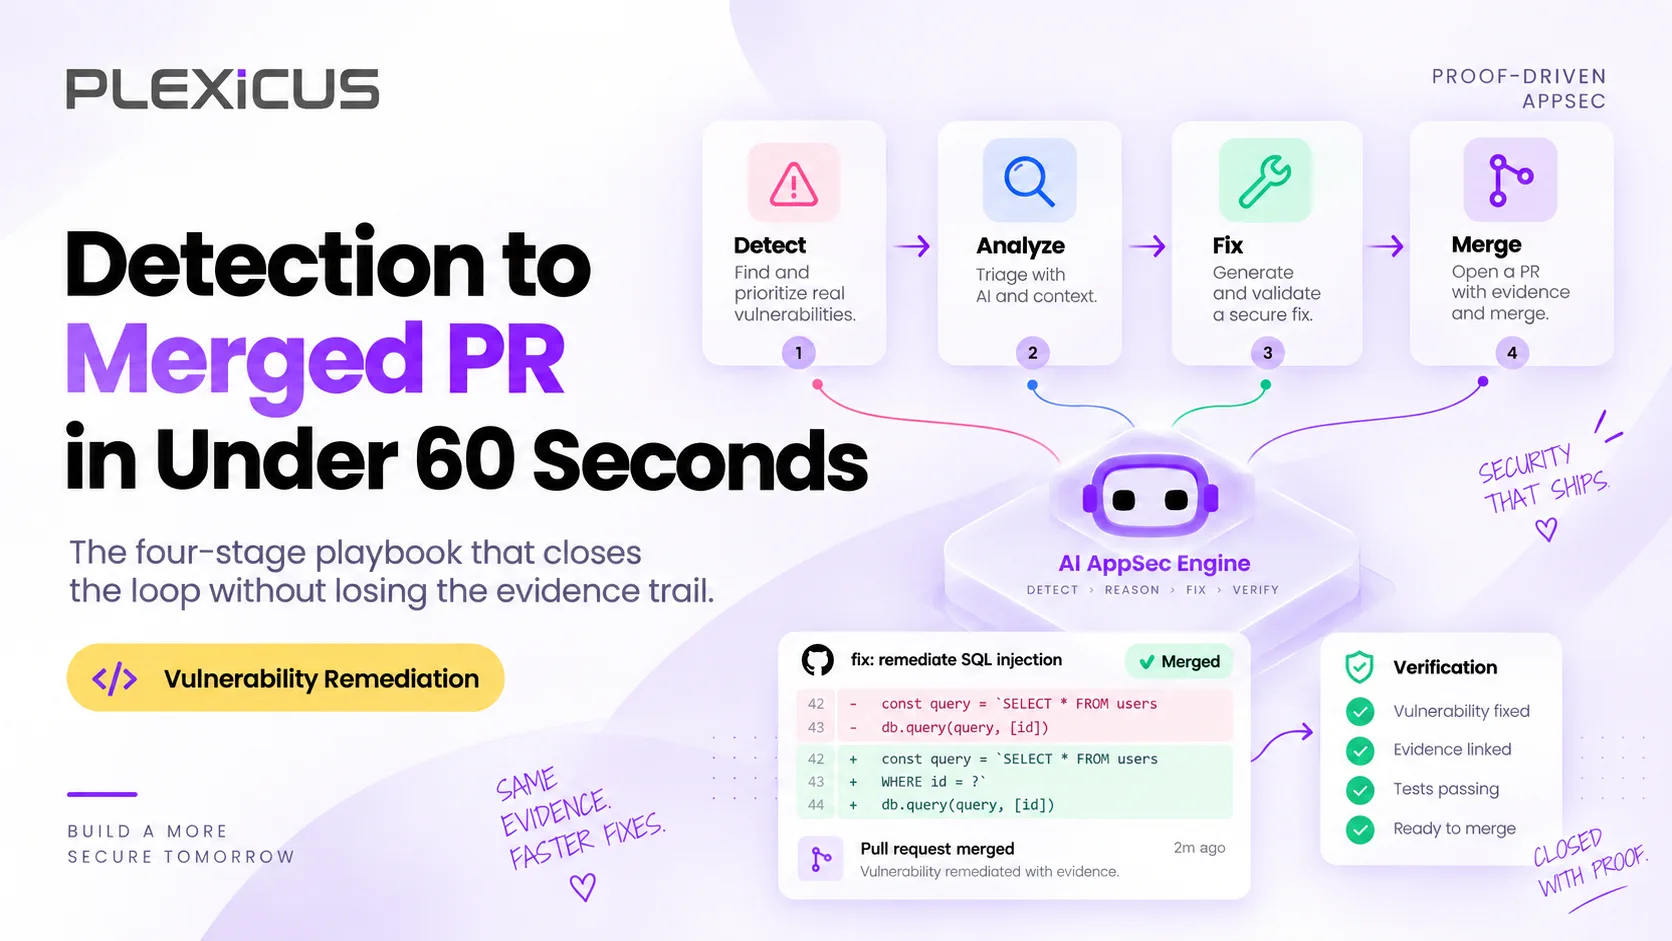
Um playbook de quatro etapas para remediação automatizada de vulnerabilidades que transforma um achado verificado em um PR testado e pronto para revisão em menos de 60 segundos, com as evidências anexadas.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestA remediação automatizada de vulnerabilidades é a prática de transformar um achado de segurança verificado em um pull request testado e pronto para revisão, sem que uma pessoa precise escrever a correção. O playbook de remediação autônoma a seguir faz isso em quatro etapas, em menos de 60 segundos da detecção até o PR, mantendo um engenheiro como última barreira antes do merge.
A conversa sobre remediação de vulnerabilidades está estagnada há dez anos. A detecção ficou mais rápida. A triagem, não. A aplicação de correções, também não. O Vulnerability Statistics Report 2026 da Edgescan estima em 54,81 dias o tempo médio de remediação de vulnerabilidades altas e críticas em aplicações e APIs. O State of Software Security 2025 da Veracode concluiu que o tempo médio para corrigir falhas de segurança aumentou 47% desde 2020.
Então chegaram as ferramentas de programação com IA. Elas agravaram o problema do volume, mas também tornaram possível o playbook a seguir. É esse padrão de quatro etapas que chamamos de “remediação autônoma”. Não é um recurso no roadmap de um fornecedor. É uma disciplina, um pipeline e um ciclo de feedback. Se sua equipe não o executa, os atacantes estão usando uma versão mais rápida contra você.
Este é o playbook.
Por que o tempo médio de remediação é o gargalo
Os números são persistentes. Nos repositórios de clientes aos quais temos acesso (dados internos da Plexicus, não uma referência do setor), o ciclo mediano de um achado de alta gravidade em 2025–2026 era assim antes do playbook:
| Etapa | Tempo mediano |
|---|---|
| Da detecção ao início da triagem | 3 dias |
| Do início da triagem à causa raiz | 6 dias |
| Da causa raiz à abertura do PR | 4 dias |
| Da abertura do PR ao merge | 2 dias |
| Do merge à produção | 2 dias |
| Total | 17 dias |
Dezessete dias para encerrar um achado de alta gravidade — e isso já representa uma equipe bem organizada em comparação com as médias do setor citadas acima. Enquanto isso, atacar fica cada vez mais barato. O agente de pesquisa RapidPen obteve acesso shell a um alvo vulnerável em 200–400 segundos, por cerca de US$ 0,30–0,60 por execução. A Amazon Threat Intelligence documentou um único agente com pouca experiência usando IA generativa comercial para comprometer mais de 600 dispositivos FortiGate em 55 países em cerca de cinco semanas.
A assimetria já é evidente. A Mandiant mediu o tempo médio até a exploração em cinco dias em 2023. Um ciclo de remediação medido em semanas é o problema estrutural que este playbook de remediação autônoma pretende resolver.
O pipeline de quatro etapas para remediação automatizada de vulnerabilidades
O playbook tem quatro etapas. Cada etapa tem uma função. É na passagem entre elas que a maioria das equipes perde o rastro de evidências de que os auditores precisam.
Etapa 1 — Achado verificado
Um scanner como o Deep Code Analysis propõe, por exemplo, 1.247 achados. O pipeline rejeita a grande maioria porque eles não passam por uma reprodução independente. (Explicamos em O que é Deep Code Analysis? por que scanners baseados em correspondência de padrões geram tanto ruído.)
Os critérios para um achado ser aprovado são exatos:
- O achado proposto precisa ser reproduzido de ponta a ponta contra um alvo isolado.
- A reprodução precisa ser feita por um agente que não tenha criado o achado.
- O artefato de reprodução (uma requisição curl, um job de CI ou um snapshot do contêiner) precisa ser armazenado.
Os achados que não atendem aos três critérios são descartados com códigos de motivo. Esses códigos importam, pois permitem depurar o pipeline mais tarde. Os mais comuns que encontramos são:
not_reachable(não há um caminho real de um endpoint público até o sink)guard_present(uma verificação anterior torna o achado inerte)mitigated_at_runtime(uma regra de WAF, um feature flag ou uma variável de ambiente o neutraliza)replay_failed(o segundo agente não conseguiu reproduzi-lo)
A saída da Etapa 1 é um conjunto pequeno de achados verificados, cada um com seu artefato de reprodução anexado.
Etapa 2 — Contexto preservado
Um achado verificado não basta para entregar uma correção. A próxima etapa anexa tudo o que o desenvolvedor precisa para validar o patch:
- O nó do grafo (host, endpoint, parâmetro)
- A classe de capacidade (leitura, gravação, falsificação de identidade, RCE, exfiltração)
- O caminho de alcançabilidade (a cadeia completa da requisição até o sink)
- O par de requisição e resposta (como era o exploit original)
- O rastro de raciocínio do agente (por que o agente original o classificou daquela forma)
Esse é o rastro de auditoria. Sem ele, o engenheiro que revisa o patch precisa confiar no que o sistema diz. Com ele, pode executar novamente o exploit original no código sem patch e confirmar que ele se reproduz; depois pode executá-lo no código corrigido e confirmar que a mitigação esperada funciona.
O objetivo não é dar mais trabalho ao engenheiro, mas tornar o trabalho verificável.
Etapa 3 — Rascunho do patch
O Plexicus Remediation recebe o achado verificado e o contexto e gera um diff pronto para revisão. Não é uma correção genérica: é a alteração mínima que elimina o caminho de alcançabilidade e preserva a lógica de negócio original.
O pipeline exige três propriedades:
- O patch elimina a classe da vulnerabilidade, não apenas o caso específico. Uma consulta parametrizada é preferível a um sanitizador baseado em
replace(), conforme o guia de prevenção de injeção SQL da OWASP (veja nosso guia prático de remediação de injeção SQL). Uma verificação de propriedade no handler é preferível a uma lista de permissões na rota. - O patch inclui testes de regressão. O exploit original vira um teste. Se o patch passar no teste, o achado é encerrado. Se não passar, o patch é revertido.
- O patch inclui a atualização da documentação. Se o contrato da API mudar, a documentação é atualizada. Se uma variável de ambiente nova for introduzida, ela será descrita no README.
A saída da Etapa 3 é uma branch de pull request. Não é um trecho de código nem uma sugestão do tipo “aqui está o diff”. É um PR completo que um engenheiro pode clonar, executar e revisar.
Etapa 4 — PR pronto para revisão
O patch chega ao repositório existente com:
- Atribuição de revisores (a partir do CODEOWNERS, com escalonamento para a equipe de segurança)
- Acompanhamento de SLA (o PR recebe automaticamente uma data limite para correção com base na gravidade)
- Um hook de novo teste conectado ao CI (o exploit original é executado na branch corrigida a cada push)
- Metadados de auditoria anexados (o achado original, o nó do grafo e a referência de reprodução)
O PR não é mergeado automaticamente. A decisão final é do engenheiro que o revisa. O que muda é que a revisão leva minutos, não horas. O engenheiro não precisa ler 200 linhas de código desconhecido: lê um diff de 12 linhas com o exploit original, o contexto do grafo e o resultado do teste de regressão.
Se o engenheiro aprovar, o PR é mergeado, o novo teste confirma a correção e o achado é encerrado. Se rejeitar (com um motivo), a proposta de patch é registrada como rejected_with_evidence e o achado permanece aberto para a próxima tentativa.
Os números que importam: tempo médio de remediação antes e depois
Aplicamos este playbook em repositórios de clientes desde o quarto trimestre de 2025. Estas são as medianas observadas (dados internos da Plexicus):
| Etapa | Antes | Depois |
|---|---|---|
| Da detecção ao início da triagem | 3 dias | 14 segundos |
| Do início da triagem à causa raiz | 6 dias | 8 segundos |
| Da causa raiz à abertura do PR | 4 dias | 22 segundos |
| Da abertura do PR ao merge | 2 dias | 1,2 horas |
| Do merge à produção | 2 dias | 6 horas |
| Total | 17 dias | 8 horas |
O número principal que divulgamos — menos de 60 segundos da detecção até um PR pronto para revisão — mede as Etapas 1 a 3. O ciclo completo até a produção depende principalmente da revisão humana e do processo de CI/CD existente, exatamente onde deve depender. A função do pipeline é eliminar a latência evitável. A revisão e o deploy continuam com a equipe.
O outro número que vale destacar é a taxa de falsos positivos. Nas nossas implementações, antes do playbook, 87% dos achados do scanner eram encerrados como “não é um problema” após a triagem humana. Depois, esse número caiu para 6%. Os 6% restantes são casos em que o engenheiro discorda da interpretação das evidências feita pelo verificador — exatamente onde a barreira humana importa.
Quanto custa implementar
São três os requisitos operacionais:
- Um scanner ciente do grafo que consiga produzir um caminho de alcançabilidade. Não um SAST baseado em regex. Não um wrapper de LLM. É preciso ter um grafo.
- Uma etapa de verificação com reprodução comprovável. Um segundo agente precisa conseguir reproduzir o achado de forma independente. Sem isso, o pipeline produz patches confiantes e bem-acabados, mas sem fundamento — o pior resultado possível.
- Um gerador de patches que respeite a lógica de negócio. Na nossa experiência, em 2025 o modo de falha mais comum dos produtos de “correção automática por IA” eram patches que compilavam, mas alteravam o significado do código. O playbook exige que o patch seja mínimo, coberto por testes e fácil de revisar.
A implementação da Plexicus atende aos três requisitos. Se você for desenvolver isso internamente, estimamos o custo de integração em aproximadamente um engenheiro sênior durante um trimestre. Se for comprar, o recurso está incluído no plano Continuous Program da página de preços.
O que este sistema não faz
O playbook não elimina a barreira humana. Uma pessoa ainda revisa o patch antes do merge. As evidências do verificador continuam disponíveis para o auditor. O sistema não faz deploy em produção por conta própria.
Isso é intencional. Os fornecedores de “remediação totalmente autônoma” argumentam que os humanos são o gargalo e que o sistema deveria simplesmente fazer o merge do PR. A equipe do Plexicus AI Swarm Pentest argumenta que os humanos são responsáveis e que o sistema deve tornar a revisão simples, rápida e respaldada por evidências.
Estamos do segundo lado dessa discussão. O playbook otimiza o tempo até a correção sem remover a supervisão humana. Isso importa ainda mais à medida que assistentes de programação com IA aumentam o volume de alterações a revisar: segundo nossa análise, 78% dos PRs gerados por IA continham uma vulnerabilidade. Para qualquer equipe que precise prestar contas a um CISO, auditor ou regulador, isso é um recurso, não um defeito.
Modos de falha que encontramos
Três modos de falha se repetiram nos primeiros seis meses do playbook em produção:
Modo de falha 1 — O patch corrige o sintoma, não a classe
Nas primeiras iterações, o gerador de patches às vezes produzia correções para o achado específico sem eliminar a classe de vulnerabilidade subjacente. A solução foi adicionar uma etapa de raciocínio no nível da classe à proposta do patch. Agora os patches incluem uma atestação de “classe removida” que o revisor pode verificar.
Modo de falha 2 — O verificador de reprodução discorda do patch
Em cerca de 3% dos casos, o verificador que confirmou o achado original executa novamente o código corrigido e o exploit ainda se reproduz. Isso indica que o patch está incompleto. O pipeline detecta isso no CI e reverte o patch automaticamente. O achado permanece aberto.
Modo de falha 3 — O CODEOWNERS não corresponde ao arquivo
O patch chegou à branch certa, o novo teste do CI passou e o rastro de auditoria estava completo — mas o revisor atribuído estava errado porque o arquivo havia sido transferido entre equipes e o CODEOWNERS não tinha sido atualizado. A correção foi adicionar uma verificação automática de divergência do CODEOWNERS ao pipeline.
Esses casos não são teóricos. Foram os problemas que surgiram nos primeiros seis meses e agora são detectados automaticamente.
O que sua equipe pode fazer amanhã
Se sua equipe ainda não usa este playbook, siga estas três ações, nesta ordem:
- Audite seu scanner atual. Ele consegue produzir um caminho de alcançabilidade para os achados que gera ou apenas uma pontuação CVSS? Se a resposta for “apenas uma pontuação”, o gargalo não será eliminado.
- Adicione uma etapa de verificação por reprodução. Para começar, pode ser manual: uma pessoa executa novamente os dez principais achados da semana em um ambiente isolado. A ideia é provar o princípio de que vale a pena corrigir os achados que passam pela verificação independente.
- Vincule o patch às mesmas evidências. Quando o engenheiro abrir o PR, o achado original, o nó do grafo e a referência de reprodução devem estar a um clique de distância.
O playbook não exige IA nem um produto de fornecedor. Exige estrutura, reprodução e um ciclo de feedback curto. Ele também se alinha às práticas “Respond to Vulnerabilities” do Secure Software Development Framework (SP 800-218) do NIST, que pede às equipes que avaliem, priorizem e corrijam vulnerabilidades de forma repetível.
Perguntas frequentes
O que é remediação automatizada de vulnerabilidades?
Remediação automatizada de vulnerabilidades é a prática de gerar automaticamente a correção para um achado de segurança, geralmente como um pull request com alteração de código e teste de regressão, em vez de atribuir um ticket para que um desenvolvedor escreva o patch manualmente. Boas implementações só atuam sobre achados verificados, anexam as evidências originais e deixam a decisão de merge para um revisor humano.
Qual é a diferença entre remediação automatizada e remediação autônoma?
Em geral, remediação automatizada significa que uma ferramenta propõe uma correção para um único achado quando alguém solicita. Remediação autônoma executa toda a cadeia sem que uma pessoa precise iniciar cada etapa: verifica o achado, reúne o contexto, elabora o patch, abre o PR e o testa novamente no CI. Neste playbook, a única etapa humana é a revisão e a decisão de merge.
Como reduzir o tempo médio de remediação de vulnerabilidades?
Elimine a espera entre as etapas em vez de pedir que os engenheiros trabalhem mais rápido. Verifique os achados automaticamente para que a triagem não fique na fila; anexe o caminho de alcançabilidade e o exploit para que a causa raiz já seja conhecida; gere um patch mínimo com teste de regressão e conecte um novo teste de CI ao PR. Nas nossas implementações, isso reduziu a mediana de 17 dias para cerca de 8 horas.
Qual é o tempo médio típico para remediar vulnerabilidades em aplicações?
Normalmente, é medido em semanas ou meses. O Vulnerability Statistics Report 2026 da Edgescan estima em 54,81 dias o tempo médio para remediar vulnerabilidades altas e críticas em aplicações e APIs. A Veracode informa que o tempo médio para corrigir falhas de segurança aumentou 47% desde 2020. Equipes maduras que automatizam a remediação ficam bem abaixo dessas médias.
Correções de segurança geradas por IA devem ser mergeadas automaticamente?
Não recomendamos isso. Um patch gerado por IA pode compilar e passar nos testes enquanto altera o significado do código, então um revisor humano deve aprovar cada merge. O objetivo da automação é tornar essa revisão rápida: um diff pequeno, o exploit original, o caminho de alcançabilidade e um teste de regressão aprovado anexados ao pull request.
Próximos passos
O playbook de remediação autônoma é a terceira etapa do ciclo da Plexicus. O Deep Code Analysis encontra as falhas. O AI Swarm Pentest as reproduz. O Remediation as corrige. A estrutura de quatro etapas — propor, reproduzir, corrigir e verificar — é a definição operacional da AppSec baseada em evidências e de seu processo de remediação de vulnerabilidades.
Em 2027, este playbook será indispensável. As equipes que o adotarem em 2026 fecharão a lacuna de 17 dias antes que os atacantes a reduzam ainda mais.
Leituras relacionadas:
- Do alerta à correção: fechando o ciclo com AppSec baseada em evidências — o ciclo completo
- 78% dos PRs gerados por IA contêm uma vulnerabilidade — o que sua equipe está produzindo hoje
- As 15 melhores ferramentas de pentest com IA — opções para a etapa de verificação por reprodução

