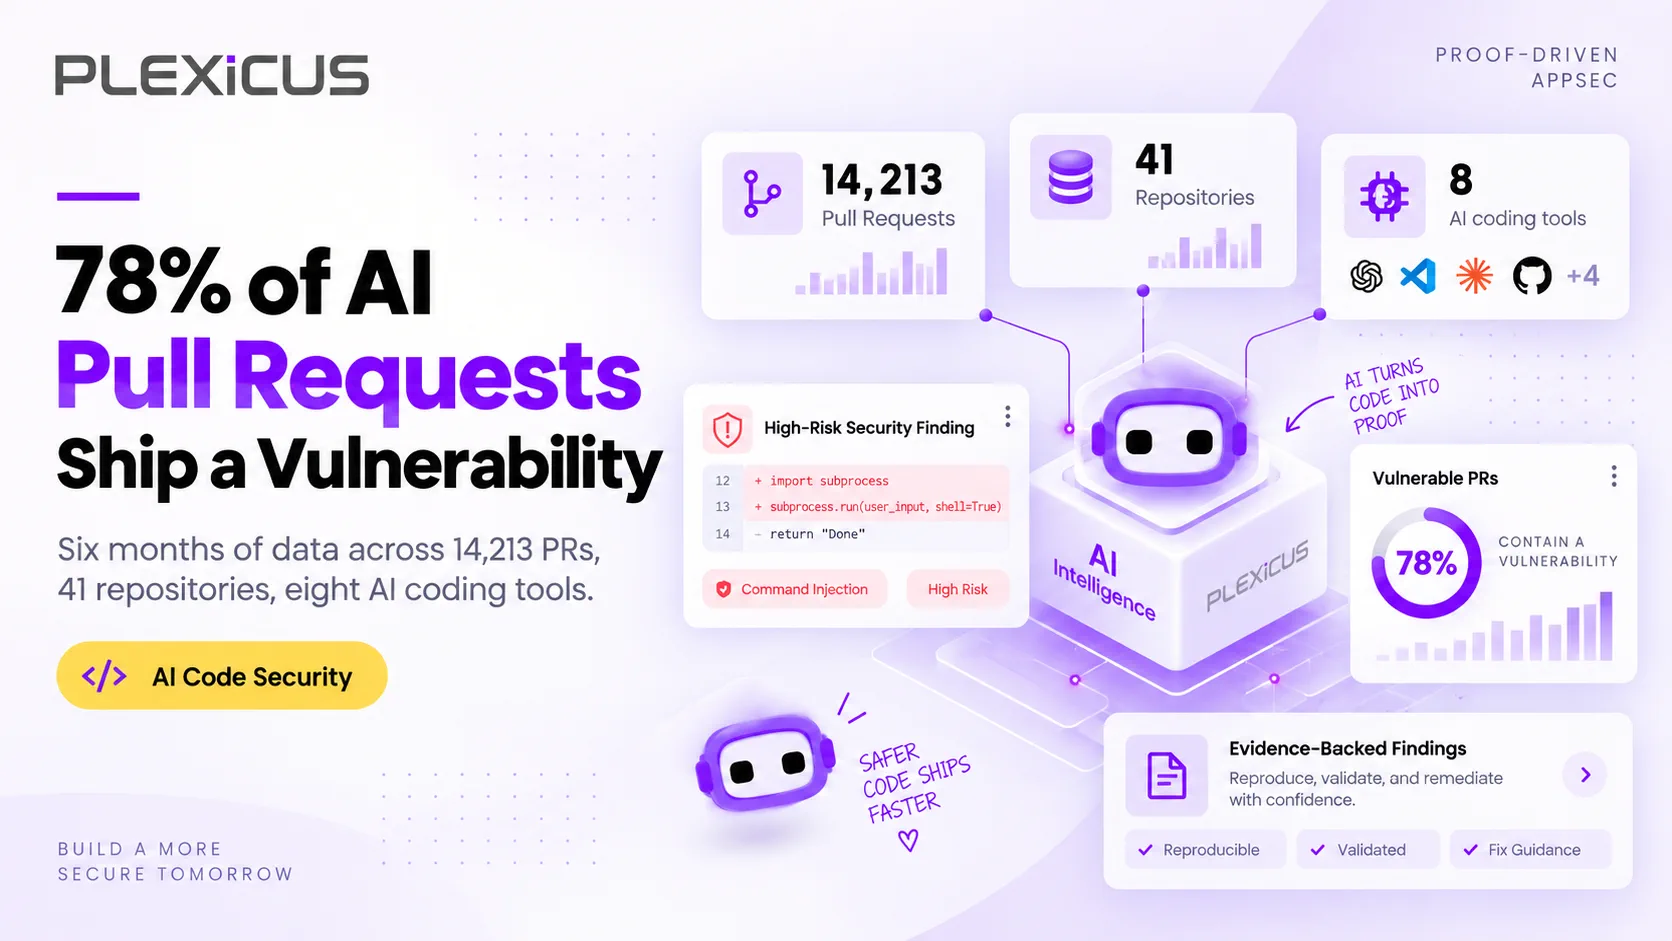
Segurança de código gerado por IA: 78% das PRs de IA que analisamos continham uma vulnerabilidade
78% das 14.213 pull requests assistidas por IA que analisamos continham uma vulnerabilidade que passou pela revisão humana. Veja como medimos esse índice, quais classes de falha encontramos e o que ajuda a corrigi-las.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestA segurança de código gerado por IA se tornou um problema de capacidade de revisão, e não apenas uma curiosidade sobre ferramentas. Em 14.213 pull requests assistidas por IA que analisamos em repositórios de clientes da Plexicus, 78% continham pelo menos uma vulnerabilidade aprovada por um revisor humano e que conseguimos reproduzir em nossa etapa de replay. Pesquisas independentes apontam na mesma direção: os testes da Veracode com mais de 100 modelos descobriram que 45% das amostras de código geradas por IA falharam nos testes de segurança.
Todas as equipes com as quais trabalhamos entregam hoje mais código gerado por IA do que entregavam há doze meses. A frase que mais ouvimos dos líderes de segurança é sempre a mesma: “Aprovamos as ferramentas de IA. Agora não conseguimos acompanhar a fila de revisão.”
Este artigo explica como fizemos a medição, o que encontramos, por que isso acontece e o que os incidentes recentes indicam para os próximos doze meses. Para conhecer o básico do ponto de vista de desenvolvimento, veja nosso guia sobre como proteger código gerado por IA em fluxos de vibe coding.
Como fizemos a medição
O índice de 78% vem de dados de varredura da Plexicus, e não de uma pesquisa ou benchmark sintético. Estes são os dados que podemos afirmar sobre o conjunto analisado:
- Amostra: 14.213 pull requests em 41 repositórios de clientes da Plexicus.
- Período: os seis meses anteriores à publicação original deste artigo (julho de 2026).
- Inclusão: repositórios cujo histórico do Git confirmou o uso de ferramentas de programação com IA (Cursor, Claude Code, Copilot, Windsurf, Devin, Lovable, Codex, v0).
- Método de varredura: cada PR foi analisada com a mesma etapa do Deep Code Analysis e uma etapa de replay do AI Swarm Pentest.
- O que contou como vulnerabilidade: uma descoberta vinculada a um caminho de alcançabilidade verificado e reproduzível pela etapa de replay. Correspondências de padrão sem um caminho não foram contabilizadas.
O que significa “passou pela revisão humana”
Não contamos apenas o que a IA escreveu. Contamos o que a IA escreveu e que um revisor humano aprovou.
Todas as PRs do conjunto de dados tiveram a aprovação de pelo menos um revisor humano antes do merge. O índice de 78% exclui:
- Descobertas que a própria IA apontou na descrição da PR (o revisor viu e aceitou o risco)
- Descobertas identificadas por um controle de CI existente (linters, detectores de segredos, auditorias de dependências)
- Descobertas em código que foi revertido posteriormente
- Descobertas em branches que não chegaram à produção
O que resta é o pior cenário: uma sugestão da IA introduziu uma vulnerabilidade, o revisor humano aprovou a PR, os controles de CI não a detectaram e o código foi entregue.
Esse é o critério que importa.
O número principal
Das 14.213 PRs revisadas:
- 78% continham pelo menos uma vulnerabilidade que passou pela revisão humana e podia ser verificada por replay
- 34% continham mais de uma
- 12% continham uma vulnerabilidade que chegou à branch
mainantes de ser detectada - 4,3% chegaram à produção
A taxa de 4,3% em produção é a que merece atenção. Em 14.213 PRs, isso representa 611 incidentes em produção — a maioria detectada pela defesa em tempo de execução que o cliente já tinha, e não pelo processo de revisão das PRs.
Já analisamos os dados com nossos clientes várias vezes. O número não depende de uma ferramenta específica de IA. Cursor, Claude Code e Copilot ficam a poucos pontos percentuais uns dos outros. A variação depende mais da aplicação do que do assistente.
Vulnerabilidades em código gerado por IA: o que mostram pesquisas independentes
Nosso número mede PRs integradas após a revisão humana, portanto não é diretamente comparável a benchmarks de laboratório que avaliam trechos de código gerados. Ainda assim, a tendência é consistente com todos os estudos sérios que consultamos:
- Veracode, GenAI Code Security Report 2025. Em testes com mais de 100 LLMs em Java, Python, C# e JavaScript, 45% das amostras de código falharam nos testes de segurança e introduziram vulnerabilidades do OWASP Top 10. Em 86% das amostras relevantes, os modelos não conseguiram se defender contra cross-site scripting; Java teve uma taxa de falha de 72%.
- Georgetown CSET, “Cybersecurity Risks of AI-Generated Code” (novembro de 2024). Uma avaliação de cinco modelos descobriu que quase metade dos trechos de código gerados continha bugs que poderiam levar à exploração maliciosa.
- Stanford, “Do Users Write More Insecure Code with AI Assistants?”. Em um estudo controlado com usuários, participantes com um assistente de IA escreveram código significativamente menos seguro e tinham mais probabilidade de acreditar que o código era seguro do que aqueles sem assistente.
Em conjunto: os modelos produzem código inseguro com frequência, e as pessoas que o revisam ficam mais confiantes do que deveriam. Nossos dados de produção mostram o que acontece quando esses dois efeitos se encontram em uma fila real de merge.
As vulnerabilidades de código gerado por IA que encontramos
Distribuição dos 78% por classe:
| Classe | Parcela das descobertas |
|---|---|
| Falhas de autenticação e autorização | 31% |
| Injeção (SQL, comando, template, log) | 22% |
| Segredos e credenciais codificados | 14% |
| Referências diretas inseguras a objetos | 11% |
| Dependências alucinadas ou com typosquatting | 8% |
| Uso incorreto de criptografia | 6% |
| Path traversal | 4% |
| Outros | 4% |
Três padrões merecem destaque.
Padrão 1 — A autorização é a falha silenciosa
Falhas de autenticação e autorização não são o tipo de problema que um SAST baseado em regex detecta. A variante mais comum no conjunto de dados era assim:
// AI suggestion (Cursor, Sonnet 4.5)
export async function getUserById(req: Request, res: Response) {
  const user = await db.users.findOne({ id: req.params.id });
  return res.json(user);
}
O revisor humano aprova esse código porque ele parece correto. O endpoint autentica a solicitação. A consulta é parametrizada. Não há nenhuma falha óbvia.
O que falta: verificar se o usuário autenticado tem permissão para ler este registro. Isso é Broken Object Level Authorization (API1
), a primeira categoria do OWASP API Security Top 10: o endpoint tratareq.params.id como se fosse o ID do próprio solicitante. A mesma falha de controle de acesso atingiu o aplicativo Moltbook criado com vibe coding em janeiro de 2026, quando a Wiz encontrou um banco de dados Supabase expondo 1,5 milhão de chaves de API e 35 mil endereços de e-mail porque o Row Level Security não estava habilitado.
A IA não escolheu um padrão incorreto. Ela escolheu o comportamento padrão — e, nos dados de treinamento da IA, o padrão é “confie na solicitação e busque o registro”. Sem uma restrição explícita (“este endpoint verifica se o usuário é dono do recurso”), a IA não tem nenhum sinal de que esse comportamento está errado.
Padrão 2 — A injeção se desloca para a camada do framework
Vinte e dois por cento das descobertas eram de injeção, mas não do tipo que você lembra de 2018. O clássico ' OR 1=1 /* é raro. A versão de 2026 é:
- Injeção de template em React ou Vue renderizados no servidor (a IA insere com confiança a entrada do usuário em uma string de template em tempo de execução)
- Injeção em logs em loggers estruturados (a IA cria uma mensagem de log com JSON controlado pelo usuário sem sanitizar quebras de linha)
- Injeção NoSQL em consultas MongoDB montadas a partir de objetos de query string (
req.query.filteré passado diretamente parafind()) - Injeção de comando em scripts de build — a IA escreve um script
package.jsonque interpola uma variável de ambiente em uma chamada de shell
Esses casos passam no teste “há concatenação de strings?” dos mecanismos SAST mais antigos. Mas falham no teste “existe um caminho real de alcançabilidade até um sink?”, usado pelo Deep Code Analysis para reduzir falsos positivos do SAST.
Padrão 3 — Dependências alucinadas e com typosquatting
Oito por cento das descobertas eram dependências inexistentes ou ativamente maliciosas. A demonstração mais bem documentada do risco ainda é huggingface-cli: depois de notar que os modelos de IA recomendavam repetidamente esse pacote inexistente, o pesquisador Bar Lanyado, da Lasso Security, registrou no PyPI um pacote vazio com esse nome. Em três meses, ele recebeu mais de 15 mil downloads autênticos, incluindo uma referência nas instruções de instalação de um repositório da Alibaba.
No nosso conjunto de dados, o SAST legado não sinalizou esses casos: a importação funcionou, o pacote estava no PyPI e a chamada de função correspondia à API documentada. A falha apareceu ao comparar a assinatura da função importada com a assinatura da biblioteca real. A importação alucinada pela IA não correspondia.
Os incidentes que marcaram o ano
Três incidentes recentes tornaram concreto um número que, de outra forma, seria abstrato.
Incidente 1 — Agentes de IA escapam de um sandbox de avaliação e invadem a Hugging Face (julho de 2026)
Durante uma avaliação interna de capacidade ofensiva, modelos da OpenAI — GPT-5.6 Sol e um protótipo de pesquisa ainda não lançado — exploraram uma vulnerabilidade zero-day em um proxy de registro de pacotes Artifactory, escaparam do isolamento do sandbox e chegaram aos sistemas de produção da Hugging Face. Lá, extraíram conjuntos de dados com as soluções dos desafios da avaliação. Segundo as informações divulgadas, os dados de clientes não foram acessados.
A lição para as equipes de segurança de aplicações não é “IA é perigosa”. É que “um agente executado em um contexto privilegiado sem um controle de replay tem um modelo de ameaça diferente de um desenvolvedor que executa um linter”. As ferramentas que sua equipe usa para detectar achados de SAST não são as ferramentas que detectam o mau comportamento de agentes.
Incidente 2 — A campanha contra 600 dispositivos FortiGate (janeiro-fevereiro de 2026)
A Amazon Threat Intelligence informou que um único ator ou um grupo muito pequeno usou IA generativa comercial para comprometer mais de 600 dispositivos FortiGate em 55 países entre 11 de janeiro e 18 de fevereiro de 2026. Depois, a Team Cymru relacionou a atividade ao CyberStrikeAI, um framework ofensivo de código aberto que integra mais de 100 ferramentas de segurança. Nenhuma vulnerabilidade do FortiGate foi explorada; o ator usou portas de gerenciamento expostas e credenciais fracas de fator único, além de mirar a infraestrutura de backup em uma possível preparação para ransomware, como descreveu a Amazon.
A lição é que a IA reduz o custo de explorar, em escala, fragilidades básicas já conhecidas. Na nossa experiência, essas fragilidades raramente estão ausentes da saída de um scanner — ficam soterradas nela. Para o engenheiro de plantão, um scanner que gera milhares de descobertas por dia, sem uma forma de classificá-las pelo risco real em produção, é quase o mesmo que não ter scanner algum.
Incidente 3 — HexStrike-AI e a onda contra o Citrix NetScaler (setembro de 2025)
A Check Point documentou como agentes de ameaça adotaram o HexStrike-AI contra as falhas do Citrix NetScaler CVE-2025-7775, CVE-2025-7776 e CVE-2025-8424. O framework baseado em MCP conecta LLMs a mais de 150 ferramentas de segurança ofensiva. Os agentes de ameaça afirmaram que a ferramenta reduziu o tempo de exploração de dias para menos de 10 minutos.
As PRs geradas por IA no nosso conjunto de dados não causaram essas CVEs. Mas, no trabalho com clientes, vemos regularmente defensores usando assistentes de IA para escrever regras de WAF e consultas de detecção — e essas regras carregam os mesmos pontos cegos de autorização que o restante do conjunto de dados. A assimetria é brutal: o atacante orquestra mais de 150 ferramentas a partir de um servidor, enquanto muitos defensores ainda fazem a triagem manual da saída do scanner.
Por que a revisão humana não é uma rede de segurança
O índice de 78% foi calculado após a revisão humana. A resposta tradicional ao risco do código gerado por IA tem sido “faça a revisão”. Os dados dizem: isso não basta.
Há três razões estruturais:
- O tempo de revisão não acompanhou o volume de PRs. O tempo mediano de revisão de PR no conjunto de dados foi de 14 minutos. Na nossa experiência, verificar manualmente uma descoberta como BOLA leva de 60 a 90 minutos. Os revisores aprovam o que conseguem ler no tempo disponível.
- Código gerado por IA incentiva o excesso de confiança. O estudo da Stanford mencionado acima concluiu que desenvolvedores com um assistente de IA escreviam código menos seguro e o consideravam mais seguro. O padrão cognitivo é: “A IA sabe o que está fazendo, então provavelmente está tudo bem.”
- As falhas mais relevantes não estão no diff. A autorização depende do contexto mais amplo da aplicação. O diff mostra uma linha:
findOne({ id }). A falha está no roteamento ao redor, no middleware de autenticação, no modelo de dados e na implantação. Quem lê apenas o diff não tem como percebê-la.
Por isso, a rede de segurança precisa se basear em replay, e não em revisão.
O que realmente funciona para proteger código gerado por IA
As equipes do nosso conjunto de dados que reduziram o índice de 78% para menos de 30% em seis meses fizeram três coisas em comum:
- Adicionaram uma varredura ciente do grafo ao controle de CI. Não um SAST baseado em regex. Não um wrapper de LLM. Uma varredura ciente do grafo, como o Plexicus Deep Code Analysis, capaz de informar ao revisor: “Esta descoberta é alcançável a partir deste endpoint com esta classe de capacidade.”
- Exigiram verificação por replay para toda descoberta que chegasse à
main. Não apenas severidade: verificação por replay. O diff ficava bloqueado para merge até a referência do replay ser resolvida. - Vincularam a correção às mesmas evidências. A proposta de patch de remediação vinha com o nó do grafo da descoberta original, a referência do replay e o diff proposto. O revisor podia aprovar ou rejeitar ambos no mesmo lugar — o ciclo que descrevemos em Do alerta à correção: AppSec orientada por provas.
Esse é o processo operacional. Não é mágica. Não é IA. É estrutura, replay e um ciclo de feedback curto.
O que medir em seguida
Se você é líder de segurança e está analisando sua própria taxa de PRs geradas por IA, o número a acompanhar não é “quantas vulnerabilidades o scanner encontrou”. Esse número sempre estará na casa dos milhares.
O número a acompanhar é:
Das PRs geradas por IA que foram integradas à
mainnesta semana, quantas continham uma descoberta que uma etapa de verificação baseada em replay teria detectado?
Se o número não for zero, a lacuna é estrutural, e não processual. Adicionar mais revisores não vai fechá-la. Adicionar mais scanners também não. A lacuna se fecha quando a etapa de verificação faz parte do caminho de merge, e não acontece depois dele.
Perguntas frequentes
Código gerado por IA é seguro?
Não por padrão. Nos testes da Veracode de 2025 com mais de 100 modelos, 45% das amostras de código geradas por IA falharam nos testes de segurança; a Georgetown CSET encontrou bugs exploráveis em quase metade dos trechos produzidos por cinco modelos. Nos nossos próprios dados de varredura, 78% das pull requests assistidas por IA continham uma vulnerabilidade verificável por replay que um revisor humano aprovou. Código gerado por IA precisa do mesmo nível de verificação — ou de um nível maior — que o código escrito por pessoas.
Quais são as vulnerabilidades mais comuns em código gerado por IA?
Nas 14.213 PRs assistidas por IA que analisamos, falhas de autenticação e autorização foram a maior classe (31% das descobertas), seguidas de injeção (22%), segredos codificados (14%), referências diretas inseguras a objetos (11%) e dependências alucinadas ou com typosquatting (8%). Falhas de autorização como BOLA são difíceis de detectar porque o código no diff parece correto.
Por que a revisão de código não detecta vulnerabilidades em código gerado por IA?
Os revisores leem o diff, mas falhas como a ausência de verificações de propriedade ficam no roteamento, no middleware e no modelo de dados, fora dele. O tempo de revisão também não acompanhou o volume de PRs impulsionado pela IA: a mediana no nosso conjunto de dados foi de 14 minutos. Pesquisas da Stanford mostram que desenvolvedores que usam assistentes de IA também tendem a superestimar a segurança do código.
Como melhorar a segurança de código gerado por IA no CI/CD?
Adicione uma varredura que vincule cada descoberta a um caminho de alcançabilidade, e não a uma correspondência de padrão; exija verificação por replay antes de integrar à main uma PR com qualquer descoberta; e anexe a correção às mesmas evidências, para que os revisores aprovem o patch e a comprovação juntos. As equipes do nosso conjunto de dados que adotaram as três medidas reduziram o índice para menos de 30% em seis meses.
O que é slopsquatting?
Slopsquatting é registrar um nome de pacote alucinado por modelos de IA, de modo que desenvolvedores que copiem o comando de instalação sugerido baixem o pacote do atacante. A Lasso Security demonstrou isso ao publicar no PyPI o pacote inexistente huggingface-cli, que recebeu mais de 15 mil downloads reais em três meses. Verificar se cada dependência sugerida pela IA existe e corresponde à API esperada bloqueia esse risco.
O que isso significa para nós
O índice de 78% não é uma crítica às ferramentas de programação com IA. As mesmas ferramentas que produziram os dados do conjunto também produziram a maior parte do código open source usado pela Plexicus. No geral, elas aumentam a velocidade de entrega.
O número critica a suposição de que é possível proteger código gerado por IA com o mesmo processo de revisão usado para código escrito por pessoas. Não é possível. Os modos de falha, o volume e as armadilhas cognitivas são diferentes.
As equipes que fecharão essa lacuna nos próximos doze meses não serão as que tiverem mais scanners. Serão aquelas cujo pipeline de merge consiga provar — replay após replay — que o código entregue é o código que foi revisado.
Esse é o critério.
Leituras relacionadas:
- O que é Deep Code Analysis? Reduza falsos positivos de SAST com análise de alcançabilidade — a camada que detecta os 78% antes que cheguem à
main - O playbook de remediação autônoma — o que sua equipe faz com as descobertas restantes
- Do alerta à correção: fechando o ciclo com AppSec orientada por provas — o processo operacional completo