Présentation de la remédiation native IA : de la découverte validée au correctif relu
Comment une découverte validée devient une pull request prête pour la revue, avec preuves, tests de régression et retest, et pourquoi la fusion reste entre les mains de votre équipe.
Au-delà de l’ASPM
Une AppSec fondée sur la preuve pour les équipes qui développent avec l’IA
Plexicus utilise AI Swarm Pentest pour explorer des chemins d’application autorisés, valider ce qui est exploitable et fournir les preuves nécessaires pour prioriser la remédiation.
Découvrir AI Swarm PentestTrouver des vulnérabilités n’a jamais coûté aussi peu.
Les corriger n’a pas suivi le même rythme.
Les scanners, les pentests et les agents d’IA produisent désormais des découvertes plus vite que les équipes d’ingénierie ne peuvent les lire. Le backlog grossit. Le risque reste en production.
La remédiation native IA consiste à transformer une découverte de sécurité validée en changement de code prêt pour la revue, accompagné des preuves, du raisonnement et des tests, afin qu’un humain puisse le fusionner en confiance et qu’un retest prouve que la correction a fonctionné.
Ce n’est pas un bot qui pousse des patchs en production.
C’est la dernière étape d’une boucle fermée : prouver le problème, le comprendre dans le code, proposer le changement, laisser une personne décider, puis prouver que le problème a disparu.
Le besoin est mesurable. Dans son Data Breach Investigations Report 2026, Verizon constate que l’exploitation de vulnérabilités est devenue le premier vecteur d’accès initial, avec 31 % des violations de son jeu de données dont le vecteur d’accès initial est connu. Le même rapport indique que seules 26 % des Known Exploited Vulnerabilities (KEV) de la CISA trouvées dans les environnements des organisations ont été entièrement corrigées en 2025, contre 38 % l’année précédente, et que le délai médian de résolution complète est passé à 43 jours.
Les attaquants exploitent l’écart entre « trouvé » et « corrigé ». La remédiation native IA vise à le combler sans renoncer au contrôle.
Qu’est-ce que la remédiation native IA ?
La remédiation native IA est un workflow de remédiation conçu dès le départ autour de l’IA : le système lit une découverte validée, rassemble le contexte du code qui l’entoure, rédige une correction minimale avec des tests et une explication, la soumet sous forme de pull request à une revue humaine, puis teste à nouveau la preuve initiale après le changement.
Trois mots de cette définition font l’essentiel du travail.
Validée. L’entrée est une découverte dont la réalité a été démontrée, pas une alerte brute. Si le problème ne peut pas être reproduit, il n’y a encore rien à corriger.
Prête pour la revue. La sortie est un changement qu’un développeur peut évaluer en quelques minutes : un diff réduit, la raison pour laquelle il traite la faiblesse, les tests qui la couvrent et les emplacements concernés dans le code source.
Retestée. La correction n’est pas terminée au moment de la fusion. Elle l’est quand la preuve initiale ne fonctionne plus.
Retirez l’un de ces éléments et vous obtenez quelque chose de plus faible.
Sans validation, vous automatisez des corrections pour des problèmes qui n’existent peut-être pas.
Sans revue, vous donnez un accès en écriture à un modèle.
Sans retest, vous avez un changement qui semble correct et qui ne l’est peut-être pas.
Pourquoi la remédiation est le goulot d’étranglement en 2026
La détection a passé à l’échelle en premier. La remédiation, non.
Les chiffres de sources indépendantes vont dans le même sens.
Les données sur les correctifs.
Le DBIR 2026 a mesuré la remédiation des vulnérabilités répertoriées dans le KEV que les scanners ont trouvées dans les environnements des organisations, à partir de données agrégées provenant de plus de 13 000 organisations. Trois constats ressortent :
- Seules 26 % de ces vulnérabilités du KEV ont été entièrement corrigées en 2025, contre 38 % l’année précédente.
- Le délai médian de résolution complète est passé de 32 jours à 43 jours.
- L’organisation médiane avait 16 vulnérabilités du KEV à corriger, contre 11 l’année précédente, soit près de 50 % de plus selon le rapport.
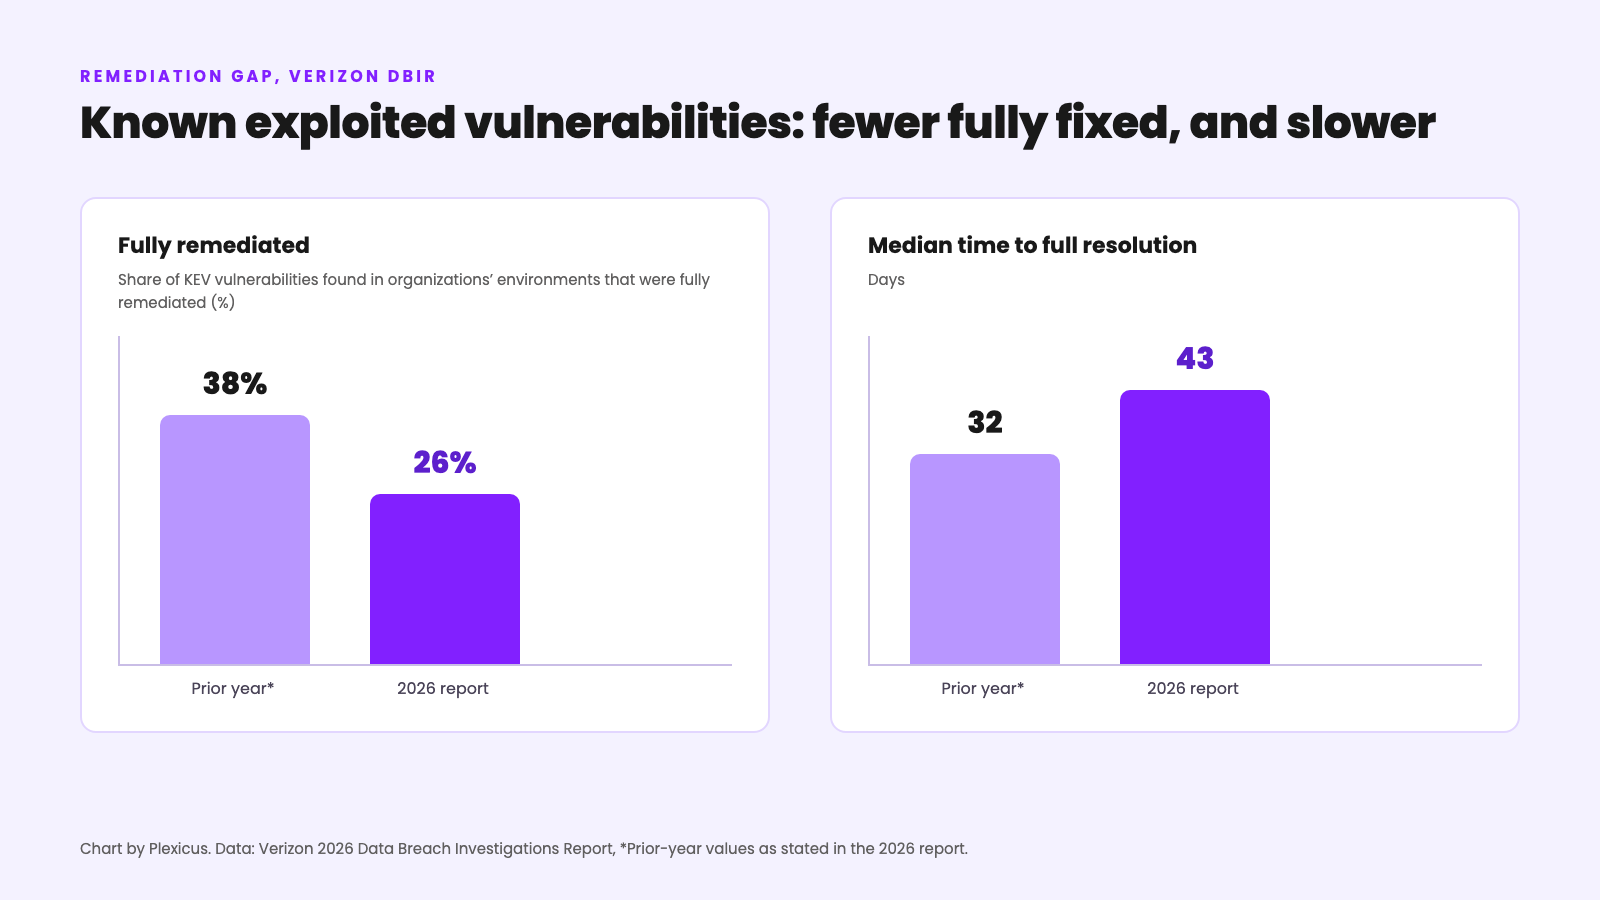
Graphique réalisé par Plexicus à partir des chiffres publiés dans le Data Breach Investigations Report 2026 de Verizon ; les valeurs de l’année précédente sont celles que le rapport indique à titre de comparaison.
Ces chiffres décrivent l’application de correctifs pour des vulnérabilités connues dans les environnements des organisations, pas les corrections du code applicatif propriétaire. Ils montrent tout de même la forme du problème : la file d’attente grossit plus vite que les équipes ne la résorbent.
Les délais.
Pour les agences fédérales américaines, l’échéance n’est pas une question de préférence. La Binding Operational Directive (BOD) 26-04 de la CISA, émise le 10 juin 2026, a révoqué la BOD 22-01 et remplacé les échéances que celle-ci fixait par défaut pour le KEV par des délais de remédiation fondés sur le risque, applicables aux agences civiles du pouvoir exécutif fédéral.
Quatre facteurs fixent le délai de chaque actif :
- S’il est exposé publiquement.
- Si la vulnérabilité figure dans le catalogue KEV.
- Si un adversaire peut automatiser toutes les étapes nécessaires à son exploitation.
- Si une exploitation réussie donne un contrôle partiel ou total sur l’actif.
Les délais évoluent lorsque ces faits changent : le délai d’une vulnérabilité se raccourcit quand la CISA l’ajoute au catalogue KEV. Les agences doivent déjà corriger les vulnérabilités du KEV selon les échéances du catalogue KEV, et respecter les délais complets pour toute vulnérabilité dotée d’un identifiant CVE dans les 180 jours suivant l’émission.
En Europe, le Cyber Resilience Act, le règlement sur la cyberrésilience, est entré en vigueur le 10 décembre 2024. Selon la Commission européenne, ses obligations de signalement s’appliquent à partir du 11 septembre 2026 et ses principales obligations à partir du 11 décembre 2027. Les fabricants de produits comportant des éléments numériques doivent désormais signaler les vulnérabilités activement exploitées.
La réglementation n’écrit pas de patchs. Elle réduit en revanche le temps dont une équipe dispose pour décider s’il faut en écrire.
Le code en cours d’écriture.
Le volume de nouveau code change aussi. Le GenAI Code Security Report 2025 de Veracode a testé plus de 100 grands modèles de langage sur des tâches de programmation et indique que 45 % des échantillons de code ont échoué aux tests de sécurité et introduit des faiblesses de l’OWASP Top 10. Ces résultats sont publiés par le fournisseur à partir de son propre jeu de tests, pas d’une réplication indépendante.
Même lue avec cette réserve, la tendance est claire. Les outils de codage par IA augmentent la quantité de code qui arrive en revue. Une partie de ce code contient les mêmes failles classiques que les équipes de sécurité corrigent depuis vingt ans.
Le volume des divulgations.
La méthodologie 2025 du CWE Top 25 du MITRE a analysé 39 080 enregistrements CVE publiés entre le 1er juin 2024 et le 1er juin 2025. Cela représente une année d’enregistrements CVE publiés, sans compter ce que vos propres scanners et tests trouvent dans votre propre code.
Plus de découvertes, des délais plus courts, davantage de code. La contrainte n’est plus de voir le problème. C’est de le résoudre.
Ce que signifie « native IA », et ce que cela ne signifie pas
L’expression « native IA » se prête facilement aux abus, il vaut donc mieux être précis.
Un workflow de remédiation native IA est un workflow dans lequel l’IA fait partie de la conception du pipeline : elle reçoit des preuves structurées, travaille sur le vrai dépôt, produit une sortie structurée et se trouve contrôlée par des tests et par une personne.
C’est différent d’une fenêtre de chat greffée sur un scanner.
C’est aussi différent d’une autonomie sans limites.
L’IA rédige. Les tests vérifient. Les personnes décident. Un retest confirme.
En ce sens, « native IA » décrit la place de l’IA dans la boucle, pas l’autorité qu’elle détient.
Plus l’IA prend en charge une grande part du travail, plus le workflow a besoin de preuves et de revue autour d’elle.
Remédiation native IA et gestion automatisée des correctifs
La gestion automatisée des correctifs et les bots de mise à jour des dépendances résolvent très bien un problème plus étroit.
La documentation de GitHub sur les mises à jour de sécurité Dependabot décrit le principe : lorsqu’une dépendance fait l’objet d’un avis publié, Dependabot vérifie s’il peut passer à une version corrigée sans casser le graphe de dépendances, puis ouvre une pull request qui met à jour la dépendance vers la version minimale incluant le correctif.
C’est un workflow précieux. Conservez-le.
Mais il répond à une seule question : existe-t-il une version plus récente de ce paquet sans la vulnérabilité connue ?
La pull request de montée de version ne répond pas, à elle seule, à ces questions :
- Votre code appelle-t-il réellement la fonction vulnérable ?
- La faille se trouve-t-elle dans votre propre code plutôt que dans une bibliothèque ?
- La correction exige-t-elle de modifier la façon dont votre application appelle la bibliothèque ?
- Le vrai problème est-il un contrôle d’autorisation qui n’a jamais été écrit ?
La remédiation native IA part d’une autre entrée. Elle commence par une découverte validée dans votre application, y compris dans le code propriétaire, et peut proposer des changements de ce code, pas seulement d’un manifeste.
Les deux approches se complètent bien. Une montée de version est souvent la bonne correction. Parfois, elle ne suffit pas.
Remédiation native IA et suggestions de code par IA
Les suggestions d’IA intégrées à un éditeur ou à une pull request aident un développeur qui examine déjà le problème.
Elles sont utiles. Elles sont aussi autre chose.
Une suggestion intégrée part généralement d’une alerte de scanner ou d’un prompt du développeur. Elle propose une modification. Le développeur décide si l’alerte était réelle et si la modification est correcte.
La remédiation native IA avance deux de ces décisions et les rend explicites :
- La découverte est-elle réelle ? Le workflow n’accepte que des découvertes validées et accompagnées de preuves.
- La correction fonctionne-t-elle ? Le workflow joint des tests et rejoue la preuve initiale.
Le développeur relit toujours le changement. Il le relit avec plus de contexte et moins de suppositions.
Remédiation native IA et remédiation manuelle
La remédiation manuelle est la référence, et elle reste le bon outil pour les problèmes les plus difficiles.
Un ingénieur expérimenté comprend l’intention de conception, les conventions de l’équipe et les règles métier qu’aucun rapport de découverte ne contient. Pour une faille enracinée dans l’architecture, une personne doit mener le travail.
La faiblesse de la remédiation manuelle n’est pas la qualité. C’est le débit et la régularité.
Chaque découverte exige que quelqu’un la reproduise, la localise, la comprenne, conçoive une correction, écrive des tests et ouvre une pull request. Ce travail entre en concurrence avec la feuille de route produit, et c’est généralement la feuille de route qui l’emporte.
La remédiation native IA prend en charge la partie répétitive de cette séquence et laisse la décision à l’ingénieur.
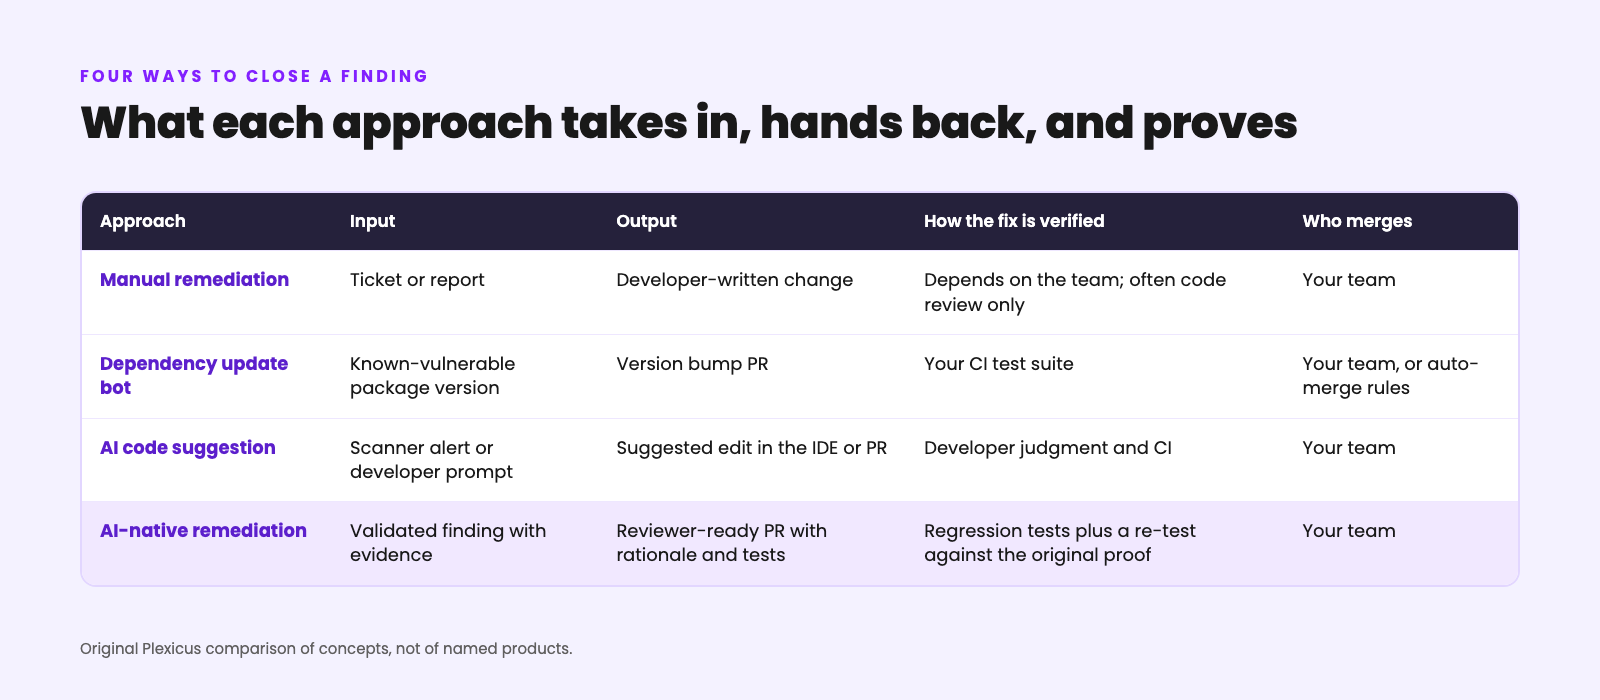
Comparaison originale de Plexicus des quatre approches en tant que concepts ; elle ne décrit aucun produit nommé.
Fonctionnement de la remédiation native IA
Un workflow complet comporte sept étapes. Chacune transmet un artefact précis à la suivante. Le schéma ci-dessous les regroupe en cinq étapes.
Validated finding + evidence
        ↓
Code context and root cause
        ↓
Fix strategy
        ↓
Drafted change + tests + rationale
        ↓
Automated checks (CI)
        ↓
Human review and merge decision
        ↓
Re-test against the original proof
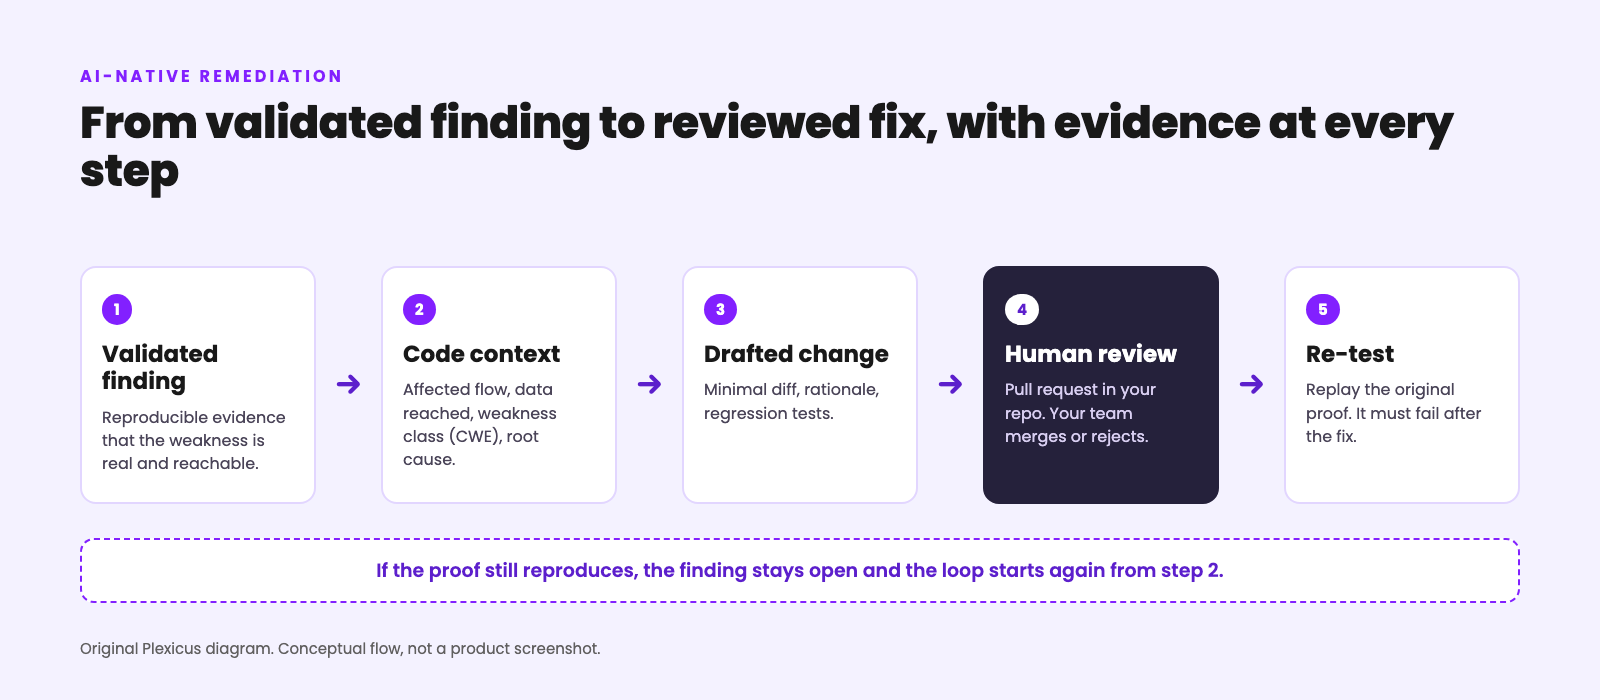
Schéma original de Plexicus de la boucle de remédiation ; il s’agit d’un flux conceptuel, pas d’une capture d’écran du produit.
1. Partir d’une découverte validée
L’entrée est une découverte accompagnée de preuves : la requête qui a déclenché la faille, la réponse qui l’a prouvée, les données atteintes, le rôle qui pouvait les atteindre.
Une découverte sans preuve est une hypothèse. Une remédiation fondée sur une hypothèse gaspille du temps de revue et érode la confiance dans chaque pull request suivante.
2. Rassembler le contexte du code et la cause racine
Le système remonte de la découverte jusqu’au code : le point de terminaison, le handler, la fonction, le paramètre et le flux de données entre eux.
Il identifie aussi la classe de faiblesse, généralement sous la forme d’une entrée CWE comme CWE-89 pour l’injection SQL. La classe compte, car le modèle de correction en dépend.
Voici le contexte de code d’une découverte dans la plateforme Plexicus.
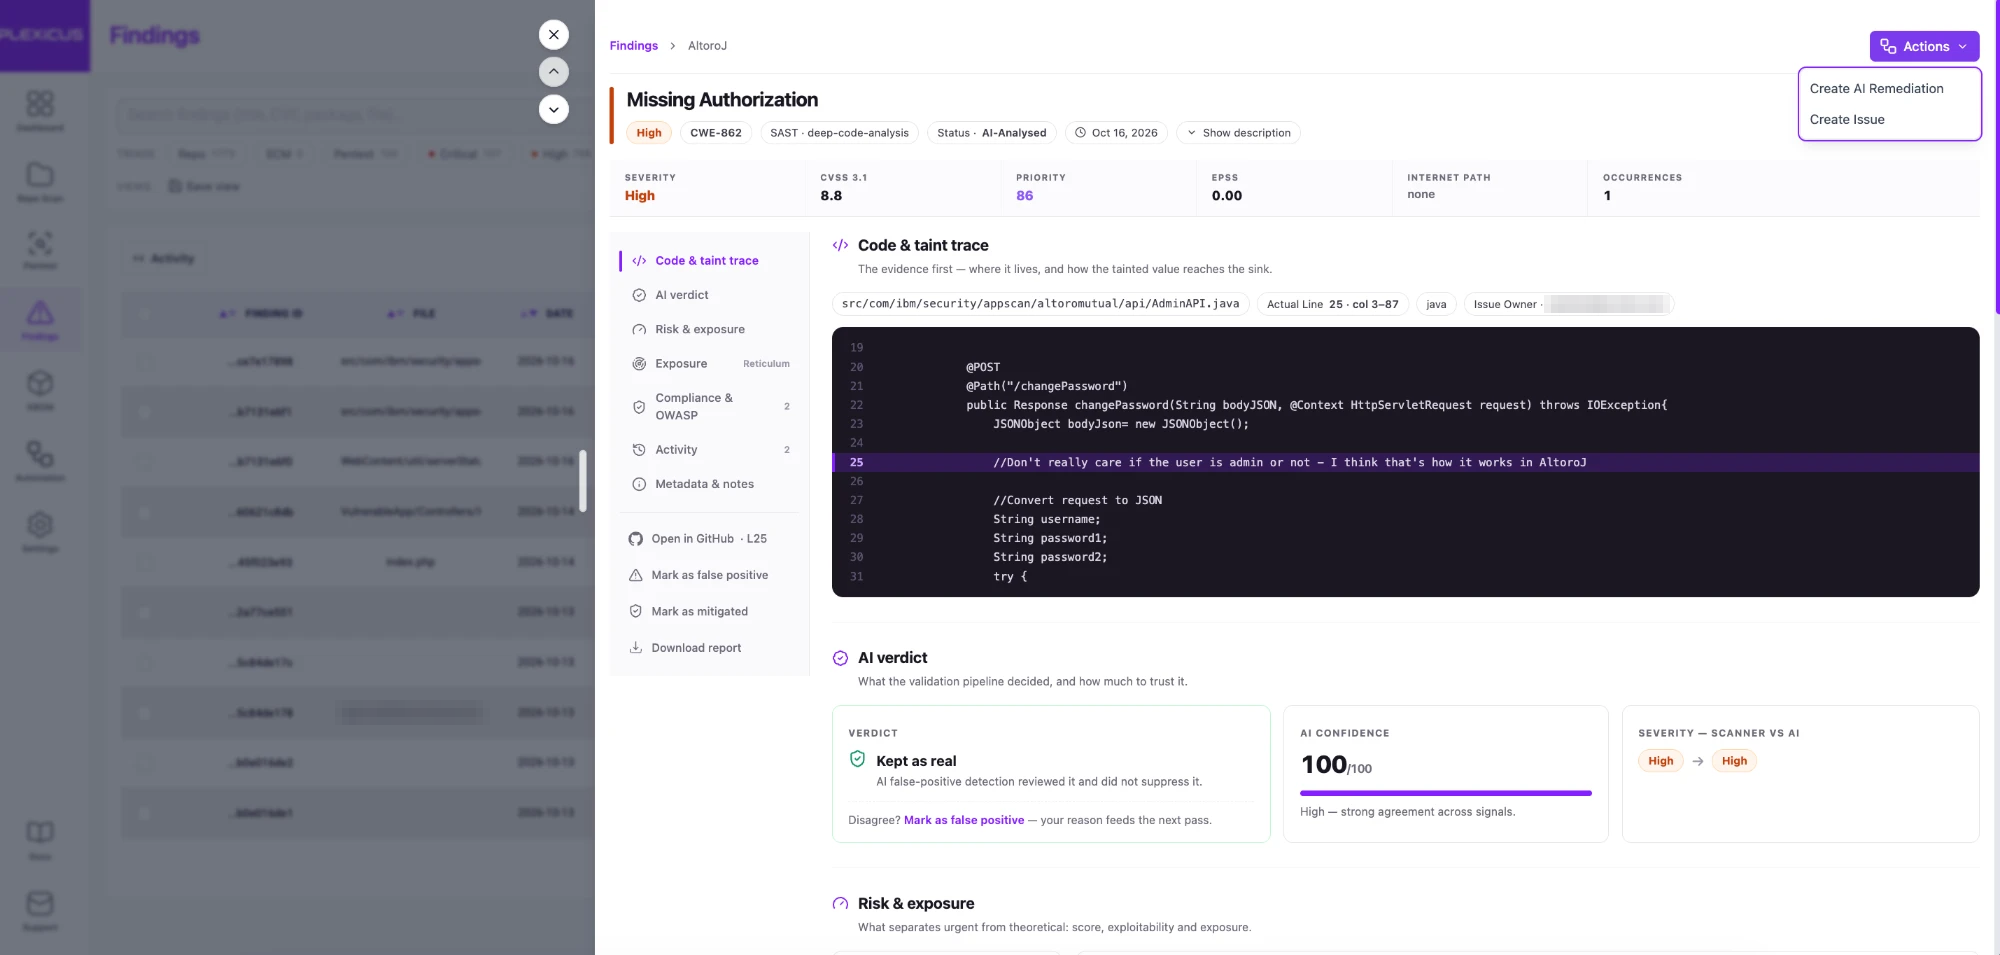
Capture d’écran : le détail d’une découverte d’autorisation manquante (CWE-862) dans une application Java de démonstration, dans la plateforme Plexicus. Il montre la section Code & taint trace, le verdict d’IA et Create AI Remediation dans le menu d’actions. Données de démonstration, capturées en octobre 2026 ; l’adresse e-mail du propriétaire du ticket est pixellisée.
3. Choisir une stratégie de correction
La plupart des classes de faiblesse ont des modèles de correction éprouvés.
Des requêtes paramétrées pour l’injection. Un contrôle de propriété pour l’autorisation au niveau des objets. Une montée de version pour une dépendance vulnérable.
La stratégie détermine aussi le périmètre. La meilleure correction est généralement le plus petit changement qui supprime la faiblesse à sa source.
4. Rédiger le changement, les tests et l’explication
La sortie est un diff, une courte justification qui relie chaque ligne modifiée à la découverte, et des tests qui auraient échoué avant la correction.
Un test de régression est ce qui empêche la même faille de revenir six mois plus tard.
Voici une remédiation générée par l’IA en cours de relecture dans la plateforme Plexicus.
Vidéo : un extrait du parcours guidé de la plateforme Plexicus. Dans la boîte de dialogue AI Remediation Details d’une découverte d’injection de commandes, l’onglet Details explique la vulnérabilité et le correctif, l’onglet Code Changes montre le diff du fichier app.py, et l’extrait se termine par la création de la pull request. Enregistré en mai 2026.
5. Exécuter les contrôles automatisés
Le changement passe par le même pipeline de CI que n’importe quelle autre pull request : build, tests unitaires, linters et contrôles de sécurité existants.
Une correction rédigée par l’IA ne bénéficie d’aucun raccourci. Au contraire, elle passe par le pipeline complet à chaque fois.
6. Confier la décision à un humain
Le changement arrive sous forme de pull request dans le dépôt que votre équipe utilise déjà. Un relecteur lit le diff, les preuves et la justification, puis fusionne, modifie ou rejette le changement.
Le relecteur est maître de la fusion.
Voici à quoi ressemble une découverte une fois un correctif soumis, dans la plateforme Plexicus.
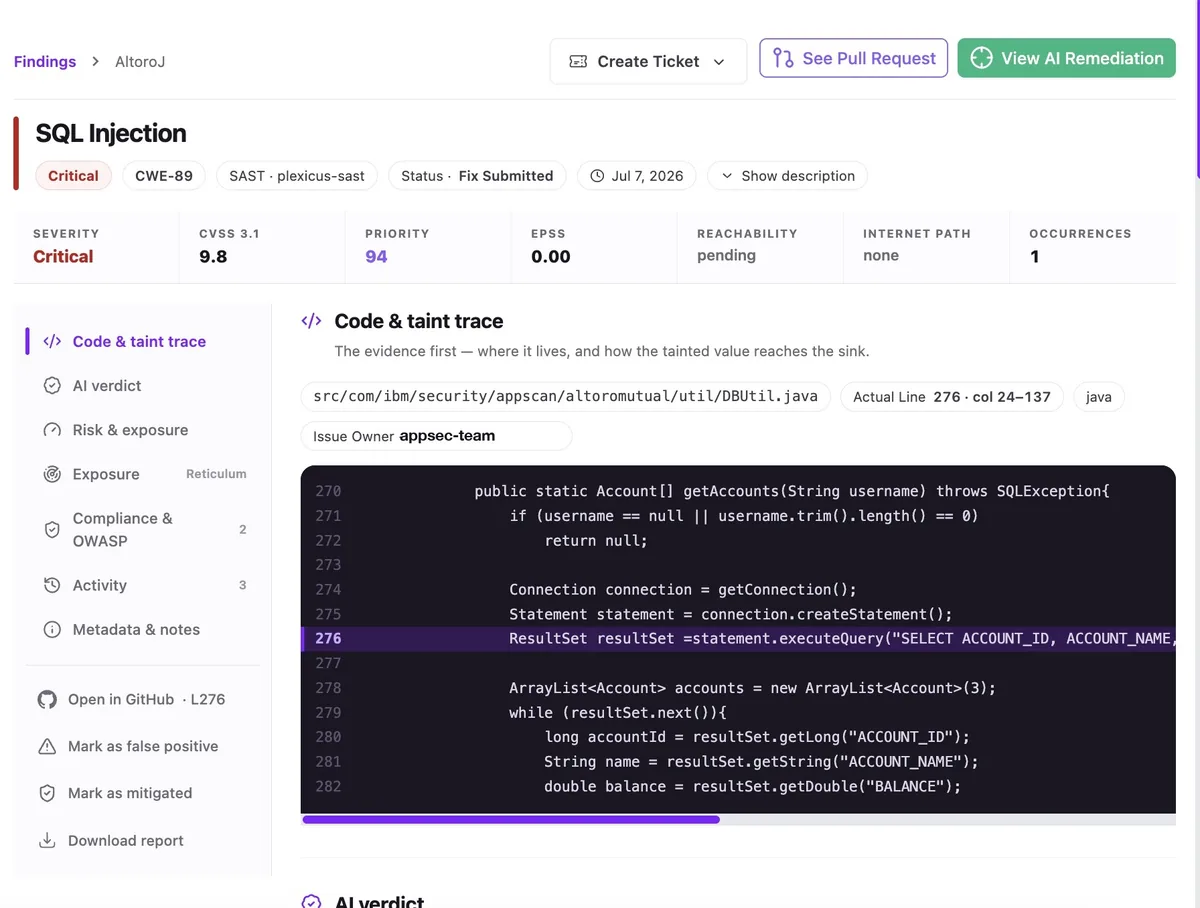
Capture d’écran : une découverte critique d’injection SQL (CWE-89) dans une application Java de démonstration, affichée dans la plateforme Plexicus avec le statut Fix Submitted. La barre d’outils propose Create Ticket, See Pull Request et View AI Remediation. Données de démonstration.
Et voici une pull request pour une découverte d’injection de commandes, telle qu’elle arrive dans le dépôt.
Vidéo : un extrait du parcours guidé de la plateforme Plexicus. Le journal d’état en direct se termine par la création de la pull request ; sur GitHub, elle est ouverte par un compte bot Plexicus avec un commit et l’explication du correctif dans sa description, puis une personne la fusionne. Cet enregistrement ne montre ni vérifications CI ni relectures sur la pull request. Enregistré en mai 2026.
7. Retester avec la preuve initiale
Après le changement, la preuve initiale est rejouée. Si l’exploit fonctionne encore, la découverte reste ouverte. S’il échoue, la découverte peut être clôturée avec des preuves des deux côtés : elle se reproduisait avant, elle ne se reproduit plus après.
C’est cette dernière étape qui transforme un changement de code en découverte clôturée.
Pourquoi l’entrée doit être une découverte validée
Il est tentant de diriger un agent de correction vers la totalité des résultats de chaque scanner.
Cela multiplie le bruit.
Chaque faux positif devient une pull request. Chaque pull request prend du temps à un relecteur. Après quelques changements rejetés, les relecteurs commencent à les approuver ou à les ignorer sans les lire, ce qui est pire que de n’avoir aucune automatisation.
Partir de découvertes validées change l’économie de la revue. Chaque changement qu’un relecteur voit est lié à un problème dont la réalité a été démontrée.
C’est le cœur de Proof-Driven AppSec : no PoC, no finding. La même règle s’applique une étape plus loin. Pas de découverte validée, pas de correction automatisée.
Pour en savoir plus sur le fonctionnement de la validation, consultez notre article explicatif sur AI Swarm Pentest, qui décrit la reproduction indépendante effectuée avant qu’une découverte soit présentée comme vérifiée.
Pourquoi la sortie doit être une pull request, pas un push
Une pull request est le point de contrôle auquel votre organisation d’ingénierie fait déjà confiance.
Elle contient un diff et exécute la CI. Elle enregistre qui a approuvé quoi et quand, et elle peut être annulée.
Le projet OpenSSF Scorecard en fait une pratique de base. Son contrôle Code-Review détermine si un projet exige une revue de code humaine avant la fusion des pull requests, et classe le risque de s’en passer comme élevé.
Cette exigence devrait s’appliquer avec plus de force, pas moins, lorsque l’auteur est une IA.
Un workflow de remédiation native IA n’a donc jamais besoin d’un accès direct en écriture à la production. Il a besoin de pouvoir ouvrir une branche et une pull request. Tout ce qui suit relève de votre processus habituel.
Ce que dit la recherche sur les correctifs de sécurité générés par IA
La recherche sur les patchs de sécurité écrits par l’IA est à la fois encourageante et invite à la prudence. Quatre sources méritent d’être connues.
Les LLM peuvent réparer des cas simples, le code réel est plus difficile.
Dans « Examining Zero-Shot Vulnerability Repair with Large Language Models », présenté au 2023 IEEE Symposium on Security and Privacy, Pearce et ses collègues ont testé cinq modèles disponibles dans le commerce, un modèle open source et un modèle entraîné localement, sur des scénarios de vulnérabilité synthétiques, conçus à la main et issus du monde réel.
Ensemble, les modèles ont réparé tous les scénarios synthétiques et conçus à la main. Sur des exemples historiques issus du monde réel, les auteurs font état de difficultés à générer du code fonctionnellement correct.
Leçon : une correction qui compile n’est pas une correction qui fonctionne.
À grande échelle, un taux de réussite modeste compte quand même.
Le rapport technique de Google sur le patching assisté par IA décrit un pipeline qui demande à Gemini de générer des corrections pour des bugs détectés par des sanitizers en C/C++, Java et Go, puis les soumet à une revue humaine.
Google indique que cette approche a corrigé avec succès 15 % des bugs de sanitizer découverts pendant les tests unitaires, soit des centaines de bugs corrigés. Il s’agit d’un résultat publié par l’entreprise à partir de son propre pipeline, pas d’une réplication indépendante.
Leçon : même un taux d’automatisation partiel supprime du travail réel, tant que des humains relisent ce qui est livré.
La qualité d’un patch doit être testée, pas jugée par sa ressemblance.
Dans « Fixing Security Vulnerabilities with AI in OSS-Fuzz », des chercheurs ont adapté un agent LLM pour corriger des vulnérabilités trouvées par OSS-Fuzz, qui, selon l’article, a identifié plus de 10 000 vulnérabilités dans 1 000 projets ou plus.
L’un de leurs constats concerne directement la conception de la remédiation : des patchs bien notés par les métriques de similarité de code échouaient encore lorsque l’entrée de l’exploit était exécutée contre eux. Les auteurs concluent que la correction d’un patch de sécurité doit tenir compte d’attributs dynamiques comme l’exécution de tests.
Leçon : l’exploit fait partie du test. Une correction n’est pas juste tant que la preuve fonctionne encore, même si le diff ressemble beaucoup à une correction connue.
Les systèmes de compétition peuvent trouver et corriger rapidement.
Les résultats finaux de l’AI Cyber Challenge de la DARPA, annoncés le 8 août 2025, indiquent que les systèmes en compétition ont découvert 54 vulnérabilités synthétiques uniques sur les 63 défis de la finale et en ont corrigé 43. Les équipes ont aussi trouvé 18 vulnérabilités réelles, non synthétiques, et fourni 11 patchs pour des vulnérabilités réelles. La DARPA fait état d’un délai moyen de 45 minutes pour soumettre un patch.
Ce sont des résultats de compétition obtenus sur des logiciels open source réels choisis pour le défi, selon les règles de notation de la compétition. Ils montrent ce qui est possible, pas ce qu’une équipe donnée observera dans son propre code.
Ce que les preuves n’établissent pas.
Aucune de ces sources ne montre que l’IA peut corriger chaque vulnérabilité sans supervision.
Elles montrent que l’IA peut rédiger une part utile des corrections et que leur justesse doit être vérifiée en exécutant la preuve. Seul le pipeline de production de Google fait intervenir une personne dans la boucle ; les trois autres mesurent des systèmes autonomes en conditions de test.
C’est pourquoi un workflow de production ajoute une revue humaine par-dessus. C’est exactement la conception d’un workflow de remédiation native IA.
L’exploit est le meilleur test de régression.
La plupart des correctifs de sécurité sont vérifiés en les lisant.
Un relecteur regarde le diff, reconnaît une requête paramétrée et approuve.
Cela fonctionne pour les modèles familiers. Cela échoue pour les cas subtils : un contrôle d’autorisation placé après le chargement des données, un filtre de nettoyage qui ignore un encodage, une montée de version d’une dépendance qui laisse en place une copie transitive vulnérable.
Lorsque la découverte s’accompagne d’une preuve fonctionnelle, le contrôle le plus solide est simple :
Proof reproduced before the fix:  YES
Proof reproduced after the fix:   NO
Regression tests:                 PASS
Reviewer approval:                YES
Cet enregistrement de quatre lignes est une preuve plus solide qu’un raisonnement sur le seul diff.
Ce n’est pas la preuve d’une correction complète. Un changement qui ne bloque que la charge utile initiale passe aussi le rejeu ; les tests de régression doivent donc inclure des variantes de l’entrée, comme d’autres encodages.
C’est aussi l’enregistrement qu’un auditeur, un client ou un régulateur finira par demander.
Quels types de failles la remédiation native IA peut-elle corriger ?
Toutes les découvertes ne sont pas de bonnes candidates. L’adéquation dépend du caractère local de la correction et de la maturité du modèle de correction.
Failles de code classiques.
L’injection, le cross-site scripting, la falsification de requêtes côté serveur, la désérialisation non sécurisée et la cryptographie faible ont généralement des modèles de correction bien connus. L’OWASP Top 10
classe l’injection en A05 et les défaillances cryptographiques en A04.Points forts : les corrections sont souvent locales à une seule fonction, le modèle est standard et un test de régression est facile à écrire.
Limites : la même faille peut apparaître à plusieurs endroits, et la correction d’un point d’appel ne couvre pas les autres. Le workflow doit rechercher le même modèle ailleurs, ce que le SSDF du NIST appelle l’examen du logiciel à la recherche de vulnérabilités similaires afin d’éradiquer une classe.
Failles de contrôle d’accès et de logique métier.
Les défaillances du contrôle d’accès occupent le rang A01 de l’OWASP Top 10
. Cette catégorie couvre des failles comme l’absence de contrôle de propriété et l’élévation de privilèges. Les failles de logique métier, comme l’absence de limitation de débit, se situent juste à côté.Points forts : une découverte validée montre exactement quel utilisateur a atteint quel objet, ce qui rend concret le contrôle manquant.
Limites : la bonne règle dépend de l’intention métier. Un administrateur d’équipe doit-il voir tous les projets de l’organisation, ou seulement ceux de son équipe ?
L’IA peut rédiger le contrôle. Une personne doit confirmer la règle.
Exposition des dépendances et de la chaîne d’approvisionnement.
Versions vulnérables, noms victimes de typosquatting et paquets qui n’auraient jamais dû être installés.
Points forts : les montées de version et les remplacements de paquets sont mécaniques, et les changements de fichiers de verrouillage sont faciles à relire.
Limites : les montées de version majeure peuvent casser des API. Une correction peut nécessiter des changements de code en plus de la montée de version, et les tests comptent ici plus que partout ailleurs.
Failles introduites en codant avec l’IA.
Noms de paquets hallucinés, secrets codés en dur, points d’injection de prompt et lacunes d’autorisation dans le code généré.
Points forts : ces failles suivent souvent des modèles reconnaissables et se trouvent dans du code récemment modifié, ce qui limite le périmètre de la correction.
Limites : le code généré peut n’avoir aucun test, la remédiation doit donc en ajouter, et pas seulement modifier le code.
Failles d’architecture.
Un système qui fait confiance à une frontière réseau interne, ou une conception qui place des secrets côté client.
Points forts : les preuves aident tout de même une équipe à comprendre le problème et à le prioriser.
Limites : ces failles ont rarement un petit diff sûr. La bonne sortie est une explication claire et un plan pour l’équipe, pas une pull request automatisée.
Quand une pull request de correction automatique peut-elle être fusionnée sans risque ?
« Sans risque à fusionner » relève du jugement d’un relecteur. Ces questions rendent ce jugement plus rapide et plus cohérent.
- La découverte a-t-elle été validée ? Existe-t-il des preuves que la faiblesse était réelle et atteignable ?
- Le diff est-il minimal ? Chaque ligne modifiée concerne-t-elle la découverte ?
- La justification est-elle précise ? Nomme-t-elle la classe de faiblesse, l’emplacement dans le code source et la raison pour laquelle le changement la supprime ?
- Y a-t-il des tests de régression ? Auraient-ils échoué avant le changement ?
- La CI passe-t-elle ? Entièrement, sans job ignoré.
- La preuve échoue-t-elle après la correction ? L’exploit ou la reproduction initiale a-t-il été rejoué ?
- La correction modifie-t-elle un comportement sur lequel comptent les utilisateurs ? Si oui, le responsable produit l’a-t-il vu ?
- Le même modèle est-il présent ailleurs ? Si oui, un suivi est-il prévu ?
Si une réponse est « non » ou « inconnue », la pull request n’est pas prête, aussi propre que paraisse le diff.
Bonnes pratiques de remédiation native IA
1. Fournir des preuves, pas des alertes
Seules les découvertes validées doivent entrer dans la file de remédiation. Tout le reste reste en triage.
2. Garder les preuves attachées au changement
La pull request doit renvoyer vers la découverte, sa preuve et son contexte. Un relecteur ne devrait jamais avoir besoin d’ouvrir un autre outil pour comprendre pourquoi le changement existe.
3. Préférer la plus petite correction juste
Les petits diffs sont plus faciles à relire, à tester et à annuler. Les refactorisations ont leur place dans des pull requests séparées.
4. Exiger des tests avec chaque correction
Un correctif de sécurité sans test est un correctif qui peut disparaître sans bruit lors de la prochaine refactorisation.
5. Utiliser vos règles de revue existantes
La protection des branches, les relecteurs obligatoires et les contrôles de CI doivent s’appliquer aux changements rédigés par l’IA exactement comme aux changements écrits par des humains.
6. Retester après la fusion, pas seulement avant
Rejouez la preuve contre le changement déployé. Une correction qui fonctionne sur une branche et échoue après le déploiement n’est pas une correction.
7. Suivre les causes racines dans le temps
Enregistrez la classe de faiblesse de chaque correction. Si la même classe revient sans cesse, le problème se situe en amont : dans une bibliothèque, un modèle de code ou une habitude de programmation.
8. Commencer par des classes bien comprises
Commencez par les classes de faiblesse qui ont des modèles de correction standard. Élargissez le périmètre une fois que les relecteurs font confiance aux résultats.
Erreurs courantes
Automatiser des corrections pour des découvertes non validées. Les relecteurs se noient dans des changements pour des problèmes qui n’ont jamais existé.
Laisser l’IA pousser directement sur une branche protégée. Cela supprime le seul contrôle qui rend l’ensemble du workflow digne de confiance.
Juger une correction à sa lecture. La ressemblance avec une correction connue n’est pas la justesse, comme l’a montré l’étude OSS-Fuzz.
Se passer de tests de régression parce que la CI est au vert. Une CI au vert ne couvre que ce que les tests vérifient.
Considérer que chaque découverte peut être corrigée par du code. Certains problèmes exigent une décision de conception, pas un diff.
Mesurer le succès au nombre de pull requests ouvertes. L’indicateur qui compte est le nombre de découvertes clôturées avec un retest réussi.
Normes et cadres applicables
La remédiation native IA est une nouvelle façon d’accomplir un travail que les normes existantes décrivent déjà.
NIST Secure Software Development Framework.
Le NIST SP 800-218, le Secure Software Development Framework (SSDF) publié en février 2022, comporte un groupe de pratiques intitulé Respond to Vulnerabilities (RV). Ses tâches correspondent étroitement au workflow décrit plus haut :
| Tâche du SSDF | Ce qu’elle demande | Où elle apparaît dans le workflow |
|---|---|---|
RV.2.1 | Analyser chaque vulnérabilité pour réunir suffisamment d’informations sur le risque afin de planifier sa remédiation | Découverte validée et contexte du code |
RV.2.2 | Planifier et mettre en œuvre des réponses aux risques liés aux vulnérabilités | Changement rédigé et revue |
RV.3.1 | Analyser les vulnérabilités identifiées pour déterminer leurs causes racines | Cause racine et classe de faiblesse |
RV.3.2 | Analyser les causes racines dans le temps pour identifier des tendances | Suivi des causes racines dans le temps |
RV.3.3 | Examiner le logiciel à la recherche de vulnérabilités similaires afin d’éradiquer une classe de vulnérabilités | Recherche du même modèle ailleurs |
RV.3.4 | Examiner le processus de SDLC et, si nécessaire, le mettre à jour pour empêcher que la cause racine se reproduise (ou en réduire la probabilité) | Correction en amont de la bibliothèque, du modèle de code ou de l’habitude |
Le SSDF demande aussi, dans PW.7.2, que les résultats de la revue et de l’analyse du code ainsi que les remédiations recommandées soient consignés dans le workflow ou l’outil de suivi des tickets de l’équipe de développement. Une pull request accompagnée de ses preuves le fait par conception.
KEV de la CISA et BOD 26-04.
Pour les agences fédérales, la BOD 26-04 fixe les délais de remédiation décrits plus haut, et le statut KEV est l’un de ses quatre facteurs. Pour tous les autres, le catalogue KEV est une liste de priorités pratique : si une vulnérabilité est connue pour être exploitée, elle passe en tête de la file de remédiation.
OWASP Top 10
. fournit un vocabulaire commun pour les classes de failles que les workflows de remédiation traitent le plus souvent : défaillances du contrôle d’accès, mauvaises configurations de sécurité, défaillances de la chaîne d’approvisionnement logicielle, défaillances cryptographiques, injection, entre autres.Cyber Resilience Act de l’UE.
Le CRA inscrit dans la loi la gestion des vulnérabilités pour les produits comportant des éléments numériques vendus dans l’UE. Un enregistrement de remédiation qui montre la découverte, la correction, la revue et le retest est le type de preuve dont ce processus de gestion aura besoin.
Un exemple pratique
Imaginez une API de facturation construite avec l’aide d’un assistant de codage par IA.
Un pentest autorisé découvre qu’un utilisateur peut télécharger la facture d’un autre client en modifiant l’identifiant dans l’URL :
GET /api/invoices/8812/pdf     (account A, owns invoice 8812)    200 OK
GET /api/invoices/8813/pdf     (account A, invoice of account B) 200 OK
La seconde requête aurait dû être refusée. La découverte est reproduite de façon indépendante et marquée comme validée, et les deux requêtes et réponses sont conservées comme preuves.
Contexte du code.
En suivant la route, on arrive à un seul handler :
@app.get("/api/invoices/<int:invoice_id>/pdf")
@login_required
def invoice_pdf(invoice_id):
    invoice = Invoice.query.get_or_404(invoice_id)
    return render_pdf(invoice)
La classe de faiblesse est l’absence d’autorisation sur une clé contrôlée par l’utilisateur, CWE-639. L’utilisateur est authentifié. La propriété n’est jamais vérifiée.
Changement rédigé.
Le diff proposé ajoute le contrôle manquant à l’endroit où l’objet est chargé :
 def invoice_pdf(invoice_id):
-    invoice = Invoice.query.get_or_404(invoice_id)
+    invoice = Invoice.query.filter_by(
+        id=invoice_id, account_id=current_user.account_id
+    ).first_or_404()
     return render_pdf(invoice)
Renvoyer 404 au lieu de 403 évite aussi de confirmer que l’autre facture existe.
Tests.
Deux tests accompagnent le changement. Ici, client_a est une fixture du projet : un client de test déjà connecté en tant qu’utilisateur du compte A.
def test_owner_can_download_invoice(client_a, invoice_a):
    assert client_a.get(f"/api/invoices/{invoice_a.id}/pdf").status_code == 200

def test_other_account_cannot_download_invoice(client_a, invoice_b):
    assert client_a.get(f"/api/invoices/{invoice_b.id}/pdf").status_code == 404
Le second test échoue sur l’ancien code et réussit sur le nouveau.
Revue et retest.
La pull request explique la découverte, renvoie vers les preuves, montre le diff et les tests, et soumet une question au relecteur : existe-t-il d’autres routes de facturation, comme l’envoi par e-mail ou l’export, qui chargent les factures de la même façon ?
Le relecteur vérifie, trouve une autre route et demande la même correction à cet endroit.
Après la fusion et le déploiement, les requêtes initiales sont rejouées :
GET /api/invoices/8812/pdf     (account A, owns invoice 8812)    200 OK
GET /api/invoices/8813/pdf     (account A, invoice of account B) 404 Not Found
La découverte est clôturée avec des preuves des deux côtés.
Ce que la remédiation native IA n’est pas
Ce n’est pas un agent disposant d’un accès en écriture à la production.
Ce n’est pas un substitut à la revue de code.
Ce n’est pas la garantie que chaque découverte peut être corrigée automatiquement.
Ce n’est pas une raison de se passer de tests parce que l’IA aurait « compris » le code.
Et ce n’est pas une raison d’arrêter de corriger les causes racines. Si la même faille apparaît chaque semaine, la réponse est une bibliothèque plus sûre ou un meilleur modèle de code, pas un correcteur plus rapide.
La place de Plexicus
Plexicus est construit autour d’une boucle fermée : valider, comprendre, corriger, puis vérifier la correction avant la fusion.
Valider. AI Swarm Pentest explore une application, une API ou du code source autorisés dans un périmètre convenu. Chaque découverte inclut des preuves reproductibles, et si une seconde passe ne parvient pas à reproduire le résultat, la découverte est marquée comme non vérifiée ou écartée.
Comprendre. Deep Code Analysis retrace le chemin de code concerné, afin que les ingénieurs voient les points de terminaison, les paramètres et la logique métier qu’une découverte touche, ainsi que les données qu’elle peut atteindre et le rôle qui peut la déclencher.
Corriger. Plexicus Remediation prend une découverte vérifiée et prépare le contexte de remédiation ainsi qu’un changement suggéré. Le flux concerné, la portée, la classe de faiblesse et la justification sont regroupés dans le changement proposé. Le diff prêt pour la revue explique la découverte initiale en ligne, et des tests de régression et des notes sont inclus lorsque c’est pertinent.
Transmettre. Le changement arrive dans votre dépôt existant avec l’attribution d’un relecteur et un déclencheur de retest relié à la CI, et votre équipe le vérifie avant la fusion. Plexicus mentionne GitHub, GitLab et Bitbucket pour les dépôts. Votre équipe fusionne ou rejette en s’appuyant sur des preuves.
Garder le contrôle. Plexicus ne pousse jamais en production, et votre équipe décide de fusionner ou non. La page AI Swarm Pentest précise que les propositions arrivent sous forme de pull requests ou de fichiers de patch séparés.
Plexicus décrit quatre types de corrections qu’il prépare : les failles introduites lors du développement avec des outils de codage par IA, les découvertes classiques comme l’injection SQL et le cross-site scripting, les failles de logique métier comme les défauts d’autorisation au niveau des objets, et l’exposition de la chaîne d’approvisionnement comme les dépendances victimes de typosquatting, avec épinglage des versions et mise à jour des fichiers de verrouillage.
C’est Proof-Driven AppSec appliqué au dernier kilomètre : une boucle fermée avec PR, où chaque changement porte les preuves qui l’ont produit.
Si vous en êtes à une étape plus précoce, notre guide complet de la sécurité des applications explique la place de la remédiation dans un programme AppSec moderne, et notre article explicatif sur l’analyse approfondie du code montre pourquoi le contexte du code compte avant la rédaction d’une correction. Pour un modèle de correction détaillé, consultez comment automatiser la remédiation de l’injection SQL.
Foire aux questions
Quelle est la différence entre la remédiation native IA et la remédiation automatique ?
La remédiation automatique désigne souvent l’application automatique d’une action prédéfinie, comme un patch ou un changement de configuration. La remédiation native IA rédige un changement de code pour une découverte validée précise et le confie à une personne pour revue avant toute fusion.
La remédiation native IA pousse-t-elle des changements en production ?
Elle ne devrait pas. La sortie est une pull request ou un fichier de patch, relu et fusionné selon votre processus habituel. Plexicus indique ne jamais pousser en production.
L’IA peut-elle corriger correctement des vulnérabilités ?
Parfois, et la recherche montre comment le savoir. Google indique que son pipeline a corrigé 15 % des bugs de sanitizer découverts pendant les tests unitaires, avec une revue humaine. L’étude OSS-Fuzz montre que les patchs doivent être vérifiés en exécutant l’exploit, et non selon leur ressemblance avec une correction connue.
Pourquoi partir de découvertes validées plutôt que des résultats de scanners ?
Parce que chaque découverte non validée qui devient une pull request coûte du temps de revue et peut ne rien corriger. La validation fait de chaque changement un élément qui mérite l’attention d’un relecteur.
Quels tests doivent accompagner un correctif de sécurité ?
Au moins un test qui échoue sur l’ancien code et réussit sur le nouveau, plus un test qui confirme que l’usage légitime fonctionne toujours. Pour les failles de contrôle d’accès, testez à la fois le propriétaire et un autre compte.
La remédiation native IA remplace-t-elle les développeurs ou les ingénieurs sécurité ?
Non. Elle prend en charge les parties répétitives : reproduire, localiser, rédiger et tester. Les personnes décident toujours du comportement correct et de la fusion du changement.
Quelles vulnérabilités sont de bonnes candidates ?
Les failles dont les modèles de correction sont locaux et bien compris, comme l’injection, l’absence de contrôle de propriété et les versions de dépendances vulnérables. Les failles d’architecture exigent généralement un plan, pas un diff automatisé.
Quel est le lien avec le SSDF du NIST ?
Les pratiques Respond to Vulnerabilities du SSDF demandent aux équipes d’analyser chaque vulnérabilité, de mettre en œuvre une réponse, de trouver les causes racines et de rechercher la même faille ailleurs. Un workflow de remédiation native IA est une façon d’accomplir ces tâches à plus grand volume.
Comment mesurer son efficacité ?
Comptez les découvertes clôturées avec un retest réussi, ainsi que le délai entre la validation et la fusion. Le nombre de pull requests ouvertes n’est pas un indicateur utile à lui seul.
Peut-elle corriger du code écrit par des assistants de codage par IA ?
Oui, et ce code en a souvent besoin. Le code généré peut contenir des failles classiques et arriver sans tests ; la correction doit donc ajouter des tests en plus de modifier le code.
Bouclez la boucle avec des preuves
Chaque correction doit prouver que la découverte était réelle, montrer pourquoi le changement fonctionne et montrer que l’attaque a cessé.
Découvrir Plexicus Remediation →
Vous voulez un premier aperçu de votre propre code ? Lancez l’outil SAST gratuit, une analyse statique de votre code source GitHub.