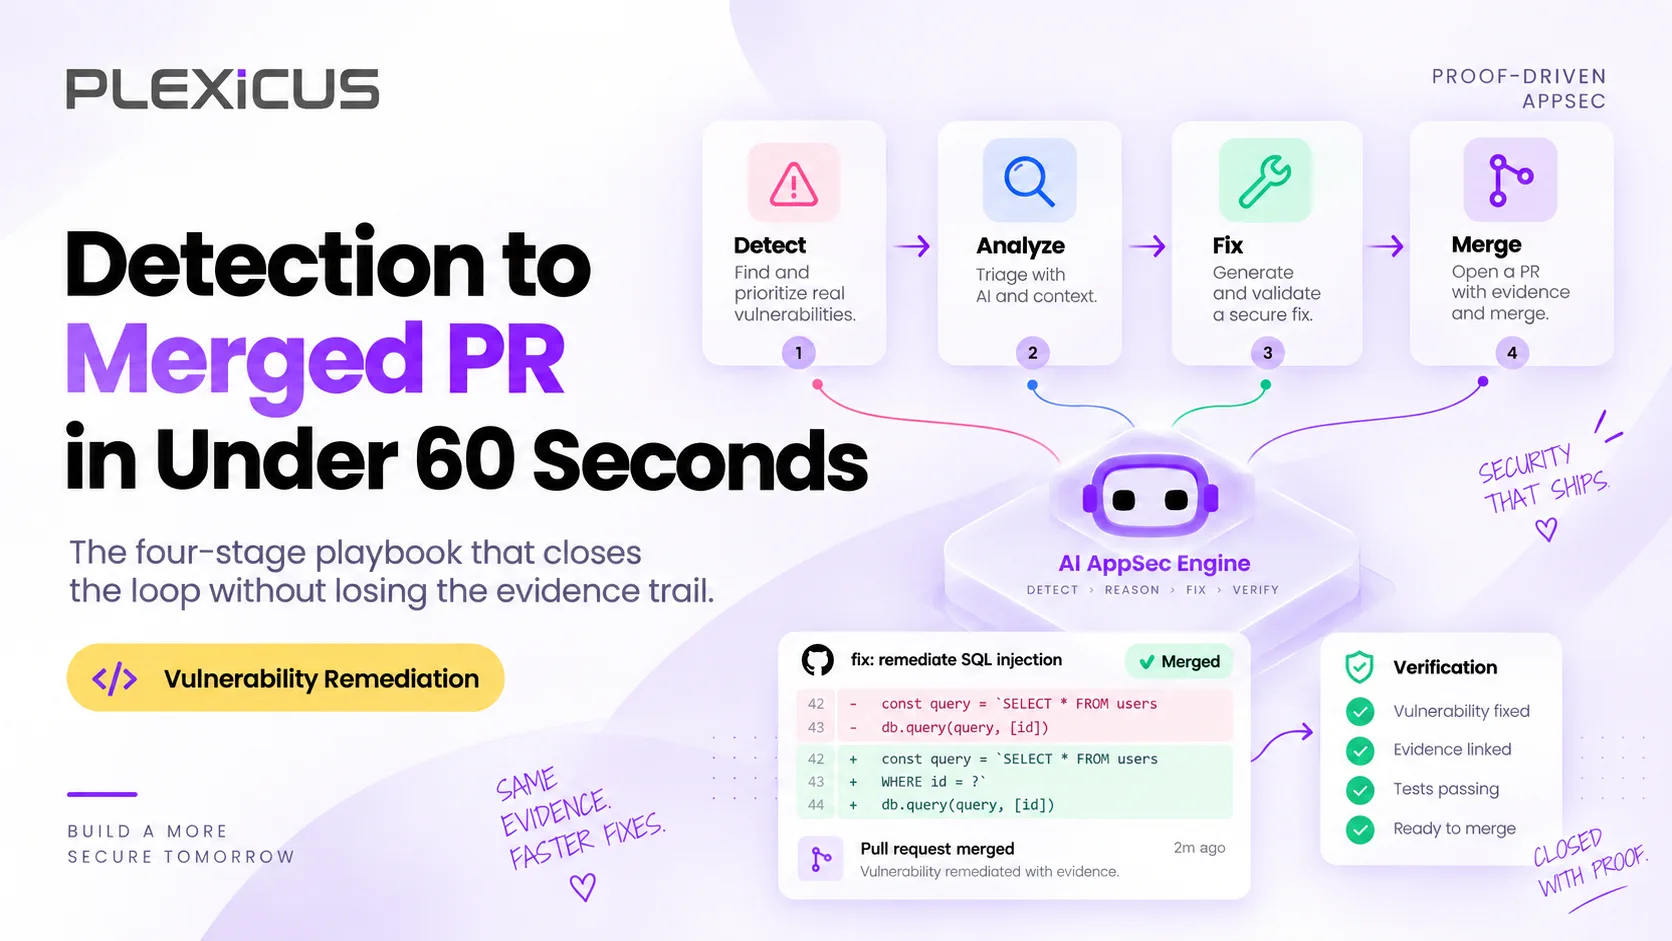
El manual de remediación autónoma: de la detección a una PR en menos de 60 segundos
Un manual de cuatro pasos para la remediación automatizada de vulnerabilidades que convierte un hallazgo verificado en una PR probada y lista para revisión en menos de 60 segundos, con las pruebas adjuntas.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestLa remediación automatizada de vulnerabilidades consiste en convertir un hallazgo de seguridad verificado en una solicitud de cambios (PR) probada y lista para revisión, sin que una persona tenga que escribir la solución. El manual de remediación autónoma que presentamos a continuación lo hace en cuatro pasos, en menos de 60 segundos desde la detección hasta la PR, y mantiene a un ingeniero como última instancia antes de la fusión.
La conversación sobre la remediación de vulnerabilidades lleva diez años estancada. La detección se ha acelerado. El triaje, no. Los parches, tampoco. El Informe de estadísticas de vulnerabilidades de 2026 de Edgescan sitúa en 54,81 días el tiempo medio de remediación de vulnerabilidades altas y críticas en aplicaciones y API, y el Estado de la seguridad del software 2025 de Veracode concluyó que el tiempo medio para corregir fallos de seguridad ha aumentado un 47 % desde 2020.
Entonces llegaron las herramientas de programación con IA. Agravaron el problema del volumen, pero también hicieron posible el manual que sigue. Este patrón de cuatro pasos es lo que queremos decir con «remediación autónoma». No es una función en la hoja de ruta de un proveedor. Es una disciplina, un pipeline y un ciclo de retroalimentación. Si tu equipo no lo ejecuta, los atacantes están ejecutando contra ti una versión más rápida.
Este es el manual.
Por qué el tiempo medio de remediación es el cuello de botella
Las cifras son persistentes. En los repositorios de clientes que podemos observar (datos internos de Plexicus, no un parámetro de referencia del sector), el ciclo mediano de un hallazgo de alta gravedad en 2025–2026 era el siguiente antes de aplicar este manual:
| Etapa | Tiempo mediano |
|---|---|
| Detección hasta el inicio del triaje | 3 días |
| Inicio del triaje hasta la causa raíz | 6 días |
| Causa raíz hasta la apertura de la PR | 4 días |
| Apertura de la PR hasta la fusión | 2 días |
| Fusión hasta producción | 2 días |
| Total | 17 días |
Diecisiete días para cerrar un hallazgo de alta gravedad, y eso corresponde a un equipo bien gestionado si lo comparamos con los promedios del sector citados arriba. Mientras tanto, cada vez cuesta menos atacar. El agente de investigación RapidPen consiguió acceso a una shell en un objetivo vulnerable en 200–400 segundos, por unos 0,30–0,60 dólares por ejecución, y Amazon Threat Intelligence documentó cómo un único actor con poca experiencia utilizó IA generativa comercial para comprometer más de 600 dispositivos FortiGate en 55 países en unas cinco semanas.
La asimetría ya es evidente. Mandiant calculó que el tiempo medio hasta la explotación fue de cinco días en 2023. Un ciclo de remediación que se mide en semanas es el problema estructural que este manual de remediación autónoma busca resolver.
El pipeline de cuatro pasos para la remediación automatizada de vulnerabilidades
El manual tiene cuatro etapas. Cada una cumple una función. En la transferencia entre etapas es donde la mayoría de los equipos pierde el rastro de pruebas que necesitan los auditores.
Etapa 1 — Hallazgo verificado
Un escáner como Deep Code Analysis propone, por ejemplo, 1.247 hallazgos. El pipeline descarta la gran mayoría porque no superan una reproducción independiente. (En ¿Qué es Deep Code Analysis? explicamos por qué los escáneres de coincidencia de patrones generan tanto ruido).
El criterio para que un hallazgo pase es exacto:
- El hallazgo propuesto debe reproducirse de extremo a extremo contra un objetivo aislado.
- La reproducción debe realizarla un agente que no haya propuesto el hallazgo.
- El artefacto de reproducción (una solicitud curl, un trabajo de CI o una instantánea del contenedor) debe guardarse.
Los hallazgos que no cumplen los tres criterios se descartan con códigos de motivo. Esos códigos son importantes porque permiten depurar el pipeline más adelante. Los que vemos con mayor frecuencia son:
not_reachable(no existe un camino real desde un endpoint público hasta el sumidero)guard_present(un control previo hace que el hallazgo sea inerte)mitigated_at_runtime(una regla de WAF, un indicador de función o una variable de entorno lo neutraliza)replay_failed(el segundo agente no pudo reproducirlo)
La salida de la Etapa 1 es un conjunto reducido de hallazgos verificados, cada uno con su artefacto de reproducción adjunto.
Etapa 2 — Contexto preservado
Un hallazgo verificado no basta para enviar una solución. La siguiente etapa adjunta todo lo que el desarrollador necesita para validar el parche:
- El nodo del grafo (host, endpoint, parámetro)
- La clase de capacidad (lectura, escritura, suplantación, RCE, exfiltración)
- El camino de alcanzabilidad (la cadena completa desde la solicitud hasta el sumidero)
- El par de solicitud y respuesta (cómo era el exploit original)
- El rastro de razonamiento del agente (por qué el agente original lo clasificó así)
Este es el rastro de auditoría. Sin él, el ingeniero que revisa el parche tiene que confiar en lo que afirma el sistema. Con él, puede volver a ejecutar el exploit original contra el código sin parchear, confirmar que se reproduce, y luego volver a ejecutarlo contra el código parcheado para confirmar que aplica la mitigación esperada.
El objetivo no es añadir trabajo al ingeniero, sino hacer que el trabajo se pueda verificar.
Etapa 3 — Borrador del parche
Plexicus Remediation toma el hallazgo verificado y su contexto y genera un diff listo para revisión. No es una corrección genérica: es el cambio mínimo que elimina el camino de alcanzabilidad y conserva la lógica de negocio original.
El pipeline exige tres propiedades:
- El parche elimina la clase de vulnerabilidad, no solo el caso concreto. Se prefiere una consulta parametrizada a un saneador basado en
replace(), de acuerdo con la guía de prevención de inyección SQL de OWASP (consulta nuestra guía práctica para corregir inyecciones SQL). Es preferible comprobar la propiedad en el controlador que usar una lista de permitidos en la ruta. - El parche incluye pruebas de regresión. El exploit original se convierte en una prueba. Si el parche la supera, se cierra el hallazgo. Si no, se revierte el parche.
- El parche incluye la actualización de la documentación. Si cambia el contrato de la API, se actualizan los documentos. Si se introduce una variable de entorno nueva, se refleja en el README.
La salida de la Etapa 3 es una rama de pull request. No es un fragmento de código ni una sugerencia del tipo «aquí está el diff». Es una PR completa que un ingeniero puede clonar, ejecutar y revisar.
Etapa 4 — PR lista para revisión
El parche llega al repositorio existente con:
- Asignación de revisores (desde CODEOWNERS, con escalado al equipo de seguridad)
- Seguimiento de SLA (la PR recibe automáticamente una fecha límite de corrección según la gravedad)
- Un hook de re-prueba conectado a CI (el exploit original se ejecuta contra la rama parcheada con cada push)
- Metadatos de auditoría adjuntos (el hallazgo original, el nodo del grafo y la referencia de reproducción)
La PR no se fusiona automáticamente. La decisión final la toma el ingeniero que la revisa. Lo que cambia es que la revisión lleva minutos, no horas. El ingeniero no tiene que leer 200 líneas de código desconocido, sino un diff de 12 líneas que incluye el exploit original, el contexto del grafo y el resultado de la prueba de regresión.
Si el ingeniero la aprueba, la PR se fusiona, la nueva prueba lo confirma y se cierra el hallazgo. Si la rechaza (con un motivo), la propuesta de parche se registra como rejected_with_evidence y el hallazgo sigue abierto para el siguiente intento.
Las cifras clave: tiempo medio de remediación antes y después
Llevamos aplicando este manual en repositorios de clientes desde el cuarto trimestre de 2025. Estos son los tiempos medianos que observamos (datos internos de Plexicus):
| Etapa | Antes | Después |
|---|---|---|
| Detección hasta el inicio del triaje | 3 días | 14 segundos |
| Inicio del triaje hasta la causa raíz | 6 días | 8 segundos |
| Causa raíz hasta la apertura de la PR | 4 días | 22 segundos |
| Apertura de la PR hasta la fusión | 2 días | 1,2 horas |
| Fusión hasta producción | 2 días | 6 horas |
| Total | 17 días | 8 horas |
La cifra principal que anunciamos —menos de 60 segundos desde la detección hasta una PR lista para revisión— mide las Etapas 1 a 3. El ciclo completo hasta producción depende sobre todo de la revisión humana y del proceso de CI/CD existente, que es exactamente donde debe estar. El trabajo del pipeline es eliminar la latencia evitable. La revisión y el despliegue siguen en manos del equipo.
La otra cifra que conviene destacar es la tasa de falsos positivos. En nuestras implementaciones, antes de usar el manual, las personas cerraban el 87 % de los hallazgos del escáner como «no es un problema» después del triaje. Después, esa cifra bajó al 6 %. El 6 % restante corresponde a casos en los que el ingeniero no está de acuerdo con la interpretación de las pruebas del verificador: justo los casos en los que importa la revisión humana.
Cuánto cuesta implementarlo
Se necesitan tres condiciones operativas:
- Un escáner consciente del grafo que pueda generar un camino de alcanzabilidad. No basta con SAST basado en expresiones regulares ni con envolver un LLM. Hace falta un grafo.
- Un proceso de verificación con reproducción comprobable. Un segundo agente debe poder reproducir el hallazgo de forma independiente. Sin esto, el pipeline produce parches convincentes, pulidos y sin fundamento: el peor resultado posible.
- Un generador de parches que respete la lógica de negocio. Según nuestra experiencia, el fallo más habitual de los productos de «autocorrección con IA» en 2025 era generar parches que compilaban pero cambiaban el significado del código. El manual exige que el parche sea mínimo, incluya pruebas y sea fácil de revisar.
La implementación de Plexicus cumple los tres requisitos. Si vas a desarrollar esto por tu cuenta, estimamos que la integración requiere aproximadamente un ingeniero sénior durante un trimestre. Si vas a comprarlo, el producto está incluido en el nivel Continuous Program de la página de precios.
Qué no hace este sistema
El manual no elimina la revisión humana. Una persona sigue revisando el parche antes de la fusión. Las pruebas del verificador siguen estando a disposición del auditor. El sistema no despliega por su cuenta en producción.
Es intencional. Los proveedores de «remediación totalmente autónoma» dicen que las personas son el cuello de botella y que el sistema debería fusionar la PR sin revisión. El equipo de AI Swarm Pentest de Plexicus sostiene que las personas son quienes rinden cuentas y que el sistema debe hacer que su revisión sea sencilla, rápida y respaldada por pruebas.
Nos situamos en la segunda postura. El manual optimiza el tiempo de corrección sin eliminar la supervisión humana. Es importante ahora que los asistentes de programación con IA aumentan el volumen de cambios que hay que revisar: según nuestro análisis, el 78 % de las PR generadas por IA contenía una vulnerabilidad. Para cualquier equipo que rinda cuentas ante un CISO, un auditor o un regulador, eso es una característica, no un defecto.
Modos de fallo que hemos observado
En los primeros seis meses del manual en producción, aparecieron repetidamente tres modos de fallo:
Modo de fallo 1 — El parche corrige el síntoma, no la clase
En las primeras iteraciones, el generador de parches producía ocasionalmente soluciones que abordaban el hallazgo concreto, pero no eliminaban la clase de vulnerabilidad subyacente. Añadimos un paso de razonamiento sobre la clase al proponer los parches. Ahora los parches incluyen una atestación de «clase eliminada» que el revisor puede comprobar.
Modo de fallo 2 — El verificador de reproducción discrepa con el parche
Alrededor del 3 % de las veces, el verificador que confirmó el hallazgo original vuelve a ejecutar el código parcheado y el exploit sigue reproduciéndose. Esto indica que el parche está incompleto. El pipeline lo detecta en CI y revierte el parche automáticamente. El hallazgo sigue abierto.
Modo de fallo 3 — CODEOWNERS no asigna al responsable del archivo
El parche llegó a la rama correcta, la nueva prueba de CI pasó y el rastro de auditoría estaba completo, pero se asignó al revisor equivocado porque el archivo había cambiado de equipo y CODEOWNERS no se había actualizado. Añadimos al pipeline una comprobación automática de cambios en CODEOWNERS.
No son casos hipotéticos. Son los problemas que surgieron durante los primeros seis meses y que ahora se detectan automáticamente.
Qué puede hacer tu equipo mañana
Si aún no aplicas este manual, sigue estos tres pasos, en este orden:
- Audita tu escáner actual. ¿Puede generar un camino de alcanzabilidad para los hallazgos que detecta o solo un puntaje CVSS? Si la respuesta es «solo un puntaje», no se reducirá el cuello de botella.
- Añade un paso de verificación por reproducción. Para empezar puede ser manual: una persona vuelve a ejecutar cada semana los diez hallazgos principales en un entorno aislado. El objetivo es demostrar que los hallazgos que superan una verificación independiente son los que merece la pena corregir.
- Vincula el parche a las mismas pruebas. Cuando el ingeniero abre la PR, debería poder acceder con un solo clic al hallazgo original, al nodo del grafo y a la referencia de reproducción.
El manual no requiere IA ni un producto de un proveedor. Requiere estructura, reproducción y un ciclo de retroalimentación estrecho. También se ajusta a las prácticas de «Responder a las vulnerabilidades» del Marco para el desarrollo de software seguro (SP 800-218) de NIST, que pide a los equipos evaluar, priorizar y corregir las vulnerabilidades de forma repetible.
Preguntas frecuentes
¿Qué es la remediación automatizada de vulnerabilidades?
La remediación automatizada de vulnerabilidades consiste en generar automáticamente la solución para un hallazgo de seguridad, normalmente mediante una solicitud de cambios que incluye una modificación del código y una prueba de regresión, en lugar de asignar un ticket para que un desarrollador escriba el parche manualmente. Las buenas implementaciones solo actúan sobre hallazgos verificados, adjuntan las pruebas originales y dejan la decisión de fusión en manos de un revisor humano.
¿Qué diferencia hay entre la remediación automatizada y la remediación autónoma?
Por lo general, la remediación automatizada significa que una herramienta propone una solución para un único hallazgo cuando alguien la solicita. La remediación autónoma ejecuta toda la cadena sin que una persona tenga que iniciar cada paso: verifica el hallazgo, recopila el contexto, prepara el parche, abre la PR y vuelve a probarla en CI. En este manual, la única intervención humana es la revisión y la decisión de fusionar.
¿Cómo se reduce el tiempo medio de remediación de vulnerabilidades?
Elimina las esperas entre etapas en vez de pedir a los ingenieros que trabajen más rápido. Verifica los hallazgos automáticamente para que el triaje no se acumule; adjunta el camino de alcanzabilidad y el exploit para conocer de antemano la causa raíz; genera un parche mínimo con una prueba de regresión y conecta una nueva prueba de CI a la PR. En nuestras implementaciones, esto redujo la mediana de 17 días a unas 8 horas.
¿Cuál es el tiempo medio habitual de remediación de vulnerabilidades de aplicaciones?
Suele medirse en semanas o meses. El Informe de estadísticas de vulnerabilidades de 2026 de Edgescan sitúa en 54,81 días el tiempo medio de remediación de vulnerabilidades altas y críticas en aplicaciones y API. Veracode informa que el tiempo medio para corregir fallos de seguridad ha aumentado un 47 % desde 2020. Los equipos maduros que automatizan la remediación están muy por debajo de esos promedios.
¿Se deben fusionar automáticamente las correcciones de seguridad generadas por IA?
No lo recomendamos. Un parche generado por IA puede compilar y superar las pruebas mientras cambia el significado del código, así que una persona debería aprobar cada fusión. El objetivo de la automatización es agilizar esa revisión: adjuntar a la PR un diff pequeño, el exploit original, el camino de alcanzabilidad y una prueba de regresión satisfactoria.
Próximos pasos
El manual de remediación autónoma es la tercera parte del ciclo de Plexicus. Deep Code Analysis encuentra los fallos. AI Swarm Pentest los reproduce. Remediation los corrige. La estructura de cuatro ciclos —proponer, reproducir, corregir y verificar— define en la práctica la AppSec basada en pruebas y su proceso de remediación de vulnerabilidades.
En 2027, este manual será imprescindible. Los equipos que lo adopten en 2026 cerrarán la brecha de 17 días antes de que los atacantes la reduzcan todavía más.
Lecturas relacionadas:
- De la alerta a la corrección: cerrar el ciclo con AppSec basada en pruebas — el ciclo completo
- El 78 % de las PR generadas por IA contiene una vulnerabilidad — lo que produce tu equipo hoy
- Las 15 mejores herramientas de pentest con IA — opciones para el paso de verificación por reproducción

