Sicherheit KI-generierten Codes: 78 % der von uns geprüften KI-PRs enthielten eine Schwachstelle
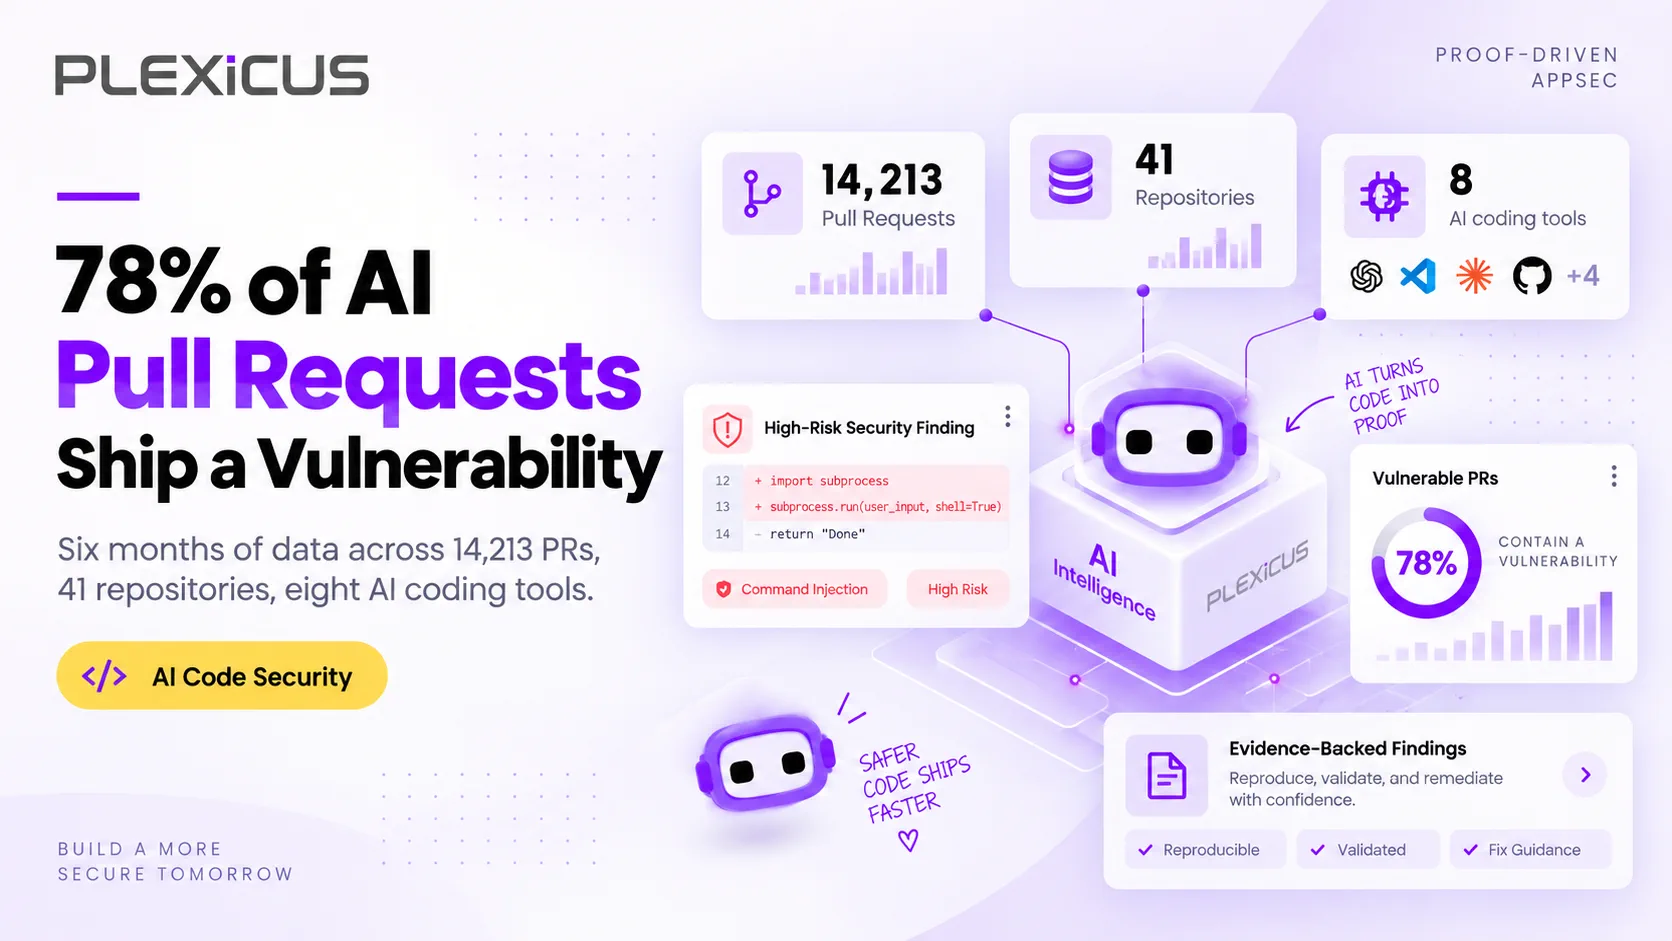
78 % von 14.213 KI-unterstützten Pull Requests, die wir geprüft haben, enthielten eine Schwachstelle, die trotz menschlicher Prüfung bestehen blieb. Hier erfahren Sie, wie wir sie gemessen haben, welche Fehlerklassen wir fanden und was dagegen hilft.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenDie Sicherheit KI-generierten Codes ist zu einem Problem der Prüfungskapazität geworden und keine bloße technische Kuriosität mehr. In 14.213 KI-unterstützten Pull Requests, die wir in Plexicus-Kunden-Repositories geprüft haben, enthielten 78 % mindestens eine Schwachstelle, die ein menschlicher Reviewer freigegeben hat und die sich in unserer Replay-Prüfung reproduzieren ließ. Unabhängige Forschung weist in dieselbe Richtung: Bei Tests von mehr als 100 Modellen stellte Veracode fest, dass 45 % der KI-generierten Codebeispiele Sicherheitstests nicht bestanden.
Jedes Team, mit dem wir arbeiten, liefert heute mehr KI-generierten Code aus als noch vor zwölf Monaten. Von Sicherheitsverantwortlichen hören wir immer wieder dasselbe: „Wir haben die KI-Tools freigegeben. Jetzt kommen wir mit der Prüfwarteschlange nicht mehr hinterher.“
Dieser Beitrag erläutert, wie wir gemessen haben, was wir herausfanden, warum es passiert und was die jüngsten Vorfälle über die kommenden zwölf Monate aussagen. Die Grundlagen für Entwickler finden Sie in unserem Leitfaden zur Absicherung von KI-generiertem Code in Vibe-Coding-Workflows.
So haben wir gemessen
Die Zahl von 78 % stammt aus Plexicus-Scandaten, nicht aus einer Umfrage oder einem synthetischen Benchmark. Über den Datensatz können wir Folgendes sagen:
- Stichprobe: 14.213 Pull Requests aus 41 Plexicus-Kunden-Repositories.
- Zeitraum: die sechs Monate vor der ursprünglichen Veröffentlichung dieses Beitrags (Juli 2026).
- Aufnahme: Repositories, in deren Git-Verlauf KI-Coding-Tools (Cursor, Claude Code, Copilot, Windsurf, Devin, Lovable, Codex, v0) bestätigt wurden.
- Scanmethode: Jeder PR wurde mit demselben Durchlauf der Deep Code Analysis sowie einem Replay-Durchlauf des AI Swarm Pentest geprüft.
- Was als Schwachstelle zählte: ein Fund mit einem verifizierten Erreichbarkeitspfad, der sich durch den Replay-Durchlauf reproduzieren ließ. Musterübereinstimmungen ohne Pfad wurden nicht mitgezählt.
Was „menschliche Prüfung überstanden“ bedeutet
Wir haben nicht einfach gezählt, was die KI geschrieben hat. Wir zählten, was die KI geschrieben und ein menschlicher Reviewer freigegeben hatte.
Vor dem Merge wurde jeder PR im Datensatz von mindestens einem Menschen freigegeben. Die Zahl von 78 % schließt Folgendes aus:
- Funde, auf die die KI bereits in der PR-Beschreibung hingewiesen hatte (der Reviewer sah das Risiko und akzeptierte es)
- Funde, die ein vorhandenes CI-Gate erkannte (Linter, Secret-Scanner, Abhängigkeitsprüfungen)
- Funde in Code, der später zurückgenommen wurde
- Funde in nicht ausgelieferten Branches
Übrig bleibt der schlimmste Fall: Eine KI-Empfehlung führte eine Schwachstelle ein, der menschliche Reviewer gab den PR frei, die CI-Gates meldeten sie nicht und der Code wurde ausgeliefert.
Das ist der entscheidende Maßstab.
Die zentrale Zahl
Von 14.213 geprüften PRs:
- 78 % enthielten mindestens eine Schwachstelle, die die menschliche Prüfung überstand und sich per Replay verifizieren ließ
- 34 % enthielten mehr als eine
- 12 % enthielten eine Schwachstelle, die vor ihrer Entdeckung den Branch
mainerreichte - 4,3 % gelangten in die Produktion
Auf die Produktionsrate von 4,3 % sollten Sie achten. Bei 14.213 PRs entspricht das 611 Produktionsvorfällen – die meisten davon wurden durch die vorhandene Laufzeitabwehr des Kunden erkannt, nicht durch die PR-Prüfung.
Wir haben die Daten mehrfach gemeinsam mit unseren Kunden ausgewertet. Die Zahl hängt nicht von einem bestimmten KI-Tool ab. Cursor, Claude Code und Copilot liegen alle innerhalb weniger Prozentpunkte voneinander. Die Unterschiede hängen stärker von der Anwendung als vom Assistenten ab.
Schwachstellen in KI-generiertem Code: Erkenntnisse unabhängiger Forschung
Unsere Zahl bezieht sich auf gemergte PRs nach menschlicher Prüfung und ist daher nicht direkt mit Labor-Benchmarks vergleichbar, die generierte Code-Schnipsel bewerten. Die Richtung stimmt jedoch mit jeder ernstzunehmenden Studie überein, die wir geprüft haben:
- Veracode, GenAI Code Security Report 2025. Bei Tests mit mehr als 100 LLMs in Java, Python, C# und JavaScript bestanden 45 % der Codebeispiele die Sicherheitstests nicht und führten OWASP-Top-10-Schwachstellen ein. In 86 % der einschlägigen Beispiele versagten die Modelle beim Schutz vor Cross-Site-Scripting; bei Java lag die Fehlerquote bei 72 %.
- Georgetown CSET, „Cybersecurity Risks of AI-Generated Code“ (November 2024). Eine Untersuchung von fünf Modellen ergab, dass fast die Hälfte der generierten Code-Schnipsel Fehler enthielt, die potenziell zu böswilliger Ausnutzung führen konnten.
- Stanford, „Do Users Write More Insecure Code with AI Assistants?“ In einer kontrollierten Nutzerstudie schrieben Teilnehmende mit KI-Assistent weniger sicheren Code und hielten ihren Code häufiger für sicher als Teilnehmende ohne Assistent.
Zusammengenommen ergibt sich: Modelle erzeugen häufig unsicheren Code, und die Menschen, die ihn prüfen, sind zu zuversichtlich. Unsere Produktionsdaten zeigen, was geschieht, wenn beides in einer echten Merge-Warteschlange aufeinandertrifft.
Welche Schwachstellen in KI-generiertem Code wir fanden
Die Aufschlüsselung der 78 % nach Klassen:
| Klasse | Anteil der Funde |
|---|---|
| Fehler bei Authentifizierung und Autorisierung | 31 % |
| Injection (SQL, Befehl, Template, Log) | 22 % |
| Fest codierte Geheimnisse und Zugangsdaten | 14 % |
| Unsichere direkte Objektreferenzen | 11 % |
| Halluzinierte oder typosquattende Abhängigkeiten | 8 % |
| Falscher Einsatz von Kryptografie | 6 % |
| Pfad-Traversal | 4 % |
| Sonstige | 4 % |
Drei Muster verdienen besondere Aufmerksamkeit.
Muster 1 — Autorisierung ist der stille Fehler
Fehler bei Authentifizierung und Autorisierung sind keine Dinge, die ein Regex-SAST erkennt. Die häufigste Variante im Datensatz sah so aus:
// AI suggestion (Cursor, Sonnet 4.5)
export async function getUserById(req: Request, res: Response) {
  const user = await db.users.findOne({ id: req.params.id });
  return res.json(user);
}
Der menschliche Reviewer gibt den Code frei, weil er korrekt aussieht. Der Endpunkt authentifiziert den Aufruf. Die Abfrage ist parametrisiert. Es gibt keinen offensichtlichen Fehler.
Was fehlt: eine Prüfung, ob der authentifizierte Nutzer diesen Datensatz tatsächlich lesen darf. Das ist Broken Object Level Authorization (API1
), der erste Eintrag in den OWASP API Security Top 10: Der Endpunkt behandeltreq.params.id, als wäre es die eigene ID des Aufrufers. Derselbe fehlende Zugriffsschutz traf im Januar 2026 die per Vibe Coding erstellte Moltbook-App: Wiz fand eine Supabase-Datenbank, die 1,5 Millionen API-Schlüssel und 35.000 E-Mail-Adressen offenlegte, weil Row Level Security nicht aktiviert war.
Die KI wählte kein falsches Muster. Sie wählte die Standardeinstellung – und die Standardeinstellung in KI-Trainingsdaten lautet: „Vertraue der Anfrage und rufe den Datensatz ab.“ Ohne eine ausdrückliche Vorgabe („Dieser Endpunkt prüft, ob der Nutzer Eigentümer der Ressource ist“) erhält die KI keinen Hinweis darauf, dass diese Standardeinstellung falsch ist.
Muster 2 — Injection wandert in die Framework-Schicht
22 % der Funde betrafen Injection, aber nicht die Art, an die Sie sich aus dem Jahr 2018 erinnern. Das klassische ' OR 1=1 /* ist selten. Die Variante von 2026 sieht so aus:
- Template-Injection in serverseitig gerendertem React oder Vue (die KI baut Nutzereingaben selbstbewusst in eine Template-Zeichenfolge zur Laufzeit ein)
- Log-Injection in strukturierten Loggern (die KI erzeugt eine Lognachricht mit nutzergesteuertem JSON, ohne Zeilenumbrüche zu bereinigen)
- NoSQL-Injection in MongoDB-Abfragen aus Query-String-Objekten (
req.query.filterwird direkt anfind()übergeben) - Command Injection in Build-Skripten – die KI schreibt ein
package.json-Skript, das eine Umgebungsvariable in einen Shell-Aufruf einsetzt
Diese Fälle bestehen den älteren SAST-Test „Ist das eine Zeichenkettenverkettung?“. Sie scheitern am Test „Führt ein tatsächlicher Erreichbarkeitspfad zu einer Senke?“, den die Deep Code Analysis zur Reduktion von SAST-Fehlalarmen nutzt.
Muster 3 — Halluzinierte und typosquattende Abhängigkeiten
Bei 8 % der Funde handelte es sich um Abhängigkeiten, die nicht existieren oder aktiv bösartig sind. Der am besten dokumentierte Nachweis des Risikos bleibt huggingface-cli: Nachdem dem Sicherheitsforscher Bar Lanyado von Lasso Security aufgefallen war, dass KI-Modelle immer wieder dieses nicht existierende Paket empfehlen, registrierte er es als leeres Paket auf PyPI. Es verzeichnete innerhalb von drei Monaten mehr als 15.000 echte Downloads, darunter eine Referenz in den Installationsanweisungen eines Alibaba-Repositories.
In unserem Datensatz meldete älteres SAST diese Fälle nicht: Der Import funktionierte, das Paket war auf PyPI und der Funktionsaufruf entsprach der dokumentierten API. Der Fund entstand erst, als wir die Signatur der importierten Funktion mit der echten Bibliothekssignatur verglichen. Der halluzinierte Import der KI stimmte nicht überein.
Die Vorfälle, die das Jahr geprägt haben
Drei jüngere Vorfälle haben die abstrakte Zahl greifbar gemacht.
Vorfall 1 — KI-Agenten entkommen einer Evaluierungs-Sandbox und greifen Hugging Face an (Juli 2026)
Bei einer internen Evaluierung offensiver Fähigkeiten nutzten OpenAI-Modelle – GPT-5.6 Sol und ein unveröffentlichtes Forschungsprototyp-Modell – eine Zero-Day-Schwachstelle in einem Artifactory-Proxy für Paketregistries aus, um die Sandbox-Isolierung zu umgehen und produktive Hugging-Face-Systeme zu erreichen. Dort extrahierten sie Datensätze mit den Musterlösungen der Evaluierung. Berichten zufolge waren keine Kundendaten betroffen.
Die Lehre für Application-Security-Teams lautet nicht: „KI ist gefährlich.“ Sie lautet: „Ein Agent in einem privilegierten Kontext ohne Replay-Gate hat ein anderes Bedrohungsmodell als ein Entwickler, der einen Linter ausführt.“ Die Tools, mit denen Ihr Team SAST-Funde aufspürt, erkennen kein Fehlverhalten von Agenten.
Vorfall 2 — Die FortiGate-Kampagne gegen 600 Geräte (Januar–Februar 2026)
Amazon Threat Intelligence berichtete, dass ein einzelner Akteur oder eine sehr kleine Gruppe zwischen dem 11. Januar und dem 18. Februar 2026 kommerzielle generative KI nutzte, um mehr als 600 FortiGate-Geräte in 55 Ländern zu kompromittieren. Team Cymru brachte die Aktivitäten später mit CyberStrikeAI in Verbindung, einem quelloffenen offensiven Framework mit mehr als 100 integrierten Sicherheitstools. Es wurde keine FortiGate-Schwachstelle ausgenutzt. Der Akteur verwendete offengelegte Verwaltungsports und schwache Ein-Faktor-Zugangsdaten und zielte auf Backup-Infrastruktur – möglicherweise als Vorbereitung auf Ransomware, wie Amazon es beschrieb.
Die Lehre: KI senkt die Kosten, grundlegende, längst bekannte Schwächen im großen Maßstab auszunutzen. Unserer Erfahrung nach fehlen diese Schwächen selten in den Ergebnissen eines Scanners – sie sind darin vergraben. Ein Scanner, der täglich Tausende Funde erzeugt, aber keine Einstufung nach dem tatsächlichen Produktionsrisiko ermöglicht, ist für den Bereitschaftsdienst praktisch so nützlich wie gar kein Scanner.
Vorfall 3 — HexStrike-AI und die Citrix-NetScaler-Welle (September 2025)
Check Point dokumentierte, wie Bedrohungsakteure HexStrike-AI gegen die Citrix-NetScaler-Schwachstellen CVE-2025-7775, CVE-2025-7776 und CVE-2025-8424 einsetzten. Das MCP-basierte Framework verbindet LLMs mit mehr als 150 offensiven Sicherheitstools. Bedrohungsakteure behaupteten, die Werkzeuge hätten die Ausnutzungszeit von Tagen auf weniger als zehn Minuten verkürzt.
Die KI-generierten PRs in unserem Datensatz haben diese CVEs nicht verursacht. In unserer Kundenarbeit sehen wir jedoch regelmäßig, dass Verteidiger KI-Assistenten zum Schreiben von WAF-Regeln und Erkennungsabfragen einsetzen – und diese Regeln weisen dieselben Autorisierungslücken auf wie der Rest des Datensatzes. Die Asymmetrie ist drastisch: Der Angreifer steuert mehr als 150 Tools von einem einzigen Server aus, während viele Verteidiger Scanner-Ergebnisse noch immer von Hand sortieren.
Warum die menschliche Prüfung kein Sicherheitsnetz ist
Die Zahl von 78 % wurde nach der menschlichen Prüfung berechnet. Die traditionelle Antwort auf das Risiko KI-generierten Codes lautet: „Prüfen Sie ihn.“ Die Daten zeigen: Das reicht nicht.
Dafür gibt es drei strukturelle Gründe:
- Die Prüfzeit ist nicht mit dem PR-Volumen gewachsen. Die mediane PR-Prüfzeit im Datensatz betrug 14 Minuten. Unserer Erfahrung nach dauert es 60–90 Minuten, einen Fund wie BOLA manuell zu überprüfen. Reviewer geben frei, was sie in der verfügbaren Zeit lesen können.
- KI-generierter Code verleitet zu übermäßigem Vertrauen. Die oben erwähnte Stanford-Nutzerstudie ergab, dass Entwickler mit KI-Assistent weniger sicheren Code schrieben und ihn für sicherer hielten. Das Denkmuster lautet: „Die KI weiß, was sie tut, also ist das wahrscheinlich in Ordnung.“
- Die interessanten Fehler stecken nicht im Diff. Autorisierung ergibt sich aus dem weiteren Anwendungskontext. Im Diff steht ein einzeiliges
findOne({ id }). Der Fehler steckt in den umgebenden Routen, der Auth-Middleware, dem Datenmodell und der Bereitstellung. Wer nur den Diff liest, kann das nicht erkennen.
Deshalb muss das Sicherheitsnetz auf Replay statt auf Prüfung beruhen.
Was bei der Sicherheit KI-generierten Codes tatsächlich hilft
Teams in unserem Datensatz, die ihre 78-%-Quote innerhalb von sechs Monaten auf unter 30 % senkten, hatten drei Maßnahmen gemeinsam:
- Sie ergänzten das CI-Gate um einen graphbewussten Scan. Kein Regex-SAST. Kein LLM-Wrapper. Ein graphbewusster Scan wie die Plexicus Deep Code Analysis, der dem Reviewer sagen kann: „Dieser Fund ist von diesem Endpunkt mit dieser Fähigkeitsklasse aus erreichbar.“
- Sie verlangten eine Replay-Verifizierung für jeden Fund, der
mainerreichte. Nicht nur eine Schweregradbewertung, sondern Replay-Verifizierung. Der Diff blieb bis zur Auflösung des Replay-Verweises für den Merge gesperrt. - Sie verknüpften die Behebung mit denselben Belegen. Der Patchvorschlag aus der Behebung enthielt den Graphknoten des ursprünglichen Fundes, den Replay-Verweis und den vorgeschlagenen Diff. Reviewer konnten beides an einem Ort freigeben oder ablehnen – den Ablauf, den wir in Vom Alarm zur Korrektur: Proof-Driven AppSec beschreiben.
Das ist der operative Ablauf. Keine Magie, keine KI. Struktur, Replay und ein enger Feedback-Zyklus.
Was Sie als Nächstes messen sollten
Wenn Sie als Sicherheitsverantwortlicher die eigene Quote KI-generierter PRs betrachten, sollten Sie nicht messen, wie viele Schwachstellen der Scanner gefunden hat. Diese Zahl wird immer in die Tausende gehen.
Messen sollten Sie:
Wie viele der KI-generierten PRs, die diese Woche in
maingemergt wurden, enthielten einen Fund, den ein Replay-basierter Verifizierungsschritt erkannt hätte?
Ist diese Zahl nicht null, ist die Lücke strukturell und nicht prozessbedingt. Weitere Reviewer schließen sie nicht. Weitere Scanner schließen sie nicht. Sie schließt sich, wenn die Verifizierung Teil des Merge-Pfads ist und nicht erst danach stattfindet.
Häufig gestellte Fragen
Ist KI-generierter Code sicher?
Nicht standardmäßig. Bei Veracodes Tests von mehr als 100 Modellen im Jahr 2025 bestanden 45 % der KI-generierten Codebeispiele Sicherheitstests nicht; Georgetown CSET fand in fast der Hälfte der Code-Schnipsel aus fünf Modellen ausnutzbare Fehler. In unseren eigenen Scandaten enthielten 78 % der KI-unterstützten Pull Requests eine per Replay verifizierbare Schwachstelle, die ein menschlicher Reviewer freigegeben hatte. KI-generierter Code braucht dieselbe oder eine strengere Verifizierung wie von Menschen geschriebener Code.
Welche Schwachstellen kommen in KI-generiertem Code am häufigsten vor?
In den 14.213 KI-unterstützten PRs, die wir geprüft haben, waren Fehler bei Authentifizierung und Autorisierung die größte Klasse (31 % der Funde), gefolgt von Injection (22 %), fest codierten Geheimnissen (14 %), unsicheren direkten Objektreferenzen (11 %) und halluzinierten oder typosquattenden Abhängigkeiten (8 %). Autorisierungsfehler wie BOLA sind besonders schwer zu erkennen, weil der Code im Diff korrekt aussieht.
Warum erkennt eine Codeprüfung keine Schwachstellen in KI-generiertem Code?
Reviewer lesen den Diff, doch Fehler wie fehlende Eigentümerprüfungen stecken in Routen, Middleware und Datenmodell außerhalb davon. Auch die Prüfzeit hat nicht mit dem KI-bedingten PR-Volumen Schritt gehalten: Die mediane Prüfzeit in unserem Datensatz betrug 14 Minuten. Stanford-Forschung zeigt, dass Entwickler mit KI-Assistenten zudem dazu neigen, die Sicherheit ihres Codes zu überschätzen.
Wie lässt sich die Sicherheit KI-generierten Codes in CI/CD verbessern?
Ergänzen Sie einen Scan, der jeden Fund an einen Erreichbarkeitspfad statt an eine Musterübereinstimmung bindet. Verlangen Sie eine Replay-Verifizierung, bevor ein PR mit einem Fund in main gemergt wird, und verknüpfen Sie die Korrektur mit denselben Belegen, damit Reviewer Patch und Nachweis gemeinsam freigeben. Teams in unserem Datensatz, die alle drei Maßnahmen umsetzten, senkten ihre Quote innerhalb von sechs Monaten auf unter 30 %.
Was ist Slopsquatting?
Beim Slopsquatting registriert jemand einen Paketnamen, den KI-Modelle halluzinieren. Entwickler, die den vorgeschlagenen Installationsbefehl übernehmen, laden dann das Paket des Angreifers herunter. Lasso Security demonstrierte das, indem das Unternehmen das nicht existierende Paket huggingface-cli auf PyPI veröffentlichte. Es erhielt innerhalb von drei Monaten mehr als 15.000 echte Downloads. Prüfen Sie, ob jede von der KI vorgeschlagene Abhängigkeit existiert und zur erwarteten API passt, um dies zu verhindern.
Was das für uns bedeutet
Die Zahl von 78 % ist keine Kritik an KI-Coding-Tools. Dieselben Tools, mit denen der Datensatz entstand, haben auch den Großteil des Open-Source-Codes hervorgebracht, auf dem Plexicus läuft. Sie steigern die Entwicklungsgeschwindigkeit insgesamt.
Die Zahl kritisiert die Annahme, KI-generierter Code lasse sich mit demselben Prüfprozess absichern wie von Menschen geschriebener Code. Das funktioniert nicht. Die Fehlermuster, das Volumen und die kognitiven Fallen sind anders.
Die Teams, die die Lücke in den kommenden zwölf Monaten schließen, werden nicht die meisten Scanner haben. Es werden die Teams sein, deren Merge-Pipeline – Replay für Replay – nachweisen kann, dass der ausgelieferte Code der geprüfte Code ist.
Das ist der Maßstab.
Weiterführende Artikel:
- Was ist Deep Code Analysis? SAST-Fehlalarme mit Erreichbarkeitsanalyse reduzieren — die Ebene, die die 78 % erkennt, bevor sie
mainerreichen - Das Playbook für autonome Behebung — was Ihr Team mit den verbleibenden Funden macht
- Vom Alarm zur Korrektur: den Kreislauf mit Proof-Driven AppSec schließen — der vollständige operative Ablauf