Framework MAESTRO: guia prático de 7 camadas para modelagem de ameaças em IA agêntica
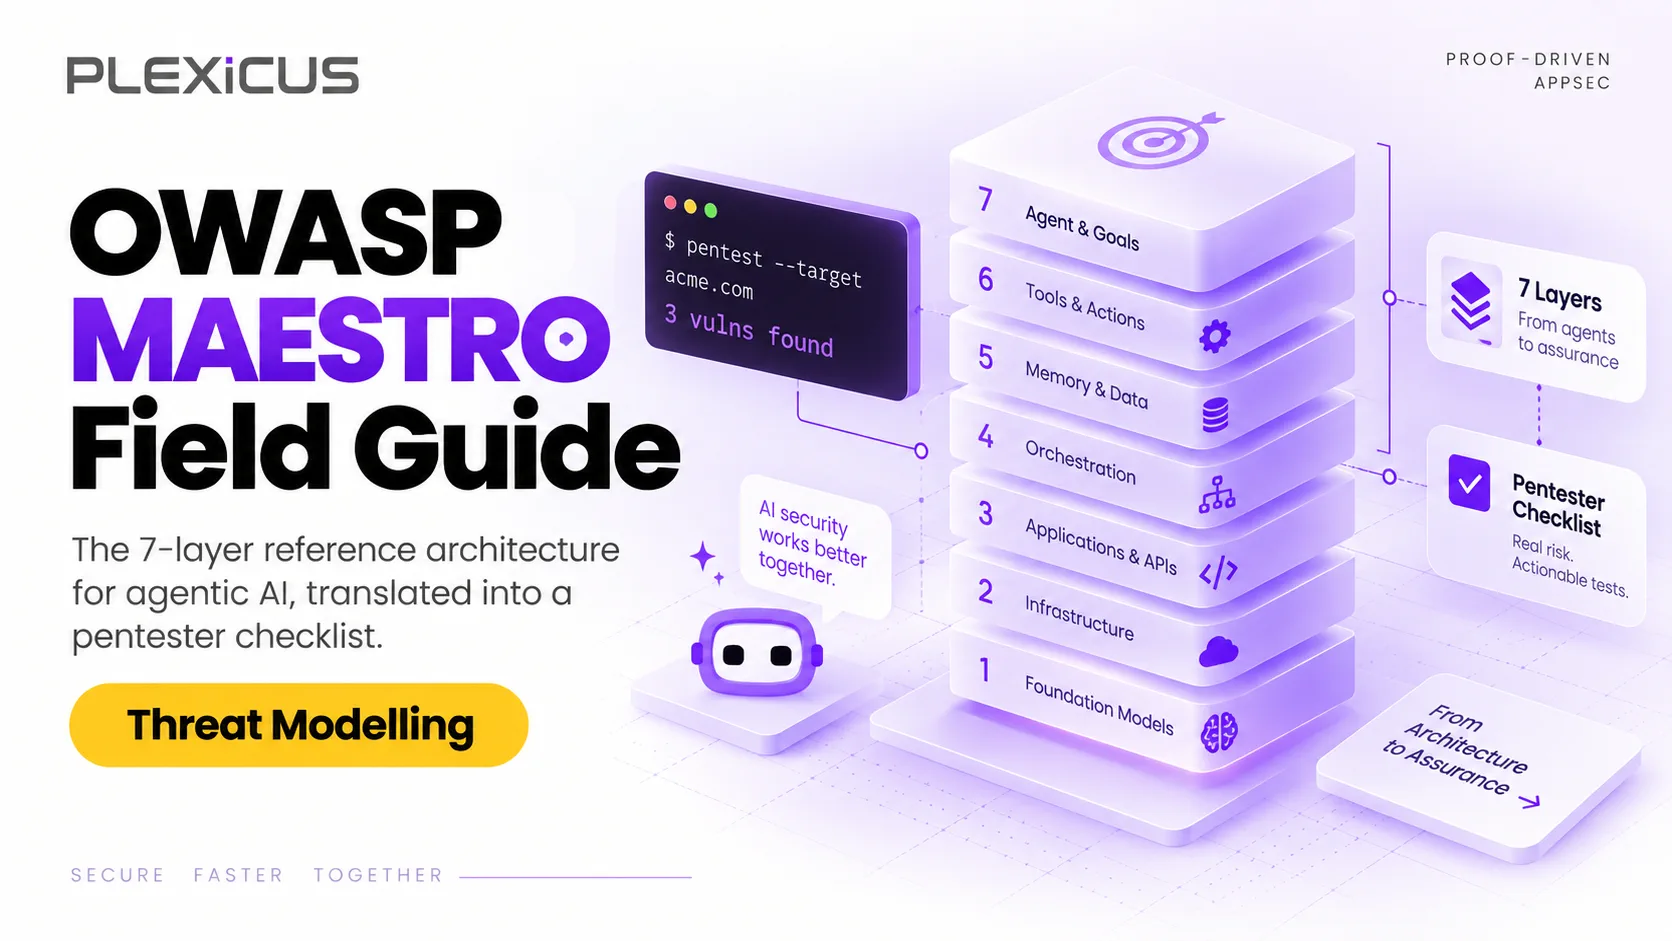
MAESTRO é o framework de 7 camadas da Cloud Security Alliance para modelagem de ameaças em IA agêntica, aplicado pelo OWASP GenAI Security Project. Este guia transforma cada camada em uma lista de verificação para pentests.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestO framework MAESTRO (Multi-Agent Environment, Security, Threat, Risk, and Outcome) é um método de modelagem de ameaças em sete camadas para sistemas de IA agêntica. Ken Huang o apresentou por meio da Cloud Security Alliance em fevereiro de 2025, e o Multi-Agentic System Threat Modeling Guide do OWASP GenAI Security Project (abril de 2025) foi desenvolvido com base nele. Por isso, muitas equipes o chamam de “OWASP MAESTRO”. Este guia prático transforma cada camada do MAESTRO em uma lista de verificação para pentesters.
Todos os frameworks de modelagem de ameaças usados até agora pela sua equipe de segurança foram criados para softwares escritos por pessoas. O STRIDE aborda ameaças clássicas a aplicações. O PASTA é um processo centrado em riscos e baseado em simulação de ataques. O LINDDUN cobre ameaças à privacidade. O OCTAVE trata de riscos organizacionais. O Trike e o VAST se concentram em ampliar a modelagem de ameaças entre equipes.
Nenhum deles modela a superfície de ameaças de um agente. Nenhum tem uma camada para “os dados de treinamento do modelo foram envenenados”. Nenhum tem uma camada para “a descrição da ferramenta do agente foi reescrita depois da aprovação”. Nenhum tem uma camada para “o rastro de raciocínio do agente divergiu do objetivo declarado”.
O MAESTRO foi criado para preencher essa lacuna. Em vez de descartar os métodos antigos, os autores da CSA ampliam categorias do STRIDE, PASTA e LINDDUN com ameaças específicas de IA e as organizam camada por camada. O restante deste guia apresenta padrões de ataque concretos, sinais de detecção e mitigações para cada camada.
O que é o framework MAESTRO?
O MAESTRO é uma arquitetura de referência de 7 camadas para segurança de IA agêntica. Ele preserva os aspectos úteis de STRIDE e PASTA, mas modela a superfície de ameaças de baixo para cima, considerando o que surge quando um agente de IA tem:
- Memória persistente
- Recursos de chamada de ferramentas (muitas vezes por MCP)
- Um ciclo de raciocínio em várias etapas
- Capacidade de agir em sistemas externos
As sete camadas, de baixo para cima:
- Foundation Models — os LLMs que dão suporte ao agente
- Data Operations — os pipelines que fornecem contexto ao modelo
- Agent Frameworks — o ambiente de execução que orquestra o ciclo do agente
- Deployment & Infrastructure — onde o agente é executado
- Evaluation & Observability — como o comportamento do agente é medido e registrado
- Security & Compliance — os controles que governam o agente
- Agent Ecosystem — os outros agentes, ferramentas e serviços com os quais o agente interage
No original da CSA, Security & Compliance é uma camada vertical que atravessa as outras seis, em vez de ficar acima delas. Cada camada tem seu próprio modelo de ameaças, padrões de ataque e mitigações. Modelos genéricos de ameaças costumam agrupar quase tudo isso em uma única categoria de “dependências externas”. O MAESTRO separa esses elementos.
MAESTRO e OWASP: quem publica o quê?
- Cloud Security Alliance (CSA): a publicação original do framework MAESTRO, de Ken Huang, em 6 de fevereiro de 2025.
- OWASP GenAI Security Project, Agentic Security Initiative: a taxonomia Agentic AI Threats and Mitigations (fevereiro de 2025) e o Multi-Agentic System Threat Modeling Guide (abril de 2025), que aplica o MAESTRO a sistemas multiagentes reais.
O resultado é um framework que um pentester de IA agêntica pode usar como lista de verificação. O restante deste guia é essa lista.
Camada 1 — Foundation Models
Superfície de ameaças
O próprio modelo, seus pesos, seus dados de treinamento e a cadeia de suprimentos que o produziu.
Padrões de ataque
- Envenenamento do modelo por meio dos dados de treinamento. Um colaborador de um conjunto de dados insere exemplos com backdoor. O modelo aprende o gatilho, que é ativado em produção.
- Exfiltração de pesos. Um invasor compromete o registro de modelos e copia os pesos. O modelo fica disponível para concorrentes ou para ajuste fino adversarial.
- Checkpoints com backdoor no Hugging Face. Um ajuste fino de um modelo conhecido, disponível publicamente, contém um backdoor. O agente subsequente herda o problema.
- Ajuste fino adversarial de um modelo-base de código aberto. Uma equipe usa Llama 4 ou Mistral como base. Um invasor publica uma variante descrita como “ajustada para segurança”, mas sutilmente desalinhada. A equipe escolhe a versão errada.
Sinais de detecção
- Divergência entre o hash esperado e os pesos carregados
- Atualizações de gradiente suspeitas durante o ajuste fino
- Comportamento subsequente acionado por entradas raras (detecção probabilística de backdoor)
- Picos incomuns na curva de perda durante o treinamento
Mitigações
- Fixar as versões do modelo por hash, não pelo nome
- Obter pesos de registros atestados (commits assinados no Hugging Face e artefatos internos assinados)
- Avaliar a robustez adversarial antes da implantação
- Manter uma lista de permissões de fornecedores de modelos com verificação de procedência
Camada 2 — Data Operations
Superfície de ameaças
Os dados que o agente consome em tempo de execução: corpora de geração aumentada por recuperação (RAG), modelos de prompt, histórico de conversas, saídas de ferramentas e qualquer outro contexto que chegue ao modelo durante a inferência.
Padrões de ataque
- Injeção indireta de prompt por documentos RAG. O OWASP LLM01 define injeção indireta de prompt como a entrada que o modelo recebe de fontes externas, como sites ou arquivos. O invasor insere texto em um documento que o agente vai recuperar. Esse texto contém instruções que o agente segue como se tivessem vindo do usuário.
- Ocultação em modelo de prompt. O invasor modifica um modelo de prompt armazenado para incluir instruções adicionais que contornam a camada de segurança do agente.
- Envenenamento de saída de ferramenta. O agente chama uma ferramenta. Ela retorna uma cadeia de caracteres com instruções injetadas. O agente trata a saída da ferramenta como uma fonte confiável de instruções.
- Envenenamento de memória. O agente grava em sua memória de longo prazo. O invasor pode gravar no mesmo armazenamento de memória (geralmente um banco de dados vetorial). Recuperações futuras incluem as instruções do invasor.
- Injeção em logs. O agente registra seu rastro de raciocínio. O invasor injeta texto no log. Um agente de monitoramento lê o log e trata o texto injetado como instruções.
Sinais de detecção
- Saídas de ferramentas com padrões semelhantes a instruções (verbos no imperativo e tratamento direto)
- Documentos RAG com densidade de instruções muito acima do normal
- Gravações na memória que não correspondem ao histórico de interações observado do agente
- Entradas de log com padrões de linguagem incompatíveis com a persona do agente
Mitigações
- Tratar todo conteúdo recuperado e todas as saídas de ferramentas como dados não confiáveis, não como instruções
- Usar um canal de instruções separado (system prompt), isolado do canal de dados
- Processar as saídas de ferramentas com um parser estruturado, em vez de concatenar strings sem tratamento
- Aplicar rastreamento de procedência a cada gravação na memória
Camada 3 — Agent Frameworks
Superfície de ameaças
O ambiente de execução que orquestra o ciclo do agente: módulo de planejamento, lógica de seleção de ferramentas, interface de memória, rastro de raciocínio e agendador de execução.
Padrões de ataque
- Manipulação do rastro de raciocínio. A cadeia de pensamento do agente é exposta nos logs. O invasor lê o rastro, identifica o objetivo e insere uma observação enganosa que desvia a próxima etapa.
- Sequestro da seleção de ferramentas. O agente seleciona ferramentas com base em um planejador. O invasor registra uma ferramenta maliciosa com nome semelhante ao de outra legítima. O planejador escolhe a ferramenta errada.
- Amplificação do ciclo (negação de carteira). O agente entra em um ciclo de raciocínio que consome tokens de API. O ciclo continua indefinidamente até o orçamento acabar.
- Escape de subagente. Um agente supervisor inicia um subagente. O subagente tem menos restrições que o supervisor e executa ações que o supervisor não teria aprovado.
- Desvio entre raciocínio e ação. O raciocínio declarado pelo agente diverge das ações reais. O auditor lê o rastro e não vê problema. As ações contam outra história.
Sinais de detecção
- Rastros de raciocínio com linguagem incompatível com a persona ou os objetivos do agente
- Seleções de ferramentas que não correspondem ao plano declarado pelo agente
- Anomalias no gasto de tokens por invocação do agente
- Invocações de subagentes que excedem o orçamento declarado pelo supervisor
- Divergência entre o rastro e os logs de ação
Mitigações
- Isolar o módulo de planejamento do módulo de execução
- Exigir confirmação explícita para chamadas de ferramentas fora de uma lista de permissões
- Limitar o gasto de tokens por invocação e por sessão
- Manter uma hierarquia rigorosa entre supervisor e subagentes, com regras de herança de capacidades
- Comparar continuamente os rastros de raciocínio com os logs de ação
Camada 4 — Deployment & Infrastructure
Superfície de ameaças
O ambiente de execução do agente: contêineres, funções sem servidor, máquinas virtuais, sistema operacional subjacente, segredos usados pelo agente e caminhos de rede que ele pode acessar.
Padrões de ataque
- Escape de contêiner. O agente é executado em um contêiner. Uma vulnerabilidade no ambiente de execução do contêiner permite escapar para o host. O agente passa a ter os privilégios do host.
- Roubo de credenciais do ambiente de execução. O agente tem chaves de API, credenciais de banco de dados ou tokens OAuth no ambiente. Uma injeção de prompt na saída de uma ferramenta leva o agente a exfiltrá-los.
- Movimentação lateral para serviços internos. O agente pode alcançar serviços internos pela rede. O invasor o usa como ponto de apoio.
- Backdoor persistente no ambiente de execução. O invasor instala um backdoor na imagem de contêiner do agente. Cada nova implantação o reintroduz.
- Vazamento de dados por canal lateral. Os padrões computacionais do agente (tempo de execução e uso de GPU) revelam informações sobre o prompt ou o estado do modelo.
Sinais de detecção
- Conexões de saída inesperadas do ambiente de execução do agente
- Atividade incomum no sistema de arquivos ou na rede
- Desvio do contêiner em relação à imagem confiável conhecida
- Diferença entre as regras de saída declaradas e as efetivas
Mitigações
- Executar o agente com os privilégios mínimos necessários (sistemas de arquivos somente leitura e nenhuma conexão de saída, exceto para endpoints permitidos)
- Obter imagens de contêiner de registros atestados e fixar seus hashes
- Aplicar listas de permissões de saída com políticas de rede
- Rotacionar as credenciais a cada reinicialização do agente
- Implantar detecção de ameaças em tempo de execução (por exemplo, Falco, Tetragon) no host do agente
Camada 5 — Evaluation & Observability
Superfície de ameaças
A infraestrutura de telemetria, logs, avaliação e observabilidade que monitora o agente.
Padrões de ataque
- Envenenamento de logs. Os logs do agente incluem saídas de ferramentas. O invasor injeta texto em uma saída que chega aos logs. O SIEM ingere a entrada e trata o texto injetado como a descrição de um alerta.
- Falsificação de telemetria. O avaliador do agente informa métricas aparentemente saudáveis. As métricas são fabricadas e o agente está se comportando mal.
- Envenenamento do conjunto de avaliação. O conjunto de avaliação fica armazenado no mesmo local que os dados de produção. O invasor o modifica. O agente “passa” em avaliações que já não representam o comportamento real.
- Conluio entre avaliador e agente. Um agente separado avalia o agente de produção. Ambos podem ser alcançados pelo mesmo ponto de injeção de prompt. O invasor usa esse ponto para manipular o avaliador.
Sinais de detecção
- Entradas de log com padrões de linguagem incompatíveis com o agente
- Melhorias repentinas nas métricas sem mudanças operacionais correspondentes
- Alterações nos hashes do conjunto de avaliação sem um commit de código ou dados correspondente
- Divergência entre a saída do avaliador e as observações de referência
Mitigações
- Separar o canal de logs do canal de dados do agente
- Assinar e calcular hashes de todos os conjuntos de avaliação; alertar sobre alterações de hash
- Tratar as saídas do avaliador como não confiáveis e compará-las com a telemetria bruta
- Usar sinais externos de referência (por exemplo, feedback dos usuários e diferenças nos registros dos sistemas) para validar os resultados da avaliação
Camada 6 — Security & Compliance
Superfície de ameaças
Os controles, políticas e regimes de conformidade que governam o comportamento do agente: RBAC, aplicação de escopo, logs de auditoria, aprovação com participação humana e artefatos de policy-as-code que codificam as regras.
Padrões de ataque
- Ampliação de escopo pela composição de ferramentas. Cada ferramenta usada pelo agente tem escopo limitado. O agente encadeia ferramentas de modo que a composição tenha um escopo maior que o de qualquer ferramenta individual.
- Contorno da aprovação humana. O fluxo de aprovação pressupõe que uma pessoa rejeitará uma ação perigosa. O agente descreve a ação de forma confusa e a pessoa a aprova.
- Injeção em policy-as-code. O mecanismo de políticas lê regras de um artefato versionado. O invasor modifica o artefato. O agente passa a operar sob regras novas.
- Adulteração do log de auditoria. O agente pode acessar o próprio log de auditoria. O invasor o usa para reescrever o log e encobrir seus rastros.
Sinais de detecção
- Chamadas de ferramentas que excedem o escopo declarado de qualquer ferramenta individual
- Padrões de aprovação incompatíveis com a ação declarada pelo agente
- Alterações no hash do artefato de políticas sem um commit correspondente
- Entradas do log de auditoria alteradas posteriormente
Mitigações
- Verificar capacidades no nível da composição, não apenas de cada ferramenta individual
- Exigir um resumo em linguagem simples junto com a própria ação
- Assinar e calcular hashes dos artefatos de políticas; alertar sobre alterações
- Gravar logs de auditoria em um armazenamento somente para anexação ao qual o agente não tenha acesso
Camada 7 — Agent Ecosystem
Superfície de ameaças
Os outros agentes, ferramentas, servidores MCP, serviços externos e pessoas com quem o agente interage em produção.
Padrões de ataque
- Envenenamento de ferramenta MCP. O servidor MCP altera a descrição da ferramenta depois que o agente a aprova (um “rug pull”, documentado pela Invariant Labs). A nova descrição determina um comportamento diferente.
- Comprometimento do servidor MCP. O próprio servidor MCP é comprometido. As chamadas de ferramenta do agente passam a ser encaminhadas por código controlado pelo invasor.
- Injeção de prompt entre agentes. Os agentes A e B se comunicam. O invasor planta instruções no contexto de A que visam especificamente B.
- Ataque à cadeia de suprimentos do marketplace de ferramentas. Uma ferramenta publicada pela comunidade contém código malicioso. O agente a importa, e a ferramenta exfiltra credenciais no primeiro uso.
- Personificação humana. O agente recebe uma mensagem que parece vir de um operador humano, mas que na verdade foi enviada pelo invasor. O agente segue as instruções.
Sinais de detecção
- Alteração na descrição da ferramenta após a aprovação
- Mudanças inesperadas no comportamento de ferramentas executadas por longos períodos
- Mensagens entre agentes com conteúdo semelhante a instruções
- Ferramentas de marketplaces com baixa pontuação de procedência
- Mensagens de operadores com padrões anômalos
Mitigações
- Fixar as descrições de ferramentas MCP no momento da aprovação e alertar sobre alterações
- Usar uma lista de permissões de ferramentas com requisitos de procedência
- Isolar a comunicação entre agentes por meio de mensagens estruturadas
- Exigir autenticação multifator para instruções de operadores
- Manter um inventário de ferramentas com pontuações de risco
Exemplo prático — Hexstrike-AI
Em setembro de 2025, a Check Point informou que agentes de ameaças estavam discutindo o Hexstrike-AI, um framework ofensivo cujo servidor FastMCP conecta LLMs (Claude, GPT, Copilot) a mais de 150 ferramentas de segurança, como forma de explorar as falhas do Citrix NetScaler CVE-2025-7775, CVE-2025-7776 e CVE-2025-8424, divulgadas em 26 de agosto de 2025. Publicações em fóruns afirmavam que ele reduzia o tempo até a exploração de dias para menos de 10 minutos.
O Hexstrike-AI é o agente do invasor, não a vítima. Isso faz dele um bom exercício MAESTRO: se um agente com o mesmo projeto fosse executado dentro do seu ambiente, como ferramenta de red team ou agente de automação interno com o mesmo acesso a ferramentas, o que cada camada precisaria responder? A tabela abaixo é um mapeamento ilustrativo nosso, não uma conclusão do relatório da Check Point.
| Camada MAESTRO | Perguntas levantadas por um agente como o Hexstrike-AI |
|---|---|
| L1 — Foundation Models | Ele depende de LLMs de terceiros; o comportamento do modelo e suas proteções ficam fora do seu controle |
| L2 — Data Operations | Resultados de varreduras e saídas de ferramentas retornam ao contexto do modelo, criando um caminho de injeção indireta de prompt vindo de alvos hostis |
| L3 — Agent Frameworks | O orquestrador escolhe entre mais de 150 ferramentas; ferramentas parecidas ou sequestradas poderiam desviá-lo |
| L4 — Deployment & Infrastructure | Onde quer que o servidor MCP seja executado, seu alcance de rede e suas credenciais fazem dele um ponto de apoio |
| L5 — Evaluation & Observability | Sem logs por chamada de ferramenta, é difícil reconstruir uma execução automatizada de varredura e exploração |
| L6 — Security & Compliance | O operador, e não a ferramenta, aplica o escopo; nada impede que uma cadeia de exploração saia dos alvos autorizados |
| L7 — Agent Ecosystem | A camada MCP é a principal superfície de ataque; descrições de ferramentas e ferramentas da comunidade precisam ser fixadas e ter sua procedência verificada |
O mapeamento do MAESTRO torna legível a superfície de ameaças em cada camada. Um pentester que avalia um agente semelhante tem uma lista de verificação que segue de baixo para cima. O mesmo padrão de agentes conectados a ferramentas reais aparece também em plataformas populares. Nossa análise da stack de agentes do OpenAI DevDay 2026 examina esse padrão pelo ponto de vista da defesa.
Lista de verificação MAESTRO para modelagem de ameaças em pentests
Para cada camada, confirme os pontos a seguir antes de iniciar um pentest de um sistema de IA agêntica:
- L1 — Modelos: Quais modelos dão suporte ao agente? Qual é a procedência deles? Os pesos estão fixados?
- L2 — Dados: O que o agente lê em tempo de execução? O conteúdo recuperado é tratado como instrução ou como dado?
- L3 — Frameworks: Há um planejador e um executor separados? As capacidades dos subagentes são herdadas ou limitadas?
- L4 — Infraestrutura: Quais são os privilégios do ambiente de execução? Qual é a política de saída? A imagem tem atestação?
- L5 — Telemetria: O que é registrado? Para onde os logs são enviados? O agente pode escrever no próprio log de auditoria?
- L6 — Controles: Como o escopo é aplicado no nível da composição de ferramentas? Em que pontos acontecem as aprovações humanas?
- L7 — Ecossistema: Quais servidores MCP o agente usa? As descrições das ferramentas estão fixadas? Com quais outros agentes ele se comunica?
Esse é o padrão. Todo trabalho que não cobrir as sete camadas é parcial. Se estiver escolhendo ferramentas para esse trabalho, nossa comparação de ferramentas de pentest de IA organiza o mercado pela qualidade das evidências, e o AI Swarm Pentest da Plexicus executa agentes de ataque com escopo assinado e descobertas verificadas por replay. As camadas 1–3 também estão no código, onde o Deep Code Analysis rastreia como uma saída não confiável de ferramenta chega a um ponto vulnerável.
Por que o MAESTRO é importante para a segurança da IA agêntica
A superfície de ameaças da IA agêntica não vai diminuir. Os modelos ficarão mais capazes, os ecossistemas de ferramentas vão crescer e a cadeia de suprimentos ficará mais complexa. O número de agentes por empresa vai se multiplicar, e uma parcela maior do código com que eles interagem será escrita por máquinas; nas nossas próprias varreduras, 78% dos pull requests gerados por IA continham uma vulnerabilidade.
O MAESTRO é um dos primeiros frameworks criados para essa realidade e oferece ao setor um vocabulário comum. Quanto antes sua equipe adotá-lo, mais rápido pentesters, profissionais de modelagem de ameaças e auditores falarão a mesma língua.
As equipes que esperarem serão aquelas cujos relatórios de auditoria listam “segurança de IA” como um único controle. As equipes que adotarem o MAESTRO agora terão uma defesa em profundidade em camadas, respaldada por evidências e verificável por replay — esse é o padrão de AppSec baseada em evidências para 2026 e além.
Perguntas frequentes
O que é o framework MAESTRO?
MAESTRO (Multi-Agent Environment, Security, Threat, Risk, and Outcome) é um framework de modelagem de ameaças para IA agêntica. Ele divide um sistema de agentes em sete camadas, desde Foundation Models e Data Operations até o Agent Ecosystem, e lista ameaças e mitigações para cada uma. O framework amplia métodos antigos como STRIDE, PASTA e LINDDUN com ameaças específicas de IA, como injeção de prompt, envenenamento de memória e envenenamento de ferramentas MCP.
O MAESTRO é um framework da OWASP ou da Cloud Security Alliance?
Ken Huang apresentou o MAESTRO no blog da Cloud Security Alliance em fevereiro de 2025. Em seguida, a Agentic Security Initiative do OWASP GenAI Security Project publicou o Multi-Agentic System Threat Modeling Guide em abril de 2025, aplicando o MAESTRO a sistemas multiagentes reais. Por isso, as pessoas costumam dizer “OWASP MAESTRO”, embora o framework tenha surgido na CSA.
Quais são as 7 camadas do MAESTRO?
As sete camadas são Foundation Models, Data Operations, Agent Frameworks, Deployment and Infrastructure, Evaluation and Observability, Security and Compliance e Agent Ecosystem. Security and Compliance é uma camada vertical que abrange todas as demais. Cada camada tem sua própria superfície de ataque, então o modelo de ameaças MAESTRO as analisa uma a uma, em vez de tratar o agente de IA como uma única caixa-preta.
Como a modelagem de ameaças MAESTRO difere do STRIDE?
O STRIDE classifica ameaças por tipo (spoofing, adulteração, repúdio, divulgação de informações, negação de serviço e elevação de privilégio) para softwares tradicionais. O MAESTRO mantém essa abordagem, mas organiza as ameaças em torno das camadas de um sistema de agentes e acrescenta ameaças sem categoria no STRIDE: dados de treinamento envenenados, injeção de prompt por ferramentas e memória, desvio entre raciocínio e ação e confiança multiagente entre ferramentas e servidores MCP.
Como usar o MAESTRO em um pentest de segurança de IA agêntica?
Comece pela Camada 1 e avance. Para cada camada, liste os componentes dentro do escopo, associe a eles os padrões de ataque deste guia e confirme se existem sinais de detecção e mitigações. Em seguida, teste os caminhos de maior risco — geralmente injeção indireta de prompt (Camada 2), seleção de ferramentas (Camada 3) e servidores MCP (Camada 7) — e mantenha evidências reproduzíveis para cada descoberta.
Leituras relacionadas:
- Do alerta à correção: fechando o ciclo com AppSec baseada em evidências — o ciclo operacional que o MAESTRO ajuda a mapear
- O que é Deep Code Analysis? — a camada de análise estática que complementa MAESTRO L1–L3
- 78% dos pull requests gerados por IA contêm uma vulnerabilidade — a falha em produção que o MAESTRO L2/L7 foi criado para modelar

