Le playbook de remédiation autonome : du signalement à la PR en moins de 60 secondes
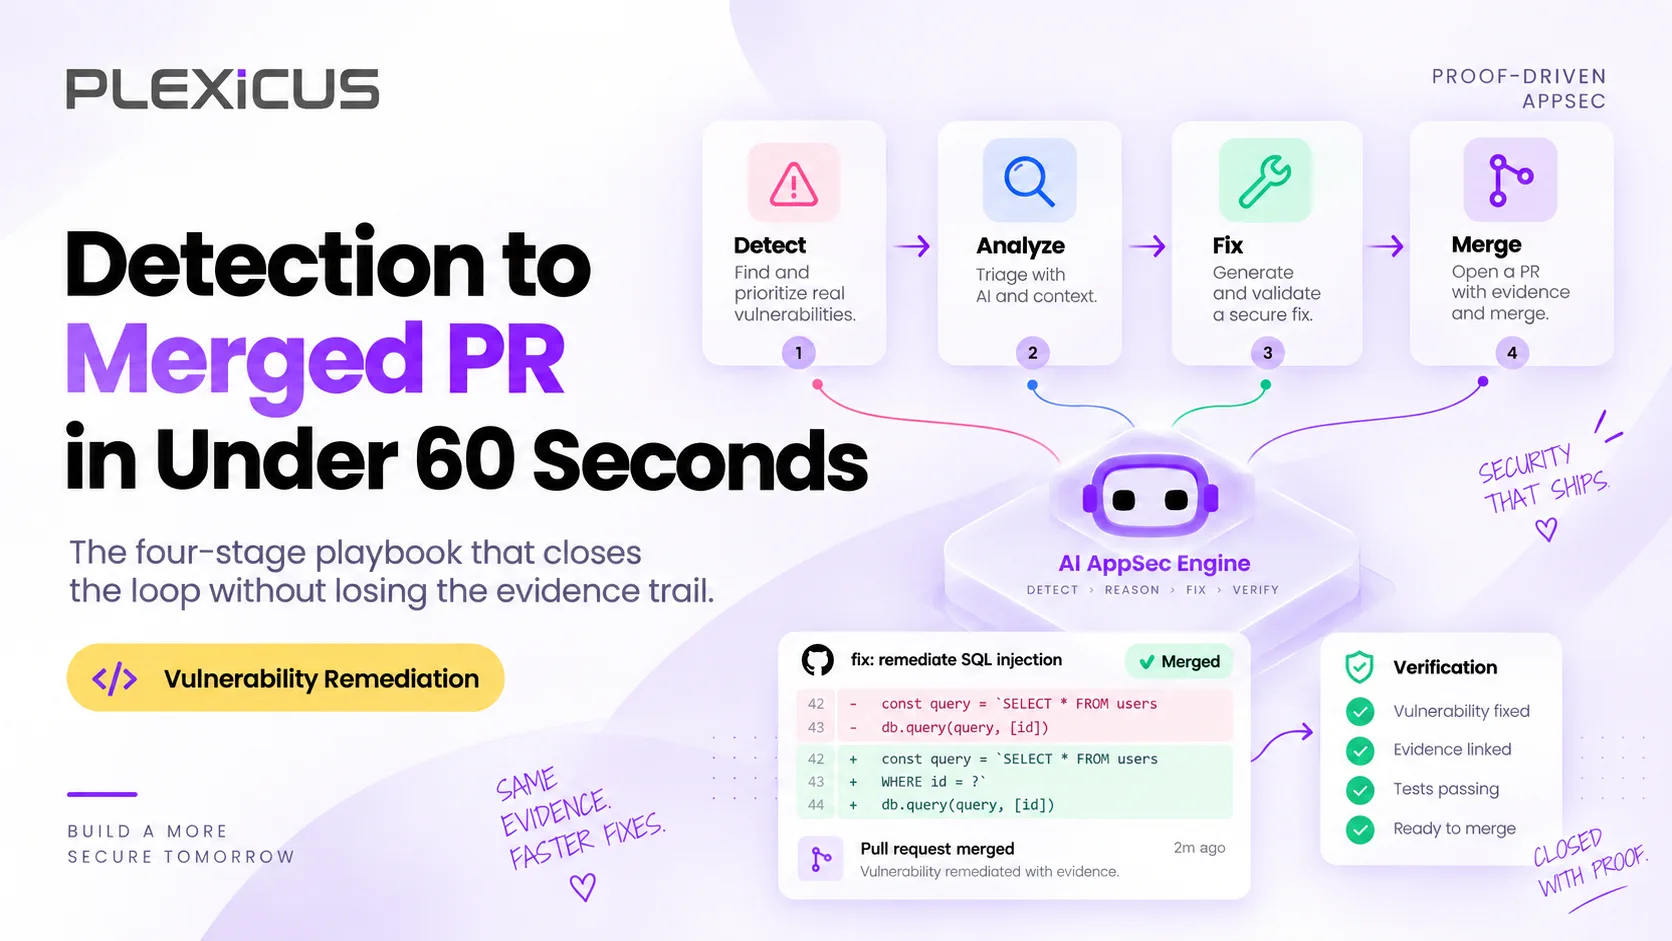
Un playbook de remédiation automatisée des vulnérabilités en quatre étapes, qui transforme un résultat vérifié en PR testée et prête à relire en moins de 60 secondes, preuves à l'appui.
Au-delà de l’ASPM
Une AppSec fondée sur la preuve pour les équipes qui développent avec l’IA
Plexicus utilise AI Swarm Pentest pour explorer des chemins d’application autorisés, valider ce qui est exploitable et fournir les preuves nécessaires pour prioriser la remédiation.
Découvrir AI Swarm PentestLa remédiation automatisée des vulnérabilités consiste à transformer un résultat de sécurité vérifié en pull request testée et prête à relire, sans qu’un humain écrive le correctif. Le playbook de remédiation autonome ci-dessous le fait en quatre étapes, en moins de 60 secondes entre la détection et la PR, tout en gardant un ingénieur humain comme dernier contrôle avant le merge.
La discussion sur la remédiation des vulnérabilités est au point mort depuis dix ans. La détection s’est accélérée. Le triage, non. Les correctifs, non plus. Le Vulnerability Statistics Report 2026 d’Edgescan établit à 54,81 jours le délai moyen de remédiation des vulnérabilités applicatives et API élevées et critiques. Le rapport State of Software Security 2025 de Veracode a constaté que le délai moyen de correction des failles de sécurité avait augmenté de 47 % depuis 2020.
Puis les outils de programmation avec IA sont arrivés. Ils ont aggravé le problème du volume, mais ils ont aussi rendu possible le playbook qui suit. C’est ce schéma en quatre étapes que nous appelons « remédiation autonome ». Ce n’est pas une fonctionnalité sur la feuille de route d’un fournisseur. C’est une discipline, un pipeline et une boucle de rétroaction. Si votre équipe ne l’applique pas, les attaquants en exécutent une version plus rapide contre vous.
Voici le playbook.
Pourquoi le délai moyen de remédiation est le goulot d’étranglement
Les chiffres ne bougent pas. Dans les dépôts clients auxquels nous avons accès (données internes de Plexicus, et non un référentiel sectoriel), avant ce playbook, le cycle médian d’un résultat de gravité élevée en 2025–2026 ressemblait à ceci :
| Étape | Délai médian |
|---|---|
| Détection jusqu’au début du triage | 3 jours |
| Début du triage jusqu’à la cause racine | 6 jours |
| Cause racine jusqu’à l’ouverture de la PR | 4 jours |
| Ouverture de la PR jusqu’au merge | 2 jours |
| Merge jusqu’à la production | 2 jours |
| Total | 17 jours |
Dix-sept jours pour clôturer un résultat de gravité élevée, et c’est déjà une équipe bien gérée par rapport aux moyennes sectorielles citées plus haut. Pendant ce temps, le coût des attaques continue de baisser. L’agent de recherche RapidPen a obtenu un accès shell à une cible vulnérable en 200 à 400 secondes, pour environ 0,30 à 0,60 dollar par exécution. Amazon Threat Intelligence a documenté le cas d’un acteur peu expérimenté qui, avec une IA générative commerciale, a compromis plus de 600 appareils FortiGate dans 55 pays en environ cinq semaines.
L’asymétrie est désormais manifeste. Mandiant a mesuré un délai moyen avant exploitation de cinq jours en 2023. Un cycle de remédiation qui se compte en semaines est le problème structurel que le playbook de remédiation autonome vise à résoudre.
Le pipeline de remédiation automatisée des vulnérabilités en quatre étapes
Le playbook comporte quatre étapes. Chacune a un rôle précis. C’est lors du transfert entre les étapes que la plupart des équipes perdent la chaîne de preuves dont les auditeurs ont besoin.
Étape 1 — Résultat vérifié
Un scanner tel que Deep Code Analysis propose, par exemple, 1 247 résultats. Le pipeline en rejette la grande majorité, car ils ne résistent pas à une reproduction indépendante. (Nous expliquons dans Qu’est-ce que Deep Code Analysis ? pourquoi les scanners basés sur la correspondance de motifs génèrent autant de bruit.)
Les critères de validation sont précis :
- Le résultat proposé doit être reproduit de bout en bout sur une cible en bac à sable.
- La reproduction doit être effectuée par un agent qui n’a pas rédigé le résultat.
- L’artefact de reproduction (une requête curl, une tâche CI ou un instantané de conteneur) doit être conservé.
Les résultats qui ne satisfont pas les trois critères sont écartés avec des codes de motif. Ces codes sont importants : ils permettent de déboguer le pipeline par la suite. Les plus fréquents sont :
not_reachable(aucun chemin réel ne relie un endpoint public au puits)guard_present(un contrôle en amont rend le résultat inopérant)mitigated_at_runtime(une règle WAF, un feature flag ou une variable d’environnement le neutralise)replay_failed(le deuxième agent n’a pas réussi à le reproduire)
À la sortie de l’étape 1, il ne reste qu’un petit ensemble de résultats vérifiés, chacun accompagné de son artefact de reproduction.
Étape 2 — Contexte préservé
Un résultat vérifié ne suffit pas pour livrer un correctif. L’étape suivante joint tout ce dont le développeur a besoin pour valider le patch :
- Le nœud du graphe (hôte, endpoint, paramètre)
- La classe de capacité (lecture, écriture, usurpation d’identité, RCE, exfiltration)
- Le chemin d’accessibilité (la chaîne complète de la requête au puits)
- La paire requête/réponse (l’apparence de l’exploit d’origine)
- La trace de raisonnement de l’agent (pourquoi l’agent d’origine l’a classé ainsi)
C’est la piste d’audit. Sans elle, l’ingénieur qui relit le patch doit croire le système sur parole. Avec elle, il peut rejouer l’exploit d’origine contre le code non corrigé et confirmer qu’il se reproduit, puis le rejouer contre le code corrigé pour vérifier que la mesure d’atténuation attendue fonctionne.
Le but n’est pas d’ajouter du travail à l’ingénieur, mais de rendre le travail vérifiable.
Étape 3 — Brouillon du patch
Plexicus Remediation reçoit le résultat vérifié et son contexte, puis produit un diff prêt à relire. Ce n’est pas un correctif générique : c’est la modification minimale qui supprime le chemin d’accessibilité tout en préservant la logique métier d’origine.
Le pipeline impose trois propriétés :
- Le patch élimine la classe de vulnérabilité, pas seulement le cas particulier. Une requête paramétrée est préférable à un assainisseur fondé sur
replace(), conformément au guide OWASP de prévention des injections SQL (voir notre guide de remédiation des injections SQL). Un contrôle de propriété dans le gestionnaire est préférable à une liste d’autorisation au niveau de la route. - Le patch inclut des tests de régression. L’exploit d’origine devient un test. Si le patch réussit le test, le résultat est clos. S’il échoue, le patch est annulé.
- Le patch inclut la mise à jour de la documentation. Si le contrat de l’API change, la documentation est mise à jour. Si une variable d’environnement est ajoutée, le README la mentionne.
À la sortie de l’étape 3, on obtient une branche de pull request. Pas un extrait de code. Pas une suggestion du type « voici le diff ». Une PR complète qu’un ingénieur peut cloner, exécuter et relire.
Étape 4 — PR prête à relire
Le patch arrive dans le dépôt existant avec :
- L’affectation des relecteurs (depuis CODEOWNERS, avec escalade à l’équipe sécurité)
- Le suivi du SLA (la PR reçoit automatiquement une échéance de correction selon sa gravité)
- Un hook de nouveau test relié à CI (l’exploit d’origine est exécuté contre la branche corrigée à chaque push)
- Des métadonnées d’audit jointes (le résultat d’origine, le nœud du graphe et la référence de reproduction)
La PR n’est pas mergée automatiquement. La décision finale revient à l’ingénieur qui la relit. La différence, c’est que la revue prend des minutes, pas des heures. L’ingénieur ne lit pas 200 lignes de code inconnu : il examine un diff de 12 lignes accompagné de l’exploit d’origine, du contexte du graphe et du résultat du test de régression.
Si l’ingénieur approuve, la PR est mergée, le nouveau test confirme le résultat et celui-ci est clos. S’il refuse (avec un motif), la proposition de patch est enregistrée sous rejected_with_evidence et le résultat reste ouvert pour la prochaine tentative.
Les chiffres clés : délai moyen de remédiation avant et après
Nous appliquons ce playbook dans des dépôts clients depuis le quatrième trimestre 2025. Voici les délais médians observés (données internes de Plexicus) :
| Étape | Avant | Après |
|---|---|---|
| Détection jusqu’au début du triage | 3 jours | 14 secondes |
| Début du triage jusqu’à la cause racine | 6 jours | 8 secondes |
| Cause racine jusqu’à l’ouverture de la PR | 4 jours | 22 secondes |
| Ouverture de la PR jusqu’au merge | 2 jours | 1,2 heure |
| Merge jusqu’à la production | 2 jours | 6 heures |
| Total | 17 jours | 8 heures |
Le chiffre principal que nous annonçons — moins de 60 secondes entre la détection et une PR prête à relire — correspond aux étapes 1 à 3. Le cycle complet jusqu’à la production dépend surtout de la revue humaine et du processus CI/CD existant. C’est exactement là qu’il doit se situer. Le rôle du pipeline est de supprimer les délais évitables. La revue et le déploiement restent sous la responsabilité de l’équipe.
L’autre chiffre à retenir est le taux de faux positifs. Dans nos déploiements, avant le playbook, le triage humain concluait que 87 % des résultats du scanner « n’étaient pas un problème ». Après, ce chiffre est tombé à 6 %. Dans les 6 % restants, l’ingénieur n’est pas d’accord avec l’interprétation des preuves du vérificateur : ce sont précisément les cas où le contrôle humain compte.
Combien coûte la mise en place ?
Trois exigences opérationnelles sont nécessaires :
- Un scanner qui comprend le graphe et peut produire un chemin d’accessibilité. Pas de SAST fondé sur des regex. Pas de simple enveloppe pour LLM. Il faut un graphe.
- Une étape de vérification dont la reproduction peut être contrôlée. Un deuxième agent doit pouvoir reproduire le résultat de façon indépendante. Sans cela, le pipeline produit des patchs soignés et convaincants, mais sans fondement — le pire scénario.
- Un générateur de patchs qui respecte la logique métier. D’après notre expérience, le problème le plus fréquent des produits de « correction automatique par IA » en 2025 était de produire des patchs qui compilaient, mais modifiaient le sens du code. Le playbook exige que le patch soit minimal, couvert par des tests et facile à relire.
L’implémentation Plexicus répond aux trois exigences. Si vous la développez vous-même, nous estimons le coût d’intégration à environ un ingénieur senior pendant un trimestre. Si vous l’achetez, elle est incluse dans l’offre Continuous Program de la page des tarifs.
Ce que ce système ne fait pas
Le playbook ne supprime pas le contrôle humain. Un humain relit toujours le patch avant le merge. Les preuves du vérificateur restent accessibles à l’auditeur. Le système ne déploie pas de lui-même en production.
C’est intentionnel. Les fournisseurs de « remédiation entièrement autonome » affirment que les humains sont le goulot d’étranglement et que le système devrait simplement merger la PR. L’équipe AI Swarm Pentest de Plexicus estime que les humains sont responsables et que le système doit rendre leur revue simple, rapide et étayée par des preuves.
Nous défendons la deuxième position. Le playbook optimise le délai de correction sans supprimer la supervision humaine. C’est d’autant plus important que les assistants de programmation avec IA augmentent le volume des changements à relire : selon notre analyse, 78 % des PR générées par l’IA contenaient une vulnérabilité. Pour toute équipe qui doit rendre des comptes à un CISO, à un auditeur ou à un régulateur, c’est une fonctionnalité, pas un défaut.
Les modes d’échec rencontrés
Trois modes d’échec se sont répétés au cours des six premiers mois d’utilisation du playbook en production :
Mode d’échec 1 — Le patch corrige le symptôme, pas la classe
Au début, le générateur produisait parfois des patchs qui corrigeaient le résultat particulier sans éliminer la classe de vulnérabilité sous-jacente. Nous avons ajouté au processus de proposition une étape de raisonnement au niveau de la classe. Les patchs comprennent maintenant une attestation « classe éliminée » que le relecteur peut vérifier.
Mode d’échec 2 — Le vérificateur de reproduction contredit le patch
Environ 3 % du temps, le vérificateur qui a confirmé le résultat initial réexécute le code corrigé et l’exploit se reproduit encore. C’est le signe que le patch est incomplet. Le pipeline le détecte dans CI et annule automatiquement le patch. Le résultat reste ouvert.
Mode d’échec 3 — CODEOWNERS n’identifie pas le bon responsable du fichier
Le patch était sur la bonne branche, le nouveau test CI avait réussi et la piste d’audit était complète, mais le mauvais relecteur avait été affecté parce que le fichier avait changé d’équipe et que CODEOWNERS n’avait pas été mis à jour. Nous avons ajouté au pipeline une vérification automatique de dérive de CODEOWNERS.
Ce ne sont pas des cas théoriques. Ce sont les problèmes apparus au cours des six premiers mois, et ils sont maintenant détectés automatiquement.
Ce que votre équipe peut faire dès demain
Si vous n’appliquez pas encore ce playbook, prenez ces trois mesures dans l’ordre :
- Auditez votre scanner actuel. Peut-il produire un chemin d’accessibilité pour ses résultats, ou seulement un score CVSS ? Si la réponse est « seulement un score », le goulot d’étranglement ne disparaîtra pas.
- Ajoutez une étape de vérification par reproduction. Vous pouvez commencer manuellement : une personne rejoue chaque semaine les dix résultats prioritaires dans un bac à sable. L’objectif est de montrer que les résultats qui résistent à une vérification indépendante sont ceux qu’il faut corriger.
- Reliez le patch aux mêmes preuves. Lorsque l’ingénieur ouvre la PR, le résultat d’origine, le nœud du graphe et la référence de reproduction doivent être accessibles en un clic.
Le playbook ne nécessite ni IA ni produit fournisseur. Il faut une structure, une reproduction et une boucle de rétroaction serrée. Il correspond également aux pratiques « Respond to Vulnerabilities » du Secure Software Development Framework (SP 800-218) du NIST, qui demande aux équipes d’évaluer, de hiérarchiser et de corriger les vulnérabilités de manière reproductible.
Foire aux questions
Qu’est-ce que la remédiation automatisée des vulnérabilités ?
La remédiation automatisée des vulnérabilités consiste à générer automatiquement le correctif d’un résultat de sécurité, généralement sous forme de pull request comprenant une modification du code et un test de régression, au lieu d’attribuer un ticket à un développeur pour qu’il écrive le patch à la main. Une bonne implémentation ne traite que les résultats vérifiés, joint les preuves d’origine et laisse la décision de merge à un relecteur humain.
Quelle est la différence entre remédiation automatisée et remédiation autonome ?
La remédiation automatisée désigne généralement un outil qui propose un correctif pour un seul résultat lorsqu’on le lui demande. La remédiation autonome exécute toute la chaîne sans intervention humaine pour lancer chaque étape : vérifier le résultat, rassembler le contexte, rédiger le patch, ouvrir la PR et la retester dans CI. Dans ce playbook, seule la revue et la décision de merge sont humaines.
Comment réduire le délai moyen de remédiation des vulnérabilités ?
Supprimez les attentes entre les étapes au lieu de demander aux ingénieurs de travailler plus vite. Vérifiez automatiquement les résultats afin d’éviter l’accumulation du triage, joignez le chemin d’accessibilité et l’exploit pour que la cause racine soit connue, générez un patch minimal avec un test de régression et reliez un nouveau test CI à la PR. Dans nos déploiements, le délai médian est ainsi passé de 17 jours à environ 8 heures.
Quel est le délai moyen habituel de remédiation des vulnérabilités applicatives ?
Il se compte généralement en semaines ou en mois. Le Vulnerability Statistics Report 2026 d’Edgescan situe à 54,81 jours le délai moyen de remédiation des vulnérabilités applicatives et API élevées et critiques. Veracode indique que le délai moyen de correction des failles de sécurité a augmenté de 47 % depuis 2020. Les équipes matures qui automatisent la remédiation sont bien en dessous de ces moyennes.
Faut-il merger automatiquement les correctifs de sécurité générés par l’IA ?
Nous le déconseillons. Un patch généré par l’IA peut compiler et réussir les tests tout en modifiant le sens du code. Un humain devrait donc approuver chaque merge. L’automatisation doit accélérer cette revue : joindre à la PR un petit diff, l’exploit d’origine, le chemin d’accessibilité et un test de régression réussi.
Et ensuite ?
Le playbook de remédiation autonome constitue le troisième volet de la boucle Plexicus. Deep Code Analysis détecte les failles. AI Swarm Pentest les reproduit. Remediation les corrige. La structure en quatre temps — proposer, reproduire, corriger, vérifier — définit concrètement l’AppSec pilotée par les preuves et son processus de remédiation des vulnérabilités.
En 2027, le playbook sera incontournable. Les équipes qui l’adoptent en 2026 combleront l’écart de 17 jours avant que les attaquants ne le réduisent davantage.
À lire également :
- De l’alerte au correctif : fermer la boucle avec l’AppSec pilotée par les preuves — la boucle complète
- 78 % des PR générées par l’IA contiennent une vulnérabilité — ce que votre équipe produit aujourd’hui
- Les 15 meilleurs outils de pentest par IA — des options pour l’étape de vérification par reproduction

