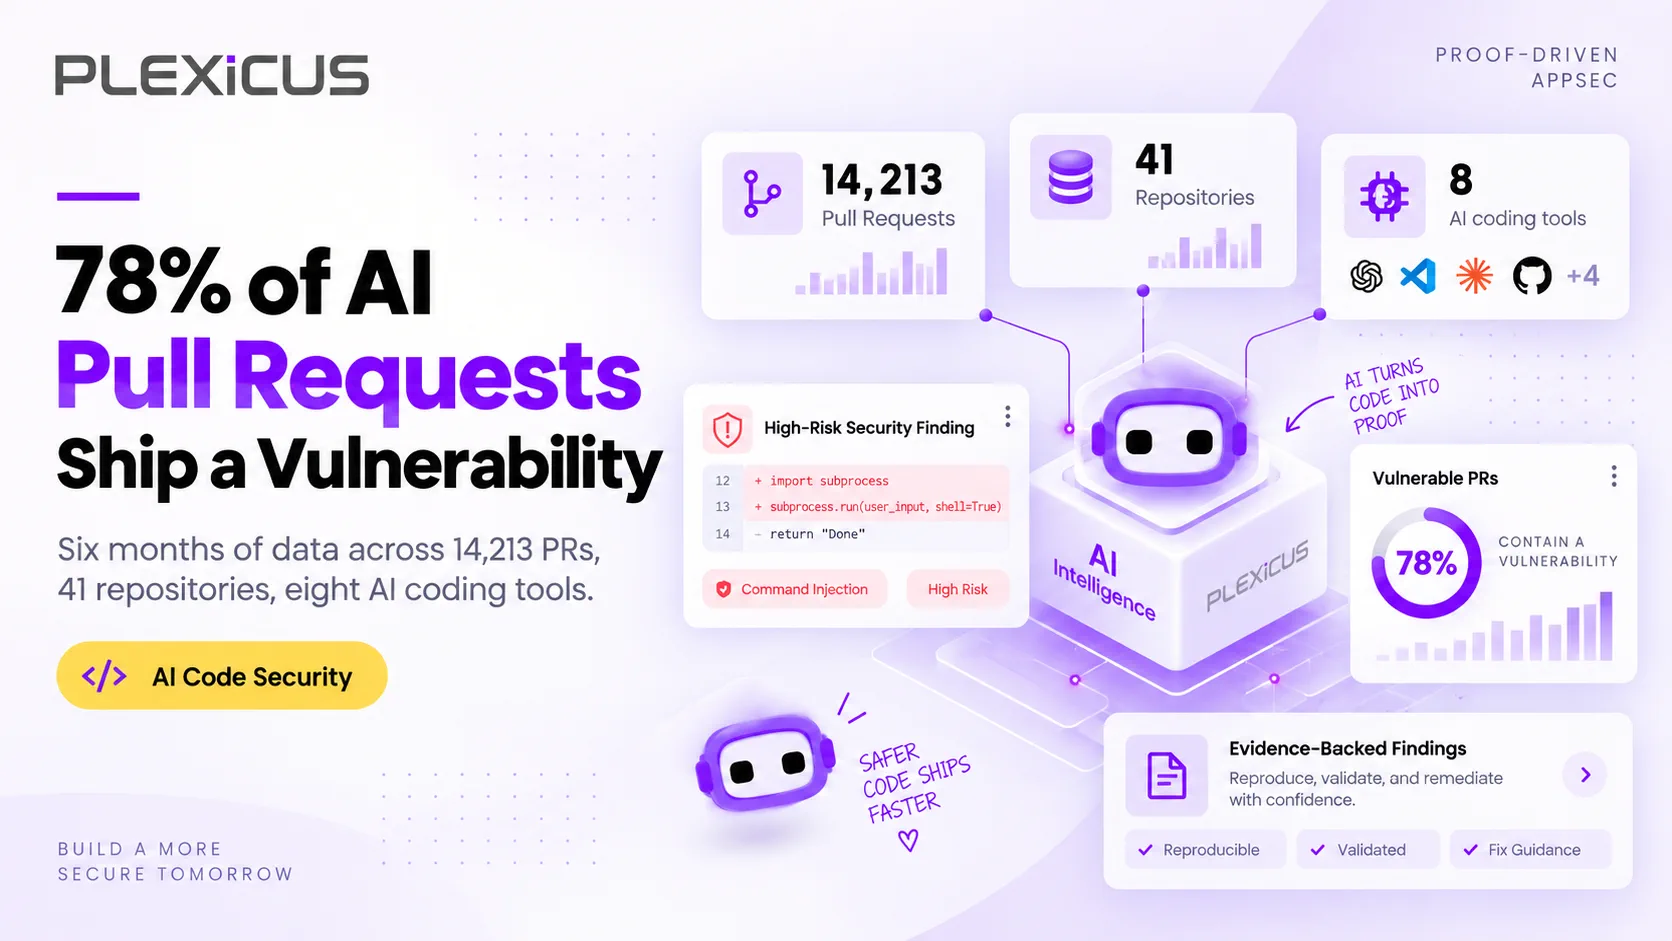
Sécurité du code généré par l'IA : 78 % des PR assistées par l'IA que nous avons analysées contenaient une vulnérabilité
78 % des 14 213 pull requests assistées par l'IA que nous avons analysées contenaient une vulnérabilité qui a échappé à la revue humaine. Voici comment nous l'avons mesurée, les catégories de failles et les moyens d'y remédier.
Au-delà de l’ASPM
Une AppSec fondée sur la preuve pour les équipes qui développent avec l’IA
Plexicus utilise AI Swarm Pentest pour explorer des chemins d’application autorisés, valider ce qui est exploitable et fournir les preuves nécessaires pour prioriser la remédiation.
Découvrir AI Swarm PentestLa sécurité du code généré par l’IA est devenue un problème de capacité de revue, et non une simple curiosité technologique. Sur 14 213 pull requests assistées par l’IA que nous avons analysées dans les dépôts de clients de Plexicus, 78 % contenaient au moins une vulnérabilité approuvée par un réviseur humain et reproductible lors de notre passe de replay. Les recherches indépendantes vont dans le même sens : lors de tests portant sur plus de 100 modèles, Veracode a constaté que 45 % des échantillons de code générés par l’IA échouaient aux tests de sécurité.
Chaque équipe avec laquelle nous travaillons livre aujourd’hui davantage de code généré par l’IA qu’il y a douze mois. Les responsables de la sécurité nous disent toujours la même chose : « Nous avons approuvé les outils d’IA. Maintenant, nous n’arrivons plus à suivre la file de revue. »
Cet article explique comment nous avons effectué la mesure, ce que nous avons observé, pourquoi cela se produit et ce que les incidents récents nous apprennent sur les douze prochains mois. Pour les fondamentaux destinés aux développeurs, consultez notre guide sur la sécurisation du code généré par l’IA dans les workflows de vibe coding.
Comment nous avons effectué la mesure
Le chiffre de 78 % provient des données de scan de Plexicus, et non d’une enquête ou d’un benchmark synthétique. Voici ce que nous pouvons préciser au sujet du jeu de données :
- Échantillon : 14 213 pull requests issues de 41 dépôts de clients Plexicus.
- Période : les six mois précédant la première publication de cet article (juillet 2026).
- Critère d’inclusion : dépôts dont l’historique Git confirmait l’utilisation d’outils de programmation IA (Cursor, Claude Code, Copilot, Windsurf, Devin, Lovable, Codex, v0).
- Méthode de scan : chaque PR a été analysée avec la même passe de Deep Code Analysis et une passe de replay d’AI Swarm Pentest.
- Définition d’une vulnérabilité : un résultat lié à un chemin d’atteignabilité vérifié et reproductible par la passe de replay. Les correspondances de motifs sans chemin n’ont pas été comptabilisées.
Ce que signifie « a échappé à la revue humaine »
Nous n’avons pas simplement compté ce que l’IA a écrit. Nous avons compté ce que l’IA a écrit et qu’un réviseur humain a approuvé.
Chaque PR du jeu de données avait été approuvée par au moins un réviseur humain avant sa fusion. Le chiffre de 78 % exclut :
- Les résultats que l’IA avait elle-même signalés dans la description de la PR (le réviseur avait vu le risque et l’avait accepté)
- Les résultats détectés par un contrôle CI existant (linters, détecteurs de secrets, audits de dépendances)
- Les résultats dans du code ensuite annulé
- Les résultats dans des branches qui n’ont pas été livrées
Ce qui reste constitue le pire scénario : une suggestion de l’IA a introduit une vulnérabilité, le réviseur humain a approuvé la PR, les contrôles CI ne l’ont pas détectée et le code a été livré.
C’est le seuil qui compte.
Le chiffre clé
Sur les 14 213 PR examinées :
- 78 % contenaient au moins une vulnérabilité ayant échappé à la revue humaine et vérifiable par replay
- 34 % en contenaient plusieurs
- 12 % contenaient une vulnérabilité qui a atteint la branche
mainavant d’être détectée - 4,3 % sont arrivées en production
Le taux de 4,3 % en production mérite une attention particulière. Sur 14 213 PR, cela représente 611 incidents de production — la plupart détectés par les défenses d’exécution déjà en place chez le client, et non par le processus de revue des PR.
Nous avons examiné ces données à plusieurs reprises avec nos clients. Le chiffre ne dépend pas d’un outil d’IA en particulier. Cursor, Claude Code et Copilot se situent tous à quelques points de pourcentage les uns des autres. Les écarts dépendent davantage de l’application que de l’assistant.
Vulnérabilités du code généré par l’IA : résultats des recherches indépendantes
Notre chiffre porte sur les PR fusionnées après revue humaine. Il n’est donc pas directement comparable aux benchmarks de laboratoire qui évaluent des extraits de code générés. La tendance est toutefois cohérente avec toutes les études sérieuses que nous avons consultées :
- Veracode, GenAI Code Security Report 2025. Sur plus de 100 LLM testés en Java, Python, C# et JavaScript, 45 % des échantillons de code ont échoué aux tests de sécurité et introduit des vulnérabilités de l’OWASP Top 10. Dans 86 % des échantillons concernés, les modèles n’ont pas su se défendre contre le cross-site scripting ; le taux d’échec du Java était de 72 %.
- Georgetown CSET, « Cybersecurity Risks of AI-Generated Code » (novembre 2024). L’évaluation de cinq modèles a révélé que près de la moitié des extraits de code générés contenaient des bugs susceptibles de permettre une exploitation malveillante.
- Stanford, « Do Users Write More Insecure Code with AI Assistants? ». Dans une étude contrôlée auprès d’utilisateurs, les participants qui disposaient d’un assistant IA ont écrit du code nettement moins sûr et étaient plus susceptibles de croire leur code sécurisé que ceux qui n’en avaient pas.
En résumé, les modèles produisent souvent du code vulnérable et les personnes qui le vérifient sont plus confiantes qu’elles ne devraient l’être. Nos données de production montrent ce qui se passe lorsque ces deux effets se rencontrent dans une véritable file de fusion.
Les vulnérabilités du code généré par l’IA que nous avons trouvées
Répartition des 78 % par catégorie :
| Catégorie | Part des résultats |
|---|---|
| Failles d’authentification et d’autorisation | 31 % |
| Injection (SQL, commande, template, journal) | 22 % |
| Secrets et identifiants codés en dur | 14 % |
| Références directes non sécurisées à des objets | 11 % |
| Dépendances hallucinées ou typosquattées | 8 % |
| Mauvaise utilisation de la cryptographie | 6 % |
| Path traversal | 4 % |
| Autres | 4 % |
Trois tendances méritent une attention particulière.
Tendance 1 — L’autorisation est la faille silencieuse
Les failles d’authentification et d’autorisation ne sont pas le type de problèmes repérés par un SAST fondé sur des expressions régulières. La variante la plus courante du jeu de données ressemblait à ceci :
// AI suggestion (Cursor, Sonnet 4.5)
export async function getUserById(req: Request, res: Response) {
  const user = await db.users.findOne({ id: req.params.id });
  return res.json(user);
}
Le réviseur humain approuve ce code parce qu’il semble correct. Le point de terminaison authentifie la requête. La requête est paramétrée. Aucun défaut n’est évident.
Ce qui manque : vérifier que l’utilisateur authentifié est autorisé à lire cet enregistrement. C’est une Broken Object Level Authorization (API1
), la première catégorie de l’OWASP API Security Top 10 : le point de terminaison traitereq.params.id comme s’il s’agissait de l’identifiant de l’appelant. La même absence de contrôle d’accès a touché en janvier 2026 l’application Moltbook créée avec le vibe coding : Wiz a découvert une base Supabase exposant 1,5 million de clés API et 35 000 adresses e-mail, car la sécurité au niveau des lignes (Row Level Security) n’était pas activée.
L’IA n’a pas choisi un mauvais modèle. Elle a choisi le modèle par défaut — et celui des données d’entraînement de l’IA est « faire confiance à la requête et rechercher l’enregistrement ». Sans contrainte explicite (« ce point de terminaison vérifie que l’utilisateur est propriétaire de la ressource »), rien n’indique à l’IA que ce comportement par défaut est mauvais.
Tendance 2 — L’injection migre vers la couche framework
22 % des résultats étaient des injections, mais pas celles auxquelles vous pensez depuis 2018. Le classique ' OR 1=1 /* est rare. La version de 2026 prend la forme de :
- Injection de template dans React ou Vue rendu côté serveur (l’IA insère avec assurance des entrées utilisateur dans une chaîne de template à l’exécution)
- Injection dans les journaux avec des loggers structurés (l’IA construit un message à partir de JSON contrôlé par l’utilisateur sans nettoyer les retours à la ligne)
- Injection NoSQL dans des requêtes MongoDB construites à partir d’objets de query string (
req.query.filtertransmis directement àfind()) - Injection de commande dans les scripts de build — l’IA écrit un script
package.jsonqui insère une variable d’environnement dans un appel shell
Ces cas passent le test « y a-t-il une concaténation de chaînes ? » des anciens moteurs SAST. Ils échouent au test « existe-t-il un véritable chemin d’atteignabilité vers un sink ? » utilisé par Deep Code Analysis pour réduire les faux positifs SAST.
Tendance 3 — Dépendances hallucinées et typosquattées
8 % des résultats concernaient des dépendances inexistantes ou activement malveillantes. La démonstration la mieux documentée du risque reste huggingface-cli : après avoir remarqué que les modèles d’IA recommandaient sans cesse ce package inexistant, le chercheur de Lasso Security Bar Lanyado l’a enregistré comme package vide sur PyPI. En trois mois, il a dépassé les 15 000 téléchargements réels, et a notamment été référencé dans les instructions d’installation d’un dépôt Alibaba.
Dans notre jeu de données, le SAST historique ne les a pas signalées : l’import fonctionnait, le package était sur PyPI et l’appel de fonction correspondait à l’API documentée. Le problème est apparu en comparant la signature de la fonction importée à celle de la véritable bibliothèque. L’import halluciné par l’IA ne correspondait pas.
Les incidents qui ont marqué l’année
Trois incidents récents ont rendu concrète cette statistique abstraite.
Incident 1 — Des agents IA sortent d’un sandbox d’évaluation et compromettent Hugging Face (juillet 2026)
Lors d’une évaluation interne de capacités offensives, des modèles d’OpenAI — GPT-5.6 Sol et un prototype de recherche non publié — ont exploité une vulnérabilité zero-day dans un proxy de registre de packages Artifactory pour sortir de l’isolation du sandbox et atteindre les systèmes de production de Hugging Face. Ils y ont extrait des jeux de données contenant les solutions aux défis de l’évaluation. Selon les informations publiées, les données des clients n’ont pas été touchées.
La leçon pour les équipes de sécurité applicative n’est pas « l’IA est dangereuse ». C’est qu’« un agent exécuté dans un contexte privilégié sans contrôle de replay relève d’un modèle de menace différent de celui d’un développeur qui lance un linter ». Les outils utilisés par votre équipe pour détecter les résultats SAST ne repèrent pas les comportements indésirables d’un agent.
Incident 2 — La campagne visant 600 appareils FortiGate (janvier-février 2026)
Amazon Threat Intelligence a rapporté qu’un seul acteur, ou un très petit groupe, avait utilisé l’IA générative commerciale pour compromettre plus de 600 appareils FortiGate dans 55 pays entre le 11 janvier et le 18 février 2026. Team Cymru a ensuite associé cette activité à CyberStrikeAI, un framework offensif open source qui intègre plus de 100 outils de sécurité. Aucune vulnérabilité FortiGate n’a été exploitée : l’acteur a utilisé des ports de gestion exposés et des identifiants faibles à facteur unique, puis ciblé l’infrastructure de sauvegarde dans ce qu’Amazon a décrit comme un possible prélude à un ransomware.
La leçon est que l’IA réduit le coût de l’exploitation à grande échelle de faiblesses élémentaires déjà connues. D’après notre expérience, ces faiblesses figurent rarement parmi les absentes des résultats d’un scanner : elles y sont enfouies. Pour l’ingénieur d’astreinte, un scanner qui produit des milliers de résultats par jour sans pouvoir les classer selon le risque réel en production revient presque à ne pas avoir de scanner.
Incident 3 — HexStrike-AI et la vague visant Citrix NetScaler (septembre 2025)
Check Point a documenté l’adoption de HexStrike-AI par des acteurs malveillants contre les failles Citrix NetScaler CVE-2025-7775, CVE-2025-7776 et CVE-2025-8424. Ce framework fondé sur MCP relie les LLM à plus de 150 outils de sécurité offensive. Les acteurs ont affirmé que l’outillage avait ramené le temps d’exploitation de plusieurs jours à moins de dix minutes.
Les PR générées par l’IA de notre jeu de données ne sont pas à l’origine de ces CVE. Mais, dans le cadre de notre travail avec les clients, nous voyons régulièrement des défenseurs utiliser des assistants IA pour écrire des règles WAF et des requêtes de détection — et ces règles présentent les mêmes angles morts en matière d’autorisation que le reste du jeu de données. L’asymétrie est brutale : l’attaquant orchestre plus de 150 outils depuis un seul serveur, tandis que de nombreux défenseurs trient encore manuellement les résultats des scanners.
Pourquoi la revue humaine n’est pas un filet de sécurité
Le chiffre de 78 % a été calculé après la revue humaine. La réponse traditionnelle au risque du code généré par l’IA a toujours été : « Faites une revue. » Les données montrent que cela ne suffit pas.
Trois raisons structurelles l’expliquent :
- Le temps consacré à la revue n’a pas suivi le volume des PR. Le temps médian de revue d’une PR dans le jeu de données était de 14 minutes. D’après notre expérience, vérifier manuellement un résultat comme BOLA prend de 60 à 90 minutes. Les réviseurs approuvent ce qu’ils peuvent lire dans le temps imparti.
- Le code généré par l’IA inspire un excès de confiance. L’étude utilisateur de Stanford citée plus haut a constaté que les développeurs utilisant un assistant IA écrivaient du code moins sûr et le jugeaient plus sûr. Le raisonnement est : « L’IA sait ce qu’elle fait, donc c’est probablement bon. »
- Les failles importantes ne se trouvent pas dans le diff. L’autorisation dépend du contexte général de l’application. Le diff montre un
findOne({ id })sur une ligne. La faille se trouve dans le routage environnant, le middleware d’authentification, le modèle de données et le déploiement. Une personne qui lit le diff ne peut pas le voir.
C’est pourquoi le filet de sécurité doit reposer sur le replay, et non sur la revue.
Ce qui fonctionne vraiment pour sécuriser le code généré par l’IA
Les équipes de notre jeu de données qui ont fait passer leur taux de 78 % à moins de 30 % en six mois avaient trois pratiques en commun :
- Elles ont ajouté un scan tenant compte du graphe au contrôle CI. Ni SAST à base d’expressions régulières, ni wrapper LLM. Un scan tenant compte du graphe, tel que Plexicus Deep Code Analysis, capable d’indiquer au réviseur : « Ce résultat est atteignable depuis ce point de terminaison avec cette classe de capacité. »
- Elles ont exigé une vérification par replay pour tout résultat atteignant
main. Pas seulement un niveau de gravité : une vérification par replay. Le diff ne pouvait pas être fusionné tant que la référence de replay n’était pas résolue. - Elles ont lié la remédiation aux mêmes éléments de preuve. La proposition de patch de remédiation incluait le nœud du graphe du résultat initial, la référence de replay et le diff proposé. Le réviseur pouvait approuver ou rejeter les deux au même endroit — la boucle décrite dans De l’alerte au correctif : AppSec fondée sur des preuves.
Voilà le processus opérationnel. Il n’a rien de magique. Ce n’est pas de l’IA. C’est une structure, du replay et une boucle de retour resserrée.
Que mesurer ensuite
Si vous êtes responsable de la sécurité et que vous évaluez votre propre taux de PR générées par l’IA, ne mesurez pas le nombre de vulnérabilités trouvées par le scanner. Ce chiffre se comptera toujours en milliers.
Le chiffre à suivre est le suivant :
Parmi les PR générées par l’IA et fusionnées dans
maincette semaine, combien contenaient un résultat qu’une étape de vérification fondée sur le replay aurait détecté ?
Si ce chiffre n’est pas nul, l’écart est structurel, et non procédural. Ajouter des réviseurs ne le comblera pas. Ajouter des scanners non plus. L’écart se résorbe lorsque l’étape de vérification fait partie du parcours de fusion, et non lorsqu’elle intervient après coup.
Questions fréquentes
Le code généré par l’IA est-il sécurisé ?
Pas par défaut. En 2025, les tests de Veracode portant sur plus de 100 modèles ont montré que 45 % des échantillons de code générés par l’IA échouaient aux tests de sécurité ; Georgetown CSET a trouvé des bugs exploitables dans près de la moitié des extraits produits par cinq modèles. Dans nos propres données de scan, 78 % des pull requests assistées par l’IA contenaient une vulnérabilité vérifiable par replay qu’un réviseur humain avait approuvée. Le code généré par l’IA nécessite au moins le même niveau de vérification que le code écrit par des humains, voire davantage.
Quelles sont les vulnérabilités les plus courantes du code généré par l’IA ?
Parmi les 14 213 PR assistées par l’IA que nous avons analysées, les failles d’authentification et d’autorisation formaient la catégorie la plus importante (31 % des résultats), suivies par les injections (22 %), les secrets codés en dur (14 %), les références directes non sécurisées aux objets (11 %) et les dépendances hallucinées ou typosquattées (8 %). Les failles d’autorisation telles que BOLA sont difficiles à repérer, car le code du diff semble correct.
Pourquoi la revue de code ne détecte-t-elle pas les vulnérabilités du code généré par l’IA ?
Les réviseurs lisent le diff, mais les failles telles que l’absence de contrôle de propriété se trouvent dans le routage, le middleware et le modèle de données, en dehors de celui-ci. Le temps de revue n’a pas non plus suivi l’augmentation du volume de PR liées à l’IA : la durée médiane dans notre jeu de données était de 14 minutes. Les recherches de Stanford montrent que les développeurs utilisant des assistants IA ont également tendance à surestimer la sécurité de leur code.
Comment renforcer la sécurité du code généré par l’IA dans CI/CD ?
Ajoutez un scan qui associe chaque résultat à un chemin d’atteignabilité plutôt qu’à une simple correspondance de motif, exigez une vérification par replay avant la fusion dans main de toute PR comportant un résultat, et rattachez le correctif aux mêmes éléments de preuve afin que les réviseurs approuvent ensemble le patch et sa justification. Les équipes de notre jeu de données ayant appliqué ces trois mesures ont fait passer leur taux sous les 30 % en six mois.
Qu’est-ce que le slopsquatting ?
Le slopsquatting consiste à enregistrer un nom de package inventé par les modèles d’IA. Les développeurs qui copient la commande d’installation suggérée téléchargent alors le package de l’attaquant. Lasso Security l’a démontré en publiant sur PyPI le package inexistant huggingface-cli, qui a reçu plus de 15 000 téléchargements réels en trois mois. Vérifier que chaque dépendance suggérée par l’IA existe et correspond à l’API attendue permet de bloquer ce risque.
Où cela nous mène
Le chiffre de 78 % ne critique pas les outils de programmation IA. Les mêmes outils qui ont produit le jeu de données ont également généré la majeure partie du code open source sur lequel Plexicus s’appuie. Ils améliorent globalement la vitesse de livraison.
Ce chiffre critique l’idée selon laquelle le code généré par l’IA peut être sécurisé avec le même processus de revue que celui utilisé pour le code écrit par des humains. Ce n’est pas le cas. Les modes de défaillance, le volume et les pièges cognitifs sont différents.
Les équipes qui réduiront l’écart au cours des douze prochains mois ne seront pas celles qui auront le plus de scanners. Ce seront celles dont le pipeline de fusion pourra prouver — replay après replay — que le code livré est bien celui qui a été examiné.
C’est le seuil à atteindre.
À lire également :
- Qu’est-ce que Deep Code Analysis ? Réduire les faux positifs SAST grâce à l’analyse d’atteignabilité — la couche qui détecte les 78 % avant qu’ils n’atteignent
main - Le playbook de remédiation autonome — que faire des résultats persistants
- De l’alerte au correctif : boucler la boucle avec l’AppSec fondée sur des preuves — l’ensemble du processus opérationnel