Qu’est-ce que le SAST ? Le guide complet du test statique de sécurité des applications en 2026
Un guide complet du SAST en 2026 : le fonctionnement de l’analyse statique, ce qu’elle trouve et ce qu’elle manque, l’origine des faux positifs et la façon de transformer une découverte en preuve.
Au-delà de l’ASPM
Une AppSec fondée sur la preuve pour les équipes qui développent avec l’IA
Plexicus utilise AI Swarm Pentest pour explorer des chemins d’application autorisés, valider ce qui est exploitable et fournir les preuves nécessaires pour prioriser la remédiation.
Découvrir AI Swarm PentestChaque bug de sécurité dans votre propre logiciel commence par une ligne de code.
Le test statique de sécurité des applications est l’une des plus anciennes méthodes automatisées pour chercher ces lignes avant que quiconque n’exécute le programme.
Le SAST analyse le code source, le bytecode ou les binaires sans exécuter l’application, et signale les modèles de code et les flux de données susceptibles de mener à une vulnérabilité, avec le fichier et la ligne où ils se trouvent.
L’OWASP décrit ces outils de la même façon : les outils d’analyse du code source, aussi appelés outils SAST, analysent le code source ou ses versions compilées pour aider à trouver des failles de sécurité. OWASP
L’idée est simple. La pratique ne l’est pas.
Un outil SAST peut signaler un modèle dangereux en quelques secondes. Il ne peut pas toujours vous dire si un attaquant peut atteindre ce modèle, quelles données se trouvent derrière, ni si l’alerte est réelle.
Cet écart compte davantage en 2026. Dans son Data Breach Investigations Report 2026, Verizon constate que l’exploitation de vulnérabilités est devenue le vecteur d’accès initial le plus fréquent dans les violations qu’il a analysées, avec 31 %, contre 20 % l’année précédente.
Ce guide explique ce qu’est le SAST, comment il fonctionne, ce qu’il trouve et ce qu’il manque, comment évaluer un outil, et comment transformer une découverte statique en preuve sur laquelle votre équipe peut agir.
Qu’est-ce que le SAST ?
Le test statique de sécurité des applications (SAST) est une méthode de test en boîte blanche qui inspecte le code d’une application, sans l’exécuter, pour trouver des faiblesses qui pourraient devenir des vulnérabilités de sécurité.
« Boîte blanche » signifie que l’outil voit l’intérieur de l’application : les fichiers source, les fonctions, les variables et la façon dont les données circulent entre eux.
« Statique » signifie que rien n’est exécuté. L’outil lit et modélise le code comme le fait un compilateur, puis applique des règles de sécurité à ce modèle.
Une découverte SAST typique répond à quatre questions :
- Quelle faiblesse a été trouvée, généralement associée à un identifiant CWE comme CWE-89 (injection SQL).
- Où elle se trouve : fichier, ligne et extrait de code.
- Comment des données non fiables l’atteignent, lorsque l’outil retrace un flux de données.
- Quelle gravité l’outil lui attribue.
L’OWASP cite ce niveau de localisation parmi les principaux points forts de la méthode : les résultats SAST signalent le code problématique par nom de fichier, emplacement, numéro de ligne et même l’extrait concerné. OWASP
C’est pour cela que les développeurs continuent de l’utiliser. Une découverte qui pointe vers la ligne 276 d’un fichier est plus facile à traiter qu’un rapport qui dit « la page de connexion est vulnérable ».
Que peut analyser un outil SAST ?
Selon l’outil, le SAST travaille sur une ou plusieurs de ces entrées :
- Le code source, l’entrée la plus courante : Java, Python, JavaScript, Go, C#, PHP, etc.
- Le bytecode, comme les classes Java compilées ou les assemblys .NET.
- Les binaires, lorsque le code source n’est pas disponible.
- Les fichiers d’infrastructure et de configuration, dans les outils qui étendent l’analyse statique à Terraform, aux Dockerfiles ou aux manifestes Kubernetes.
Certains outils ont besoin d’un code qui compile. L’OWASP note que de nombreux outils SAST ont du mal à analyser du code qui ne peut pas être compilé, et que les analystes manquent souvent des bonnes bibliothèques, des instructions de build ou de la base de code complète. OWASP
Le SAST est-il la même chose que l’analyse statique du code ?
Presque.
L’analyse statique du code est la technique au sens large : toute lecture automatisée du code sans l’exécuter, y compris les contrôles de style, les détecteurs de bugs et les vérificateurs de types.
Le SAST est une analyse statique du code avec un objectif de sécurité. Il utilise les mêmes techniques de compilation, mais ses règles cherchent des vulnérabilités, pas des problèmes de formatage ou de performance.
Pourquoi le SAST compte en 2026
Le SAST n’est pas nouveau. Quatre évolutions le rendent plus pertinent aujourd’hui, pas moins.
1. Les vulnérabilités exploitées sont la première porte d’entrée
Le DBIR 2026 de Verizon attribue à l’exploitation de vulnérabilités 31 % des violations qu’il a analysées. L’abus d’identifiants, auparavant en tête, est tombé à 13 %, en partie parce que Verizon compte désormais le prétexting comme un vecteur distinct. Verizon DBIR
Toutes les vulnérabilités exploitées ne sont pas des failles de code dans votre propre application : le chiffre du rapport couvre les vulnérabilités de n’importe quel logiciel, y compris les produits tiers.
Mais la part qui se trouve dans votre propre code est celle que seule votre équipe peut corriger, et le SAST est le premier contrôle automatisé qui la lit.
2. Les classes de bugs les plus anciennes restent en tête
Le CWE Top 25 2025 des faiblesses logicielles les plus dangereuses, publié par le programme CWE du MITRE, classe le cross-site scripting (CWE-79) en première position et l’injection SQL (CWE-89) en deuxième.
Ce sont deux failles d’injection que le SAST a été conçu pour trouver.
En mars 2024, la CISA et le FBI ont publié une Secure by Design Alert conjointe sur l’élimination de l’injection SQL. Elle note que l’injection SQL reste une classe de vulnérabilité répandue, malgré deux décennies de documentation et des mesures d’atténuation efficaces.
3. Une part croissante du code est écrite par des assistants d’IA
Les assistants de codage par IA écrivent du code plus vite que les personnes ne peuvent le relire.
Dans son GenAI Code Security Report 2026, publié en juillet 2026, Veracode indique qu’environ 44 % des tâches de génération de code par IA qu’il a testées ont produit du code contenant une vulnérabilité connue. Le taux moyen de réussite aux tests de sécurité, tous modèles confondus, était de 56 %, à peine différent des 55 % de son premier rapport. Ces résultats sont publiés par un fournisseur de sécurité, pas issus d’une réplication indépendante.
Quel que soit le taux exact dans votre base de code, davantage de code généré signifie davantage de code que quelqu’un, ou quelque chose, doit vérifier.
4. Les cadres de développement sécurisé demandent une analyse du code
Le Secure Software Development Framework (SP 800-218) du NIST comprend une pratique qui consiste à relire et/ou analyser le code lisible par l’humain pour identifier les vulnérabilités, afin de les corriger avant la publication du logiciel.
La tâche PW.7.2 demande aux équipes d’effectuer la revue ou l’analyse du code selon leurs normes de codage sécurisé, puis de consigner et trier tous les problèmes découverts et les remédiations recommandées dans le workflow ou l’outil de suivi des tickets de l’équipe.
Le SAST est un moyen courant de satisfaire à grande échelle la partie « analyse du code » de cette tâche.
SAST et DAST
Le SAST et le DAST sont les deux méthodes de test les plus connues, et ils observent une application depuis des côtés opposés.
| SAST | DAST | |
|---|---|---|
| Point de vue | De l’intérieur : lit le code | De l’extérieur : envoie des requêtes à une application en cours d’exécution |
| Prérequis | Code source, bytecode ou binaires | Une application déployée et en cours d’exécution |
| Quand | Dès le premier commit | Une fois l’application construite et déployée dans un environnement de test |
| Résultats | Fichier, ligne et chemin de code | URL, requête, réponse et comportement observé |
| Points forts | Modèles d’injection, API non sûres, problèmes de flux de données | Comportement à l’exécution, configuration, réponses du serveur |
| Points faibles | Contexte d’exécution, configuration, preuve de l’exploitabilité | Localiser la ligne vulnérable, code jamais atteint par le crawler |
Le SAST vous dit où une faiblesse pourrait se trouver. Le DAST vous dit ce que fait réellement l’application en cours d’exécution.
L’un ne remplace pas l’autre. Pour une comparaison plus détaillée, consultez SAST et DAST : la différence et pourquoi utiliser les deux.
SAST et SCA
L’analyse de la composition logicielle (SCA) examine le code que vous n’avez pas écrit.
Elle inventorie les paquets open source et les autres composants tiers, puis compare leurs versions aux vulnérabilités connues.
Le SAST examine le code que vous avez écrit : vos fonctions, vos requêtes, vos handlers.
| SAST | SCA | |
|---|---|---|
| Périmètre | Code propriétaire | Composants tiers et leurs versions |
| Trouve | Des failles de code, souvent sans CVE | Des vulnérabilités connues, généralement avec un CVE |
| Correction typique | Modifier votre code | Mettre à jour, remplacer ou patcher le composant |
Il vous faut les deux. Une bibliothèque vulnérable et une faille d’injection dans votre propre handler sont des problèmes différents, avec des corrections différentes.
SAST et revue de code manuelle
Le SSDF du NIST trace clairement cette limite. Dans la tâche PW.7.1, la revue de code signifie qu’une personne examine directement le code pour trouver des problèmes, et l’analyse de code signifie que des outils sont utilisés pour trouver des problèmes dans le code, de façon entièrement automatisée ou avec une personne. NIST SP 800-218
Les deux sont complémentaires :
- Le SAST est rapide, reproductible et infatigable. Il lit chaque ligne à chaque commit.
- Un relecteur humain comprend l’intention. Il remarque qu’un point de terminaison « supprimer le compte » ne vérifie jamais qui fait la demande.
Le meilleur usage du SAST est de libérer les relecteurs de la recherche de modèles connus, pour qu’ils consacrent leur attention à la conception et à la logique.
Comment fonctionne le SAST
Chaque moteur SAST est différent, mais la plupart suivent les mêmes six étapes.
1. Analyser le code et en construire un modèle
L’outil lit chaque fichier et le transforme en représentation structurée, généralement un arbre syntaxique abstrait (AST), puis une représentation intermédiaire plus proche de celle qu’utilise un compilateur.
L’analyse lexicale vient en premier. L’OWASP la décrit comme la conversion de la syntaxe du code source en tokens, afin d’abstraire le code et de le rendre plus facile à manipuler. OWASP
2. Construire le flux de contrôle et le flux de données
L’outil détermine ensuite comment le programme peut s’exécuter.
Un graphe de flot de contrôle représente le code sous forme de blocs de base reliés par les sauts entre eux. L’analyse des flux de données suit ensuite la façon dont les valeurs circulent dans ces blocs. OWASP
Les meilleurs moteurs le font à travers les fonctions, les fichiers et les modules (analyse interprocédurale), car les vraies vulnérabilités tiennent rarement dans une seule fonction.
3. Repérer les sources, les sinks et les sanitizers
C’est ici qu’intervient la sécurité.
- Les sources sont les endroits où entrent des données non fiables : paramètres de requête, en-têtes, fichiers, messages.
- Les sinks sont les opérations dangereuses : une requête SQL, une commande shell, une réponse HTML, un chemin de fichier.
- Les sanitizers et les API sûres rendent les données sûres pour un sink donné, ou les tiennent à l’écart de la partie dangereuse de l’appel : encodage de sortie, normalisation des chemins, requêtes paramétrées.
4. Appliquer les règles
Le moteur applique son jeu de règles au modèle.
Certaines règles sont de simples modèles (« cette fonction de hachage faible est appelée »). D’autres sont des règles de taint : l’OWASP décrit l’analyse de taint comme l’identification des variables contaminées par une entrée contrôlable par l’utilisateur, puis leur suivi jusqu’à une fonction vulnérable, le sink ; si la valeur contaminée atteint le sink sans avoir été nettoyée, elle est signalée. OWASP
Voici le cas classique en Java :
// Source: an attacker-controlled request parameter
String username = request.getParameter("username");

// Sink: the value is concatenated into a SQL string
String sql = "SELECT * FROM accounts WHERE username = '" + username + "'";
ResultSet rs = statement.executeQuery(sql);
Une règle de taint voit username passer de getParameter à executeQuery sans aucun sanitizer entre les deux, et signale une injection SQL (CWE-89) à la ligne de la requête.
La correction supprime le sink dangereux. Une requête paramétrée envoie la valeur en tant que donnée, jamais en tant que texte SQL :
String sql = "SELECT * FROM accounts WHERE username = ?";
PreparedStatement ps = connection.prepareStatement(sql);
ps.setString(1, username);
ResultSet rs = ps.executeQuery();
5. Signaler la découverte
Chaque découverte reçoit un type de faiblesse (généralement un CWE), un emplacement, une gravité et, dans les meilleurs outils, la trace de la source jusqu’au sink.
L’OWASP cite l’interopérabilité des résultats parmi ses critères de sélection et renvoie vers SARIF, le Static Analysis Results Interchange Format. SARIF 2.1.0 est un standard OASIS qui définit un format commun pour les résultats des outils d’analyse statique. Les résultats de différents scanners peuvent alors être lus par les mêmes tableaux de bord et plateformes d’hébergement de code.
Voici comment une découverte issue d’une source SAST apparaît dans la plateforme Plexicus, avec son emplacement dans le code :
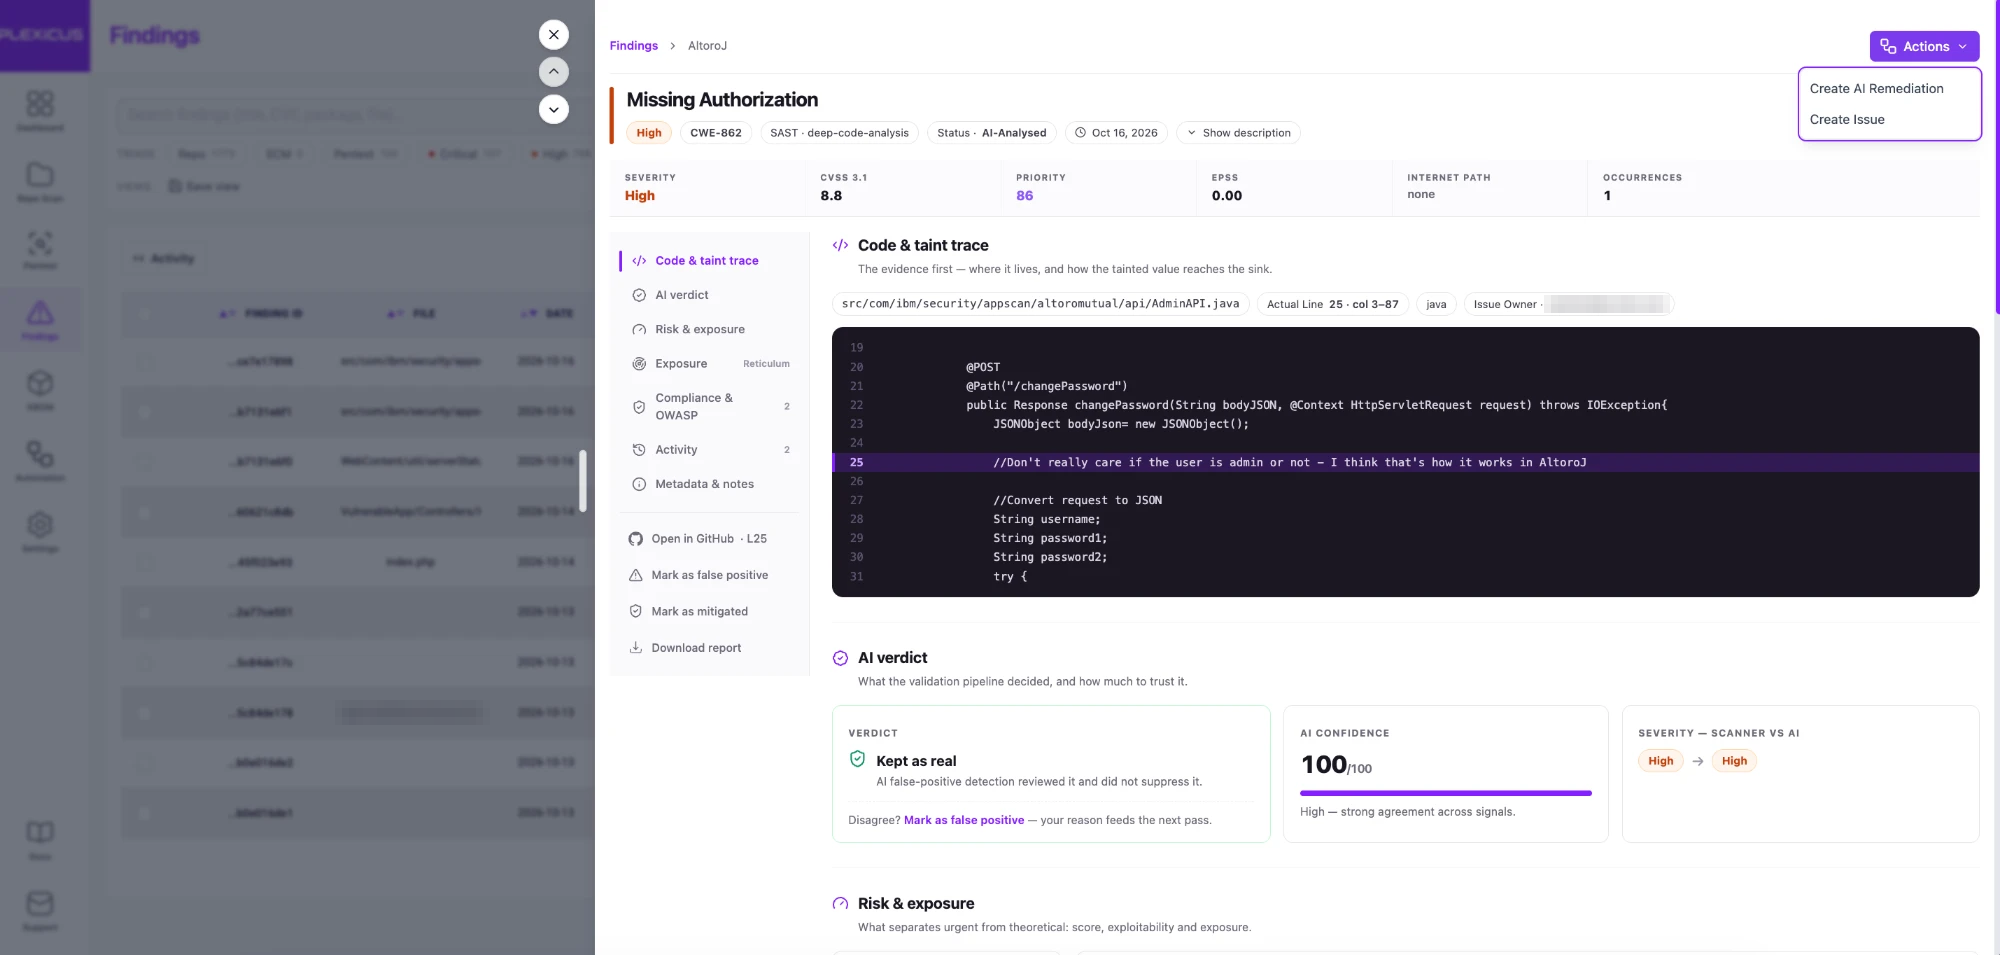
Capture d’écran : le détail d’une découverte d’autorisation manquante (CWE-862) dans une application Java de démonstration, dans la plateforme Plexicus, avec le libellé de source SAST et la section Code & taint trace ouverte sur la ligne signalée. Le panneau du verdict d’IA et le menu Actions sont visibles. Données de démonstration, capturées en octobre 2026 ; l’adresse e-mail du propriétaire du ticket est pixellisée.
6. Trier
Une personne, ou une seconde passe automatisée, décide de ce que signifie chaque découverte.
Est-elle réelle, et est-elle atteignable ? Est-elle importante, et qui est responsable de la correction ?
C’est au triage que la plupart des programmes SAST réussissent ou échouent. Un outil qui produit des découvertes plus vite que l’équipe ne peut les trier produit un backlog, pas de la sécurité.
Techniques d’analyse statique
Les moteurs SAST combinent certaines des techniques ci-dessous. Chacune fait un compromis différent entre vitesse, précision et profondeur.
Correspondance de modèles
Le moteur recherche dans l’arbre syntaxique, ou parfois dans le texte brut, des constructions connues comme dangereuses : un appel à un chiffrement faible, un identifiant codé en dur, une vérification de certificat désactivée.
Points forts : rapide, règles faciles à écrire, résultats faciles à expliquer.
Limites : aucune compréhension de l’origine des données ; elle signale donc des usages sûrs et manque des usages dangereux qui se présentent autrement.
Analyse des flux de données et analyse de taint
Le moteur suit les valeurs des sources jusqu’aux sinks à travers le programme, comme dans l’exemple Java ci-dessus.
Points forts : trouve les failles d’injection avec le chemin qui les explique ; moins d’alertes sur le code qui ne reçoit jamais d’entrée non fiable.
Limites : plus lente ; la précision dépend de la qualité avec laquelle l’outil modélise les frameworks, les bibliothèques et les sanitizers ; les très gros programmes imposent des approximations.
Modèles sémantiques et structurels
Certains moteurs construisent un modèle plus riche de l’application : ses points de terminaison, ses paramètres, son graphe d’appels et les rôles qui peuvent atteindre chaque chemin.
Points forts : peut relier une faiblesse au point de terminaison qui l’expose et aux données qui se trouvent derrière, ce dont le triage a besoin.
Limites : plus difficile à construire, et cela reste un modèle. Il décrit ce que le code pourrait faire, pas ce qu’un attaquant a fait.
Analyse assistée par IA
Les outils plus récents ajoutent de grands modèles de langage pour expliquer les découvertes, suggérer des corrections ou filtrer le bruit.
Points forts : explications lisibles ; peut raisonner sur du code que les règles décrivent mal.
Limites : un modèle de langage qui lit un extrait n’établit pas, à lui seul, comment une faiblesse affecte l’application en cours d’exécution. Il a toujours besoin des faits structurels et, idéalement, d’une preuve.
Pour comprendre pourquoi greffer un modèle de langage sur de la correspondance de modèles ne suffit pas, consultez Qu’est-ce que Deep Code Analysis ?.
Ce que le SAST trouve bien
L’OWASP cite les dépassements de tampon et l’injection SQL comme exemples de vulnérabilités bien connues que les outils SAST identifient, et note qu’ils passent bien à l’échelle : ils peuvent s’exécuter sur de nombreux logiciels, et de façon répétée, comme avec les builds nocturnes ou l’intégration continue. OWASP
En pratique, le SAST est le plus efficace sur les failles visibles dans le code lui-même :
| Faiblesse | CWE | Pourquoi le SAST la voit |
|---|---|---|
| Cross-site scripting | CWE-79 | des données non fiables arrivent dans une réponse HTML sans encodage |
| Injection SQL | CWE-89 | des données non fiables arrivent dans une chaîne de requête |
| Injection de commandes du système d’exploitation | CWE-78 | des données non fiables arrivent dans un appel shell |
| Traversée de chemin | CWE-22 | des données non fiables arrivent dans un chemin de fichier |
| Injection de code | CWE-94 | des données non fiables arrivent dans un évaluateur |
| Écriture hors limites | CWE-787 | opérations mémoire non sûres en C et C++ |
| Utilisation d’identifiants codés en dur | CWE-798 | un secret littéral apparaît dans le code |
Les six premières de ces faiblesses figurent dans le CWE Top 25 2025. MITRE CWE
Ce que le SAST manque
L’OWASP est direct sur les limites. Sa liste des faiblesses du SAST comprend : OWASP
- De nombreux types de vulnérabilités sont difficiles à trouver automatiquement, notamment les problèmes d’authentification, les problèmes de contrôle d’accès et l’usage non sécurisé de la cryptographie.
- Les outils actuels ne peuvent identifier automatiquement qu’un pourcentage relativement faible des failles de sécurité applicative.
- Un nombre élevé de faux positifs.
- Ils sont souvent incapables de trouver les problèmes de configuration, car ceux-ci ne sont pas représentés dans le code.
- Il est difficile de prouver qu’un problème identifié est une vulnérabilité réelle.
Ces limites concordent avec l’OWASP Top 10
. Sa première catégorie est Broken Access Control et sa deuxième Security Misconfiguration : les deux types de risque avec lesquels l’analyse statique a le plus de mal.Trois autres angles morts découlent du fonctionnement du SAST :
Logique métier
Un outil statique ne sait pas qu’un utilisateur ne doit télécharger que ses propres factures. Si le code vérifie la session mais pas la propriété, chaque ligne semble correcte.
Exécution et environnement
Des en-têtes définis par un proxy, un feature flag en production, un paramètre cloud trop permissif : rien de tout cela ne figure dans le dépôt que lit l’outil.
Exploitabilité
Un chemin contaminé dans le code est une hypothèse. Savoir si un attaquant peut l’atteindre depuis internet, avec quels privilèges, et ce que cela lui apporte, est une autre question.
Le SAST répond à « où cela pourrait-il mal tourner ? ». Il ne répond pas à « quelqu’un peut-il vraiment nous faire cela ? ».
Pourquoi le SAST produit des faux positifs
Un faux positif est une découverte qui n’est pas une vraie vulnérabilité.
L’OWASP explique la cause profonde : l’outil ne peut souvent pas être certain de l’intégrité et de la sécurité des données lorsqu’elles traversent l’application de l’entrée à la sortie, et il ne peut pas suivre les données à travers des composants propriétaires fermés ou des systèmes externes. OWASP
Le moteur doit donc choisir. Lorsqu’il ne peut pas prouver qu’un chemin est sûr, il peut soit se taire au risque d’un faux négatif, soit signaler au risque d’un faux positif. Un outil de sécurité qui signale dans cette situation produit exactement les faux positifs que décrit l’OWASP.
Causes fréquentes :
- Des sanitizers personnalisés que l’outil ne reconnaît pas.
- La magie des frameworks : injection de dépendances, annotations ou ORM que l’outil ne modélise pas.
- Du code mort ou de test qui ne s’exécute jamais en production.
- Un contexte manquant : l’entrée est déjà validée par une passerelle que l’outil ne voit pas.
À partir de quand y en a-t-il « trop » ?
Google a publié l’une des réponses les plus claires. Dans « Lessons from Building Static Analysis Tools at Google » (Communications of the ACM, 2018), ses ingénieurs définissent un faux positif effectif comme un problème sur lequel les développeurs n’ont pas agi après l’avoir vu, même si le problème était techniquement correct.
Leurs contrôles en revue de code doivent produire moins de 10 % de faux positifs effectifs, et si la part des clics « Not useful » pour un analyseur dépasse 10 %, l’équipe désactive cet analyseur jusqu’à ce que ses auteurs l’améliorent. Il s’agit de la pratique interne de Google, rapportée par ses propres ingénieurs.
La leçon pour toute équipe : ce sont les développeurs, pas les auteurs de l’outil, qui décident si un outil est précis. Une découverte sur laquelle personne n’agit coûte de l’attention et ne corrige rien.
Les faux négatifs comptent aussi
Un outil silencieux n’est pas un outil sûr.
Un faux négatif est une vraie vulnérabilité que l’outil a manquée. Régler un scanner jusqu’à ce qu’il ne signale plus rien de gênant est le moyen le plus simple d’obtenir un tableau de bord propre et une application vulnérable.
Comment évaluer un outil SAST
La liste des critères de sélection de l’OWASP est une bonne liste de départ : OWASP
- La prise en charge de vos langages de programmation.
- La capacité à détecter les vulnérabilités qui vous importent, comme celles de l’OWASP Top Ten.
- La précision : taux de faux positifs et de faux négatifs, et score à l’OWASP Benchmark.
- La compréhension des bibliothèques et frameworks que vous utilisez.
- Le besoin ou non d’un code source compilable, et la capacité à analyser des binaires.
- Les plugins d’IDE, la facilité de mise en place et l’intégration à la CI/CD.
- L’interopérabilité des résultats, par exemple SARIF.
Utilisez les benchmarks publics, puis votre propre code
Trois ressources publiques vous aident à comparer des outils sur une vérité de terrain connue :
- OWASP Benchmark. Une suite de tests exécutable en Java et en Python, conçue pour vérifier la vitesse et la précision des outils de détection de vulnérabilités, avec des générateurs de tableaux de résultats pour les outils courants. Son objectif est que chaque vulnérabilité qu’elle note soit réellement exploitable. OWASP Benchmark
- Suites de tests Juliet. Rédigées par le Center for Assured Software de la NSA et hébergées dans le Software Assurance Reference Dataset du NIST. La suite Juliet actuelle pour C et C++ contient à elle seule 64 099 cas de test répartis sous 118 CWE. NIST SARD
- NIST SATE. La Static Analysis Tool Exposition est une étude récurrente et non compétitive de l’efficacité des outils d’analyse statique. Le NIST précise que son but n’est pas de choisir le « meilleur » outil, car les outils ont des points forts différents. Six éditions ont eu lieu, la dernière publiée en septembre 2019. NIST SATE
Les benchmarks sont synthétiques. Le test qui compte, c’est votre propre dépôt : lancez chaque candidat sur le même code, puis demandez à un ingénieur de trier un échantillon de découvertes et de compter combien mènent à une vraie correction.
Pour une liste d’outils par laquelle commencer cette comparaison, consultez notre sélection d’outils SAST pour le développement sécurisé.
Bonnes pratiques SAST
1. Commencer par un petit jeu de règles de confiance
Activez les règles sur lesquelles votre équipe agira : injection, désérialisation non sécurisée, secrets codés en dur, cryptographie faible. Élargissez une fois que les premières découvertes sont corrigées.
2. Bloquer les nouvelles découvertes dans les pull requests, mettre le reste en référence
Les développeurs acceptent un retour sur le code qu’ils viennent d’écrire. Ils ignorent un commentaire de pull request qui liste 400 problèmes datant de 2019.
Analysez donc chaque pull request uniquement pour les nouvelles découvertes, et consignez les découvertes existantes dans une référence que vous résorbez par ordre de risque, selon votre propre calendrier.
Le SAST est le plus utile lorsqu’il s’exécute là où les développeurs travaillent déjà. Une organisation courante :
IDE            -> instant feedback while typing
Pull request   -> scan only the changed code, comment on the diff
CI pipeline    -> full rule set, block on agreed severities
Scheduled scan -> whole repository, new rules, old code
L’OWASP note que les outils intégrés à l’IDE donnent aux développeurs un retour immédiat sur les problèmes qu’ils pourraient introduire, ce qui est très utile par rapport à la découverte de vulnérabilités bien plus tard. OWASP
3. Apprendre votre code à l’outil
Déclarez vos sanitizers personnalisés, vos validateurs et vos wrappers de frameworks. Chaque élément déclaré supprime toute une famille de faux positifs.
4. Suivre les faux positifs effectifs
Reprenez l’idée de Google : mesurez la fréquence à laquelle les développeurs agissent sur une découverte. Une règle sur laquelle personne n’agit doit être corrigée ou supprimée.
5. Prioriser selon l’atteignabilité et l’exposition
Une injection SQL dans un point de terminaison exposé à internet n’est pas la même chose qu’une injection dans un script batch interne. Classez les découvertes selon ce qui peut les atteindre et ce qu’elles peuvent atteindre.
6. Consigner et trier dans le workflow des développeurs
C’est ce que demande le NIST dans PW.7.2 : des découvertes et des remédiations recommandées consignées et triées dans le workflow ou l’outil de suivi des tickets de l’équipe. Un rapport PDF envoyé par e-mail une fois par trimestre a peu de chances d’y répondre.
7. Valider avant d’escalader, retester après la correction
Avant qu’une découverte statique ne devienne un ticket critique, essayez de la prouver. Un exploit reproduit, ou au moins un chemin atteignable confirmé, change la vitesse à laquelle une équipe avance.
Une correction n’est pas terminée quand la pull request est fusionnée. Relancez l’analyse, et idéalement la preuve, pour confirmer que la faiblesse a disparu et que la correction ne l’a pas déplacée ailleurs.
Erreurs SAST courantes
Erreur 1 : faire du nombre de découvertes l’indicateur
Plus de découvertes ne signifie pas plus de sécurité. Comptez plutôt les problèmes corrigés et validés, et le délai de correction.
Erreur 2 : activer toutes les règles dès le premier jour
Le résultat : des milliers de découvertes à trier d’un coup, et une équipe qui apprend à ignorer l’outil.
Erreur 3 : bloquer les builds sur des découvertes non vérifiées
Un contrôle bloquant qui échoue sur des faux positifs finit contourné. Ne bloquez que sur des règles qui ont fait leurs preuves.
Erreur 4 : croire qu’une analyse propre signifie une application sécurisée
La propre liste de l’OWASP indique que les problèmes de contrôle d’accès et d’authentification sont difficiles à trouver automatiquement pour le SAST, et que les problèmes de configuration passent souvent inaperçus. Un rapport SAST propre en dit peu à leur sujet.
Erreur 5 : remettre la correction à « plus tard »
Une découverte sans responsable ni changement proposé est une note, pas un contrôle de sécurité.
SAST et code généré par IA
Les assistants de codage par IA changent le volume du problème, pas sa nature.
Les faiblesses du code généré sont les mêmes que d’habitude : injection, autorisation manquante, cryptographie faible, secrets dans le code. Le premier rapport de Veracode sur le sujet, une étude de fournisseur publiée en 2025, a trouvé le cross-site scripting parmi les problèmes les plus fréquents dans les échantillons générés qu’il a testés. Veracode
Ce qui change, c’est le rythme. Quand un développeur accepte une suggestion de 200 lignes en quelques secondes, la relecture qui se faisait pendant la saisie n’a plus lieu du tout.
Trois ajustements aident :
- Analyser là où le code est accepté. Les analyses dans l’IDE et dans les pull requests comptent davantage quand le code arrive en gros blocs.
- Ne pas laisser l’assistant noter son propre travail. L’outil qui a écrit le code n’en est pas un contrôle indépendant.
- Garder la preuve dans la boucle. Du code généré qui « a l’air correct » mérite la même validation que n’importe quel autre code.
Normes et cadres qui exigent une analyse du code
NIST SSDF (SP 800-218)
L’édition finale en vigueur a été publiée en février 2022. La pratique PW.7 couvre la revue ou l’analyse du code lisible par l’humain, et la tâche PW.7.2 demande que les découvertes soient consignées et triées. NIST
Le NIST a publié un projet de révision, SP 800-218 Rev. 1, le 17 décembre 2025 ; sa période de commentaires s’est terminée le 30 janvier 2026, et il reste à l’état de projet. NIST
OWASP Top 10
L’édition actuelle de la liste de sensibilisation de l’OWASP. L’injection est en A05 ; Broken Access Control est en A01. Le SAST couvre bien une partie de la liste et mal une autre, comme vu plus haut. OWASP
CWE Top 25 (2025)
Le classement du MITRE des faiblesses logicielles les plus dangereuses. Les identifiants CWE donnent aux outils un langage commun : une découverte associée à CWE-89 désigne une injection SQL quel que soit l’outil. MITRE CWE
OWASP ASVS
L’Application Security Verification Standard, dont la dernière version stable est la 5.0.0, liste des exigences détaillées de vérification de la sécurité. Certaines peuvent être vérifiées en lisant le code ; d’autres nécessitent des tests ou une revue. OWASP ASVS
SARIF
Le format standard OASIS pour les résultats d’analyse statique. Il vous permet de remplacer ou de combiner des scanners sans reconstruire votre reporting. La version 2.1.0 est le standard approuvé ; un projet de comité de la prochaine version a été publié en octobre 2026. OASIS
De la découverte SAST à la preuve
Voici le bilan honnête du SAST.
C’est le meilleur outil dont vous disposez pour lire chaque ligne de votre code, chaque jour.
C’est aussi, de l’aveu même de l’OWASP, un outil qui ne trouve automatiquement qu’une part relativement faible des failles de sécurité, produit des faux positifs et a du mal à prouver que ce qu’il a trouvé est exploitable.
Un test d’intrusion se situe à l’autre extrémité : il tente d’exploiter le système en cours d’exécution comme le ferait un attaquant.
Là où le SAST dit « ce chemin de code pourrait permettre une injection SQL », un pentest dit « nous avons extrait ces enregistrements via cette requête ». C’est la différence entre une hypothèse et une preuve.
La question n’est donc pas « le SAST ou autre chose ». C’est ce qui se passe après la découverte :
Static finding    -> "this code path might be vulnerable"
Code context      -> "this is the endpoint, the data and the role behind it"
Validation        -> "here is the evidence that it can be exploited"
Reviewed fix      -> "here is the change, with the reasoning and a test"
Re-test           -> "the proof no longer reproduces"
Cette chaîne est ce que nous appelons Proof-Driven AppSec. Sa règle est courte : no PoC, no finding.
Une alerte statique est le point de départ du travail. Ce sont les preuves qui font avancer une équipe.
La place de Plexicus
Plexicus traite le SAST comme le premier signal, puis ajoute le contexte, la preuve et la correction.
Commencer par une analyse. L’outil SAST gratuit analyse votre code source GitHub avec un accès en lecture seule. Plexicus indique ne stocker aucun code et ne pas l’utiliser pour entraîner l’IA.
Le rapport liste les vulnérabilités détectées avec une répartition par gravité, des références CVE et un score CVSS. L’analyse gratuite se connecte aujourd’hui à GitHub ; GitLab et Bitbucket sont annoncés comme bientôt disponibles.
Ajouter du contexte. Deep Code Analysis relie le code, le flux de données et l’impact métier. Sa page produit énonce clairement la différence : le SAST peut signaler un modèle et un modèle de langage peut expliquer du code, mais aucun des deux n’établit comment une faiblesse affecte l’application.
Deep Code Analysis retrace le chemin de code concerné, afin que les ingénieurs voient les points de terminaison, les paramètres et la logique métier qu’une découverte touche, associe chaque découverte aux données qu’elle peut atteindre et au rôle qui peut la déclencher, et rattache la classe de faiblesse à un CWE. La page liste 12 langages : JavaScript, TypeScript, Python, Go, Java, Rust, Ruby, PHP, C#, Swift, Kotlin et Scala.
Le prouver. Deep Code Analysis ajoute le contexte et AI Swarm Pentest valide les découvertes les plus prioritaires. AI Swarm Pentest valide les chemins exploitables dans votre application, votre API et votre code source, dans un périmètre autorisé, avec une vérification indépendante et sans aucun changement automatique en production. Notre présentation d’AI Swarm Pentest explique le fonctionnement de l’essaim d’agents.
Le corriger. Une fois une découverte vérifiée, Plexicus Remediation prépare le contexte de remédiation et un changement suggéré. Pour les découvertes SAST classiques comme l’injection SQL, le XSS, la SSRF, la désérialisation non sécurisée et la cryptographie faible, Plexicus prépare des patchs relus accompagnés de tests de régression lorsque c’est pertinent, et un déclencheur de retest est relié à la CI. Votre équipe garde la maîtrise de la fusion : Plexicus ne pousse jamais en production.
Voici à quoi ressemble une découverte statique d’injection SQL une fois une correction proposée :
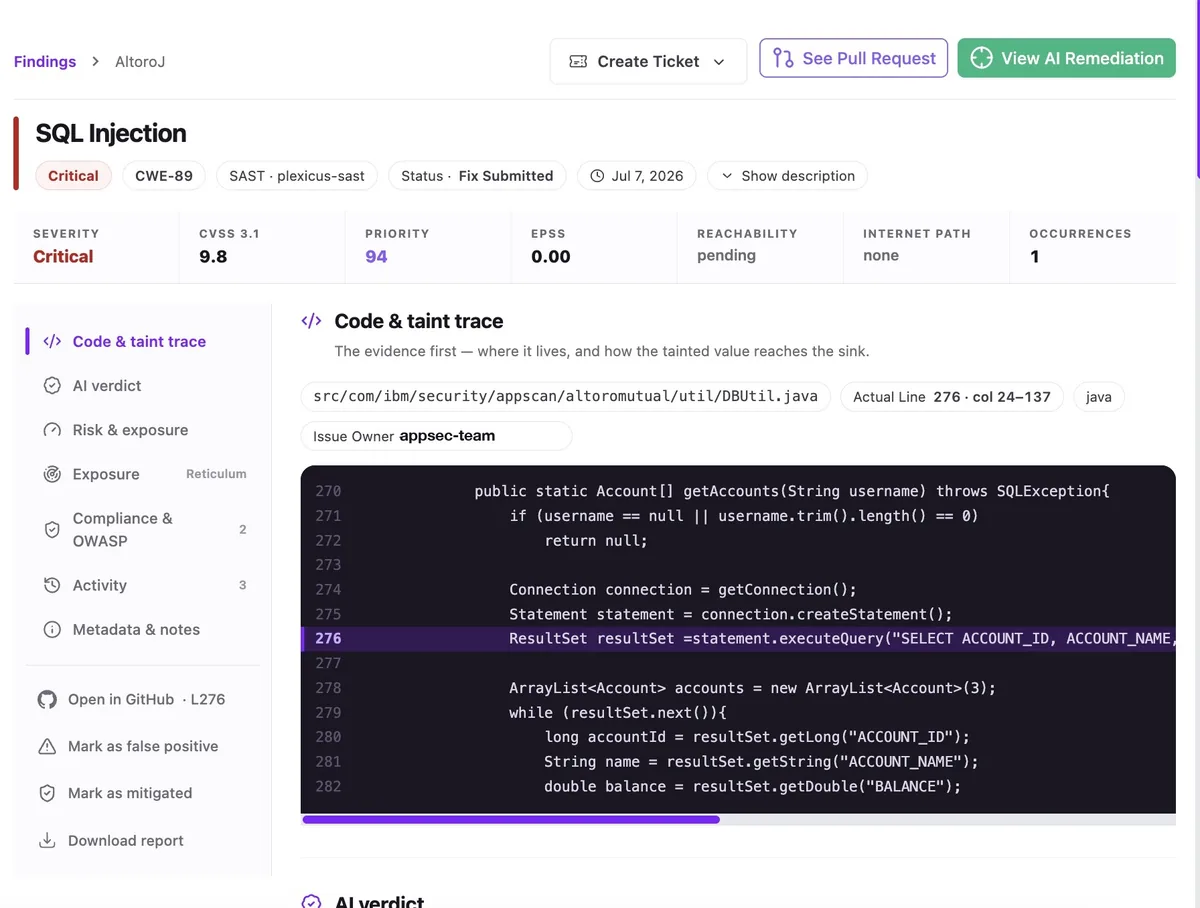
Capture d’écran : une découverte critique d’injection SQL (CWE-89) dans une application Java de démonstration, avec le libellé de source SAST et le statut Fix Submitted, affichée dans la plateforme Plexicus. La barre d’outils propose Create Ticket, See Pull Request et View AI Remediation. Données de démonstration issues d’une version antérieure de l’interface Plexicus, juillet 2026.
Mis bout à bout, cela forme une boucle fermée avec PR : un signal statique, du contexte, des preuves pour ce qui compte, puis un changement relu que votre équipe décide de fusionner.
Pour voir la place du SAST dans un programme complet, lisez notre guide complet de la sécurité des applications. Pour ce qui se passe après la validation, consultez Présentation de la remédiation native IA.
Foire aux questions
Que signifie SAST ?
SAST signifie static application security testing, ou test statique de sécurité des applications : l’analyse du code d’une application à la recherche de faiblesses de sécurité, sans l’exécuter.
Quelle est la différence entre le SAST et le DAST ?
Le SAST lit le code de l’intérieur sans l’exécuter. Le DAST teste une application en cours d’exécution depuis l’extérieur en lui envoyant des requêtes. Le SAST désigne la ligne ; le DAST montre le comportement réel à l’exécution.
Quelle est la différence entre le SAST et la SCA ?
Le SAST analyse le code écrit par votre équipe. La SCA inventorie les composants tiers et open source et compare leurs versions aux vulnérabilités connues.
Quelles vulnérabilités le SAST peut-il trouver ?
Le SAST est le plus efficace sur les failles visibles dans le code : injection SQL, cross-site scripting, injection de commandes, traversée de chemin, injection de code, opérations mémoire non sûres et identifiants codés en dur.
Que le SAST ne peut-il pas trouver ?
Selon l’OWASP, le SAST a du mal avec les problèmes d’authentification, les problèmes de contrôle d’accès, l’usage non sécurisé de la cryptographie et les problèmes de configuration, et il a du mal à prouver qu’une découverte est exploitable. Les failles de logique métier lui restent aussi largement invisibles.
Pourquoi le SAST produit-il autant de faux positifs ?
Quand un outil ne peut pas prouver que des données sont sûres pendant leur trajet de l’entrée à la sortie, il les signale généralement. Les sanitizers personnalisés, les frameworks que l’outil ne modélise pas et l’absence de contexte d’exécution sont les causes les plus fréquentes.
Comment réduire les faux positifs du SAST ?
Commencez par un petit jeu de règles, déclarez vos sanitizers et vos wrappers de frameworks, n’analysez que le nouveau code dans les pull requests, suivez la fréquence à laquelle les développeurs agissent sur les découvertes, et validez les découvertes de gravité élevée avant de les escalader.
Le SAST est-il obligatoire pour la conformité ?
Des cadres comme le SSDF du NIST demandent une revue ou une analyse du code, avec des découvertes consignées et triées, mais ils ne désignent aucun outil précis. Le SAST est un moyen courant de satisfaire à grande échelle la partie analyse du code.
Le SAST suffit-il à lui seul ?
Non. Le SAST est une couche. Un programme a aussi besoin de la SCA pour les dépendances, de tests à l’exécution et d’un moyen de prouver quelles découvertes sont exploitables avant que l’équipe ne passe du temps à les corriger.
Faites prouver chaque découverte statique
Lisez chaque ligne avec le SAST, puis ne consacrez le temps de votre équipe qu’à ce qui peut être prouvé.
Découvrir Plexicus Deep Code Analysis →
Vous voulez un premier aperçu de votre propre code ? Lancez l’outil SAST gratuit, une analyse statique de votre code source GitHub.