Framework MAESTRO: guía práctica de 7 capas para modelar amenazas en la IA agéntica
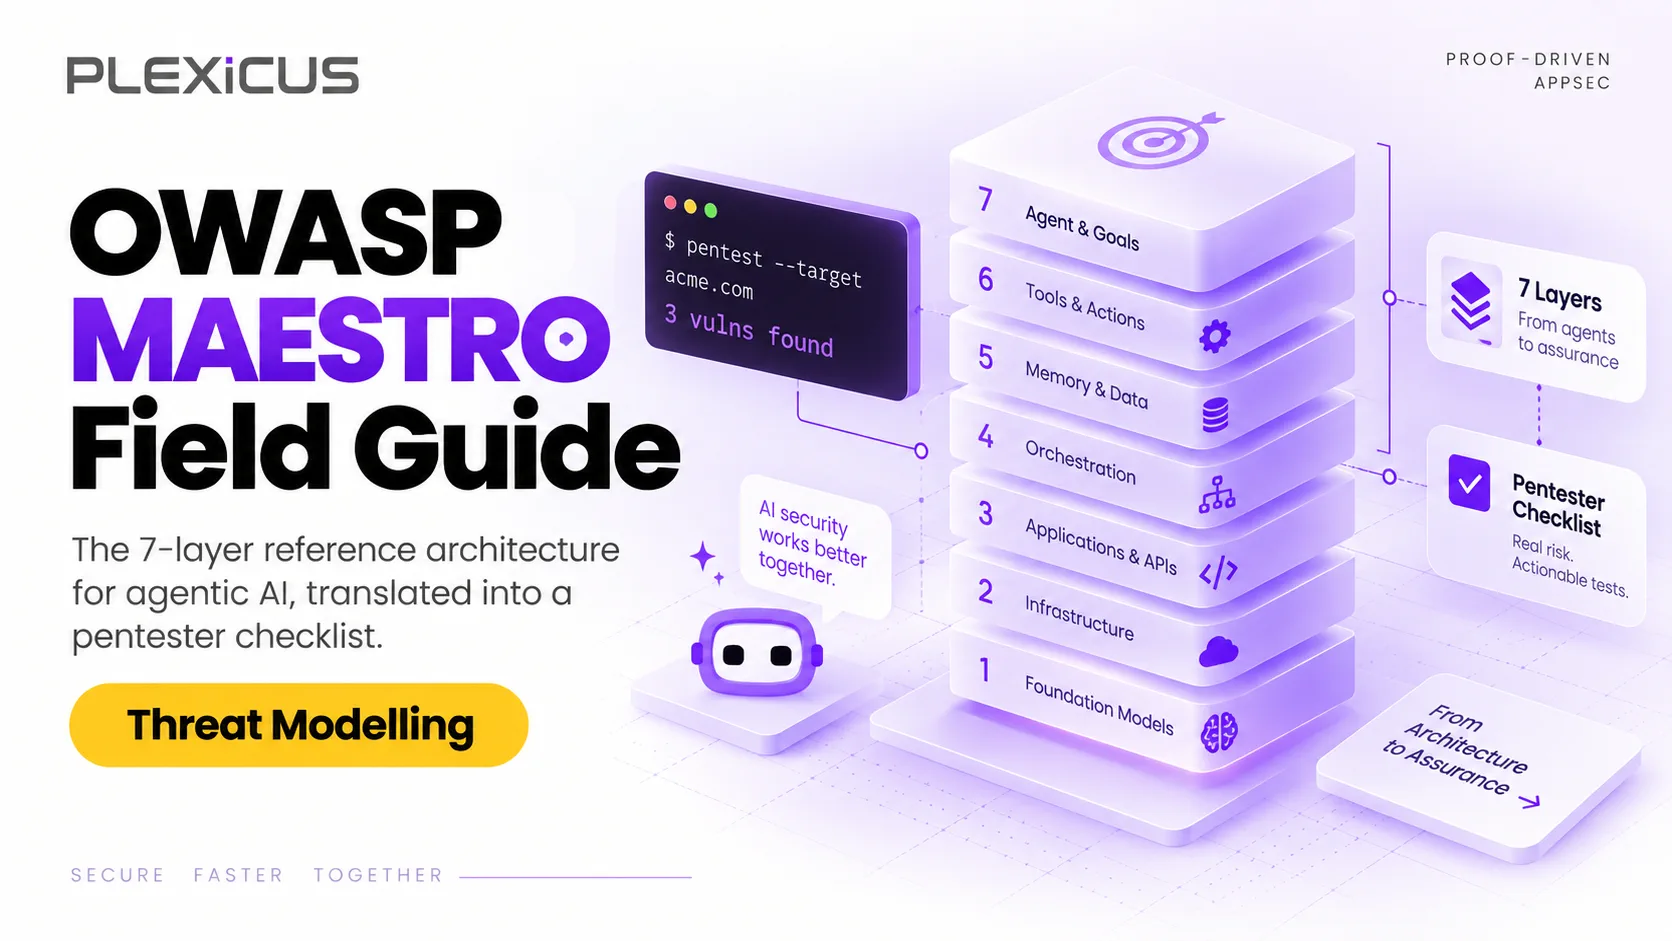
MAESTRO es el framework de 7 capas de Cloud Security Alliance para modelar amenazas en la IA agéntica, aplicado por el OWASP GenAI Security Project. Esta guía convierte cada capa en una lista de comprobación para pentests.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestEl framework MAESTRO (Multi-Agent Environment, Security, Threat, Risk, and Outcome) es un método de modelado de amenazas de siete capas para sistemas de IA agéntica. Ken Huang lo presentó a través de Cloud Security Alliance en febrero de 2025, y el Multi-Agentic System Threat Modeling Guide del OWASP GenAI Security Project (abril de 2025) se basa en él. Por eso muchos equipos lo llaman «OWASP MAESTRO». Esta guía práctica convierte cada capa de MAESTRO en una lista de comprobación para pentesters.
Todos los frameworks de modelado de amenazas que ha usado hasta ahora su equipo de seguridad se diseñaron para software escrito por personas. STRIDE se centra en las amenazas clásicas de aplicaciones. PASTA es un proceso centrado en el riesgo y basado en simulaciones de ataque. LINDDUN cubre amenazas a la privacidad. OCTAVE aborda el riesgo organizativo. Trike y VAST se centran en escalar el modelado de amenazas entre equipos.
Ninguno modela la superficie de amenazas de un agente. Ninguno tiene una capa para «se han envenenado los datos de entrenamiento del modelo». Ninguno tiene una capa para «se ha reescrito la descripción de una herramienta del agente después de aprobarla». Ninguno tiene una capa para «la traza de razonamiento del agente se ha desviado de su objetivo declarado».
MAESTRO se creó para cubrir esa brecha. En lugar de descartar los métodos anteriores, sus autores de CSA amplían categorías de STRIDE, PASTA y LINDDUN con amenazas específicas de la IA y las organizan capa por capa. El resto de esta guía ofrece patrones de ataque concretos, señales de detección y mitigaciones para cada capa.
¿Qué es el framework MAESTRO?
MAESTRO es una arquitectura de referencia de 7 capas para la seguridad de la IA agéntica. Conserva las partes útiles de STRIDE y PASTA, pero modela la superficie de amenazas de abajo arriba para tener en cuenta lo que surge cuando un agente de IA tiene:
- Memoria persistente
- Capacidad para llamar herramientas (a menudo mediante MCP)
- Un ciclo de razonamiento de varios pasos
- Capacidad para actuar en sistemas externos
Las siete capas, de abajo arriba:
- Foundation Models — los LLM que impulsan al agente
- Data Operations — los pipelines que introducen contexto en el modelo
- Agent Frameworks — el entorno de ejecución que orquesta el ciclo del agente
- Deployment & Infrastructure — el entorno donde se ejecuta el agente
- Evaluation & Observability — cómo se mide y registra el comportamiento del agente
- Security & Compliance — los controles que rigen al agente
- Agent Ecosystem — los demás agentes, herramientas y servicios con los que interactúa
En el original de CSA, Security & Compliance es una capa vertical que atraviesa las otras seis, en vez de situarse encima de ellas. Cada capa tiene su propio modelo de amenazas, sus patrones de ataque y sus mitigaciones. Los modelos de amenazas genéricos suelen agrupar casi todo esto en una sola categoría de «dependencias externas». MAESTRO los separa.
MAESTRO y OWASP: ¿quién publica qué?
- Cloud Security Alliance (CSA): la publicación original sobre el framework MAESTRO, de Ken Huang, del 6 de febrero de 2025.
- OWASP GenAI Security Project, Agentic Security Initiative: la taxonomía Agentic AI Threats and Mitigations (febrero de 2025) y el Multi-Agentic System Threat Modeling Guide (abril de 2025), que aplica MAESTRO a sistemas multiagente reales.
El resultado es un framework que los pentesters de IA agéntica pueden usar como lista de comprobación. El resto de esta guía es esa lista.
Capa 1 — Foundation Models
Superficie de amenazas
El propio modelo, sus pesos, sus datos de entrenamiento y la cadena de suministro que lo produjo.
Patrones de ataque
- Envenenamiento del modelo mediante datos de entrenamiento. Un colaborador de un conjunto de datos introduce ejemplos con una puerta trasera. El modelo aprende el activador, que se activa en producción.
- Exfiltración de pesos. Un atacante compromete el registro de modelos y copia los pesos. El modelo queda a disposición de competidores o para un ajuste fino adversarial.
- Checkpoints con puertas traseras en Hugging Face. Un ajuste fino de un modelo conocido disponible públicamente contiene una puerta trasera. El agente que lo incorpora la hereda.
- Ajuste fino adversarial de un modelo base de código abierto. Un equipo usa Llama 4 o Mistral como base. Un atacante publica una variante aparentemente «ajustada para la seguridad», pero sutilmente desalineada. El equipo elige la versión equivocada.
Señales de detección
- El hash no coincide entre los pesos esperados y los cargados
- Actualizaciones de gradiente sospechosas durante el ajuste fino
- Comportamiento posterior que se activa ante entradas poco frecuentes (detección probabilística de puertas traseras)
- Picos inusuales en la curva de pérdida durante el entrenamiento
Mitigaciones
- Fijar las versiones del modelo mediante hash, no por nombre
- Obtener pesos de registros con atestación (commits firmados de Hugging Face y artefactos internos firmados)
- Evaluar la robustez adversarial antes del despliegue
- Mantener una lista de proveedores de modelos permitidos con verificación de procedencia
Capa 2 — Data Operations
Superficie de amenazas
Los datos que consume el agente en tiempo de ejecución: corpus de generación aumentada por recuperación (RAG), plantillas de prompts, historial de conversaciones, resultados de herramientas y cualquier otro contexto que llegue al modelo durante la inferencia.
Patrones de ataque
- Inyección indirecta de prompts mediante documentos RAG. OWASP LLM01 define la inyección indirecta de prompts como entradas que el modelo acepta de fuentes externas, como sitios web o archivos. El atacante introduce texto en un documento que el agente recuperará. El texto contiene instrucciones que el agente sigue como si procedieran del usuario.
- Manipulación de plantillas de prompts. El atacante modifica una plantilla de prompt almacenada para añadir instrucciones que eluden la capa de seguridad del agente.
- Envenenamiento de la salida de una herramienta. El agente llama a una herramienta. Esta devuelve una cadena que contiene instrucciones inyectadas. El agente trata la salida como una fuente de instrucciones confiable.
- Envenenamiento de memoria. El agente escribe en su memoria a largo plazo. El atacante puede escribir en el mismo almacén de memoria (a menudo una base de datos vectorial). Las recuperaciones futuras incluyen las instrucciones del atacante.
- Inyección en registros. El agente registra su traza de razonamiento. El atacante inyecta texto en el registro. Un agente de supervisión lo lee y trata el texto inyectado como instrucciones.
Señales de detección
- Resultados de herramientas que contienen patrones similares a instrucciones (imperativos y apelaciones directas)
- Documentos RAG con una densidad de instrucciones inusualmente alta
- Escrituras en memoria que no coinciden con el historial de interacción observado del agente
- Entradas de registro con patrones lingüísticos que no encajan con la personalidad del agente
Mitigaciones
- Tratar todo el contenido recuperado y las salidas de herramientas como datos no confiables, no como instrucciones
- Usar un canal de instrucciones independiente (system prompt), aislado del canal de datos
- Procesar las salidas de herramientas con un analizador estructurado, no concatenando cadenas sin procesar
- Aplicar seguimiento de procedencia a cada escritura en memoria
Capa 3 — Agent Frameworks
Superficie de amenazas
El entorno de ejecución que orquesta el ciclo del agente: módulo de planificación, lógica de selección de herramientas, interfaz de memoria, traza de razonamiento y planificador de ejecución.
Patrones de ataque
- Manipulación de la traza de razonamiento. La cadena de pensamiento del agente queda expuesta en los registros. El atacante lee la traza, identifica el objetivo e introduce una observación engañosa que desvía el siguiente paso.
- Secuestro de la selección de herramientas. El agente elige herramientas mediante un planificador. El atacante registra una herramienta maliciosa con un nombre parecido al de otra legítima. El planificador selecciona la herramienta equivocada.
- Amplificación del ciclo (denegación de cartera). El agente entra en un ciclo de razonamiento que consume tokens de API. Se ejecuta sin fin hasta agotar el presupuesto.
- Escape de un subagente. Un agente supervisor inicia un subagente. Este tiene menos restricciones que el supervisor y realiza acciones que el supervisor no habría aprobado.
- Desviación entre razonamiento y acción. El razonamiento declarado por el agente diverge de sus acciones reales. El auditor lee la traza y no ve ningún problema. Las acciones cuentan otra historia.
Señales de detección
- Trazas de razonamiento con lenguaje que no concuerda con la personalidad o los objetivos del agente
- Selecciones de herramientas que no coinciden con el plan declarado por el agente
- Anomalías en el gasto de tokens por invocación del agente
- Invocaciones de subagentes que superan el presupuesto declarado por el supervisor
- Discrepancias entre la traza y los registros de acciones
Mitigaciones
- Aislar el módulo de planificación del módulo de ejecución
- Exigir confirmación explícita para invocar herramientas fuera de una lista permitida
- Limitar el gasto de tokens por invocación y por sesión
- Mantener una jerarquía estricta de supervisor y subagentes con reglas para heredar capacidades
- Comparar continuamente las trazas de razonamiento con los registros de acciones
Capa 4 — Deployment & Infrastructure
Superficie de amenazas
El entorno de ejecución del agente: contenedores, funciones sin servidor, máquinas virtuales, sistema operativo subyacente, secretos que usa el agente y rutas de red a las que puede acceder.
Patrones de ataque
- Escape del contenedor. El agente se ejecuta en un contenedor. Una vulnerabilidad del entorno de ejecución del contenedor permite escapar al host. El agente obtiene entonces los privilegios del host.
- Robo de credenciales del entorno de ejecución. El agente tiene claves de API, credenciales de bases de datos o tokens OAuth en su entorno. Una inyección de prompts en la salida de una herramienta hace que el agente los exfiltre.
- Movimiento lateral a servicios internos. El agente puede acceder por red a servicios internos. El atacante lo usa como punto de apoyo.
- Puerta trasera persistente en el entorno de ejecución. El atacante instala una puerta trasera en la imagen del contenedor del agente. Cada nuevo despliegue vuelve a introducirla.
- Filtración de datos por canal lateral. Los patrones de computación del agente (tiempos de ejecución y uso de GPU) revelan información sobre el prompt o el estado del modelo.
Señales de detección
- Conexiones salientes inesperadas desde el entorno de ejecución del agente
- Actividad inusual en el sistema de archivos o la red
- Desviaciones del contenedor respecto a la imagen de confianza conocida
- Diferencias entre las reglas de salida declaradas y las reales
Mitigaciones
- Ejecutar el agente con los privilegios mínimos necesarios (sistema de archivos de solo lectura y sin tráfico de salida salvo a endpoints permitidos)
- Obtener imágenes de contenedor de registros con atestación y fijar sus hashes
- Aplicar listas permitidas de salida mediante políticas de red
- Rotar las credenciales cada vez que se reinicie el agente
- Desplegar detección de amenazas en tiempo de ejecución (p. ej., Falco, Tetragon) en el host del agente
Capa 5 — Evaluation & Observability
Superficie de amenazas
La infraestructura de telemetría, registros, evaluación y observabilidad que supervisa al agente.
Patrones de ataque
- Envenenamiento de registros. Los registros del agente incluyen resultados de herramientas. El atacante inyecta texto en una salida que llega a los registros. El SIEM ingiere la entrada y trata el texto inyectado como la descripción de una alerta.
- Suplantación de telemetría. El evaluador del agente informa de métricas aparentemente saludables. Las métricas son inventadas y el agente se comporta mal.
- Envenenamiento del conjunto de evaluación. El conjunto de evaluación se guarda en el mismo lugar que los datos de producción. El atacante lo modifica. El agente «supera» evaluaciones que ya no reflejan el comportamiento real.
- Colusión entre evaluador y agente. Un agente independiente evalúa al agente de producción. Ambos son accesibles desde el mismo punto de entrada de inyección de prompts. El atacante usa ese punto para manipular al evaluador.
Señales de detección
- Entradas de registro con patrones lingüísticos que no concuerdan con el agente
- Mejoras repentinas de métricas que no corresponden a cambios operativos
- Cambios en los hashes del conjunto de evaluación sin un commit asociado de código o datos
- Discrepancias entre la salida del evaluador y las observaciones de referencia
Mitigaciones
- Separar el canal de registro del canal de datos del agente
- Firmar y calcular hashes de todos los conjuntos de evaluación; generar alertas ante cambios de hash
- Tratar las salidas del evaluador como no confiables y contrastarlas con telemetría sin procesar
- Usar señales externas de referencia (p. ej., comentarios de usuarios y diferencias en el sistema de registro) para validar los resultados de la evaluación
Capa 6 — Security & Compliance
Superficie de amenazas
Los controles, las políticas y los regímenes de cumplimiento que rigen el comportamiento del agente: RBAC, aplicación del alcance, registros de auditoría, aprobación humana y artefactos de políticas como código que codifican las reglas.
Patrones de ataque
- Ampliación del alcance mediante composición de herramientas. Cada herramienta que usa el agente tiene un alcance limitado. El agente encadena herramientas de manera que la combinación abarca más que cualquiera por separado.
- Elusión de la aprobación humana. El flujo de aprobación supone que una persona rechazará una acción peligrosa. El agente describe la acción de forma confusa y la persona la aprueba.
- Inyección en políticas como código. El motor de políticas lee reglas de un artefacto versionado. El atacante modifica ese artefacto. El agente opera ahora con reglas nuevas.
- Manipulación del registro de auditoría. El agente puede acceder a su propio registro de auditoría. El atacante lo usa para reescribirlo y encubrir sus huellas.
Señales de detección
- Invocaciones de herramientas que superan el alcance declarado de cualquier herramienta individual
- Patrones de aprobación que no concuerdan con la acción descrita por el agente
- Cambios en el hash del artefacto de políticas sin un commit correspondiente
- Entradas del registro de auditoría modificadas a posteriori
Mitigaciones
- Comprobar las capacidades a nivel de composición, no solo para cada herramienta por separado
- Exigir un resumen en lenguaje claro junto con la acción
- Firmar y calcular hashes de los artefactos de políticas; generar alertas ante cambios
- Escribir los registros de auditoría en un almacén de solo anexado al que el agente no pueda acceder
Capa 7 — Agent Ecosystem
Superficie de amenazas
Los demás agentes, herramientas, servidores MCP, servicios externos y personas con los que interactúa el agente en producción.
Patrones de ataque
- Envenenamiento de herramientas MCP. El servidor MCP cambia la descripción de su herramienta después de que el agente la haya aprobado (un «rug pull», documentado por Invariant Labs). La nueva descripción cambia el comportamiento.
- Compromiso del servidor MCP. El propio servidor MCP queda comprometido. Las llamadas a herramientas del agente pasan a través de código controlado por el atacante.
- Inyección de prompts entre agentes. Los agentes A y B se comunican. El atacante introduce instrucciones en el contexto de A dirigidas específicamente a B.
- Ataque a la cadena de suministro del mercado de herramientas. Una herramienta publicada por la comunidad contiene código malicioso. El agente la importa y la herramienta exfiltra credenciales en su primer uso.
- Suplantación de una persona. El agente recibe un mensaje que parece proceder de un operador humano, pero en realidad lo envía el atacante. El agente sigue sus instrucciones.
Señales de detección
- Cambios en la descripción de una herramienta después de aprobarla
- Cambios inesperados de comportamiento en herramientas de larga duración
- Mensajes entre agentes con contenido parecido a instrucciones
- Herramientas de mercados con bajas puntuaciones de procedencia
- Mensajes de operadores con patrones anómalos
Mitigaciones
- Fijar las descripciones de las herramientas MCP al aprobarlas y generar alertas ante cambios
- Usar una lista permitida de herramientas con requisitos de procedencia
- Aislar la comunicación entre agentes mediante mensajes estructurados
- Exigir autenticación multifactor para las instrucciones de operadores
- Mantener un inventario de herramientas con puntuaciones de riesgo
Ejemplo práctico — Hexstrike-AI
En septiembre de 2025, Check Point informó de que actores de amenazas hablaban de Hexstrike-AI, un framework ofensivo cuyo servidor FastMCP conecta LLM (Claude, GPT, Copilot) con más de 150 herramientas de seguridad, como medio para explotar los fallos de Citrix NetScaler CVE-2025-7775, CVE-2025-7776 y CVE-2025-8424, divulgados el 26 de agosto de 2025. Publicaciones en foros afirmaban que reducía el tiempo hasta la explotación de días a menos de 10 minutos.
Hexstrike-AI es el agente del atacante, no la víctima. Por eso sirve para un ejercicio MAESTRO: si un agente con el mismo diseño se ejecutara dentro de su entorno, como herramienta de red team o automatización interna con el mismo acceso a herramientas, ¿qué debería responder cada capa? La tabla siguiente es una correspondencia ilustrativa nuestra, no son hallazgos del informe de Check Point.
| Capa MAESTRO | Preguntas que plantea un agente como Hexstrike-AI |
|---|---|
| L1 — Foundation Models | Depende de LLM de terceros; el comportamiento del modelo y sus barreras de seguridad quedan fuera de su control |
| L2 — Data Operations | Los resultados del escaneo y de las herramientas vuelven al contexto del modelo, creando una vía para la inyección indirecta de prompts desde objetivos hostiles |
| L3 — Agent Frameworks | El orquestador elige entre más de 150 herramientas; herramientas con nombres similares o secuestradas podrían desviarlo |
| L4 — Deployment & Infrastructure | Dondequiera que se ejecute el servidor MCP, su alcance de red y sus credenciales lo convierten en un punto de apoyo |
| L5 — Evaluation & Observability | Sin registros de cada llamada a herramientas, es difícil reconstruir un escaneo y explotación automatizados |
| L6 — Security & Compliance | El operador, no la herramienta, aplica el alcance; nada impide que un ataque encadenado salga de los objetivos autorizados |
| L7 — Agent Ecosystem | La capa MCP es la principal superficie de ataque; hay que fijar las descripciones de herramientas y verificar la procedencia de las herramientas comunitarias |
El mapeo de MAESTRO hace legible la superficie de amenazas de cada capa. Quien realice un pentest de un agente similar obtiene una lista de comprobación que avanza de abajo arriba. El mismo patrón de agentes conectados a herramientas reales aparece también en plataformas de uso general. Nuestro análisis del stack de agentes de OpenAI DevDay 2026 lo examina desde la perspectiva defensiva.
Lista de comprobación MAESTRO para modelar amenazas en pentests
Antes de iniciar un pentest de un sistema de IA agéntica, confirme lo siguiente para cada capa:
- L1 — Modelos: ¿Qué modelos impulsan al agente? ¿Cuál es su procedencia? ¿Están fijados los pesos?
- L2 — Datos: ¿Qué lee el agente durante la ejecución? ¿Trata el contenido recuperado como instrucciones o como datos?
- L3 — Frameworks: ¿Hay un planificador y un ejecutor separados? ¿Las capacidades de los subagentes se heredan o se limitan?
- L4 — Infraestructura: ¿Qué privilegios tiene el entorno de ejecución? ¿Cuál es la política de salida? ¿La imagen tiene atestación?
- L5 — Telemetría: ¿Qué se registra? ¿Adónde van los registros? ¿Puede el agente escribir en su propio registro de auditoría?
- L6 — Controles: ¿Cómo se aplica el alcance en la composición de herramientas? ¿Dónde se aprueban las acciones humanas?
- L7 — Ecosistema: ¿Qué servidores MCP usa el agente? ¿Están fijadas las descripciones de las herramientas? ¿Con qué otros agentes se comunica?
Este es el estándar. Todo trabajo que no abarque las siete capas es parcial. Si está eligiendo herramientas para ese trabajo, nuestra comparativa de herramientas de pentest de IA clasifica el mercado según la calidad de las evidencias, y AI Swarm Pentest de Plexicus ejecuta agentes de ataque con alcance firmado y hallazgos verificados mediante replay. Las capas 1–3 también están en el código; ahí es donde Deep Code Analysis rastrea cómo una salida no confiable de una herramienta llega a un punto de riesgo.
Por qué importa MAESTRO para la seguridad de la IA agéntica
La superficie de amenazas de la IA agéntica no va a reducirse. Los modelos serán más capaces, los ecosistemas de herramientas crecerán y las cadenas de suministro se volverán más complejas. Se multiplicará el número de agentes por empresa y más código del que toquen será generado por máquinas; en nuestros propios escaneos, el 78 % de los pull requests generados por IA contenía una vulnerabilidad.
MAESTRO es uno de los primeros frameworks creados para esta realidad y proporciona al sector un vocabulario común. Cuanto antes lo adopte su equipo, antes hablarán el mismo idioma sus pentesters, modeladores de amenazas y auditores.
Los equipos que esperen serán los que incluyan «seguridad de IA» como un único control en sus informes de auditoría. Los que adopten MAESTRO ahora contarán con una defensa en profundidad por capas, respaldada por evidencias y verificable mediante replay: ese es el estándar de AppSec basada en pruebas para 2026 y los años siguientes.
Preguntas frecuentes
¿Qué es el framework MAESTRO?
MAESTRO (Multi-Agent Environment, Security, Threat, Risk, and Outcome) es un framework de modelado de amenazas para la IA agéntica. Divide un sistema de agentes en siete capas, desde los modelos fundacionales y las operaciones de datos hasta el ecosistema de agentes, y enumera amenazas y mitigaciones para cada una. Amplía métodos anteriores como STRIDE, PASTA y LINDDUN con amenazas específicas de la IA, como la inyección de prompts, el envenenamiento de memoria y el envenenamiento de herramientas MCP.
¿MAESTRO es un framework de OWASP o de Cloud Security Alliance?
Ken Huang presentó MAESTRO en el blog de Cloud Security Alliance en febrero de 2025. Después, la Agentic Security Initiative del OWASP GenAI Security Project publicó en abril de 2025 el Multi-Agentic System Threat Modeling Guide, que aplica MAESTRO a sistemas multiagente reales. Por eso se suele decir «OWASP MAESTRO», aunque el framework se originó en CSA.
¿Cuáles son las 7 capas de MAESTRO?
Las siete capas son Foundation Models, Data Operations, Agent Frameworks, Deployment and Infrastructure, Evaluation and Observability, Security and Compliance y Agent Ecosystem. Security and Compliance es una capa vertical que abarca todas las demás. Cada capa tiene su propia superficie de ataque, así que el modelado de amenazas con MAESTRO las revisa una por una en lugar de tratar al agente de IA como una única caja negra.
¿En qué se diferencia el modelado de amenazas con MAESTRO de STRIDE?
STRIDE clasifica las amenazas por tipo (suplantación, manipulación, repudio, divulgación de información, denegación de servicio y elevación de privilegios) para el software tradicional. MAESTRO mantiene ese enfoque, pero organiza las amenazas en torno a las capas de un sistema de agentes y añade riesgos que no encajan en STRIDE: datos de entrenamiento envenenados, inyección de prompts a través de herramientas y memoria, desviación entre razonamiento y acción y confianza multiagente entre herramientas y servidores MCP.
¿Cómo se usa MAESTRO en un pentest de seguridad de IA agéntica?
Empiece en la capa 1 y avance hacia arriba. Para cada capa, enumere los componentes dentro del alcance, relaciónelos con los patrones de ataque de esta guía y confirme que existen las señales de detección y las mitigaciones. Después, pruebe las rutas de mayor riesgo —por lo general, la inyección indirecta de prompts (capa 2), la selección de herramientas (capa 3) y los servidores MCP (capa 7)— y conserve evidencias reproducibles de cada hallazgo.
Lecturas relacionadas:
- De la alerta a la corrección: cerrar el ciclo con AppSec basada en pruebas — el ciclo operativo que MAESTRO ayuda a trazar
- ¿Qué es Deep Code Analysis? — la capa de análisis estático que complementa MAESTRO L1–L3
- El 78 % de los pull requests generados por IA contiene una vulnerabilidad — el fallo de producción que MAESTRO L2 y L7 está diseñado para modelar

