De la alerta a la corrección: un proceso de remediación de vulnerabilidades con AppSec basada en pruebas
AppSec basada en pruebas es un proceso de remediación de vulnerabilidades que cierra el ciclo de la alerta al fix una sola vez, con evidencia reproducible: detectar, verificar, corregir, auditar.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestUn proceso de remediación de vulnerabilidades es la secuencia de pasos que lleva un hallazgo de seguridad desde su detección hasta una corrección verificada y desplegada: detectar, verificar, corregir y auditar. AppSec basada en pruebas es nuestra versión de ese proceso, con una regla: cada paso debe producir evidencia que un desarrollador, un auditor o una puerta de CI puedan volver a ejecutar.
La mayoría de los programas de AppSec se ven iguales. Un escáner encuentra una vulnerabilidad. El hallazgo aterriza en una cola. Un humano hace triaje, eventualmente. Se abre un ticket. Un desarrollador toma el ticket, cuando puede. El desarrollador abre un PR. El PR queda en revisión. La revisión tarda una semana porque el diff es grande y el desarrollador es el único que entiende el archivo. El PR se mergea. La puerta del CI pasa. El hallazgo se cierra.
Mientras tanto, los atacantes son cada vez más rápidos y baratos. El agente de investigación RapidPen obtuvo acceso a una shell en un objetivo vulnerable en 200–400 segundos por bastante menos de un dólar por ejecución. En el lado defensor, el Vulnerability Statistics Report 2026 de Edgescan sitúa el tiempo medio de remediación (MTTR) de las vulnerabilidades altas y críticas de aplicaciones y API en 54,81 días. Un tiempo de corrección de varias semanas no es una métrica de seguridad. Es un argumento de venta para los atacantes.
AppSec basada en pruebas es la disciplina operativa que cierra el ciclo de una vez, hace que cada paso sea demostrable y baja la mediana de tiempo de corrección de semanas a días. Esta es la definición canónica.
Qué es AppSec basada en pruebas
AppSec basada en pruebas es la disciplina de ejecutar programas de seguridad de aplicaciones donde cada afirmación se basa en evidencia que un auditor, un desarrollador o una puerta de CI puede volver a ejecutar. No puntuaciones CVSS. No etiquetas de severidad. No “alto/medio/bajo”. Un artefacto reproducible adjunto al hallazgo.
Tres propiedades definen la práctica:
- Cada hallazgo tiene un camino. No un acierto de regex. No un patrón coincidente. Un camino de alcanzabilidad desde una fuente de entrada real hasta un sumidero con capacidad real, vinculado a un archivo y número de línea concretos.
- Cada hallazgo tiene evidencia. Una petición que se puede volver a ejecutar, un trabajo de CI que se puede reproducir, un estado de sandbox que se puede reanudar. Si un hallazgo no se puede reproducir, no es un hallazgo, es una hipótesis.
- Cada corrección tiene una cadena de evidencia. El parche viene del mismo hallazgo. El parche cierra el exploit original. El parche se revisó con la evidencia original adjunta. El test de regresión del parche es el exploit original, invertido.
Esa es la práctica. Cualquier cosa que no cumpla las tres propiedades es una captura de pantalla de un programa de AppSec, no un programa de AppSec.
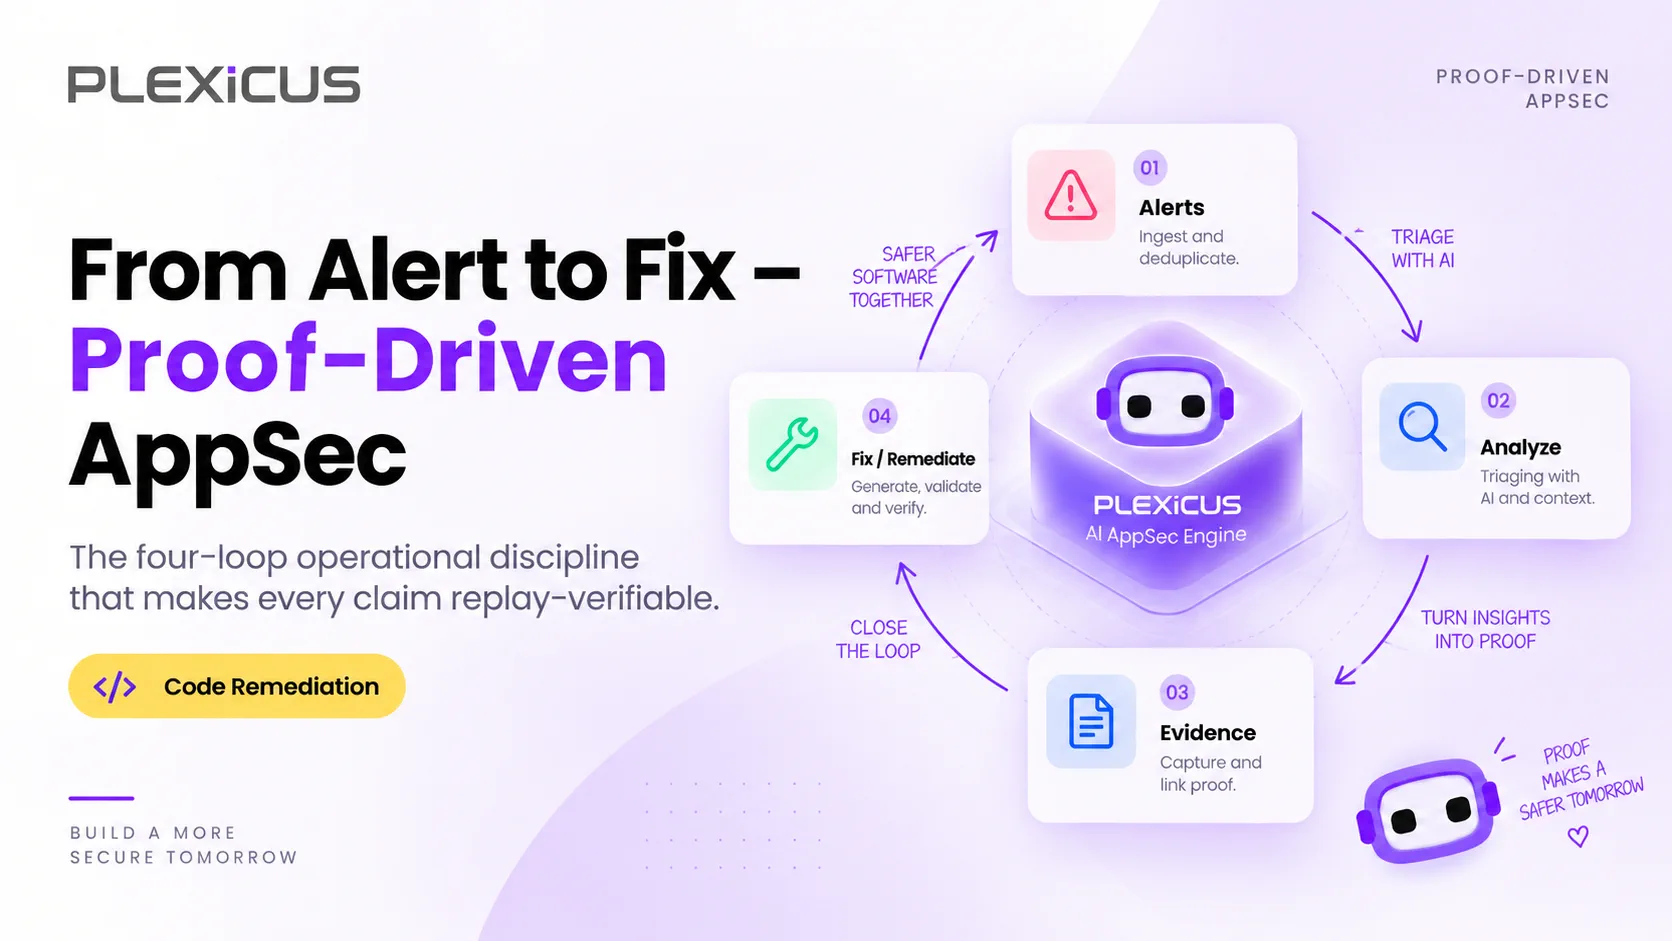
El proceso de remediación de vulnerabilidades en cuatro bucles
El patrón operativo tiene cuatro bucles. Cada bucle tiene un trabajo. Cada entrega preserva la evidencia.
Bucle 1 — Detectar
El primer pase escanea el código fuente (y el IaC que define el runtime) y produce un grafo de hosts, endpoints, parámetros y capacidades. Los hallazgos son posiciones en el grafo, no líneas en un archivo.
Esto es lo que hace Deep Code Analysis (el razonamiento completo está en ¿Qué es Deep Code Analysis?). La salida es un conjunto de hallazgos propuestos, cada uno vinculado a un nodo del grafo, un camino de alcanzabilidad, una clase de capacidad y un número de línea.
Bucle 2 — Verificar
El segundo pase toma cada hallazgo propuesto e intenta reproducirlo. El agente que ejecuta este pase no es el agente que propuso el hallazgo. Este es el paso crítico. La autoconsistencia no es verificación.
La salida del Bucle 2 es un conjunto más pequeño de hallazgos verificados, cada uno con la evidencia adjunta. Los hallazgos que no se reproducen se descartan con una razón documentada. Los códigos de razón importan: son cómo tu equipo depura el pipeline después. Los comunes incluyen: no hay camino real desde un endpoint público al sumidero, una comprobación previa que hace inerte el hallazgo, un control en runtime que lo neutraliza, o el segundo agente no pudo reproducir el resultado.
Bucle 3 — Corregir
El tercer pase toma cada hallazgo verificado y redacta un parche listo para revisar. El parche no es una corrección genérica. Es el cambio mínimo que elimina el camino de alcanzabilidad preservando la lógica de negocio. El parche incluye tests de regresión (el exploit original se convierte en un test). El parche incluye actualizaciones de documentación.
Esto es lo que hace un flujo estructurado de remediación de seguridad como Plexicus Remediation. La salida es un pull request, no un fragmento de código. Para ver cómo funciona este paso de principio a fin sin traspasos manuales, consulta el manual de remediación autónoma (en inglés).
Bucle 4 — Auditar
El cuarto pase asegura que el parche cierra el hallazgo original. El verificador vuelve a ejecutar el exploit original contra la rama parcheada. Si el exploit se reproduce, el parche se revierte. Si el exploit queda mitigado, el parche se firma y el hallazgo se cierra.
La salida del Bucle 4 es un registro de auditoría: hallazgo original, nodo del grafo, referencia a la evidencia, diff del parche, resultado del test de regresión, aprobación del revisor, marca temporal del despliegue. Un registro por hallazgo. Firmado. Reproducible.
Por qué esto no es “AppSec nativo de IA” con mejor marketing
El término “AppSec nativo de IA” fue útil cuando significaba “los escáneres usan modelos de machine learning”. Hoy todos los escáneres usan modelos de machine learning. El diferenciador no es si la IA está involucrada. Es si la IA está fundamentada.
Tres modos de fallo de la era nativa de IA:
- IA que resume hallazgos sin fundamentarlos. El modelo lee la salida del SAST y produce un PDF más legible. El auditor no puede volver a ejecutar nada.
- IA que propone correcciones sin verificación. El modelo escribe un parche. El parche compila. El parche cambia el significado del código. Se espera que un revisor humano lo detecte. No pueden, a escala, y menos cuando, según nuestro análisis, el 78% de los PRs generados por IA contenía una vulnerabilidad (en inglés).
- IA que corre sin evidencia. El modelo explora la aplicación. Encuentra algo interesante. Lo reporta como hallazgo. El reporte no se puede reproducir.
AppSec basada en pruebas es la respuesta a los tres. La estructura es el listón:
- La detección debe producir un camino, no un patrón.
- La verificación debe ser independiente, no autoconsistente.
- La corrección debe estar fundamentada en la misma evidencia, no en una sugerencia genérica.
- La auditoría debe ser reproducible, no narrativa.
Cualquier cosa que no cumpla las cuatro es el mismo programa de AppSec con un logo distinto.
La remediación de vulnerabilidades en la práctica
En la base de clientes de Plexicus que ejecutan el patrón completo de cuatro bucles, el efecto práctico tiene la misma forma: el tiempo de triaje se comprime de días a minutos, los falsos positivos bajan tras la verificación y el tiempo hasta el merge cae porque el revisor lee un diff pequeño y respaldado por evidencia en lugar de una lista sin verificar.
Dos números definen si la práctica está funcionando: con qué frecuencia el auditor puede volver a ejecutar la evidencia y confirmar el hallazgo, y con qué frecuencia el auditor acepta que el parche corrige lo que el hallazgo afirmaba. Todo lo demás es capacidad de proceso.
Las medianas exactas varían según el código, la mezcla de lenguajes y la madurez del CI. El patrón es lo que escala.
Lo que exige el panorama de amenazas
El panorama de amenazas en 2026 es estructuralmente más rápido que el ciclo del defensor:
- El tiempo hasta el exploit sigue bajando. Mandiant midió un tiempo medio hasta el exploit de cinco días en 2023, frente a 63 días en 2018–2019.
- La mayor parte de la explotación empieza antes de que exista una corrección: el 70% de las vulnerabilidades de ese conjunto de datos de Mandiant se explotaron como zero-days.
- Los agentes ofensivos con IA son baratos de ejecutar. RapidPen obtuvo acceso a una shell en 200–400 segundos por unos 0,30–0,60 dólares por ejecución.
- La IA reduce el nivel de habilidad necesario. Amazon Threat Intelligence documentó a un único actor con pocos conocimientos técnicos que, con IA generativa comercial, comprometió más de 600 dispositivos FortiGate en 55 países en unas cinco semanas.
El pipeline del atacante ya está basado en pruebas. Verifican sus exploits antes de enviarlos. Reproducen sus payloads. Auditan sus resultados. La asimetría no es “los atacantes usan IA y los defensores no”. La asimetría es “los atacantes usan un bucle cerrado y los defensores una serie de colas abiertas”.
AppSec basada en pruebas es el patrón operativo que cierra el bucle del defensor.
Cómo montar un flujo de remediación de seguridad con tus herramientas actuales
La estructura de cuatro bucles no es algo específico de un proveedor. El patrón se puede implementar con las herramientas que tu equipo ya tiene:
- Bucle 1 (Detectar) — análisis estático que produce caminos de alcanzabilidad. Plexicus Deep Code Analysis, o cualquier escáner que vincule los hallazgos al grafo de llamadas en lugar de al número de línea.
- Bucle 2 (Verificar) — un compromiso de pentest con alcance firmado. Plexicus AI Swarm Pentest, o un compromiso de pentest manual con captura de evidencia (consulta nuestra comparativa de herramientas de pentest con IA).
- Bucle 3 (Corregir) — un generador de parches con tests de regresión. Cualquier flujo de codificación con IA con instrucciones explícitas de fundamentar los parches en el hallazgo original.
- Bucle 4 (Auditar) — un hook de CI que vuelve a ejecutar el exploit original contra la rama parcheada. Es también la evidencia que espera el Secure Software Development Framework (SP 800-218) del NIST en sus prácticas de «Respond to Vulnerabilities».
Los cuatro bucles tienen que estar conectados. La evidencia del Bucle 2 tiene que aterrizar en el Bucle 3. El parche del Bucle 3 tiene que ser re-verificado por el Bucle 2. El registro de auditoría del Bucle 4 tiene que incluir las referencias de evidencia de los Bucles 1, 2 y 3.
Si alguna de esas entregas pierde la evidencia, el bucle se rompe. La práctica deja de estar basada en pruebas.
El listón para 2026
Tres preguntas para hacerle a tu programa de seguridad:
- ¿Puede tu escáner producir un camino de alcanzabilidad para cada hallazgo? Si la respuesta es “no, solo un número de línea”, tu cola de triaje seguirá creciendo.
- ¿Puede tu pentester volver a ejecutar el hallazgo contra un build limpio? Si la respuesta es “tendríamos que montar un nuevo compromiso”, tu rastro de evidencia no es reproducible.
- ¿Puede tu desarrollador abrir el PR con el exploit original adjunto? Si la respuesta es “tendría que pedirle al equipo de seguridad que lo encuentre otra vez”, tu rastro de auditoría no es continuo.
Si las tres respuestas son “sí”, estás ejecutando AppSec basada en pruebas. Si alguna es “no” o “más o menos”, la brecha está en la entrega de evidencia, no en las herramientas.
Preguntas frecuentes
¿Qué es el proceso de remediación de vulnerabilidades?
El proceso de remediación de vulnerabilidades es el conjunto de pasos que lleva un hallazgo de seguridad desde su detección hasta una corrección verificada en producción. En AppSec basada en pruebas tiene cuatro bucles: detectar la falla con un camino de alcanzabilidad, verificarla de forma independiente, corregirla con un parche mínimo y un test de regresión, y auditar el resultado volviendo a ejecutar el exploit original contra el código parcheado.
¿Cuál es la diferencia entre remediación y mitigación de vulnerabilidades?
La remediación elimina la vulnerabilidad en sí, normalmente cambiando código, actualizando una dependencia o corrigiendo una configuración. La mitigación reduce el riesgo sin eliminar la falla, por ejemplo con una regla de WAF, un feature flag o aislamiento de red. La mitigación gana tiempo; la remediación cierra el hallazgo. Un buen proceso registra cuál se aplicó y vuelve a probar ambas.
¿Qué es AppSec basada en pruebas?
AppSec basada en pruebas es una forma de gestionar la seguridad de aplicaciones en la que cada afirmación está respaldada por evidencia que otra persona puede volver a ejecutar. Los hallazgos necesitan un camino de alcanzabilidad y un exploit reproducible, las correcciones un test de regresión construido a partir de ese exploit, y el registro de auditoría los une. Si un hallazgo no se puede reproducir, es una hipótesis.
¿Cómo se verifica que una remediación de seguridad funcionó?
Vuelve a ejecutar el exploit original contra la build parcheada. Si el exploit ya no funciona y el test de regresión derivado de él pasa en CI, la corrección está verificada. Si sigue reproduciéndose, el parche está incompleto y debe revertirse. Guarda el exploit, el diff del parche y el resultado del test juntos en un único registro de auditoría.
¿Cómo deben priorizar los equipos las vulnerabilidades a remediar?
Prioriza los hallazgos verificados y alcanzables desde una entrada real por encima de las puntuaciones de severidad. Una falla de severidad media con un camino confirmado desde un endpoint público suele ser más urgente que una crítica que no se puede alcanzar. La alcanzabilidad, la evidencia del exploit y la capacidad que ganaría un atacante son mejores señales que el CVSS por sí solo.
Hacia dónde va esto
En los próximos dos años, cada regulador va a hacer la misma pregunta: ¿puedes volver a ejecutar la evidencia que demostró que este control estaba funcionando cuando ocurrió el incidente? Los equipos que ejecutan AppSec basada en pruebas responderán “sí” con el artefacto original. Los equipos con el patrón antiguo responderán “tenemos un PDF”.
La inversión para cerrar la brecha no es grande. La disciplina para mantenerla cerrada, sí lo es.
Lectura relacionada:
- ¿Qué es Deep Code Analysis? — Bucle 1
- El 78% de los PRs generados por IA contienen una vulnerabilidad — por qué la verificación es el nuevo cuello de botella
- El manual de remediación autónoma — Bucle 3 en detalle
- Guía de campo OWASP MAESTRO para modeladores de amenazas — la arquitectura de referencia para los agentes que ejecutan los bucles

