Presentamos AI Swarm Pentest: de un pentester de IA a un equipo orquestado de agentes de ataque
Cómo los agentes de ataque especializados comparten contexto, cuestionan hipótesis y verifican de forma independiente rutas de ataque dentro del flujo Proof-Driven AppSec de Plexicus.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestEl desarrollo de software es cada vez más agéntico.
Los sistemas de IA ya pueden generar, revisar, refactorizar, probar e implementar código. Las aplicaciones cambian más rápido, las API se multiplican y se pide a los equipos de seguridad que validen más software sin aumentar sus plantillas en la misma proporción.
Por el mismo motivo, las pruebas de penetración también empiezan a cambiar.
La primera ola de herramientas de seguridad con IA ayudaba sobre todo a las personas a trabajar más deprisa: explicar una vulnerabilidad, generar un payload, resumir resultados del escáner o sugerir el siguiente paso del pentest.
La siguiente ola ganó autonomía. En lugar de esperar a que una persona emitiera cada comando, un agente de IA podía explorar una aplicación, interactuar con sus endpoints, probar hipótesis, analizar respuestas y decidir qué intentar a continuación.
Pero la autonomía plantea otro problema:
Un pentest no es una sola tarea.
Es una larga cadena de decisiones.
Un atacante quizá tenga que descubrir un endpoint, entender la autenticación, identificar una referencia a un objeto, poner a prueba los límites de autorización, obtener contexto adicional, probar varias variantes de payload, relacionar el resultado con otra debilidad y, por último, demostrar que toda la ruta de ataque funciona de verdad.
Ahí es donde entra AI Swarm Pentest.
En vez de tratar el pentesting como una conversación interminable entre un modelo y un objetivo, AI Swarm Pentest lo plantea como una investigación de seguridad orquestada en la que capacidades especializadas pueden explorar, razonar, compartir contexto, verificar el trabajo de las demás y convertir hipótesis de ataque en pruebas.
El objetivo no es simplemente:
Encontrar más vulnerabilidades.
La pregunta más útil es:
¿Qué rutas de ataque son reales, a qué puede llegar realmente un atacante y qué pruebas necesita el equipo de ingeniería para actuar?
Esa distinción está en el centro de AI Swarm Pentest de Plexicus. Plexicus describe AI Swarm Pentest como un proceso que valida rutas explotables en aplicaciones, API y código fuente autorizados, con pruebas de respaldo y verificación independiente antes de presentar un hallazgo como verificado.
Ver en YouTube el gráfico animado de AI Swarm Pentest.
Primero: ¿qué significa realmente «pentesting con IA»?
No existe una definición universalmente aceptada de las pruebas de penetración con IA.
Un escáner de vulnerabilidades que incorpora explicaciones generadas por un LLM puede comercializarse como seguridad con IA.
Un pentester que usa Claude u otro modelo como copiloto también puede llamar pentesting con IA a su flujo de trabajo.
En el otro extremo del espectro, los sistemas autónomos pueden interactuar con aplicaciones, elegir herramientas, generar payloads, analizar respuestas, cambiar de estrategia, explotar vulnerabilidades y producir pruebas con poca intervención humana.
Estos sistemas no son equivalentes.
Incluso los proveedores que desarrollan plataformas de pentesting autónomo reconocen la distinción. XBOW, por ejemplo, describe el pentesting con IA como un espectro que puede abarcar desde un LLM conectado a un escáner, pasando por pruebas dirigidas por personas y asistidas por IA, hasta sistemas autónomos que coordinan agentes especializados.
Por eso, antes de hablar de AI Swarm Pentest, conviene distinguir cuatro conceptos.
| Enfoque | Quién toma las decisiones principales | Comportamiento habitual | Resultado principal |
|---|---|---|---|
| DAST / escáner tradicional | Reglas y firmas | Envía pruebas predeterminadas y las compara con patrones conocidos | Posibles vulnerabilidades |
| Pentesting asistido por IA | Pentester humano | La IA explica, recomienda, redacta comandos o analiza resultados | Hallazgos validados por una persona |
| Pentesting autónomo con IA | Agente de IA o sistema de agentes | Explora objetivos, elige acciones y se adapta a los resultados | Hallazgos autónomos y pruebas de ataque |
| Pentesting con AI Swarm | Sistema de agentes orquestado | Varias capacidades exploran, correlacionan, comparten contexto, cuestionan hipótesis y verifican rutas de ataque | Rutas de ataque verificadas con pruebas |
Los límites no son absolutos.
Una plataforma avanzada de pentesting autónomo ya puede utilizar varios agentes internamente. Por eso, «swarm» no debe interpretarse simplemente como «más de un agente de IA».
La diferencia significativa está en cómo se organizan esos agentes.
¿Qué es AI Swarm Pentest?
AI Swarm Pentest es un enfoque agéntico de pruebas de penetración en el que capacidades de seguridad especializadas operan como un sistema orquestado, en lugar de depender de un único agente de IA de propósito general que realice secuencialmente todo el trabajo.
Piense en la diferencia entre pedir a un ingeniero de seguridad muy competente que investigue una aplicación en solitario y encargar la misma misión a un equipo de seguridad coordinado.
Una persona podría enumerar la superficie de ataque.
Otra se centraría en la autenticación.
Otra investigaría la autorización.
Otra examinaría las API.
Otra intentaría convertir un comportamiento interesante en un exploit reproducible.
Y otra trataría de reproducir el hallazgo de forma independiente antes de que el equipo lo comunique.
Lo importante no es solo que trabajen varias personas.
Necesitan una comprensión compartida del objetivo.
Si un agente descubre que se puede acceder a
/api/invoices/{id}
después de autenticarse, otro agente no debería tener que redescubrirlo todo desde cero.
Si el primer agente también descubre que los identificadores de factura son secuenciales, la capacidad de comprobar autorizaciones puede usar esa información como una nueva hipótesis.
Si otra acción revela un identificador de tenant, esa observación podría resultar útil en otro punto.
El pentest pasa a ser un grafo de ataque en constante evolución, en lugar de una colección de prompts aislados.
La descripción de la próxima presentación de José Ramón Palanco en APIAddicts, el 15 de octubre de 2026 propone habilidades especializadas, MCP y memoria de ataque orientada a grafos. Se trata de una arquitectura de prueba de concepto propuesta para la charla.
Esta es una analogía mucho más cercana a un ejercicio real de seguridad ofensiva que:
Prompt → IA → informe de vulnerabilidades.
Por qué no siempre basta con un solo agente de IA
Los grandes modelos de lenguaje son asistentes de seguridad extraordinariamente capaces.
Pero el pentesting pone de manifiesto varias de sus debilidades a la vez.
Un pentest es:
prolongado,
con estado,
dependiente de herramientas,
incierto,
adversarial
y depende de pruebas recopiladas durante muchas acciones anteriores.
El artículo sobre PentestGPT documentó este problema desde el principio. Los investigadores observaron que los LLM eran útiles para tareas concretas de pentesting, como manejar herramientas, interpretar sus resultados y proponer los siguientes pasos, pero seguía siendo difícil mantener una visión integrada de todo el ejercicio. Por eso PentestGPT separó las responsabilidades en módulos que interactúan entre sí, en vez de pedir a una sola instancia del modelo que lo gestionara todo.
Investigaciones posteriores siguieron identificando dificultades en la enumeración, la explotación, la escalada de privilegios, la gestión del contexto y el razonamiento autónomo de principio a fin.
Las investigaciones más recientes sobre sistemas multiagente apuntan en la misma dirección.
El sistema de investigación ARTEMIS, por ejemplo, utiliza subagentes dinámicos y triaje automatizado de vulnerabilidades. En un estudio sobre una red universitaria real, los investigadores comunicaron ventajas en la enumeración sistemática y la explotación en paralelo. También observaron limitaciones importantes, entre ellas falsos positivos y dificultades con algunos flujos de trabajo que dependen mucho de interfaces gráficas. Estos resultados deben interpretarse en el contexto de los objetivos, las reglas de puntuación y el presupuesto de ese estudio.
La conclusión no es que «varios agentes resuelvan automáticamente el pentesting».
No es así.
La conclusión es que el trabajo complejo de seguridad ofensiva se beneficia de distribuir responsabilidades y, a la vez, mantener un estado compartido y mecanismos de verificación.
De un solo agente a un swarm
Un pentester autónomo con IA simplificado podría verse así:
Objetivo
  ↓
Agente de IA
  ↓
Reconocimiento
  ↓
Hipótesis
  ↓
Explotación
  ↓
Informe
Puede funcionar sorprendentemente bien.
Pero todo depende de que el mismo ciclo de razonamiento conserve el contexto, decida prioridades, maneje herramientas, procese sus resultados, evite caminos sin salida, valide hallazgos y documente el ejercicio.
Una arquitectura orientada a un swarm tiene un aspecto conceptual distinto:
                         ┌────────────────────────────┐
                         │ Alcance autorizado         │
                         │ + reglas de actuación      │
                         │   acordadas                │
                         └─────────────┬──────────────┘
                                   │
                                   ▼
                         ┌────────────────────┐
                         │ Orquestador swarm  │
                         └─────────┬──────────┘
                                   │
                ┌──────────────────┼──────────────────┐
                ▼                  ▼                  ▼
       ┌────────────────┐ ┌──────────────────────────┐ ┌────────────────┐
       │ Superficie /   │ │ Autenticación / lógica   │ │ Explotación    │
       │ reconocimiento │ │ capacidad                │ │ capacidad      │
       └───────┬────────┘ └────────────┬─────────────┘ └───────┬────────┘
               │                  │                  │
               └──────────────────┼──────────────────┘
                                  ▼
                       ┌──────────────────────┐
                       │ Contexto / grafo de  │
                       │ ataque / pruebas     │
                       │ compartidos          │
                       └──────────┬───────────┘
                                  │
                                  ▼
                       ┌──────────────────────┐
                       │ Verificación         │
                       │ independiente        │
                       └──────────┬───────────┘
                                  │
                                  ▼
                       ┌──────────────────────┐
                       │ Hallazgo verificado  │
                       │ + pruebas            │
                       └──────────┬───────────┘
                                  │
                                  ▼
                       ┌──────────────────────┐
                       │ Revisión humana +    │
                       │ remediación          │
                       └──────────────────────┘
El cambio arquitectónico es sutil, pero importante.
La unidad de trabajo ya no es solo el prompt.
Pasa a ser la misión.
Cómo funciona AI Swarm Pentest
A grandes rasgos, AI Swarm Pentest puede entenderse como siete etapas conectadas:
-
Definir la misión autorizada. Antes de empezar las pruebas se definen el objetivo, el entorno, las credenciales si hacen falta, los límites, los límites temporales y las reglas de actuación acordadas. En Plexicus, el alcance y las reglas se acuerdan antes del ejercicio, y el sistema está diseñado para ceñirse a ese alcance autorizado.
-
Mapear la superficie de la aplicación. El sistema explora las aplicaciones, API, rutas, parámetros, estados de autenticación, formularios y otras superficies de ataque pertinentes que sean accesibles, en lugar de limitarse a lanzar un conjunto fijo de firmas. La documentación de Plexicus distingue este comportamiento del DAST: sus agentes de AI Pentest pueden interactuar con las aplicaciones, completar formularios, utilizar sesiones autenticadas y perseguir cadenas de ataque más complejas.
-
Generar hipótesis de ataque. Las observaciones se convierten en preguntas. ¿Se puede cambiar este identificador? ¿Es posible acceder desde fuera a este endpoint interno? ¿Se puede eludir el límite entre roles? ¿Se pueden combinar dos debilidades moderadas por separado?
-
Delegar la exploración. Las capacidades pertinentes investigan esas hipótesis. Algunas rutas se agotan rápidamente. Otras producen información nueva que resulta útil para el resto del swarm.
-
Conectar las pruebas en rutas de ataque. En lugar de tratar los hallazgos como alertas aisladas, las observaciones pueden formar relaciones: usuario → endpoint → objeto → permiso → operación vulnerable → recurso sensible.
-
Verificar el hallazgo de forma independiente. Descubrir algo no equivale automáticamente a probarlo. Plexicus afirma que los hallazgos presentados como verificados se reproducen por separado y que las hipótesis sin respaldo pueden descartarse, en vez de incluirse solo para alargar el informe.
-
Entregar las pruebas a las personas. El resultado incluye contexto sobre el impacto, pruebas técnicas, priorización e información necesaria para la corrección. Los cambios en producción no se aplican automáticamente; los equipos humanos conservan la decisión final.
Esta última etapa importa.
El objetivo del pentesting autónomo no debería ser generar vulnerabilidades de forma autónoma.
Debería ser una investigación autónoma con pruebas revisables.
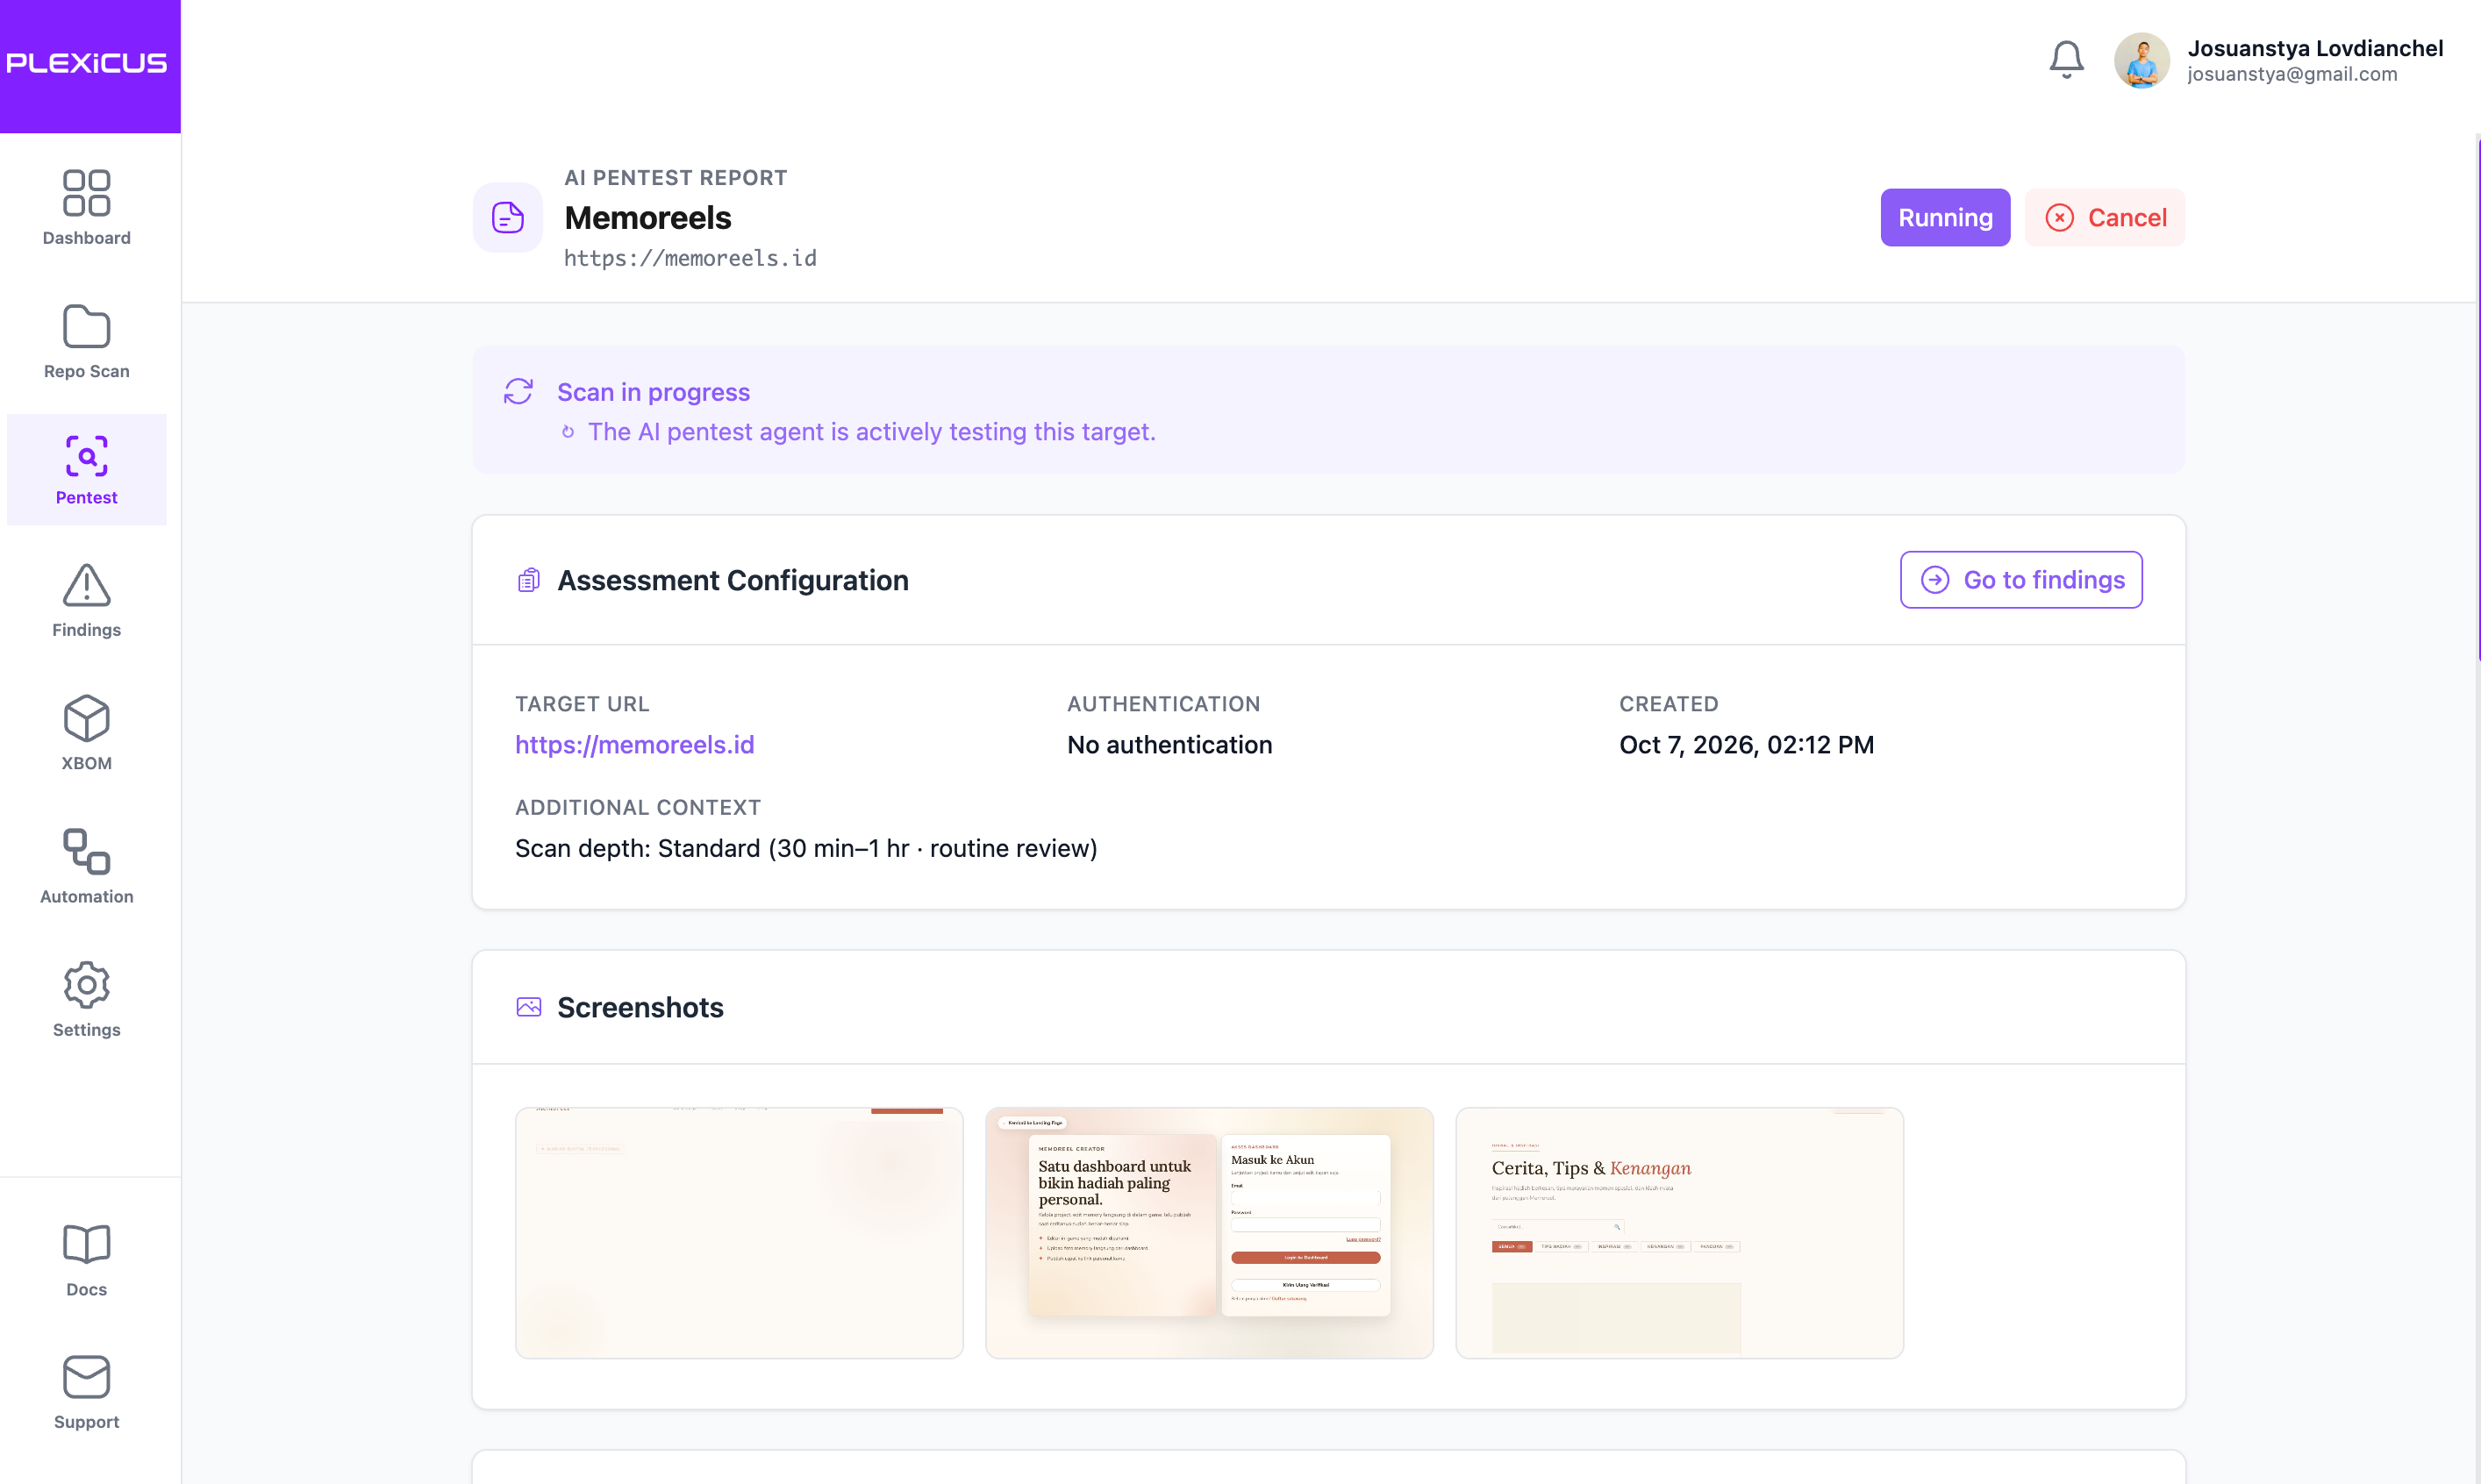
La vista general de la evaluación muestra la configuración y las capturas del objetivo mientras el pentest está en ejecución.
AI Swarm Pentest frente al DAST tradicional
El DAST sigue siendo útil.
Pero el DAST y AI Swarm Pentest responden a preguntas diferentes.
Un escáner dinámico convencional es muy eficaz para comprobar repetidamente grandes cantidades de objetivos en busca de clases de debilidades conocidas.
Puede preguntar:
¿Este parámetro responde a una prueba conocida de inyección SQL?
Un pentester agéntico puede plantear una pregunta más parecida a esta:
¿Qué hace este endpoint, qué supone la aplicación sobre quien lo llama y puedo manipular esas suposiciones para llegar a algo que no debería?
La documentación de Plexicus ilustra directamente esta diferencia. El modo DAST envía pruebas automatizadas para detectar problemas como configuraciones de seguridad HTTP incorrectas y patrones de explotación conocidos, mientras que AI Pentest explora las aplicaciones de forma interactiva, admite flujos autenticados e intenta encontrar cadenas de ataque complejas y vulnerabilidades en la lógica de negocio.
La distinción importa porque muchas vulnerabilidades reales de aplicaciones dependen del contexto.
El problema quizá no sea:
El parámetro X acepta el payload Y.
Puede ser, en cambio:
Un usuario con pocos privilegios puede obtener el identificador X en el flujo A, pasarlo a la API B, eludir la validación de propiedad y acceder al recurso de otro tenant.
Puede que ninguna petición aislada parezca extraordinaria.
La vulnerabilidad está en la relación entre las peticiones.
Precisamente ahí resulta valioso razonar sobre el estado del ataque.
AI Swarm Pentest frente a un pentest «normal» con IA
Esta es la distinción más importante y también la más fácil de simplificar en exceso.
Un pentest autónomo convencional con IA suele seguir un ciclo de agente:
observar → razonar → actuar → observar → repetir.
Ese enfoque puede ser muy potente.
Pero, a medida que crece el ejercicio, el agente debe recordar todo lo que ha aprendido, priorizar, manejar herramientas, mantener el estado de autenticación, investigar muchas hipótesis, abandonar rutas improductivas y distinguir un éxito real de una respuesta engañosa.
Una arquitectura swarm puede distribuir esas responsabilidades.
| Dimensión | Pentest típico con un solo agente de IA | Pentest con AI Swarm |
|---|---|---|
| Razonamiento | Principalmente un ciclo de razonamiento | Capacidades especializadas y orquestadas |
| Exploración | A menudo secuencial | Puede explorar varias hipótesis a la vez |
| Contexto | Conversación del agente / memoria de trabajo | Contexto compartido de la misión y relaciones de ataque |
| Especialización | Agente de pentesting de propósito general | Las capacidades pueden especializarse en partes de la misión |
| Rutas fallidas | Las gestiona el mismo agente | Se pueden aislar sin perder toda la investigación |
| Cadenas de ataque | El agente debe conservar el contexto a largo plazo | Los hallazgos pueden conectarse mediante un estado compartido |
| Validación | Puede hacerla el agente que descubre el problema | La reproducción independiente puede constituir una etapa aparte |
| Resultado | Hallazgo / informe | Ruta de ataque respaldada por pruebas y traspaso |
| Función humana | Depende de la implementación | El alcance, las salvaguardas, la revisión y la decisión final siguen siendo explícitos |
Sin embargo, esta tabla describe patrones arquitectónicos, no categorías rígidas del sector.
Algunos productos modernos de pentesting autónomo ya utilizan agentes especializados y validadores. XBOW, por ejemplo, describe públicamente la coordinación de agentes especializados y el uso de agentes validadores para confirmar la explotabilidad.
Por tanto, los compradores nunca deberían limitarse a preguntar:
«¿Tiene varios agentes?»
Una pregunta mejor sería:
«¿Cómo los coordina el sistema, conserva el estado, verifica los hallazgos, controla el alcance y convierte los resultados en pruebas en las que mi equipo pueda confiar?»
El swarm trata de coordinación, no de cuántos agentes hay
Imagine desplegar 100 agentes de IA contra una aplicación.
Si cada uno escanea de forma independiente los mismos endpoints y genera su propio informe, técnicamente tendrá muchos agentes.
Eso no significa necesariamente que tenga un swarm útil.
Un swarm resulta útil cuando el conocimiento que descubre una capacidad puede influir en las decisiones de otra.
Supongamos que una capacidad de exploración descubre:
POST /api/projects/{project_id}/export
El usuario autenticado parece pertenecer a:
tenant_A
Otra capacidad descubre un identificador de proyecto que pertenece a:
tenant_B
Una capacidad de comprobación de autorizaciones combina las observaciones.
Introduce el segundo identificador en la primera petición.
La respuesta tiene éxito de forma inesperada.
Una capacidad de verificación reproduce la secuencia desde un estado limpio.
Ahora el sistema tiene algo mucho más útil que:
Posible IDOR detectado.
Tiene una cadena de ataque:
Usuario con pocos privilegios
        ↓
Endpoint autenticado para exportar proyectos
        ↓
Identificador de proyecto controlado por el atacante
        ↓
Falta de validación de la pertenencia al tenant
        ↓
Exportación de un proyecto de otro tenant
        ↓
Exposición de datos sensibles
Y cada paso puede ir acompañado de pruebas.
Esa es la diferencia entre detectar una anomalía y demostrar una ruta de ataque.
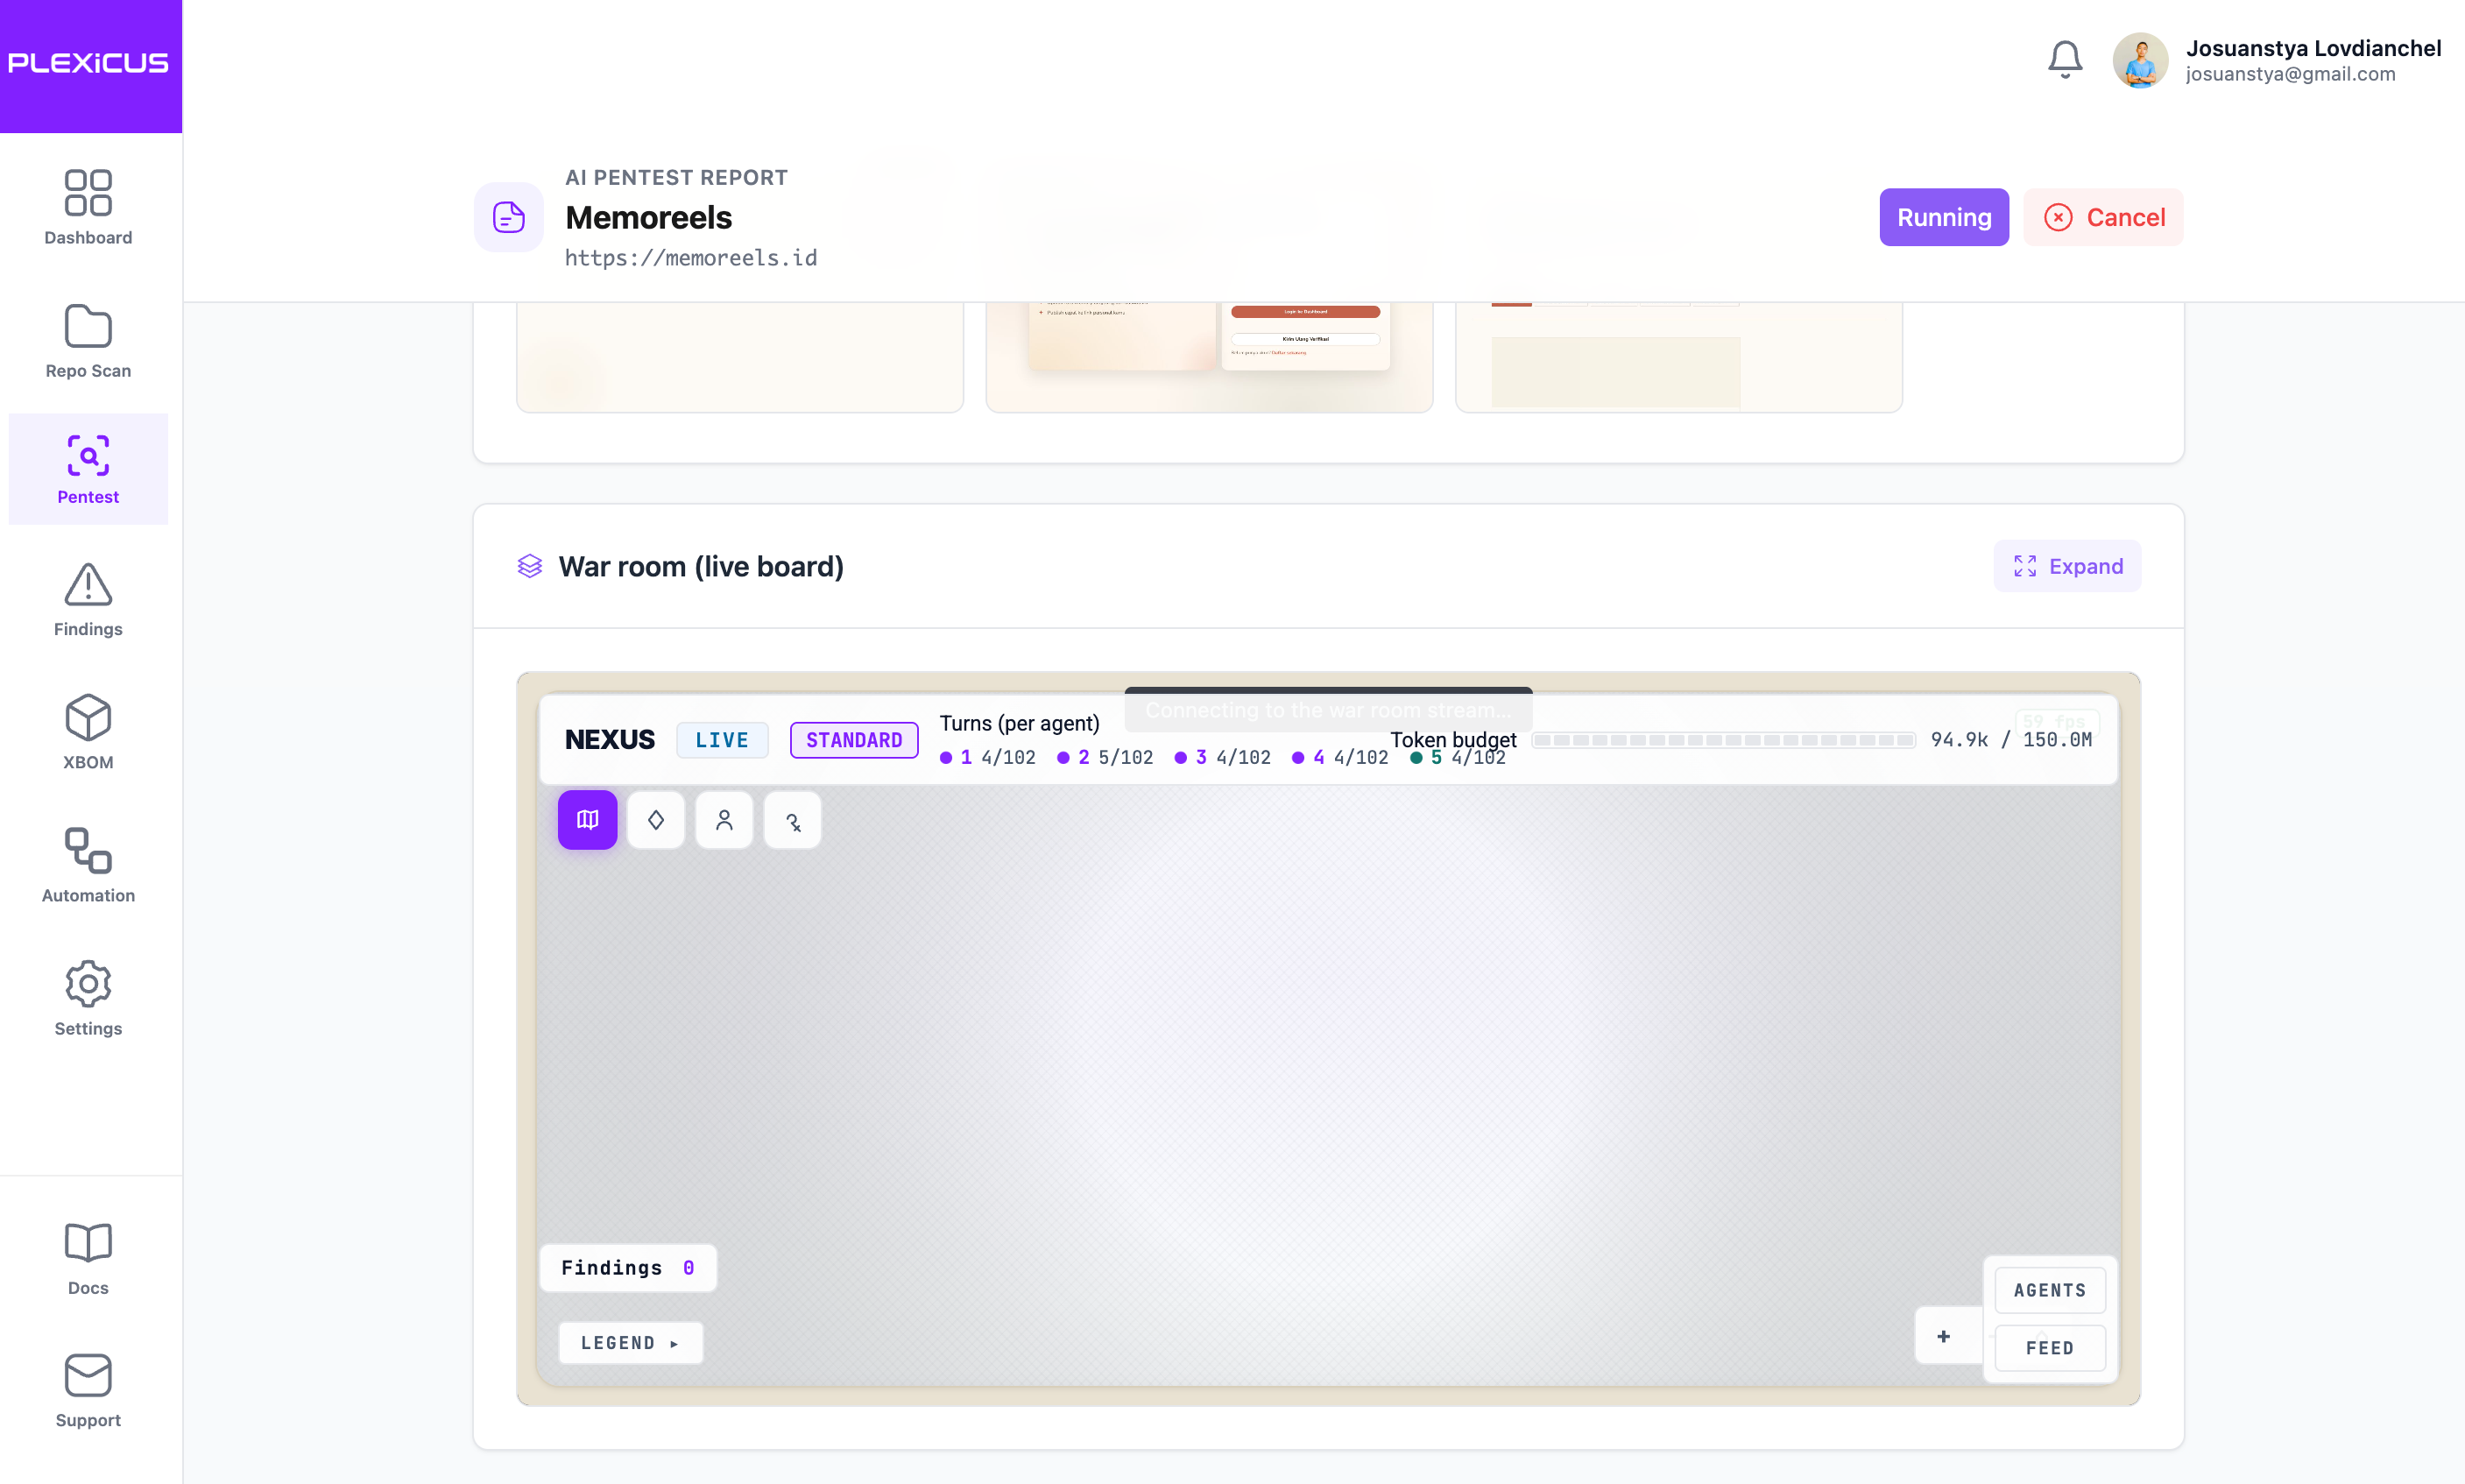
El tablero en vivo de War room integrado se muestra mientras se conecta al flujo.
El contexto compartido cambia lo que puede investigar la IA
Los pentests prolongados generan enormes cantidades de conocimiento temporal.
Un agente puede descubrir que:
un endpoint requiere un token concreto,
un usuario pertenece a un rol determinado,
un parámetro controla un objeto del backend,
un servicio expone un hostname interno,
un payload fallido aun así reveló la versión de un framework,
o un flujo de autenticación crea credenciales que resultan útiles en otro lugar.
Si esas observaciones quedan atrapadas en el contexto local del agente que las descubrió, su valor es limitado.
Una representación compartida del ataque permite acumular información.
La descripción de la próxima charla de APIAddicts Days 2026, el 15 de octubre, propone una prueba de concepto de Plexicus que combina habilidades especializadas, MCP y una base de datos orientada a grafos para almacenar memoria de ataque. La representación propuesta conecta activos, vulnerabilidades y rutas de explotación.
Las representaciones similares a grafos encajan bien con la seguridad ofensiva porque los propios ataques son grafos.
Un nodo puede representar:
Usuario
Endpoint
Credencial
Repositorio
Servicio
Rol
Vulnerabilidad
Activo
Secreto
Una arista puede representar:
PUEDE_ACCEDER
SE_AUTENTICA_EN
LLAMA_A
ES_PROPIETARIO_DE
EXPONE
DEPENDE_DE
ELUDE
CONDUCE_A
La pregunta de seguridad interesante pasa a ser:
¿Qué nueva ruta aparece al conectar estas relaciones?
Eso se acerca mucho más a cómo razonan los atacantes experimentados.
La verificación importa más que la generación
La IA generativa plantea un problema evidente para la seguridad ofensiva:
Puede equivocarse con mucha seguridad.
Un modelo puede interpretar mal una respuesta.
Un comando puede devolver un código de éxito inesperado.
Una aplicación puede comportarse de forma incoherente.
Un payload puede parecer que funciona aunque su impacto real sea distinto del que concluye el agente.
Por eso, un sistema de pentesting con IA no debe equiparar:
«El modelo cree que encontró una vulnerabilidad»
con:
«Se ha verificado una vulnerabilidad».
El sector de la IA ofensiva converge cada vez más en esta idea.
XBOW describe públicamente el uso de agentes validadores y la exigencia de pruebas antes de comunicar hallazgos validados.
Plexicus aplica el mismo principio general dentro de su modelo Proof-Driven AppSec: los hallazgos que se presentan como verificados requieren pruebas reproducibles y una confirmación independiente. Si una segunda pasada no puede reproducir el resultado, Plexicus indica que el hallazgo permanece sin verificar o se descarta.
Eso cambia el objetivo de optimización.
Un sistema débil de seguridad con IA optimiza para:
¿Cuántas vulnerabilidades podemos generar?
Un sistema basado en pruebas debería optimizar para:
¿Cuántas rutas de ataque relevantes podemos demostrar con pruebas defendibles?
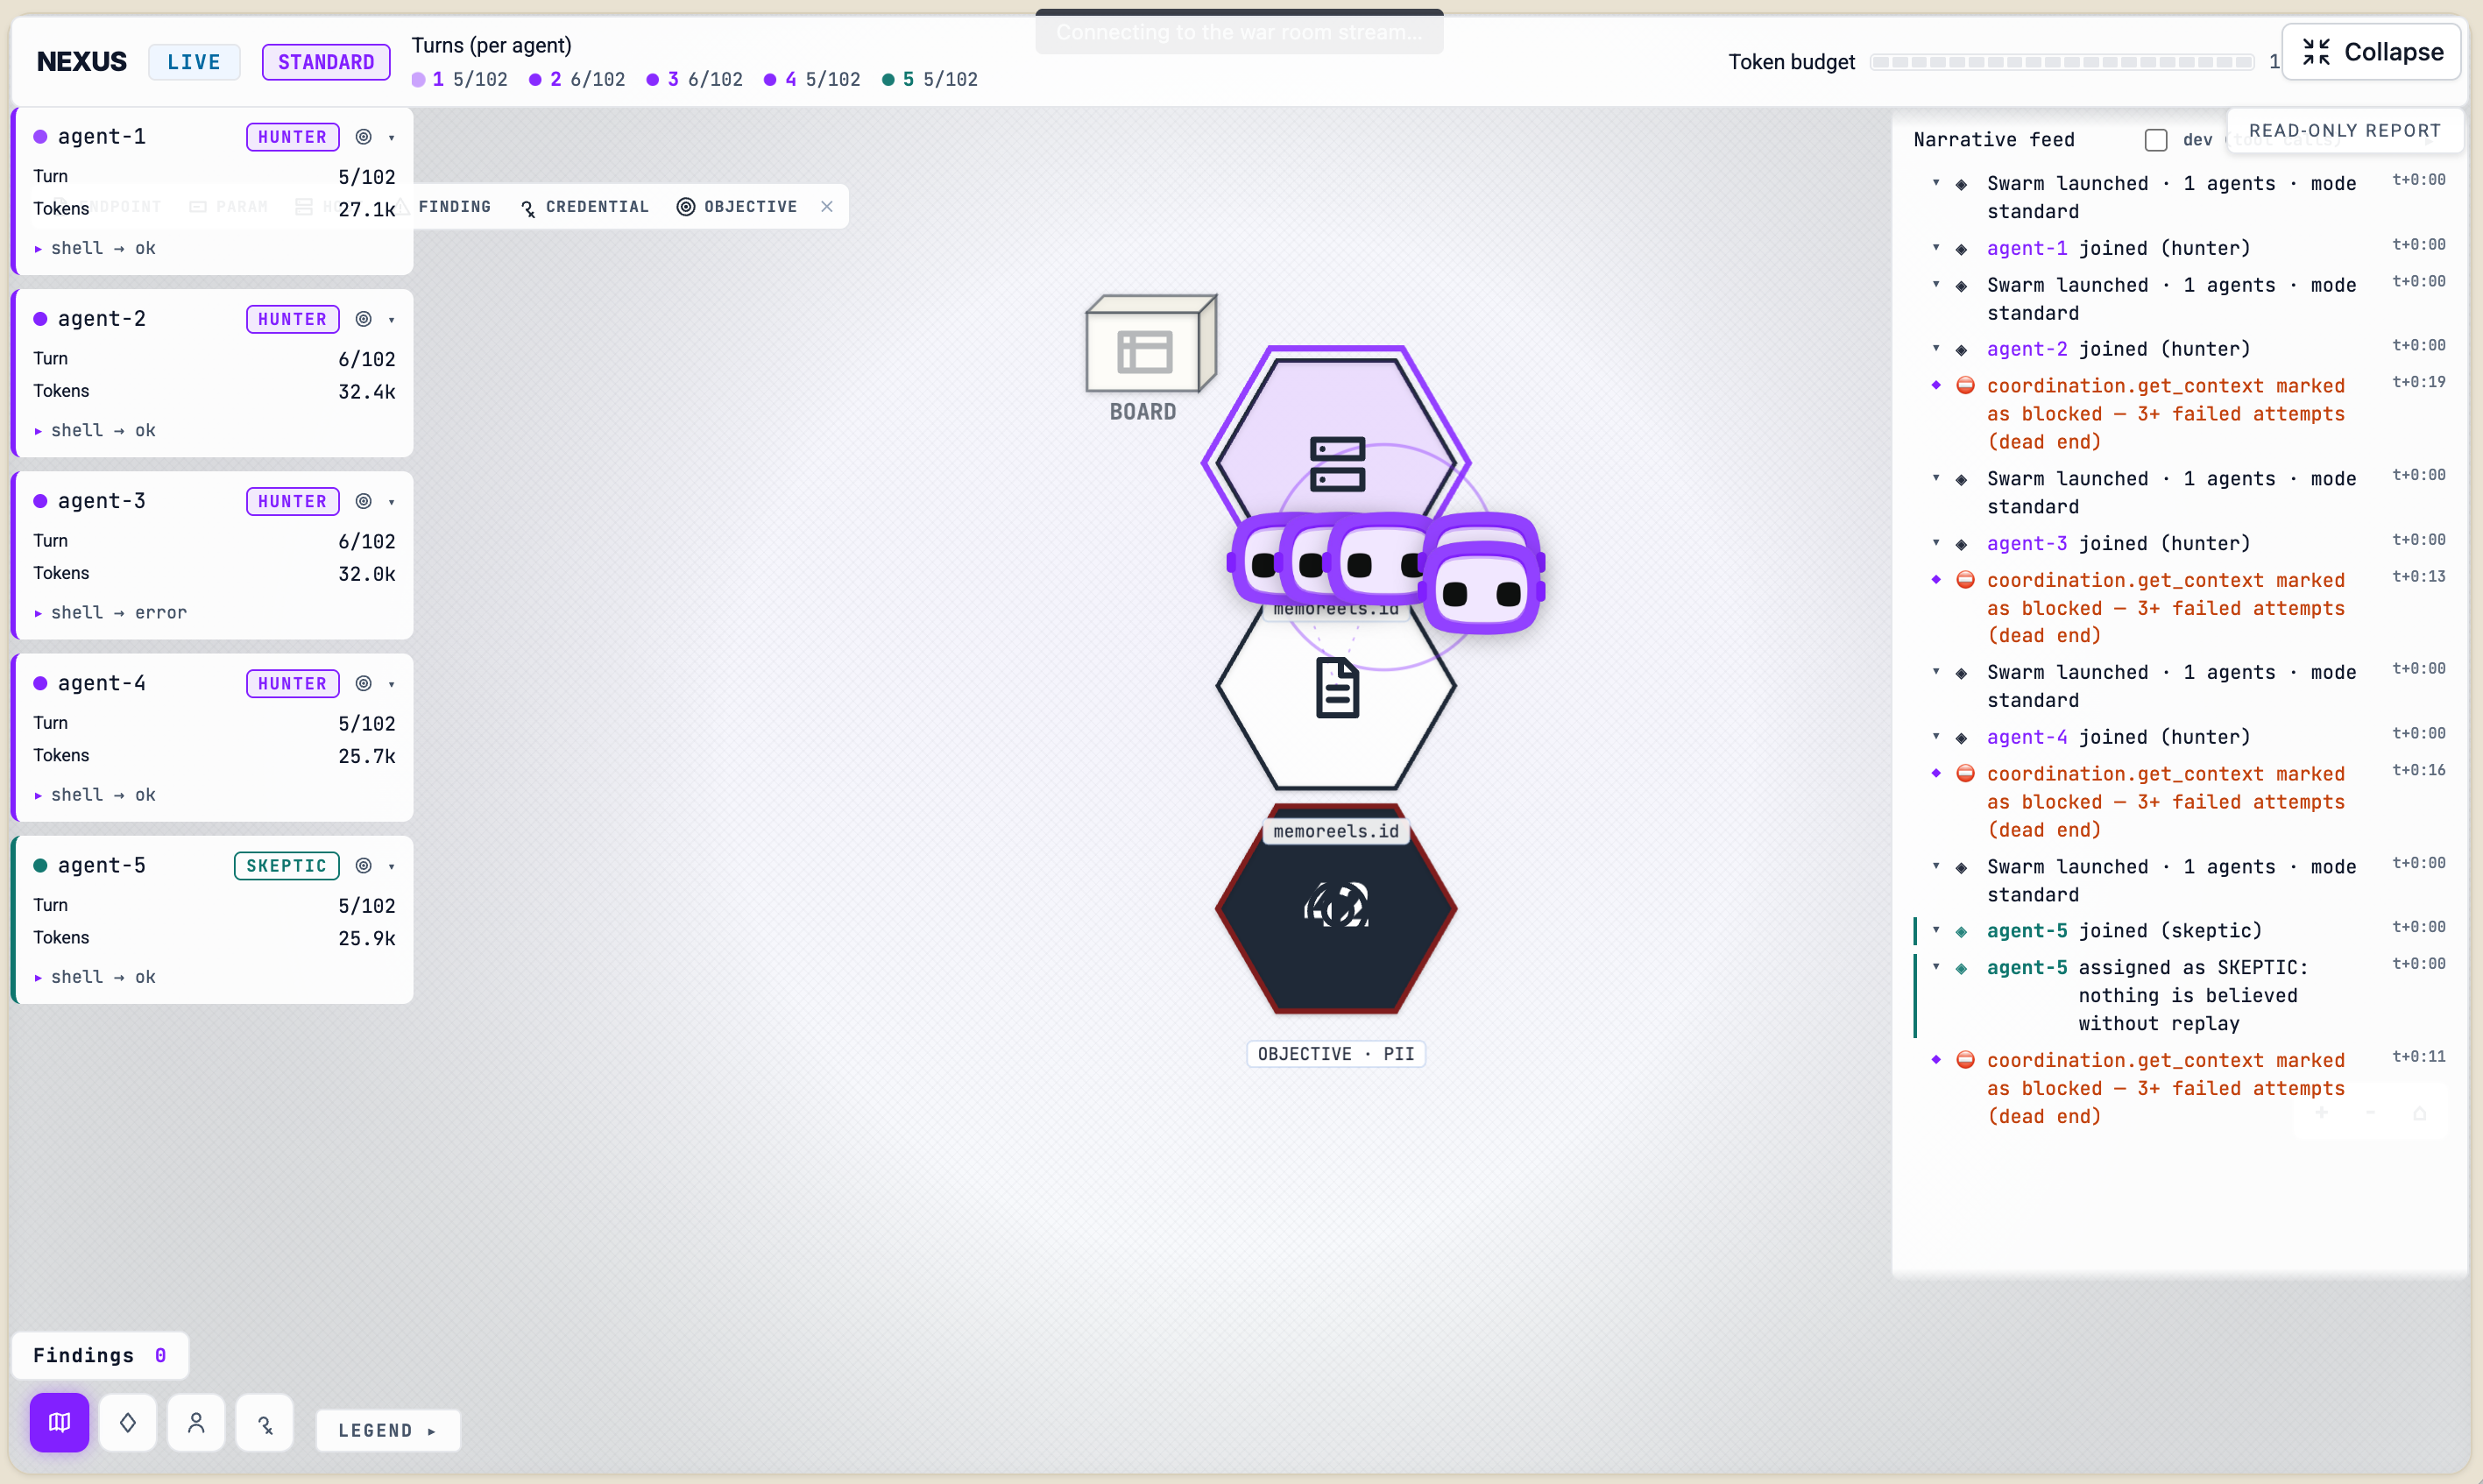
El tablero ampliado muestra cuatro agentes hunter y un skeptic, la actividad de cada agente y el flujo narrativo. Esta captura muestra cero hallazgos e intentos bloqueados; no demuestra un exploit verificado.
Por qué las cadenas de ataque importan más que el número de alertas
Los equipos de seguridad rara vez sufren por falta de alertas.
Una organización moderna puede recibir ya resultados de:
SAST,
SCA,
DAST,
escáneres de nube,
escáneres de contenedores,
escáneres de secretos,
CSPM,
inteligencia sobre dependencias,
programas de bug bounty
y pentests manuales.
El problema más difícil es decidir qué importa de verdad.
Considere tres hallazgos aislados:
Un endpoint accesible desde Internet expone un identificador de servicio.

Un servicio interno acepta un destino de redirección sin validar.

Un endpoint privilegiado confía en las peticiones originadas por ese servicio.
Por separado, quizá ninguno parezca catastrófico.
Combinados:
Atacante externo
      ↓
Endpoint público
      ↓
Descubrimiento de un servicio interno
      ↓
Primitiva SSRF / de enrutamiento
      ↓
Petición interna de confianza
      ↓
Endpoint privilegiado
El riesgo surge de la ruta, no solo de los hallazgos individuales.
Por eso Plexicus centra AI Swarm Pentest en rutas de ataque validadas, en lugar de en una lista interminable de problemas potenciales.
Pero ¿por qué llamarlo «swarm»?
La palabra puede sonar a jerga de marketing.
No debería significar «lanzamos muchos agentes».
En un swarm de seguridad útil, las capacidades deben contribuir a una misión común.
El modelo mental se parece al de un equipo de pentesting coordinado:
                     Misión
                        │
           ┌────────────┼────────────┐
           │            │            │
        Explorar       Razonar      Explotar
           │            │            │
           └────────────┼────────────┘
                        │
                Contexto compartido
                        │
           ┌────────────┼────────────┐
           │                         │
      Cuestionar                  Verificar
           │                         │
           └────────────┬────────────┘
                        │
                      Pruebas
Distintas capacidades pueden investigar diferentes partes del ataque.
Pero no son investigadores independientes que redactan notas inconexas.
Contribuyen a una representación común del objetivo que evoluciona con la investigación.
Por tanto, la inteligencia del sistema no proviene solo del modelo, sino también de la orquestación que lo rodea.
Esto cobra especial importancia a medida que mejoran los modelos de pesos abiertos.
La descripción de la próxima charla de APIAddicts plantea una pregunta relacionada: ¿cómo pueden la orquestación, las habilidades especializadas, las herramientas MCP y una memoria de ataque persistente ayudar a un modelo de pesos abiertos a investigar un objetivo autorizado?
AI Swarm Pentest dentro de Proof-Driven AppSec
El pentesting es útil.
Pero descubrir una vulnerabilidad explotable es solo el principio del flujo de trabajo de ingeniería.
Alguien debe entender el código afectado.
Alguien debe evaluar la alcanzabilidad y el impacto en el negocio.
Alguien debe determinar la corrección más segura.
Alguien debe implementarla.
Alguien debe revisar el cambio.
Y alguien debería verificar que el exploit original ya no funciona.
Por eso Plexicus presenta AI Swarm Pentest como un componente de un flujo de trabajo más amplio de Proof-Driven AppSec.
El modelo puede resumirse así:
VALIDAR
AI Swarm Pentest
      │
      │ ruta explotable + pruebas
      ▼
ENTENDER
Deep Code Analysis
      │
      │ contexto de código + impacto
      ▼
CORREGIR
Corrección revisada
      │
      │ cambio propuesto
      ▼
VOLVER A PROBAR
¿Sigue reproduciéndose el ataque?
La plataforma actual de Plexicus lo describe como Validate → Understand → Remediate: AI Swarm Pentest explora rutas de ataque autorizadas, Deep Code Analysis añade contexto del código y la remediación puede generar cambios listos para revisión que luego se vuelven a probar.
Esta conexión es importante.
Sin ella, el pentesting autónomo corre el riesgo de producir una nueva versión de un antiguo problema de seguridad:
más hallazgos de los que los equipos de ingeniería pueden corregir.
Lo que AI Swarm Pentest no es
AI Swarm Pentest no es simplemente un escáner de vulnerabilidades con descripciones generadas por IA.
No es un chatbot que te cuenta cómo podría explotar algo un atacante en teoría.
No es permiso para que un agente autónomo ataque cualquier infraestructura.
No garantiza que se descubran todas las vulnerabilidades.
Y no pretende eliminar el criterio humano de las decisiones de seguridad.
Plexicus describe AI Swarm Pentest explícitamente como un ejercicio con alcance definido y reglas de actuación acordadas, puntos de decisión humanos, verificación independiente y sin modificaciones automáticas de sistemas de producción.
Estas salvaguardas no son limitaciones que haya que eliminar.
Son parte de lo que permite utilizar la seguridad ofensiva autónoma en un entorno profesional.
¿Puede AI Swarm Pentest sustituir a los pentesters humanos?
No por completo.
Y ese tampoco debería ser el objetivo inmediato.
Los pentesters humanos siguen siendo especialmente valiosos cuando las pruebas requieren creatividad poco común, un conocimiento profundo de la organización, razonamiento social, acceso físico, procesos de negocio ambiguos o un criterio sobre consecuencias que no pueda delegarse de forma segura al software.
La IA tiene otras ventajas.
Las máquinas pueden enumerar sistemáticamente superficies grandes.
Pueden repetir tareas sin cansarse.
Pueden seguir muchas hipótesis.
Pueden volver a probar después de los cambios.
Y pueden realizar ciertas formas de exploración en paralelo a una escala que sería costoso reproducir con trabajo humano.
Las investigaciones que comparan agentes de IA con profesionales humanos de ciberseguridad ya muestran esta combinación de ventajas y limitaciones. Los sistemas multiagente pueden rendir bien en la enumeración sistemática y la explotación en paralelo, pero aún tienen dificultades con algunas tareas que dependen mucho de interfaces gráficas y generan más falsos positivos si no cuentan con suficiente verificación.
Por tanto, el futuro más realista no es:
IA contra pentester
Sino:
La IA se ocupa de la exploración escalable
        +
La verificación reduce el ruido
        +
Las personas controlan el alcance y el criterio
        +
Los expertos de seguridad investigan los casos complejos
Plexicus también afirma que AI Swarm Pentest automatiza la exploración repetitiva, la correlación y la reproducción sin eliminar el contexto humano ni la toma de decisiones final.
Cuándo puede ser especialmente útil AI Swarm Pentest
Este enfoque resulta especialmente interesante para las organizaciones cuya superficie de software cambia más rápido de lo que pueden abarcar razonablemente las pruebas manuales periódicas.
Un equipo puede publicar cambios en su aplicación a diario.
Las API pueden aparecer y desaparecer entre ciclos de pentesting.
El código generado por IA puede aumentar considerablemente el ritmo de desarrollo.
Se pueden incorporar continuamente nuevas dependencias y servicios.
Un pentest anual tradicional sigue siendo valioso, pero solo representa una instantánea.
Las pruebas agénticas abren la posibilidad de realizar validaciones ofensivas con más frecuencia.
No limitarse a preguntar:
«¿Ha detectado algo nuestro escáner?»
Sino:
«¿Puede un atacante reproducir esta ruta de ataque después del último cambio?»
Es un cambio importante: de descubrir vulnerabilidades periódicamente a validar la seguridad de forma continua.
Un ejemplo práctico
Imagine una aplicación SaaS generada con IA.
La aplicación contiene:
Frontend web
Servicio de autenticación
API de facturación
API de proyectos
Almacenamiento de archivos
API administrativa
Un escáner tradicional detecta algunas cabeceras de seguridad y una dependencia obsoleta.
Información útil, pero quizá no el problema de mayor riesgo.
Durante un pentest con AI Swarm, la fase de exploración descubre:
GET /api/projects/{project_id}
Un usuario normal puede consultar su propio proyecto.
El swarm registra la relación:
USER_A → OWNS → PROJECT_123
Otra observación revela:
PROJECT_456 → OWNED_BY → USER_B
Se formula una hipótesis de autorización.
La capacidad correspondiente solicita:
GET /api/projects/456
autenticada como el usuario A.
El servidor devuelve metadatos.
Es interesante, pero todavía no basta.
La investigación continúa.
Los metadatos devueltos contienen:
export_id: EXP-8821
Otra capacidad descubre:
GET /api/exports/{export_id}/download
La petición tiene éxito.
El archivo descargado contiene los datos privados del proyecto del usuario B.
La ruta de ataque ahora es:
Usuario A
  ↓
Manipular el identificador del proyecto
  ↓
Leer los metadatos del proyecto de B
  ↓
Descubrir el identificador de exportación
  ↓
Descargar la exportación
  ↓
Exposición de datos entre tenants
Ahora la fase de verificación repite la cadena de forma independiente.
Si el exploit se reproduce, el sistema puede adjuntar pruebas a cada paso.
Deep Code Analysis puede rastrear después en el código la falta del control de autorización.
Un flujo de remediación puede proponer una validación vinculada al tenant.
Tras la revisión, se puede volver a ejecutar el exploit original.
Si falla:
Ataque reproducido antes de la corrección: SÍ
Ataque reproducido después de la corrección: NO
Eso es un artefacto de seguridad mucho más sólido que:
Posible IDOR — Alta
El resultado más importante son las pruebas
La IA generativa hará que producir hipótesis de seguridad sea extremadamente barato.
Eso es potente y peligroso a la vez.
Un modelo puede generar cientos de explicaciones plausibles de por qué una aplicación podría ser vulnerable.
Pero los equipos de AppSec no necesitan cientos de explicaciones plausibles.
Necesitan confianza.
Necesitan saber:
¿A qué llegaste?

¿Cómo llegaste?

¿Se puede reproducir?

¿Cuál es el impacto?

¿Dónde se origina el comportamiento vulnerable?

¿Qué deberíamos cambiar?

¿La corrección detuvo realmente el ataque?
Por eso las pruebas importan más, y no menos, a medida que la IA gana capacidad.
Cuanto más autónoma sea la seguridad, más sólida tendrá que ser su capa de verificación.
El futuro del pentesting no es un único modelo más grande
Durante varios años, el progreso de la IA se describió con frecuencia en términos del tamaño del modelo.
Un modelo más inteligente daba mejores respuestas.
El pentesting muestra por qué esa forma de pensar es incompleta.
La seguridad ofensiva no es solo una prueba de razonamiento.
Es un problema de sistemas.
La IA necesita herramientas.
Necesita memoria.
Necesita permisos.
Necesita estado.
Necesita una representación del entorno.
Necesita saber cuándo explorar.
Necesita saber cuándo detenerse.
Necesita distinguir una hipótesis prometedora de un exploit demostrado.
Y necesita un mecanismo para que otro proceso cuestione sus conclusiones.
Eso significa que el futuro del pentesting autónomo puede depender tanto de la arquitectura y la orquestación como de la inteligencia bruta del modelo.
La evolución podría ser algo así:
Escáner de seguridad
      ↓
Asistente de seguridad con LLM
      ↓
Agente autónomo de pentesting
      ↓
Pentesting multiagente
      ↓
AI Swarm orquestado
      ↓
Proof-Driven AppSec
Cada etapa no sustituye necesariamente a la anterior.
Los escáneres siguen siendo útiles.
Los pentesters humanos siguen siendo útiles.
Los sistemas de un solo agente siguen siendo útiles.
La pregunta es qué arquitectura se ajusta mejor a la complejidad y la frecuencia del problema de seguridad que se quiere probar.
AI Swarm Pentest en Plexicus
AI Swarm Pentest de Plexicus se basa en un principio sencillo:
No te quedes en detectar qué podría ser vulnerable. Demuestra a qué puede llegar realmente un atacante.
Dentro de un alcance autorizado, Plexicus explora el comportamiento de las aplicaciones y las API, formula y prueba hipótesis de ataque, relaciona observaciones pertinentes y mantiene las pruebas de respaldo asociadas a los hallazgos.
Los hallazgos presentados como verificados pasan por una fase de reproducción independiente.
Después, el resultado se conecta con el resto del flujo Proof-Driven AppSec de Plexicus, donde los equipos pueden añadir contexto del código, entender el impacto, revisar la corrección y volver a verificar el resultado.
El objetivo no es generar el informe de pentesting más extenso.
Es dar a los equipos de seguridad e ingeniería algo más útil:
Una ruta de ataque validada.
Pruebas que muestran por qué es real.
Contexto sobre lo que afecta.
Y una vía clara para corregirlo.
Preguntas frecuentes
¿AI Swarm Pentest es lo mismo que el análisis automatizado de vulnerabilidades?
No.
Un escáner suele ejecutar comprobaciones o pruebas predeterminadas e informar del comportamiento que coincide con ellas. AI Swarm Pentest utiliza razonamiento agéntico para explorar un objetivo autorizado, formular hipótesis, interactuar con el comportamiento de la aplicación e investigar rutas de ataque.
Plexicus ofrece tanto DAST como AI Pentest y los documenta por separado.
¿AI Swarm Pentest es simplemente un grupo de LLM ejecutándose al mismo tiempo?
No.
El paralelismo por sí solo no crea un comportamiento swarm útil.
Lo esencial es la orquestación, la distribución de responsabilidades especializadas, el contexto de ataque compartido, la ejecución controlada y la verificación.
¿Cada agente necesita un modelo de IA distinto?
No.
La especialización de los agentes y la especialización de los modelos son conceptos distintos.
Varios agentes pueden utilizar el mismo modelo subyacente y aun así recibir misiones, herramientas, permisos, contexto o responsabilidades de validación diferentes.
Por el contrario, una capa de orquestación podría elegir modelos distintos para tareas diferentes.
¿El concepto «swarm» es exclusivo de Plexicus?
Los sistemas de seguridad multiagente no son exclusivos de Plexicus.
Los sistemas académicos y las plataformas comerciales de pentesting autónomo también utilizan arquitecturas multiagente, agentes especializados o agentes validadores.
Plexicus usa AI Swarm Pentest para describir su implementación de este enfoque dentro de su flujo más amplio de Proof-Driven AppSec, con énfasis en el contexto de ataque compartido, las pruebas, la verificación independiente, el análisis de código y la remediación.
¿AI Swarm Pentest puede encontrar vulnerabilidades de lógica de negocio?
Las pruebas agénticas son especialmente pertinentes para las vulnerabilidades de lógica de negocio y las que constan de varios pasos, porque pueden interactuar con flujos de trabajo en vez de depender exclusivamente de firmas fijas.
La documentación de Plexicus indica que AI Pentest puede probar flujos autenticados y descubrir cadenas de ataque complejas y fallos de lógica de negocio.
¿AI Swarm Pentest ataca automáticamente los sistemas de producción?
Las pruebas deben limitarse a un alcance autorizado explícitamente y a unas reglas de actuación acordadas.
Plexicus afirma que el ejercicio tiene un alcance controlado y no modifica automáticamente los sistemas de producción.
¿Elimina los falsos positivos?
Ningún sistema de seguridad autónomo debería prometerlo.
El objetivo es reducir la incertidumbre mediante la reproducibilidad y las pruebas.
En Plexicus, un hallazgo debe superar una fase de verificación aparte antes de presentarse como verificado.
¿AI Swarm Pentest sustituye el pentesting manual?
No.
Modifica qué partes de las pruebas de penetración se pueden automatizar y repetir a escala de máquina.
La experiencia humana sigue siendo importante para definir el alcance, interpretar resultados, investigar casos especiales y tomar decisiones finales.
De encontrar vulnerabilidades a demostrar rutas de ataque
La IA facilita generar código.
También facilita generar ataques.
La validación de seguridad debe evolucionar en consecuencia.
La respuesta no puede ser simplemente otro escáner que produzca otra cola de alertas.
Y añadir un LLM a ese escáner no resuelve automáticamente el problema.
Lo que transforma el flujo de trabajo es poder investigar de forma dinámica:
Explorar.
Formular una hipótesis.
Ponerla a prueba.
Compartir lo aprendido.
Relacionarlo con otra observación.
Cuestionar la conclusión.
Reproducir el ataque.
Conservar las pruebas.
Esa es la idea que hay detrás de AI Swarm Pentest.
No es una IA que pretenda ser todo un equipo red team.
Es un sistema orquestado que trabaja en una única misión de seguridad autorizada.
Y, sobre todo:
Sin pruebas reproducibles, no hay hallazgo verificado.
Comprueba a qué puede llegar realmente un atacante
AI Swarm Pentest de Plexicus explora rutas de ataque autorizadas en aplicaciones y API, valida qué es explotable y proporciona a tu equipo pruebas que puede revisar y utilizar.
Valida la ruta. Entiende el impacto. Corrígelo con pruebas.