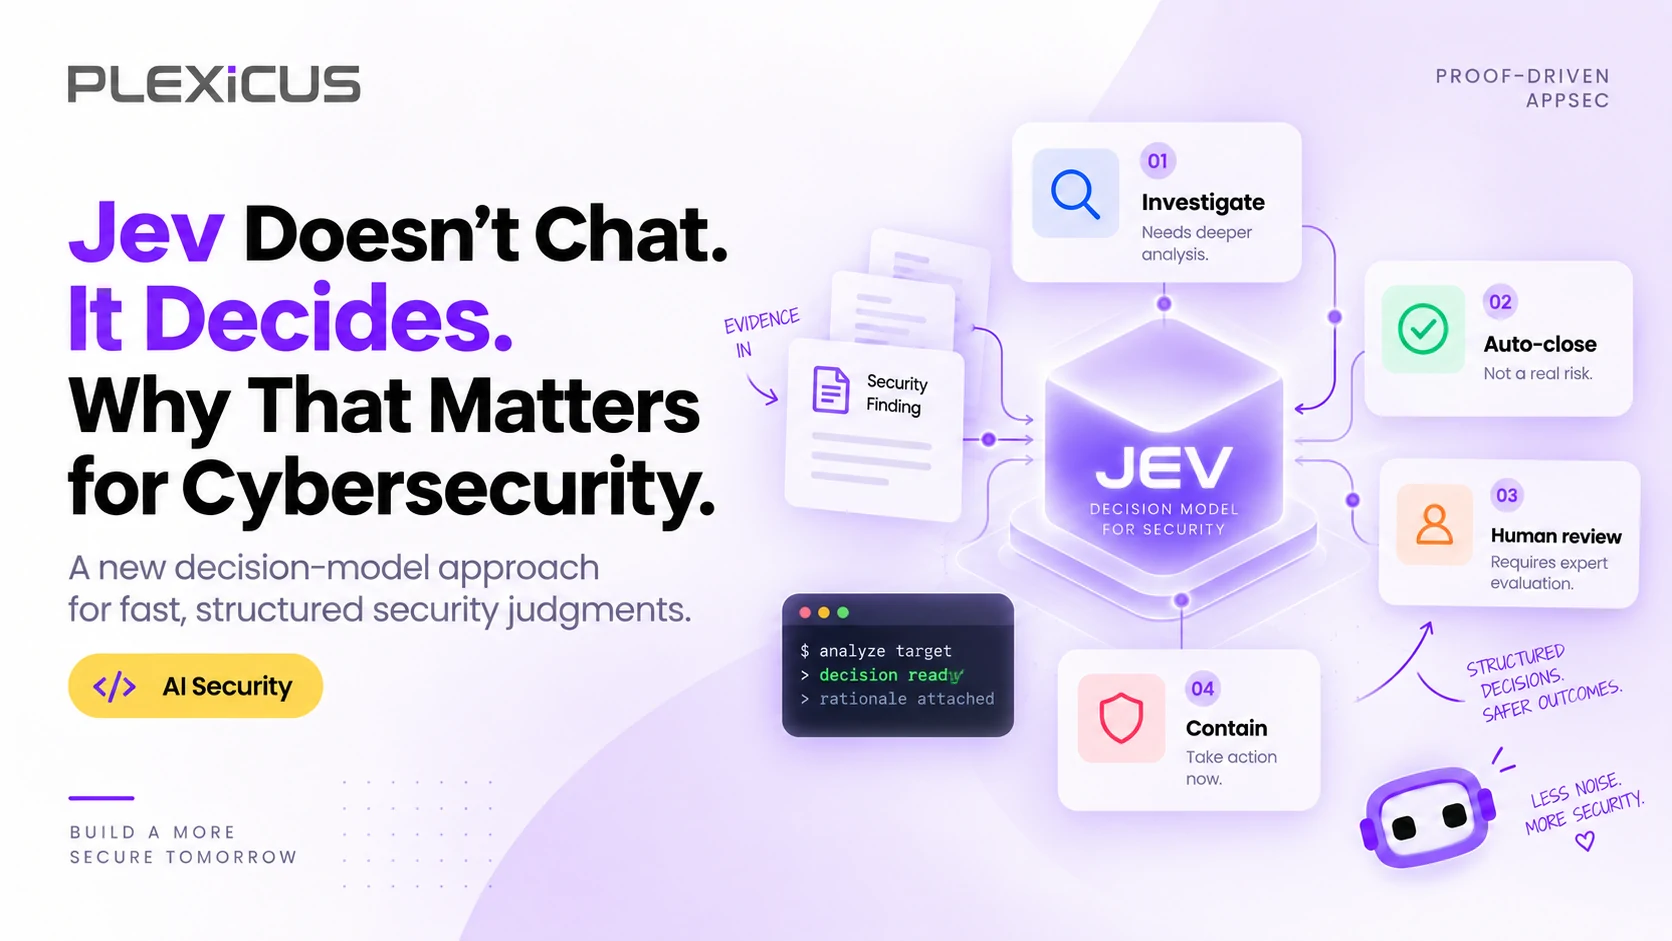
Jev AI no conversa. Decide. Por qué importa para la ciberseguridad
Jev devuelve decisiones tipadas en vez de prosa. Eso puede cambiar dónde encaja el juicio semántico en seguridad, siempre que se mantengan política, respaldo, verificación y revisión humana.
Más allá de ASPM
AppSec basada en pruebas para equipos que desarrollan con IA
Plexicus usa AI Swarm Pentest para explorar rutas de aplicaciones autorizadas, validar qué es explotable y dar a los equipos evidencia para priorizar la remediación.
Explorar AI Swarm PentestJev AI es un modelo de decisión de TypeSafe AI que devuelve elecciones, puntuaciones y probabilidades tipadas en lugar de texto generado. Para la IA en ciberseguridad esto importa porque los sistemas de seguridad toman millones de pequeñas decisiones urgentes, y un modelo que decide en menos de un segundo y por una fracción de céntimo podría aportar contexto semántico donde los grandes LLM son demasiado lentos o caros.
Durante años la carrera de IA se ha centrado en una pregunta: ¿qué modelo genera la mejor respuesta? TypeSafe AI plantea otra: ¿qué ocurre si el software no necesita una respuesta, sino una decisión?
El 15 de septiembre de 2026 TypeSafe presentó Jev, un modelo que recibe contexto y preguntas predefinidas y devuelve elecciones, puntuaciones o probabilidades tipadas. En seguridad, esa diferencia puede ser importante: cada día los sistemas deben decidir si un inicio de sesión es sospechoso, si un proceso debe detenerse o si una acción de un agente excede sus permisos.
De generar lenguaje a decidir
Un LLM puede explicar por qué una alerta parece sospechosa. El software, sin embargo, suele acabar necesitando solo esto:
riesgo = crítico
acción = contener
confianza = 0,97
Jev elimina la generación de prosa: la aplicación define las salidas posibles y el modelo devuelve probabilidades. TypeSafe lo resume como estado no estructurado de entrada y decisiones probabilísticas tipadas de salida. Su integración con Vercel AI Gateway describe decisiones de tipo Choice, Score y Boolean evaluadas en paralelo.
Una prueba de seguridad ya existe
La evaluación Security Incidents de TypeSafe incorpora alerta, activo, propietario, tickets, dispositivos, mantenimiento y autorizaciones. Primero pregunta si la actividad parece no autorizada, si los registros la explican y qué fuerza tiene la evidencia; después puede evaluar credenciales, sesiones, correo, persistencia, procesos, red y propagación. Sus salidas incluyen notificar, escalar, terminar procesos y deshabilitar cuentas.
Esto se parece a la lógica de SIEM, SOAR y triage. La diferencia potencial es que parte de la ramificación deja de ser solo determinista. Ante un viaje válido, MFA completado y un cambio VPN aprobado, una regla simple no basta. Un modelo de decisión podría devolver probabilidades de actividad no autorizada, explicación aprobada, compromiso y necesidad de contención. El modelo estima; la política de seguridad aplica.
Las primeras pruebas independientes
TypeSafe comunica 70–500 ms de latencia y 0,042 USD por millón de tokens de entrada, además de comparativas de flujo de trabajo muy favorables. Son resultados del proveedor: la empresa reconoce que sus mayores ganancias representan el extremo alto de los resultados reales y que sus propios especialistas diseñaron los flujos.
La evaluación de Nexus Agent aporta evidencia externa inicial. Informa de 19.118 momentos reales y 36.218 llamadas a Jev. En 469 casos de guardrails, Jev decidió el 58% de los casos, con 90 errores totales tras recurrir a reglas para los casos inciertos; las reglas tuvieron 148, Haiku 99 y Sonnet 92.
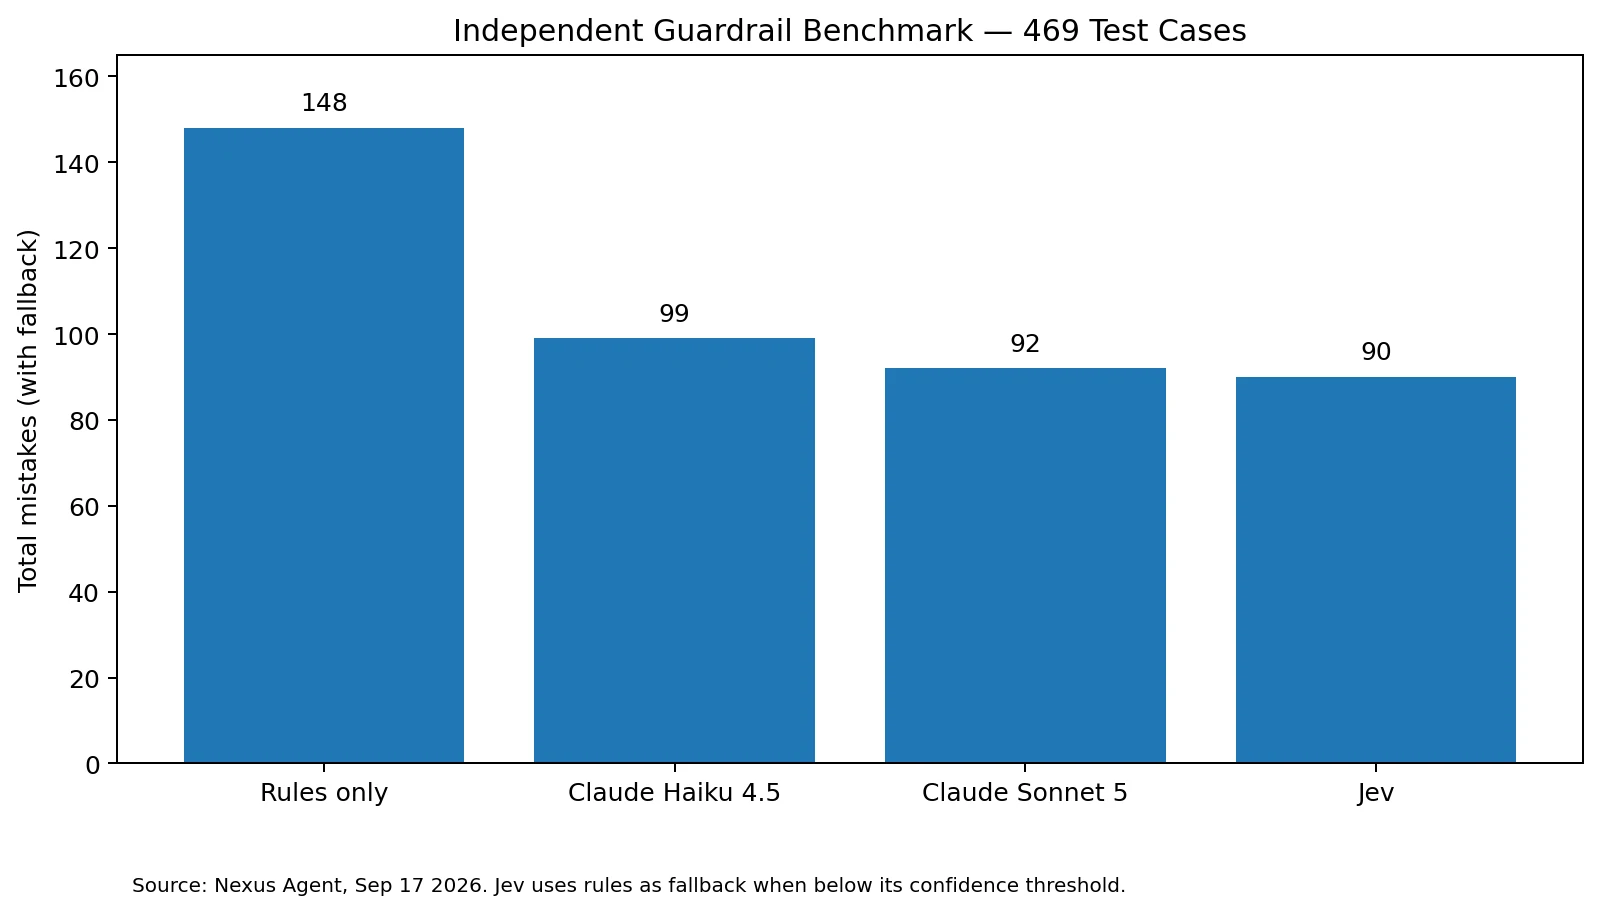
Figura 1. Errores totales con fallback. Fuente: Nexus Agent, 17 de septiembre de 2026.
El dato crucial es la cobertura: 1,8% de error cuando decide no significa precisión universal. El patrón útil es responder solo cuando hay confianza y escalar lo incierto a reglas, un modelo más fuerte o una persona. Profundizamos en esa decisión de encaminamiento en IA en la seguridad de aplicaciones: automatización vs. aumento.
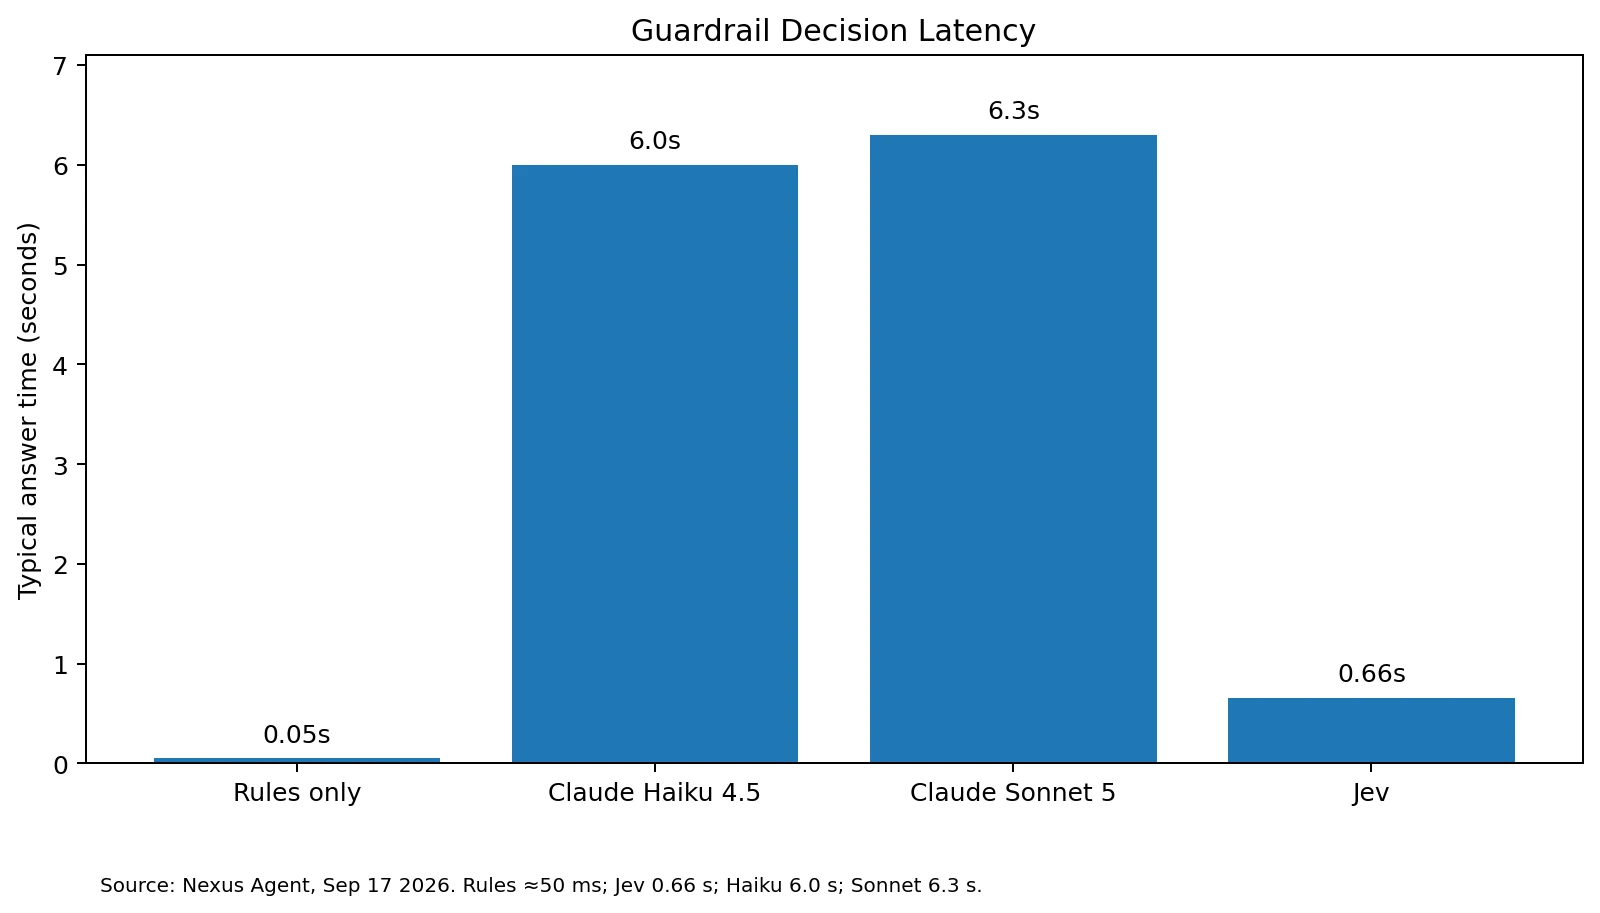
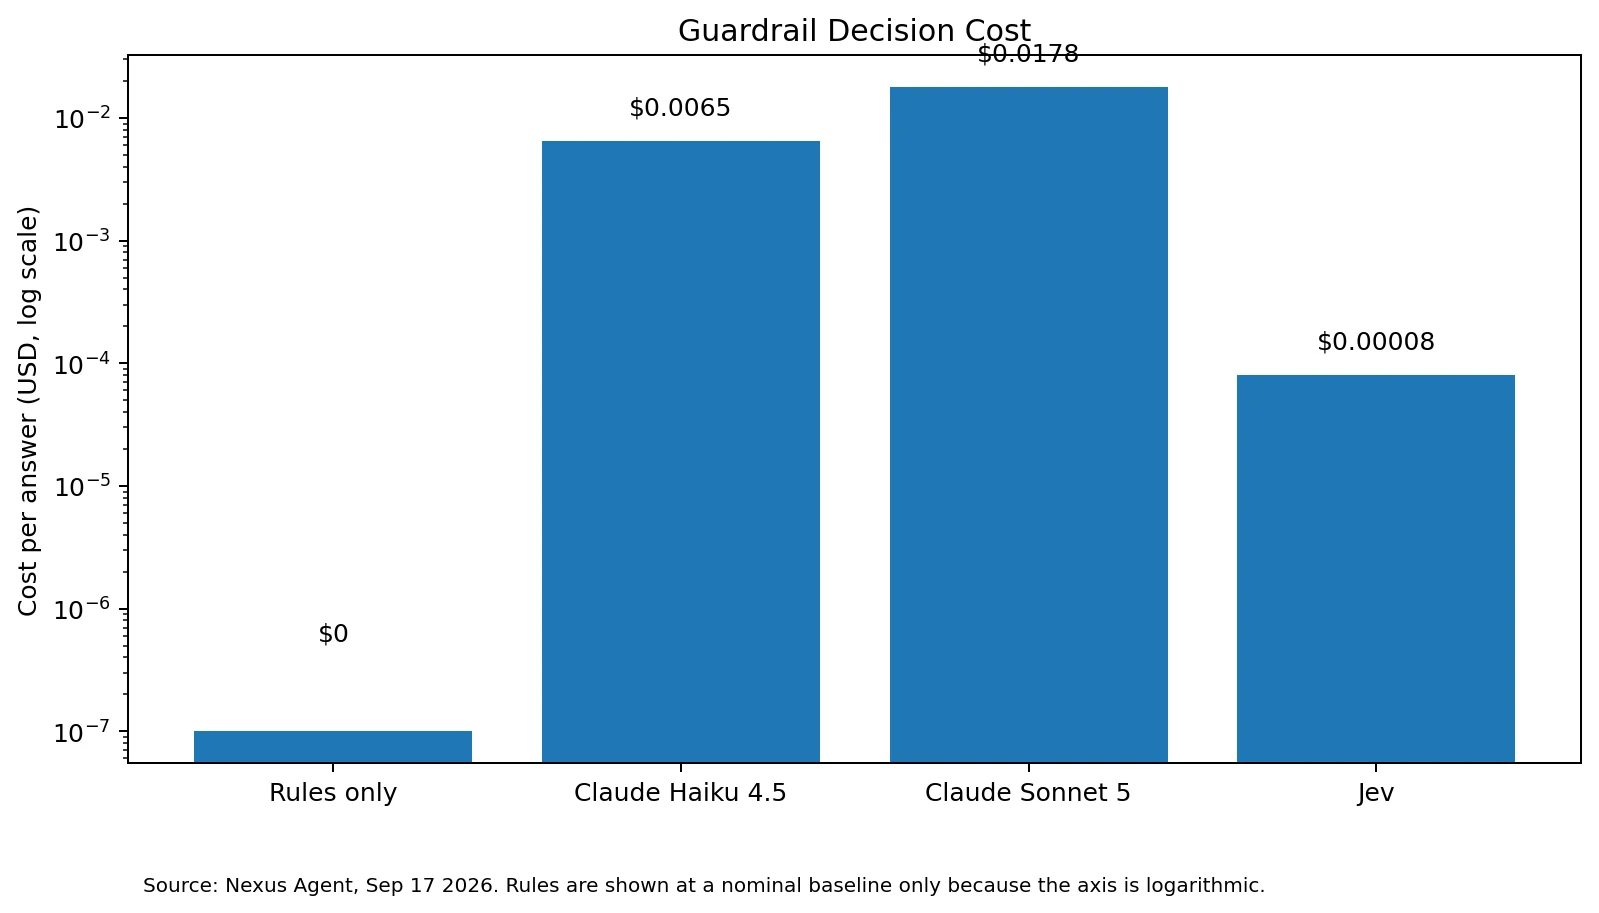
Nexus informa una latencia mediana de 0,68 segundos y un coste de 0,00008 USD por decisión para Jev en ese escenario.
Dónde puede importar Jev AI en la IA para ciberseguridad
En un SOC, un modelo de decisión podría clasificar antes los eventos: benignos, inciertos y de alto riesgo. No sustituye a analistas; reserva el razonamiento caro y la atención humana para los casos donde aportan valor.
También puede ser una capa de guardrail para agentes de IA. Antes de una acción irreversible, puede estimar si es destructiva, reversible, autorizada y si exige aprobación humana. La política puede bloquear la acción aunque el modelo razonador principal quiera ejecutarla. Esto corresponde directamente al riesgo Excessive Agency (LLM06) del OWASP Top 10 for LLM Applications. El mismo patrón aplica a DLP semántico, phishing, IAM, fraude y priorización de vulnerabilidades.
Tipado no significa corrección
Que Jev, según TypeSafe, no pueda devolver una salida fuera del esquema es valioso, pero no demuestra que la decisión sea correcta. Puede devolver ALLOW cuando debía devolver BLOCK. Para seguridad, estos modelos son sensores probabilísticos, no motores de política infalibles.
decisión + confianza → política de seguridad
alta confianza y bajo impacto → automatizar
incertidumbre → investigar
alto impacto o irreversibilidad → controles y autorización más fuertes
El coste de equivocarse debe fijar el umbral: borrar spam y borrar una base de datos de producción nunca deben compartirlo.
La pregunta correcta
Jev no reemplaza modelos de razonamiento, investigación profunda ni juicio humano. Ese trabajo sigue correspondiendo a sistemas de razonamiento, como modelos de frontera tipo Claude Opus 5.5 o herramientas multiagente como un AI Swarm Pentest. Es una posible capa especializada entre detección, razonamiento, verificación, política y acción.
Es demasiado pronto para llamarlo un avance definitivo: las cifras más espectaculares siguen siendo del proveedor y el estudio de Nexus cubre un entorno concreto. Pero la pregunta es relevante: ¿qué decisiones de seguridad son hoy demasiado frecuentes, rápidas o baratas para justificar IA, y qué cambia si esa restricción desaparece?
Evaluación editorial: las implementaciones críticas deben conservar límites de autorización deterministas, verificación independiente, fallbacks y revisión humana para acciones consecuentes. Explicamos por qué la verificación importa en de la alerta a la corrección con AppSec basada en pruebas.
Preguntas frecuentes
¿Qué es Jev AI?
Jev es un modelo de decisión que TypeSafe AI presentó en septiembre de 2026 como el primero de lo que llama System One Models. En lugar de generar texto, recibe contexto y preguntas predefinidas y devuelve respuestas tipadas de tipo Choice, Score o Boolean con probabilidades que el software puede usar directamente. TypeSafe indica tiempos de respuesta de 70–500 ms.
¿En qué se diferencia Jev AI de un LLM como GPT o Claude?
Un LLM convencional genera prosa token a token que después el software debe analizar. Jev evalúa preguntas predefinidas en paralelo y solo devuelve los tipos de respuesta permitidos, por lo que no produce salidas mal formadas. Cambia el razonamiento abierto y la generación de texto por velocidad, bajo coste y decisiones estructuradas: complementa a los modelos de razonamiento, no los sustituye.
¿Se puede usar Jev AI en ciberseguridad?
Posiblemente. TypeSafe ha publicado una evaluación de flujo para incidentes de seguridad, y Nexus Agent probó Jev como guardrail para agentes de IA. Los usos probables incluyen triaje en el SOC, control de acciones de agentes, DLP semántico, análisis de phishing y priorización de vulnerabilidades. La evidencia aún es temprana, así que conviene validarlo con datos propios.
¿«Tipado» significa que Jev AI no se equivoca?
No. La seguridad de tipos garantiza que la salida respeta el esquema definido por la aplicación, como ALLOW, REVIEW o BLOCK, pero no que la elección sea correcta. En la evaluación de Nexus, Jev falló en el 1,8 % de los casos que decidió y derivó el 42 % a reglas de respaldo. Las acciones con consecuencias siguen necesitando política, verificación y revisión humana.
¿Cómo adoptar IA para ciberseguridad de forma segura?
Trata las salidas del modelo como señales probabilísticas, no como autoridad final. Fija umbrales de confianza según el coste de un error, mantén límites de autorización deterministas, deriva los casos inciertos a un modelo más potente o a una persona y verifica los resultados de forma independiente. El NIST AI Risk Management Framework y el OWASP Top 10 for LLM Applications son buenos puntos de partida.
Fuentes