Das Playbook für autonome Behebung: Von der Erkennung zum PR in unter 60 Sekunden
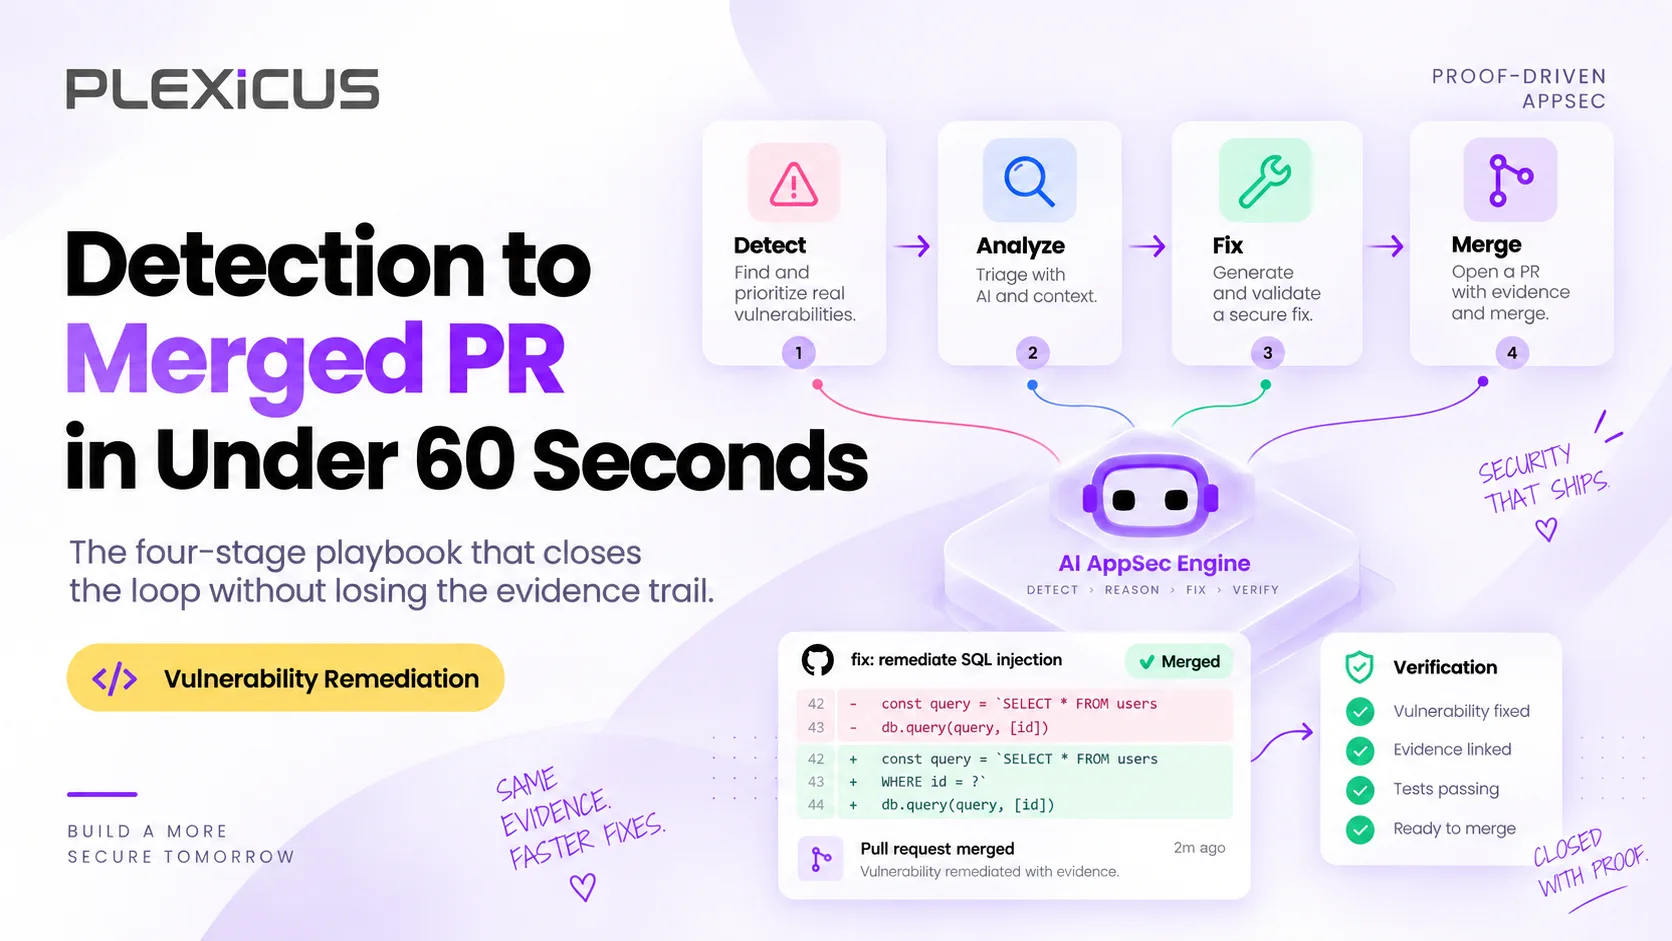
Ein Playbook mit vier Schritten zur automatisierten Schwachstellenbehebung: Es macht aus einem verifizierten Befund in unter 60 Sekunden einen getesteten, reviewbereiten PR und fügt die Nachweise bei.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenAutomatisierte Schwachstellenbehebung bedeutet, einen verifizierten Sicherheitsbefund ohne manuelles Schreiben des Fixes in einen getesteten, reviewbereiten Pull Request umzuwandeln. Das folgende Playbook für autonome Behebung schafft dies in vier Schritten und in weniger als 60 Sekunden von der Erkennung bis zum PR. Ein menschlicher Engineer bleibt dabei das letzte Tor vor dem Merge.
Die Diskussion über die Behebung von Schwachstellen steckt seit zehn Jahren fest. Die Erkennung ist schneller geworden. Die Triage nicht. Das Patchen auch nicht. Der Vulnerability Statistics Report 2026 von Edgescan beziffert die mittlere Behebungszeit für hohe und kritische Schwachstellen in Anwendungen und APIs auf 54,81 Tage. Veracodes State of Software Security 2025 stellte fest, dass sich die durchschnittliche Zeit zum Beheben von Sicherheitslücken seit 2020 um 47 % erhöht hat.
Dann kamen KI-Coding-Tools. Sie verschärften das Mengenproblem, machten aber auch das folgende Playbook möglich. Mit dem Vier-Schritte-Muster meinen wir „autonome Behebung“. Es ist kein Feature auf der Roadmap eines Anbieters. Es ist eine Disziplin, eine Pipeline und eine Feedbackschleife. Wenn dein Team sie nicht betreibt, setzen Angreifer eine schnellere Version davon gegen euch ein.
Das ist das Playbook.
Warum die mittlere Behebungszeit der Engpass ist
Die Zahlen bleiben hartnäckig. In den Kunden-Repositories, die wir einsehen können (interne Plexicus-Daten, kein Branchenbenchmark), sah der mediane Lebenszyklus eines hoch eingestuften Befunds in den Jahren 2025–2026 vor Einführung des Playbooks so aus:
| Phase | Median |
|---|---|
| Von der Erkennung bis zum Beginn der Triage | 3 Tage |
| Vom Triagebeginn bis zur Ursachenanalyse | 6 Tage |
| Von der Ursache bis zum eröffneten PR | 4 Tage |
| Vom eröffneten PR bis zum Merge | 2 Tage |
| Vom Merge bis zur Produktion | 2 Tage |
| Gesamt | 17 Tage |
Siebzehn Tage, bis ein hoch eingestufter Befund geschlossen ist – und verglichen mit den oben genannten Branchenwerten ist das bereits ein gut geführtes Team. Gleichzeitig wird die Angreiferseite immer günstiger. Der Forschungsagent RapidPen erreichte bei einem verwundbaren Ziel in 200–400 Sekunden Shell-Zugriff, bei Kosten von ungefähr 0,30–0,60 US-Dollar pro Durchlauf. Amazon Threat Intelligence dokumentierte, wie ein einzelner wenig versierter Akteur kommerzielle generative KI nutzte, um innerhalb von etwa fünf Wochen mehr als 600 FortiGate-Geräte in 55 Ländern zu kompromittieren.
Die Asymmetrie ist inzwischen unübersehbar. Mandiant ermittelte für 2023 eine durchschnittliche Zeit bis zur Ausnutzung von fünf Tagen. Ein Behebungszyklus, der in Wochen gemessen wird, ist das strukturelle Problem, das dieses Playbook für autonome Behebung schließen soll.
Die vier Schritte der Pipeline zur automatisierten Schwachstellenbehebung
Das Playbook hat vier Phasen. Jede Phase hat genau eine Aufgabe. An den Übergaben zwischen den Phasen verlieren die meisten Teams die Nachweiskette, die Auditoren benötigen.
Phase 1 — Verifizierter Befund
Ein Scanner wie Deep Code Analysis schlägt zum Beispiel 1.247 Befunde vor. Die Pipeline verwirft den Großteil davon, weil sie eine unabhängige erneute Prüfung nicht bestehen. (Warum Scanner auf Basis von Mustererkennung so viele Fehlalarme erzeugen, erklären wir in Was ist Deep Code Analysis?.)
Die Anforderungen an einen bestätigten Befund sind eindeutig:
- Der vorgeschlagene Befund muss sich vollständig an einem isolierten Ziel reproduzieren lassen.
- Die Reproduktion muss durch einen Agenten erfolgen, der den Befund nicht erstellt hat.
- Das Reproduktionsartefakt (eine curl-Anfrage, ein CI-Job oder ein Container-Snapshot) muss gespeichert werden.
Befunde, die nicht alle drei Anforderungen erfüllen, werden mit Begründungscodes verworfen. Diese Codes sind wichtig, denn mit ihnen lässt sich die Pipeline später debuggen. Am häufigsten sehen wir:
not_reachable(kein realer Pfad führt von einem öffentlichen Endpoint zur Senke)guard_present(eine vorgelagerte Prüfung macht den Befund unwirksam)mitigated_at_runtime(eine WAF-Regel, ein Feature-Flag oder eine Umgebungsvariable neutralisiert ihn)replay_failed(der zweite Agent konnte ihn nicht reproduzieren)
Das Ergebnis von Phase 1 ist eine kleine Menge verifizierter Befunde, jeweils mit angehängtem Reproduktionsartefakt.
Phase 2 — Kontext erhalten
Ein verifizierter Befund allein reicht nicht aus, um einen Fix auszuliefern. In der nächsten Phase wird alles angehängt, was Entwickler zur Prüfung des Patches benötigen:
- Der Graphknoten (Host, Endpoint, Parameter)
- Die Fähigkeitsklasse (Lesen, Schreiben, Identitätsübernahme, RCE, Exfiltration)
- Der Erreichbarkeitspfad (die vollständige Kette von der Anfrage bis zur Senke)
- Anfrage und Antwort (wie der ursprüngliche Exploit aussah)
- Die Reasoning-Spur des Agenten (warum der ursprüngliche Agent den Befund so klassifiziert hat)
Das ist der Audit-Trail. Ohne ihn muss der Engineer, der den Patch prüft, dem System einfach glauben. Mit ihm kann er den ursprünglichen Exploit gegen den ungepatchten Code erneut ausführen und bestätigen, dass er sich reproduzieren lässt. Anschließend kann er ihn gegen den gepatchten Code erneut ausführen und prüfen, ob die erwartete Mitigation greift.
Es geht nicht darum, dem Engineer zusätzliche Arbeit aufzubürden. Die Arbeit soll überprüfbar sein.
Phase 3 — Patch-Entwurf
Plexicus Remediation erhält den verifizierten Befund samt Kontext und erstellt einen reviewbereiten Diff. Das ist kein allgemeiner Fix, sondern die kleinstmögliche Änderung, die den Erreichbarkeitspfad beseitigt und zugleich die ursprüngliche Geschäftslogik erhält.
Die Pipeline setzt drei Eigenschaften durch:
- Der Patch beseitigt die Schwachstellenklasse, nicht nur den Einzelfall. Eine parametrisierte Abfrage wird einem Bereiniger mit
replace()vorgezogen, gemäß dem OWASP-Leitfaden zur Vermeidung von SQL-Injection (siehe auch unsere Anleitung zur Behebung von SQL-Injection). Eine Berechtigungsprüfung im Handler ist einer Allowlist auf Routenebene vorzuziehen. - Der Patch enthält Regressionstests. Der ursprüngliche Exploit wird zum Test. Besteht der Patch den Test, ist der Befund geschlossen. Scheitert er, wird der Patch zurückgenommen.
- Der Patch enthält die aktualisierte Dokumentation. Ändert sich der API-Vertrag, werden die Dokumente angepasst. Kommt eine neue Umgebungsvariable hinzu, wird sie in der README festgehalten.
Das Ergebnis von Phase 3 ist ein Pull-Request-Branch. Kein Code-Snippet und kein „hier ist der Diff“-Vorschlag. Es ist ein vollständiger PR, den ein Engineer auschecken, ausführen und prüfen kann.
Phase 4 — Reviewbereiter PR
Der Patch landet mit folgenden Angaben im bestehenden Repository:
- Reviewer-Zuweisung (aus CODEOWNERS, mit Eskalation an das Security-Team)
- SLA-Nachverfolgung (dem PR wird anhand des Schweregrads automatisch ein Behebungsziel zugewiesen)
- Ein an CI gekoppelter erneuter Test (der ursprüngliche Exploit wird bei jedem Push gegen den gepatchten Branch ausgeführt)
- Angefügte Audit-Metadaten (der ursprüngliche Befund, der Graphknoten, der Reproduktionsverweis)
Der PR wird nicht automatisch gemergt. Die letzte Entscheidung trifft der menschliche Reviewer. Neu ist, dass die Prüfung Minuten statt Stunden dauert. Der Engineer muss keine 200 Zeilen unbekannten Code lesen, sondern einen 12-Zeilen-Diff mit dem ursprünglichen Exploit, dem Graphkontext und dem Ergebnis des Regressionstests.
Stimmt der Engineer zu, wird der PR gemergt, der erneute Test bestätigt den Fix und der Befund wird geschlossen. Lehnt er ihn mit Begründung ab, wird der Patch-Vorschlag als rejected_with_evidence protokolliert. Der Befund bleibt für den nächsten Versuch offen.
Die entscheidenden Zahlen: mittlere Behebungszeit vorher und nachher
Seit dem vierten Quartal 2025 setzen wir das Playbook in Kunden-Repositories ein. Das sind die von uns beobachteten Medianwerte (interne Plexicus-Daten):
| Phase | Vorher | Nachher |
|---|---|---|
| Von der Erkennung bis zum Beginn der Triage | 3 Tage | 14 Sekunden |
| Vom Triagebeginn bis zur Ursachenanalyse | 6 Tage | 8 Sekunden |
| Von der Ursache bis zum eröffneten PR | 4 Tage | 22 Sekunden |
| Vom eröffneten PR bis zum Merge | 2 Tage | 1,2 Stunden |
| Vom Merge bis zur Produktion | 2 Tage | 6 Stunden |
| Gesamt | 17 Tage | 8 Stunden |
Die von uns kommunizierte Kennzahl – unter 60 Sekunden von der Erkennung bis zum reviewbereiten PR – misst Phase 1 bis Phase 3. Bis zur Produktion wird der vollständige Lebenszyklus vor allem durch das menschliche Review und den bestehenden CI/CD-Prozess bestimmt. Genau dort soll er auch bleiben. Die Pipeline soll vermeidbare Verzögerungen beseitigen. Review und Deployment bleiben beim Team.
Die andere wichtige Zahl ist die False-Positive-Rate. Vor Einführung des Playbooks wurden in unseren Deployments 87 % der Scanner-Befunde nach menschlicher Triage als „kein Problem“ geschlossen. Danach sank dieser Wert auf 6 %. In den verbleibenden 6 % ist der Engineer mit der Einschätzung der Belege durch den Verifizierer nicht einverstanden – genau in solchen Fällen ist das menschliche Gate wichtig.
Was die Implementierung kostet
Drei betriebliche Voraussetzungen sind nötig:
- Ein graphbasierter Scanner, der einen Erreichbarkeitspfad erzeugen kann. Kein regexbasiertes SAST und kein LLM-Wrapper. Es braucht einen Graphen.
- Ein Verifizierungsdurchlauf mit überprüfbarer Reproduktion. Ein zweiter Agent muss den Befund unabhängig reproduzieren können. Ohne das erzeugt die Pipeline überzeugende, ausgefeilte, aber unbelegte Patches – das schlimmstmögliche Ergebnis.
- Ein Patch-Generator, der die Geschäftslogik respektiert. Nach unserer Erfahrung waren 2025 Patches, die zwar kompilierten, aber die Bedeutung des Codes veränderten, der häufigste Fehler von „KI-Autofix“-Produkten. Das Playbook verlangt minimale, getestete und reviewbare Patches.
Die Plexicus-Implementierung erfüllt alle drei Anforderungen. Wenn du das selbst entwickelst, schätzen wir den Integrationsaufwand auf etwa einen erfahrenen Engineer für ein Quartal. Beim Kauf ist das Angebot im Continuous-Program-Tarif auf der Preisseite enthalten.
Was dieses System nicht tut
Das Playbook schafft das menschliche Gate nicht ab. Ein Mensch prüft den Patch weiterhin vor dem Merge. Die Nachweise des Verifizierers bleiben für Auditoren sichtbar. Das System deployt nicht eigenständig in die Produktion.
Das ist Absicht. Anbieter von „vollständig autonomer Behebung“ behaupten, Menschen seien der Engpass und das System solle den PR einfach mergen. Das Team von Plexicus AI Swarm Pentest vertritt die Ansicht, dass Menschen für das Ergebnis verantwortlich sind und das System ihre Prüfung einfach, schnell und evidenzbasiert machen sollte.
Wir vertreten die zweite Position. Das Playbook optimiert die Zeit bis zum Fix, ohne menschliche Aufsicht zu entfernen. Das ist umso wichtiger, da KI-Coding-Assistenten die Menge der zu prüfenden Änderungen erhöhen: Unsere Analyse ergab, dass 78 % der KI-generierten PRs eine Schwachstelle enthielten. Für jedes Team, das einem CISO, Auditor oder Regulierer Rechenschaft schuldet, ist das ein Feature, kein Fehler.
Fehlerbilder aus der Praxis
In den ersten sechs Monaten des Playbooks im Produktivbetrieb traten drei Fehlerbilder wiederholt auf:
Fehlerbild 1 — Der Patch behebt das Symptom, nicht die Klasse
In der ersten Version des Patch-Generators wurden gelegentlich Patches erstellt, die zwar den konkreten Befund behoben, aber die zugrunde liegende Schwachstellenklasse nicht entfernten. Wir ergänzten die Patch-Erstellung um einen Reasoning-Schritt auf Klassenebene. Patches enthalten jetzt eine „Klasse entfernt“-Bestätigung, die der Reviewer prüfen kann.
Fehlerbild 2 — Der Reproduktionsverifizierer widerspricht dem Patch
In etwa 3 % der Fälle führt der Verifizierer, der den ursprünglichen Befund bestätigt hat, den gepatchten Code erneut aus – und der Exploit lässt sich weiterhin reproduzieren. Das bedeutet, dass der Patch unvollständig ist. Die Pipeline erkennt dies in CI und nimmt den Patch automatisch zurück. Der Befund bleibt offen.
Fehlerbild 3 — CODEOWNERS ordnet die Datei dem falschen Reviewer zu
Der Patch landete im richtigen Branch, der CI-Nachtest war erfolgreich und der Audit-Trail vollständig. Trotzdem war der Reviewer falsch zugewiesen, weil die Datei zwischen Teams verschoben wurde und CODEOWNERS nicht aktualisiert worden war. Wir ergänzten die Pipeline um eine automatische Prüfung auf Änderungen an CODEOWNERS.
Das sind keine theoretischen Fälle. Diese Probleme traten in den ersten sechs Monaten auf und werden nun automatisch erkannt.
Was dein Team morgen tun kann
Wenn ihr das Playbook noch nicht einsetzt, geht in dieser Reihenfolge vor:
- Prüft euren aktuellen Scanner. Kann er für seine Befunde einen Erreichbarkeitspfad erzeugen oder nur einen CVSS-Wert? Lautet die Antwort „nur einen Score“, wird der Engpass nicht verschwinden.
- Ergänzt eine Reproduktionsprüfung. Für den Anfang reicht ein manueller Ablauf: Ein Mensch führt jede Woche die zehn wichtigsten Befunde in einer Sandbox erneut aus. Damit lässt sich zeigen, dass Befunde, die eine unabhängige Prüfung bestehen, auch die sind, die sich zu beheben lohnen.
- Verknüpft den Patch mit denselben Nachweisen. Wenn der Engineer den PR öffnet, sollten der ursprüngliche Befund, der Graphknoten und der Reproduktionsverweis mit einem Klick erreichbar sein.
Das Playbook erfordert weder KI noch ein Produkt eines Anbieters. Es braucht Struktur, erneute Ausführung und eine eng getaktete Feedbackschleife. Es passt außerdem zu den Praktiken „Respond to Vulnerabilities“ im Secure Software Development Framework (SP 800-218) des NIST, das Teams auffordert, Schwachstellen wiederholbar zu bewerten, zu priorisieren und zu beheben.
Häufig gestellte Fragen
Was ist automatisierte Schwachstellenbehebung?
Automatisierte Schwachstellenbehebung bedeutet, den Fix für einen Sicherheitsbefund automatisch zu erstellen – meist als Pull Request mit einer Codeänderung und einem Regressionstest –, statt einem Entwickler ein Ticket zum manuellen Patchen zuzuweisen. Gute Implementierungen bearbeiten nur verifizierte Befunde, hängen die ursprünglichen Nachweise an und überlassen die Merge-Entscheidung einem menschlichen Reviewer.
Was ist der Unterschied zwischen automatisierter und autonomer Behebung?
Automatisierte Behebung bedeutet meist, dass ein Tool auf Anfrage einen Fix für einen einzelnen Befund vorschlägt. Autonome Behebung führt die gesamte Kette ohne manuelles Anstoßen jedes Schritts aus: Befund verifizieren, Kontext sammeln, Patch erstellen, PR öffnen und in CI erneut testen. In diesem Playbook ist nur die Prüfung und die Merge-Entscheidung menschlich.
Wie lässt sich die mittlere Behebungszeit für Schwachstellen verkürzen?
Beseitige Wartezeiten zwischen den Phasen, statt Entwickler zu schnellerer Arbeit aufzufordern. Verifiziere Befunde automatisch, damit sich die Triage nicht aufstaut; füge Erreichbarkeitspfad und Exploit bei, damit die Ursache bereits bekannt ist; erstelle einen minimalen Patch mit Regressionstest und verbinde einen erneuten CI-Test mit dem PR. In unseren Deployments sank der Median dadurch von 17 Tagen auf etwa 8 Stunden.
Wie lange dauert die Behebung von Anwendungsschwachstellen üblicherweise?
Üblicherweise Wochen oder Monate. Der Vulnerability Statistics Report 2026 von Edgescan beziffert die mittlere Behebungszeit hoher und kritischer Schwachstellen in Anwendungen und APIs auf 54,81 Tage. Veracode berichtet, dass die durchschnittliche Zeit zum Beheben von Sicherheitslücken seit 2020 um 47 % gestiegen ist. Erfahrene Teams mit automatisierter Behebung liegen deutlich unter diesen Durchschnittswerten.
Sollten KI-generierte Sicherheitsfixes automatisch gemergt werden?
Davon raten wir ab. Ein KI-generierter Patch kann kompilieren und Tests bestehen und dabei trotzdem die Bedeutung des Codes verändern. Deshalb sollte ein menschlicher Reviewer jeden Merge genehmigen. Automatisierung soll diese Prüfung beschleunigen: ein kleiner Diff mit dem ursprünglichen Exploit, dem Erreichbarkeitspfad und einem erfolgreichen Regressionstest am Pull Request.
Wie es weitergeht
Das Playbook für autonome Behebung ist der dritte Teil des Plexicus-Kreislaufs. Deep Code Analysis findet die Schwachstellen. AI Swarm Pentest reproduziert sie. Remediation behebt sie. Die Vier-Schritte-Struktur – vorschlagen, erneut ausführen, beheben, verifizieren – ist die operative Definition von evidenzbasierter AppSec und ihrem Prozess zur Schwachstellenbehebung.
2027 wird das Playbook Standard sein. Teams, die es 2026 einführen, schließen die Lücke von 17 Tagen, bevor Angreifer sie weiter verkleinern.
Weiterführende Artikel:
- Vom Alert zum Fix: Den Kreislauf mit evidenzbasierter AppSec schließen — der vollständige Kreislauf
- 78 % der KI-generierten PRs enthalten eine Schwachstelle — was dein Team heute produziert
- Die 15 besten KI-Pentest-Tools — Optionen für den Schritt der Reproduktionsprüfung

