Von der Warnung zur Korrektur: Ein Prozess zur Schwachstellenbehebung mit Proof-Driven AppSec
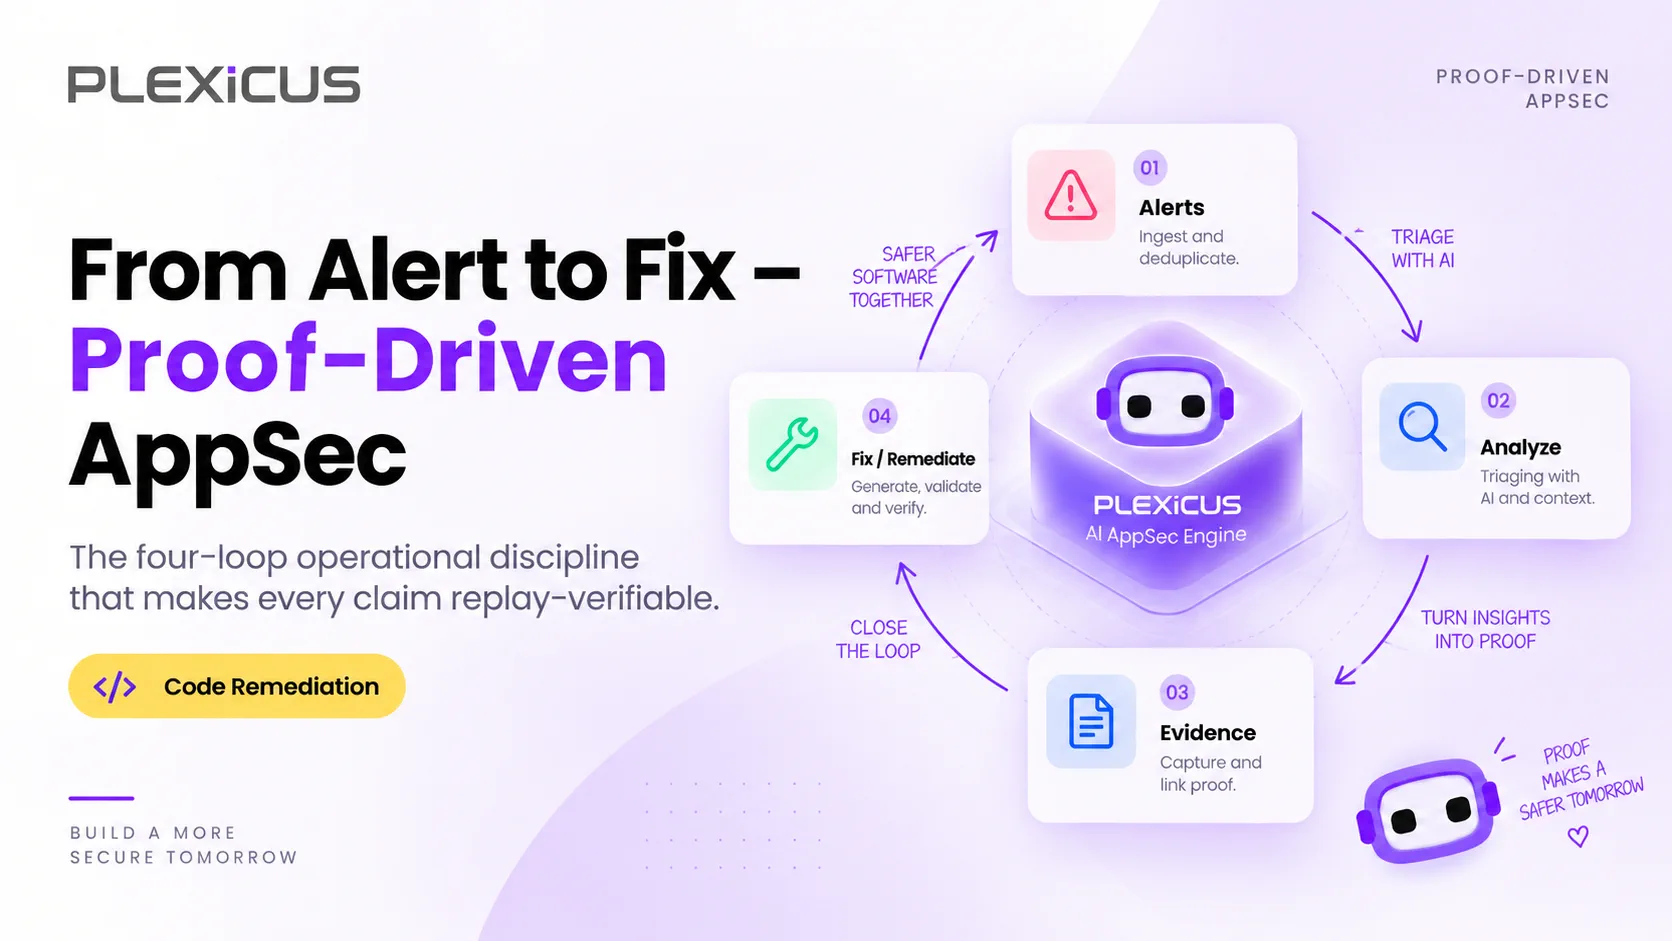
Proof-Driven AppSec ist ein Prozess zur Schwachstellenbehebung, der die Schleife von der Warnung bis zum Fix einmal schließt, mit reproduzierbarer Evidenz: erkennen, verifizieren, beheben, auditieren.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenEin Prozess zur Schwachstellenbehebung ist die Abfolge von Schritten, die einen Sicherheitsbefund von der Erkennung bis zu einer verifizierten, ausgerollten Korrektur bringt: erkennen, verifizieren, beheben und auditieren. Proof-Driven AppSec ist unsere Version dieses Prozesses, mit einer Regel: Jeder Schritt muss Evidenz erzeugen, die ein Entwickler, ein Auditor oder ein CI-Gate erneut ausführen kann.
Die meisten AppSec-Programme sehen gleich aus. Ein Scanner findet eine Schwachstelle. Der Befund landet in einer Warteschlange. Ein Mensch triagiert ihn, irgendwann. Ein Ticket wird geöffnet. Ein Entwickler nimmt sich des Tickets an — wenn er dazu kommt. Der Entwickler öffnet einen PR. Der PR bleibt in der Review. Das Review dauert eine Woche, weil der Diff groß ist und der Entwickler der Einzige ist, der die Datei versteht. Der PR wird gemergt. Das CI-Gate geht durch. Der Befund wird geschlossen.
Währenddessen werden Angreifer schneller und billiger. Der Forschungsagent RapidPen erlangte Shell-Zugriff auf ein verwundbares Ziel in 200–400 Sekunden für deutlich unter einem Dollar pro Durchlauf. Auf Verteidigerseite beziffert Edgescans Vulnerability Statistics Report 2026 die mittlere Behebungszeit (MTTR) für hoch- und kritisch eingestufte Anwendungs- und API-Schwachstellen auf 54,81 Tage. Eine Behebungszeit von mehreren Wochen ist keine Sicherheitsmetrik. Es ist eine Marketingfolie für die Angreifer.
Proof-Driven AppSec ist die operative Disziplin, die die Schleife einmal schließt, jeden Schritt beweisbar macht und den Median für die Behebung von Wochen auf Tage senkt. Dies ist die kanonische Definition.
Was Proof-Driven AppSec ist
Proof-Driven AppSec ist die Disziplin, Anwendungs-Sicherheitsprogramme so zu führen, dass jede Aussage auf Evidenz beruht, die ein Auditor, ein Entwickler oder ein CI-Gate erneut ausführen kann. Keine CVSS-Werte. Keine Schweregrad-Tags. Kein “hoch/mittel/niedrig”. Ein reproduzierbares Artefakt, das dem Befund beiliegt.
Drei Eigenschaften definieren die Praxis:
- Jeder Befund hat einen Pfad. Kein Regex-Treffer. Kein Pattern-Match. Ein Erreichbarkeitspfad von einer echten Eingabequelle zu einer echten fähigkeitsbehafteten Senke, gebunden an eine konkrete Datei und Zeilennummer.
- Jeder Befund hat Evidenz. Eine Anfrage, die erneut ausgeführt werden kann, ein CI-Job, der reproduziert werden kann, ein Sandbox-Zustand, der fortgesetzt werden kann. Wenn ein Befund nicht reproduzierbar ist, ist er kein Befund — er ist eine Hypothese.
- Jeder Fix hat eine Evidenzkette. Der Patch kommt aus demselben Befund. Der Patch schließt den ursprünglichen Exploit. Der Patch wurde mit der ursprünglichen Evidenz im Anhang reviewt. Der Regressionstest des Patches ist der ursprüngliche Exploit, invertiert.
Das ist die Praxis. Alles, was nicht alle drei Eigenschaften erfüllt, ist ein Screenshot eines AppSec-Programms, kein AppSec-Programm.
Der Prozess zur Schwachstellenbehebung in vier Schleifen
Das operative Muster hat vier Schleifen. Jede Schleife hat eine Aufgabe. Jede Übergabe bewahrt die Evidenz.
Schleife 1 — Erkennen
Der erste Durchlauf scannt die Codebasis (und das IaC, das die Runtime definiert) und erzeugt einen Graphen aus Hosts, Endpunkten, Parametern und Fähigkeiten. Befunde sind Positionen im Graphen, keine Zeilen in einer Datei.
Das macht Deep Code Analysis (die Hintergründe erklärt Was ist Deep Code Analysis?). Das Ergebnis ist eine Reihe vorgeschlagener Befunde — jeder gebunden an einen Graphknoten, einen Erreichbarkeitspfad, eine Fähigkeitsklasse und eine Zeilennummer.
Schleife 2 — Verifizieren
Der zweite Durchlauf nimmt jeden vorgeschlagenen Befund und versucht, ihn zu reproduzieren. Der Agent, der diesen Durchlauf ausführt, ist nicht der Agent, der den Befund vorgeschlagen hat. Das ist der entscheidende Schritt. Selbstkonsistenz ist keine Verifizierung.
Das Ergebnis von Schleife 2 ist eine kleinere Menge verifizierter Befunde, jeder mit der Evidenz im Anhang. Befunde, die sich nicht reproduzieren lassen, werden mit einem dokumentierten Grund verworfen. Die Grundcodes sind wichtig — so debuggt Ihr Team die Pipeline später. Häufige Gründe: kein realer Pfad von einem öffentlichen Endpunkt zur Senke, eine vorgelagerte Prüfung macht den Befund inert, eine Runtime-Kontrolle neutralisiert ihn, oder der zweite Agent konnte das Ergebnis nicht reproduzieren.
Schleife 3 — Korrigieren
Der dritte Durchlauf nimmt jeden verifizierten Befund und erstellt einen review-fähigen Patch. Der Patch ist keine generische Korrektur. Es ist die minimale Änderung, die den Erreichbarkeitspfad entfernt und die Geschäftslogik erhält. Der Patch enthält Regressionstests (der ursprüngliche Exploit wird zum Test). Der Patch enthält Dokumentationsaktualisierungen.
Das macht ein strukturierter Workflow zur Behebung von Sicherheitslücken wie Plexicus Remediation. Das Ergebnis ist ein Pull Request, kein Code-Snippet. Wie dieser Schritt ohne manuelle Übergaben durchläuft, zeigt das autonome Remediation-Playbook (auf Englisch).
Schleife 4 — Auditieren
Der vierte Durchlauf stellt sicher, dass der Patch den ursprünglichen Befund schließt. Der Verifizierer führt den ursprünglichen Exploit erneut gegen den gepatchten Branch aus. Wenn sich der Exploit reproduziert, wird der Patch zurückgerollt. Wenn der Exploit mitigiert ist, wird der Patch signiert und der Befund geschlossen.
Das Ergebnis von Schleife 4 ist ein Audit-Datensatz: ursprünglicher Befund, Graphknoten, Evidenzreferenz, Patch-Diff, Regressionstest-Ergebnis, Reviewer-Genehmigung, Deployment-Zeitstempel. Ein Datensatz pro Befund. Signiert. Reproduzierbar.
Warum das nicht “AI-native AppSec” mit besserem Marketing ist
Der Begriff “AI-native AppSec” war nützlich, als er bedeutete: “die Scanner nutzen Machine-Learning-Modelle”. Heute nutzt jeder Scanner Machine-Learning-Modelle. Der Differentiator ist nicht, ob KI beteiligt ist. Es ist, ob die KI fundiert ist.
Drei Fehlermodi der AI-native-Ära:
- KI, die Befunde ohne Fundierung zusammenfasst. Das Modell liest die SAST-Ausgabe und erzeugt ein besser lesbares PDF. Der Auditor kann nichts erneut ausführen.
- KI, die Korrekturen ohne Verifizierung vorschlägt. Das Modell schreibt einen Patch. Der Patch kompiliert. Der Patch verändert die Bedeutung des Codes. Ein menschlicher Reviewer soll das erkennen. Sie können es nicht, in großem Maßstab – erst recht nicht, wenn laut unserer Analyse 78 % der KI-generierten PRs eine Schwachstelle enthielten (auf Englisch).
- KI, die ohne Evidenz läuft. Das Modell erkundet die Anwendung. Es findet etwas Interessantes. Es meldet es als Befund. Der Bericht ist nicht reproduzierbar.
Proof-Driven AppSec ist die Antwort auf alle drei. Die Struktur ist der Maßstab:
- Erkennung muss einen Pfad liefern, nicht ein Pattern.
- Verifizierung muss unabhängig sein, nicht selbstkonsistent.
- Korrektur muss auf derselben Evidenz basieren, nicht auf einem generischen Vorschlag.
- Audit muss reproduzierbar sein, nicht narrativ.
Alles, das nicht alle vier erfüllt, ist dasselbe AppSec-Programm mit anderem Logo.
Schwachstellenbehebung in der Praxis
Über die Plexicus-Kundenbasis hinweg, die das vollständige Vier-Schleifen-Muster umsetzt, hat der praktische Effekt dieselbe Form: Triage-Zeit komprimiert sich von Tagen auf Minuten, False Positives sinken nach der Verifizierung, und die Zeit bis zum Merge sinkt, weil der Reviewer einen kleinen, evidenzgestützten Diff liest, statt eine unverifizierte Liste.
Zwei Zahlen definieren, ob die Praxis funktioniert: Wie oft kann der Auditor die Evidenz erneut ausführen und den Befund bestätigen, und wie oft akzeptiert der Auditor, dass der Patch das behebt, was der Befund behauptet hat. Alles andere ist Durchsatz.
Die exakten Mediane variieren je nach Codebasis, Sprachmix und CI-Reife. Das Muster ist es, das skaliert.
Was die Bedrohungslandschaft fordert
Die Bedrohungslandschaft 2026 ist strukturell schneller als der Verteidiger-Zyklus:
- Die Time-to-Exploit sinkt weiter. Mandiant maß eine durchschnittliche Time-to-Exploit von fünf Tagen im Jahr 2023, nach 63 Tagen in 2018–2019.
- Die meisten Angriffe beginnen, bevor es einen Fix gibt: 70 % der Schwachstellen in diesem Mandiant-Datensatz wurden als Zero-Days ausgenutzt.
- Offensive KI-Agenten sind billig im Betrieb. RapidPen meldete Shell-Zugriff in 200–400 Sekunden für etwa 0,30–0,60 US-Dollar pro Durchlauf.
- KI senkt die Einstiegshürde. Amazon Threat Intelligence dokumentierte einen einzelnen, technisch wenig versierten Akteur, der mit kommerzieller generativer KI in rund fünf Wochen mehr als 600 FortiGate-Geräte in 55 Ländern kompromittierte.
Die Angreifer-Pipeline ist bereits proof-driven. Sie verifizieren ihre Exploits, bevor sie sie versenden. Sie spielen ihre Payloads erneut ab. Sie auditieren ihre Ergebnisse. Die Asymmetrie ist nicht “Angreifer nutzen KI und Verteidiger nicht”. Die Asymmetrie ist “Angreifer nutzen eine geschlossene Schleife und Verteidiger eine Reihe offener Warteschlangen”.
Proof-Driven AppSec ist das operative Muster, das die Schleife des Verteidigers schließt.
Einen Workflow zur Behebung von Sicherheitslücken mit vorhandenen Werkzeugen aufbauen
Die Vier-Schleifen-Struktur ist nichts Anbieterspezifisches. Das Muster kann mit den Werkzeugen umgesetzt werden, die Ihr Team bereits hat:
- Schleife 1 (Erkennen) — statische Analyse, die Erreichbarkeitspfade erzeugt. Plexicus Deep Code Analysis oder jeder Scanner, der Befunde an den Call-Graph bindet statt an die Zeilennummer.
- Schleife 2 (Verifizieren) — ein Pentest-Engagement mit unterzeichnetem Scope. Plexicus AI Swarm Pentest oder ein manuelles Pentest-Engagement mit Evidenzerfassung (siehe unseren Vergleich der KI-Pentest-Tools).
- Schleife 3 (Korrigieren) — ein Patch-Generator mit Regressionstests. Jeder KI-Coding-Workflow mit expliziten Anweisungen, Patches im ursprünglichen Befund zu fundieren.
- Schleife 4 (Auditieren) — ein CI-Re-Test-Hook, der den ursprünglichen Exploit gegen den gepatchten Branch ausführt. Genau diese Evidenz erwartet auch das Secure Software Development Framework (SP 800-218) des NIST in seinen Praktiken zu „Respond to Vulnerabilities“.
Die vier Schleifen müssen miteinander verdrahtet sein. Die Evidenz aus Schleife 2 muss in Schleife 3 landen. Der Patch aus Schleife 3 muss von Schleife 2 re-verifiziert werden. Der Audit-Datensatz aus Schleife 4 muss die Evidenzreferenzen aus den Schleifen 1, 2 und 3 enthalten.
Wenn eine dieser Übergaben die Evidenz verliert, ist die Schleife gebrochen. Die Praxis ist nicht mehr proof-driven.
Der Maßstab für 2026
Drei Fragen an Ihr Sicherheitsprogramm:
- Kann Ihr Scanner für jeden Befund einen Erreichbarkeitspfad erzeugen? Wenn die Antwort “nein, nur eine Zeilennummer” lautet, wird Ihre Triage-Warteschlange weiter wachsen.
- Kann Ihr Pentester den Befund gegen einen sauberen Build erneut ausführen? Wenn die Antwort “wir müssten ein neues Engagement aufsetzen” lautet, ist Ihr Evidenzpfad nicht reproduzierbar.
- Kann Ihr Entwickler den PR mit dem ursprünglichen Exploit im Anhang öffnen? Wenn die Antwort “er müsste das Sicherheitsteam bitten, es erneut zu finden” lautet, ist Ihr Audit-Pfad nicht durchgehend.
Wenn alle drei Antworten “ja” lauten, betreiben Sie Proof-Driven AppSec. Wenn eine “nein” oder “so halb” lautet, liegt die Lücke in der Evidenzübergabe, nicht in den Werkzeugen.
Häufig gestellte Fragen
Was ist der Prozess zur Schwachstellenbehebung?
Der Prozess zur Schwachstellenbehebung umfasst alle Schritte, die einen Sicherheitsbefund von der Erkennung bis zu einer verifizierten Korrektur in Produktion bringen. In Proof-Driven AppSec besteht er aus vier Schleifen: die Schwachstelle mit Erreichbarkeitspfad erkennen, sie unabhängig verifizieren, sie mit einem minimalen Patch und Regressionstest beheben und das Ergebnis auditieren, indem der ursprüngliche Exploit gegen den gepatchten Code erneut ausgeführt wird.
Was ist der Unterschied zwischen Behebung und Mitigation einer Schwachstelle?
Die Behebung (Remediation) entfernt die Schwachstelle selbst, meist durch eine Codeänderung, ein Abhängigkeits-Update oder eine korrigierte Konfiguration. Eine Mitigation senkt das Risiko, ohne die Schwachstelle zu entfernen, etwa per WAF-Regel, Feature-Flag oder Netzwerkisolation. Mitigation verschafft Zeit, Behebung schließt den Befund. Ein guter Prozess dokumentiert, was angewendet wurde, und testet beides erneut.
Was ist Proof-Driven AppSec?
Proof-Driven AppSec ist eine Art, Anwendungssicherheit zu betreiben, bei der jede Aussage durch Evidenz gestützt wird, die jemand anderes erneut ausführen kann. Befunde brauchen einen Erreichbarkeitspfad und einen reproduzierbaren Exploit, Korrekturen einen Regressionstest aus diesem Exploit, und der Audit-Datensatz verknüpft beides. Ein nicht reproduzierbarer Befund gilt als Hypothese, nicht als Befund.
Wie prüft man, ob eine Behebung von Sicherheitslücken funktioniert hat?
Führen Sie den ursprünglichen Exploit erneut gegen den gepatchten Build aus. Wenn der Exploit nicht mehr funktioniert und der daraus abgeleitete Regressionstest im CI besteht, ist die Korrektur verifiziert. Reproduziert er sich weiterhin, ist der Patch unvollständig und sollte zurückgerollt werden. Exploit, Patch-Diff und Testergebnis gehören in einen gemeinsamen Audit-Datensatz.
Wie sollten Teams Schwachstellen für die Behebung priorisieren?
Priorisieren Sie verifizierte Befunde, die von einer echten Eingabe aus erreichbar sind, vor reinen Schweregrad-Werten. Eine mittelschwere Schwachstelle mit bestätigtem Pfad von einem öffentlichen Endpunkt ist meist dringender als eine kritische, die nicht erreichbar ist. Erreichbarkeit, Exploit-Evidenz und die Fähigkeit, die ein Angreifer gewinnen würde, sind bessere Signale als CVSS allein.
Wohin das führt
In den nächsten zwei Jahren wird jeder Regulator dieselbe Frage stellen: Können Sie die Evidenz erneut ausführen, die bewiesen hat, dass diese Kontrolle zum Zeitpunkt des Vorfalls funktionierte? Teams, die Proof-Driven AppSec betreiben, werden mit “ja” antworten und das Originalartefakt vorlegen. Teams mit dem alten Muster werden antworten: “wir haben ein PDF”.
Die Investition, um die Lücke zu schließen, ist nicht groß. Die Disziplin, sie geschlossen zu halten, ist es.
Weiterführende Lektüre:
- Was ist Deep Code Analysis? — Schleife 1
- 78% der KI-generierten PRs enthalten eine Schwachstelle — warum Verifizierung der neue Engpass ist
- Das autonome Remediation-Playbook — Schleife 3 im Detail
- OWASP MAESTRO Field Guide für Threat Modeller — die Referenzarchitektur für die Agenten, die die Schleifen ausführen

