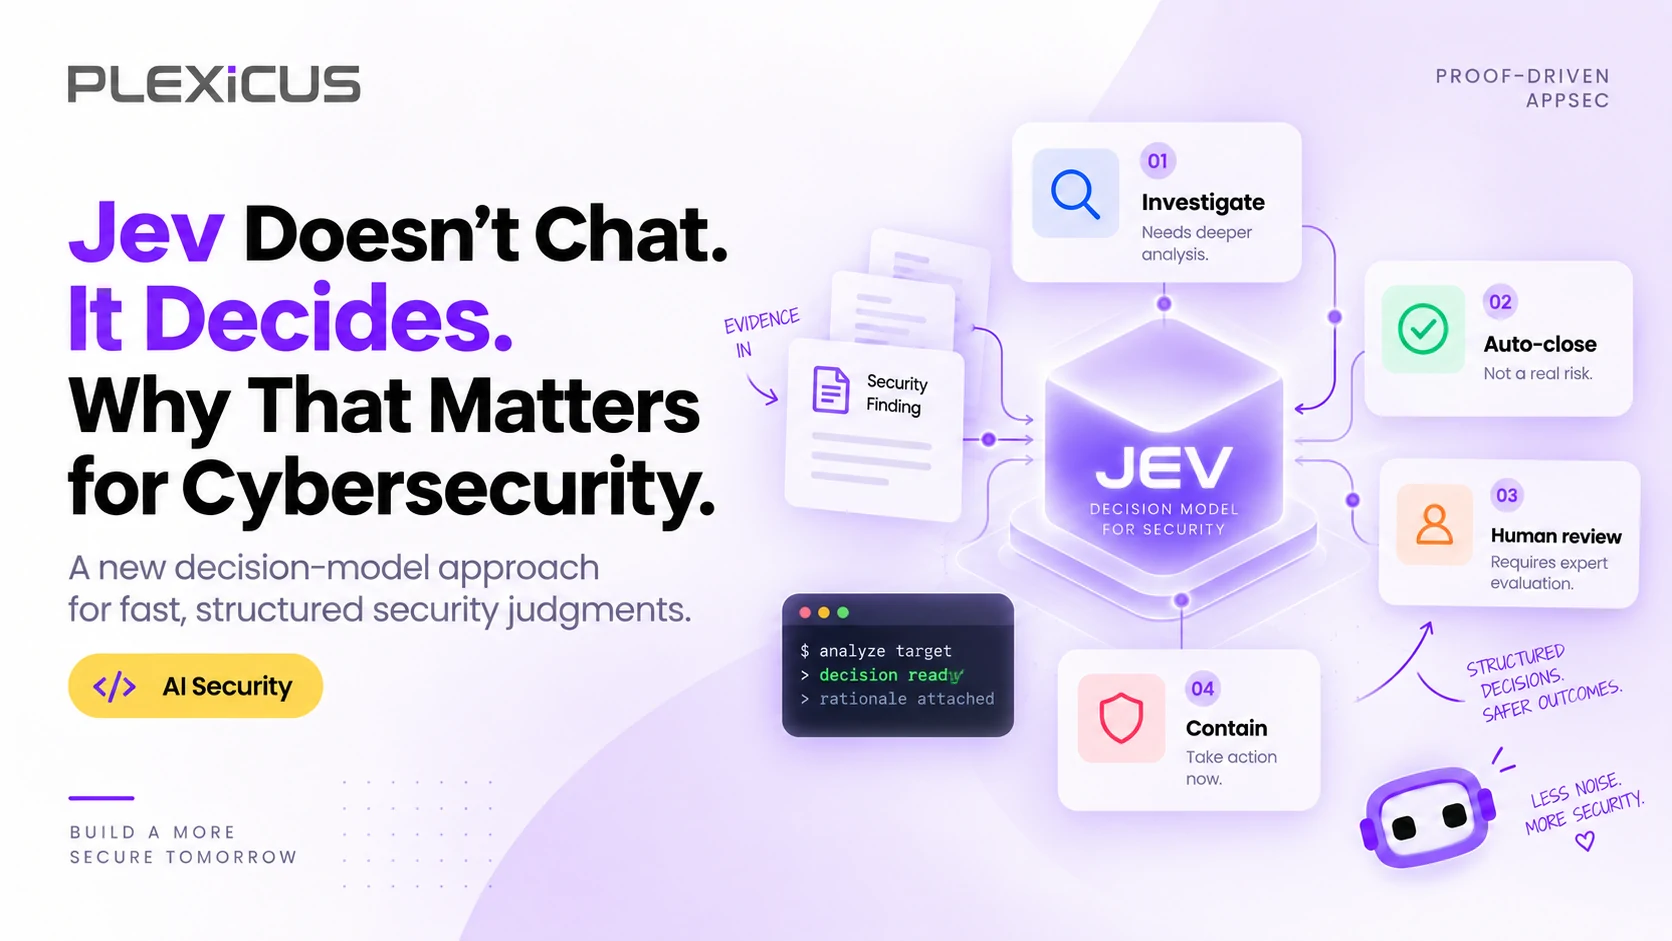
Jev AI chattet nicht. Es entscheidet. Warum das für Cybersicherheit zählt
Jev liefert typisierte Entscheidungen statt Prosa. Das kann verändern, wo semantisches Urteilsvermögen in Sicherheitsabläufe gehört – mit Richtlinien, Fallbacks, Verifikation und menschlicher Prüfung.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenJev AI ist ein Entscheidungsmodell von TypeSafe AI, das typisierte Auswahlwerte, Scores und Wahrscheinlichkeiten statt generiertem Text zurückgibt. Für KI in der Cybersicherheit ist das relevant, weil Sicherheitssysteme Millionen kleiner, zeitkritischer Urteile fällen – und ein Modell, das in deutlich unter einer Sekunde und für Bruchteile eines Cents entscheidet, semantischen Kontext dorthin bringen könnte, wo große LLMs zu langsam oder zu teuer sind.
Seit Jahren lautet die zentrale KI-Frage: Welches Modell erzeugt die beste Antwort? TypeSafe AI stellt eine andere: Was, wenn Software keine Antwort, sondern eine Entscheidung braucht?
Am 15. September 2026 stellte TypeSafe Jev vor. Das Modell nimmt Kontext und vordefinierte Fragen entgegen und gibt typisierte Auswahlwerte, Scores oder Wahrscheinlichkeiten zurück. Für die Sicherheit kann das bedeutsam sein: Systeme müssen fortlaufend beurteilen, ob ein Login verdächtig ist, ein Prozess beendet werden soll oder eine Agentenaktion die Berechtigung überschreitet.
Vom Sprachgenerieren zum Entscheiden
Ein LLM kann eine verdächtige Warnung begründen. Software benötigt oft nur:
risiko = kritisch
aktion = eindämmen
konfidenz = 0,97
Jev überspringt die Prosa. Die Anwendung definiert mögliche Ausgaben, das Modell liefert Wahrscheinlichkeiten. TypeSafe beschreibt dies als unstrukturierten Zustand hinein, typisierte probabilistische Entscheidungen heraus. Die Vercel-AI-Gateway-Integration nennt Choice-, Score- und Boolean-Entscheidungen, die parallel ausgewertet werden.
Ein Sicherheits-Workflow als Testfall
Die TypeSafe-Evaluierung Security Incidents berücksichtigt Warnung, Asset, Eigentümer, Tickets, Geräte, Wartung und Berechtigungen. Zuerst bewertet sie unberechtigte Aktivität, erklärende Aufzeichnungen und Evidenzstärke. Bei möglicher Eindämmung folgen Fragen zu Zugangsdaten, Sitzungen, E-Mail, Persistenz, Prozessen, Netzwerk und Ausbreitung. Mögliche Maßnahmen sind Benachrichtigung, Eskalation, Prozessbeendigung und Kontosperre.
Das ähnelt SIEM-, SOAR- und Triage-Abläufen. Bei einem verwalteten Gerät, einer genehmigten Reise und einer VPN-Änderung reichen starre Schwellenwerte oft nicht. Ein Entscheidungsmodell könnte Wahrscheinlichkeiten für unberechtigte Aktivität, zulässige Erklärung, Kompromittierung und nötige Eindämmung liefern. Das Modell schätzt; die Sicherheitsrichtlinie setzt durch.
Frühe externe Evidenz
TypeSafe nennt 70–500 ms und 0,042 USD pro Million Eingabetokens sowie sehr große Workflow-Vorteile. Das sind Herstellerangaben. TypeSafe weist selbst darauf hin, dass die größten Gewinne das obere Ende realer Ergebnisse darstellen und eigene Spezialisten die Workflows erstellten.
Die Nexus-Agent-Auswertung berichtet von 19.118 realen Momenten und 36.218 Jev-Aufrufen. In 469 Guardrail-Fällen entschied Jev 58% der Fälle und kam mit Regel-Fallback auf 90 Gesamtfehler; Regeln hatten 148, Haiku 99 und Sonnet 92.
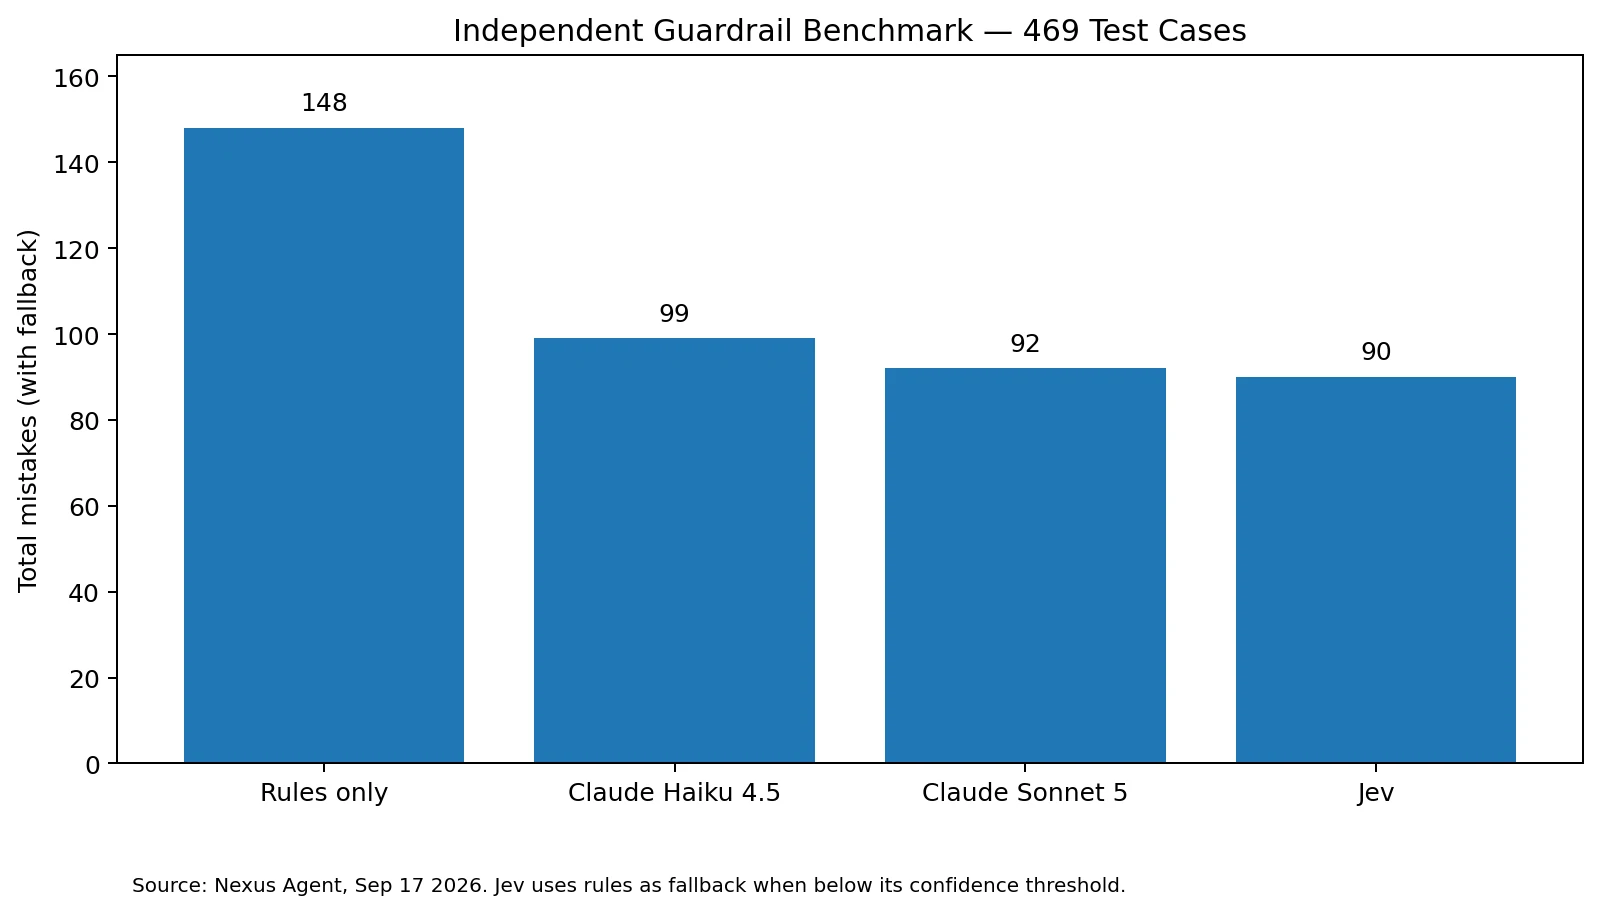
Abbildung 1. Gesamtfehler mit Fallback. Quelle: Nexus Agent, 17. September 2026.
Entscheidend ist die Abdeckung: 1,8% Fehler bei eigenen Entscheidungen bedeutet keine universelle Genauigkeit. Das sinnvolle Muster lautet: nur bei ausreichender Sicherheit entscheiden und Unklares an Regeln, ein stärkeres Modell oder Menschen weitergeben. Diese Routing-Frage vertiefen wir in KI in der Anwendungssicherheit: Automatisierung vs. Unterstützung.
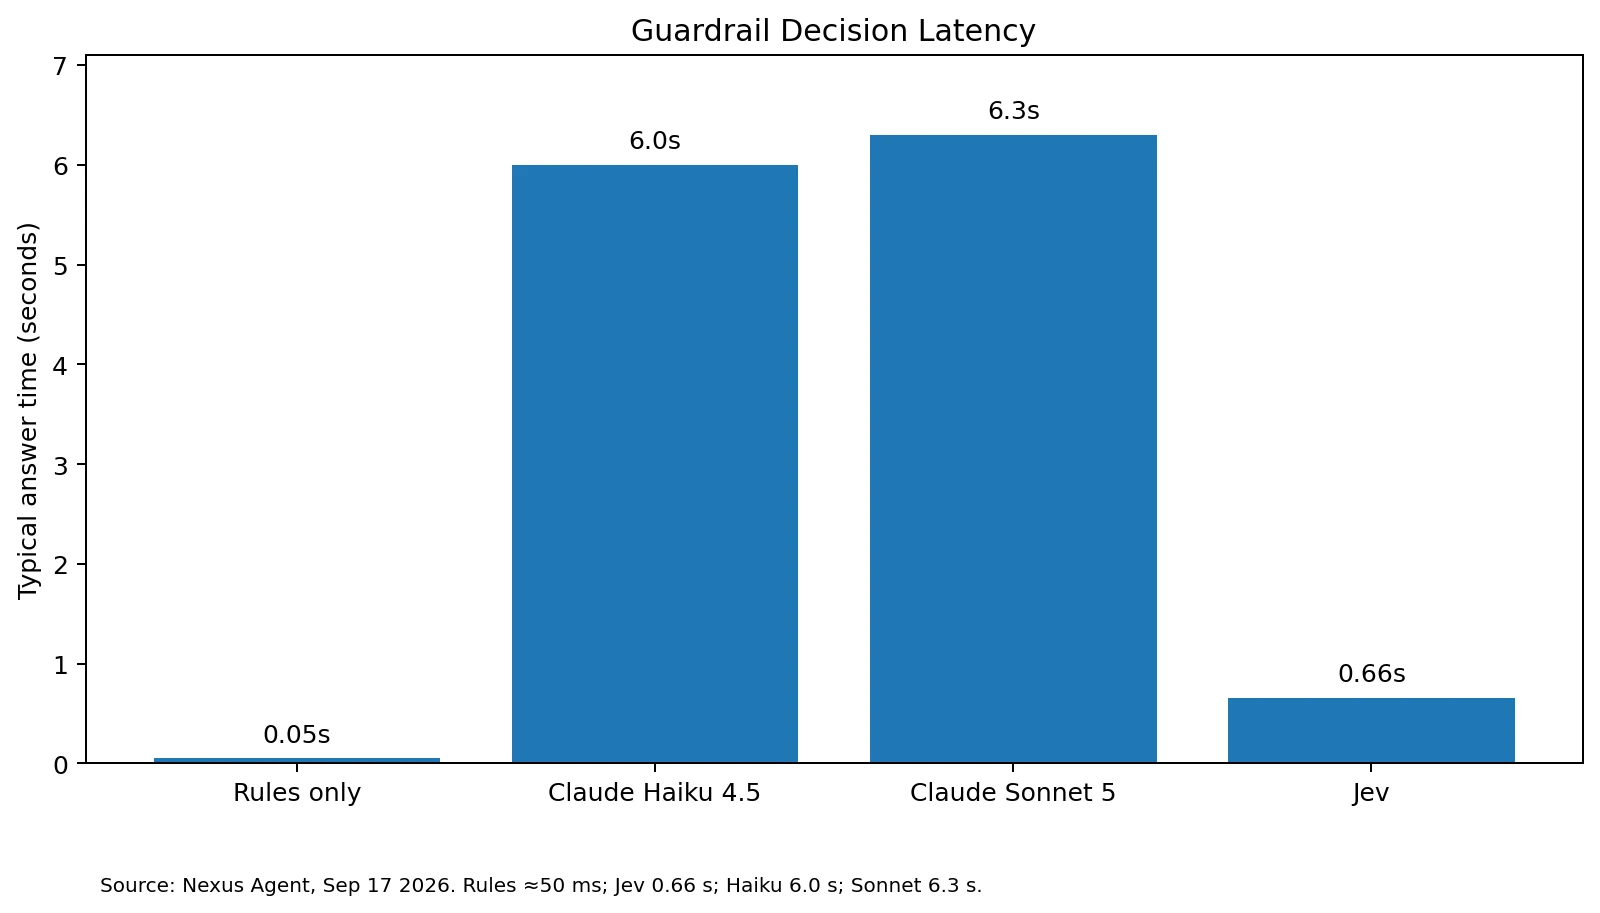
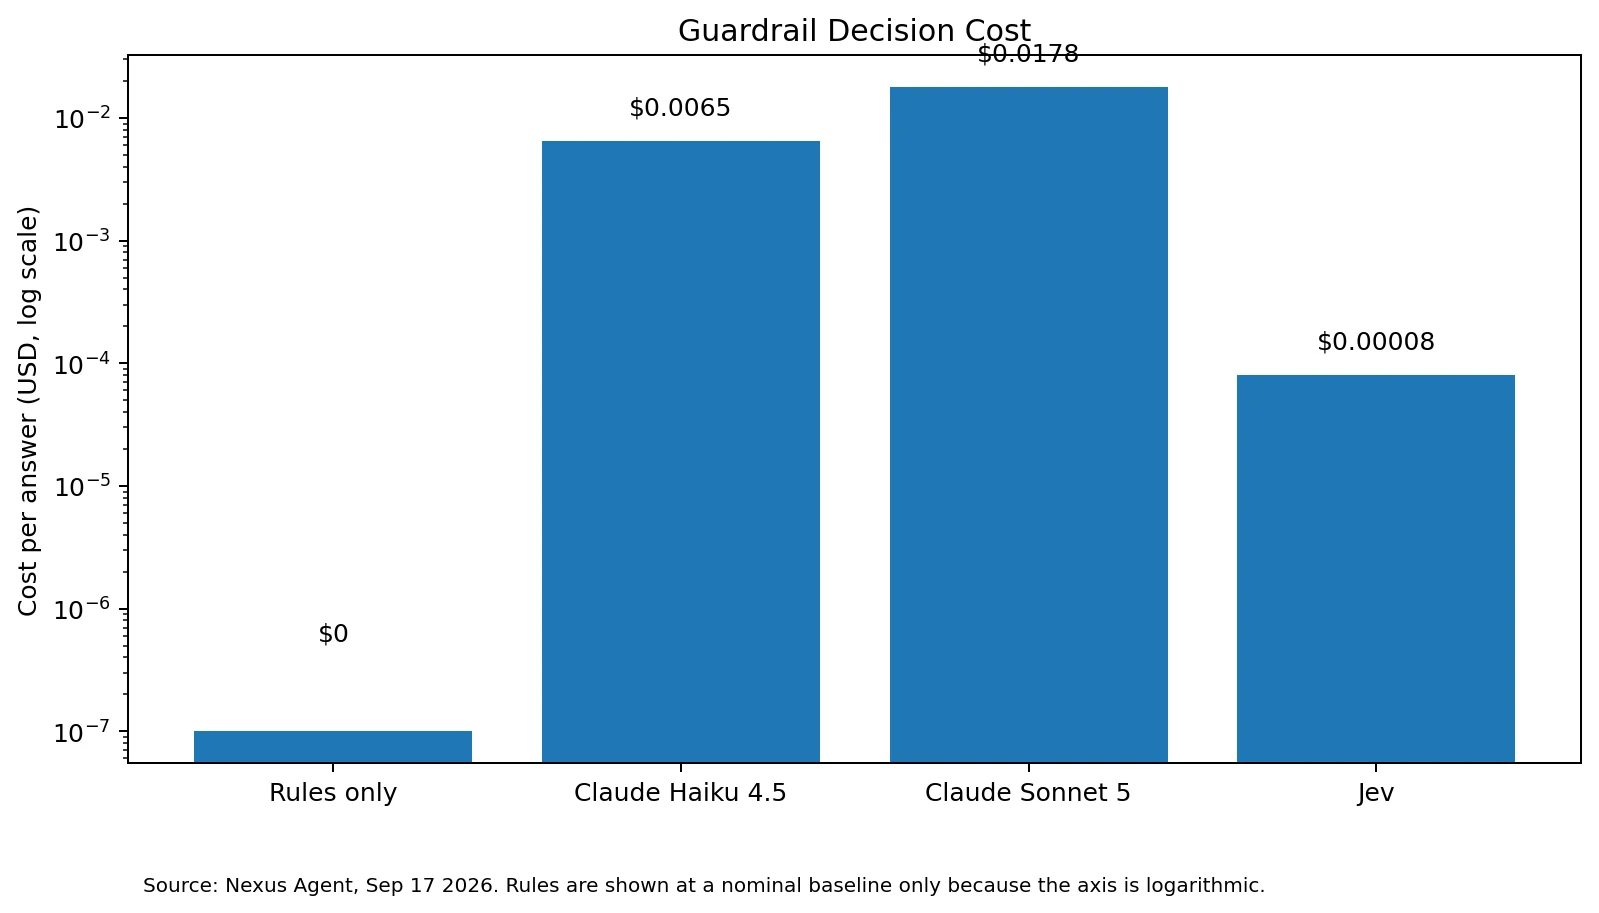
Nexus berichtet in diesem Szenario eine Medianlatenz von 0,68 Sekunden und 0,00008 USD je Jev-Entscheidung.
Wo Jev AI für KI in der Cybersicherheit relevant sein könnte
In einem SOC könnte ein Entscheidungsmodell Signale früher in harmlos, unklar und hochriskant einordnen. Es ersetzt keine Analysten, sondern reserviert teures Reasoning und menschliche Aufmerksamkeit für die Fälle mit echtem Mehrwert.
Es kann außerdem eine Guardrail-Schicht für KI-Agenten bilden. Vor einer irreversiblen Aktion kann es Destruktivität, Umkehrbarkeit, Autorisierung und notwendige menschliche Freigabe bewerten. Die Richtlinie kann eine Aktion blockieren, selbst wenn das primäre Reasoning-Modell sie ausführen möchte. Das entspricht direkt dem Risiko Excessive Agency (LLM06) der OWASP Top 10 for LLM Applications. Das Muster passt auch zu semantischem DLP, Phishing, IAM, Betrug und Schwachstellenpriorisierung.
Typsicher ist nicht korrekt
Dass Jev laut TypeSafe keine Ausgabe außerhalb des Schemas erzeugt, ist wertvoll, beweist aber nicht die inhaltliche Richtigkeit. Das Modell kann ALLOW liefern, wenn BLOCK richtig wäre. Sicherheitsverantwortliche sollten solche Modelle als probabilistische Sensoren, nicht als unfehlbare Richtlinien-Engines behandeln.
Entscheidung + Konfidenz → Sicherheitsrichtlinie
hohe Konfidenz + geringe Auswirkung → automatisieren
Unsicherheit → untersuchen
hohe Auswirkung oder Irreversibilität → stärkere Kontrollen und Freigabe
Der Schaden einer Fehlentscheidung muss die Schwelle bestimmen: Spam zu löschen und eine Produktionsdatenbank zu löschen dürfen niemals dieselbe Schwelle haben.
Die richtige Frage
Jev ersetzt weder tiefes Reasoning noch Forschung oder menschliches Urteil. Diese Arbeit bleibt bei Reasoning-starken Systemen – Frontier-Modellen wie Claude Opus 5.5 oder Multi-Agenten-Werkzeugen wie einem AI Swarm Pentest. Es ist eine mögliche spezialisierte Schicht zwischen Erkennung, Reasoning, Verifikation, Richtlinie und Aktion.
Für einen endgültigen Durchbruch ist es zu früh: die stärksten Kennzahlen bleiben Herstellerwerte, und Nexus testete eine konkrete Agentenumgebung. Relevant ist dennoch die Frage: Welche Sicherheitsentscheidungen sind heute zu häufig, zu schnell oder zu günstig für KI – und was verändert sich, wenn diese Grenze fällt?
Redaktionelle Bewertung: Sicherheitskritische Implementierungen brauchen weiterhin deterministische Autorisierungsgrenzen, unabhängige Verifikation, Fallbacks und menschliche Prüfung bei folgenreichen Aktionen. Warum der Nachweis entscheidend ist, zeigen wir in vom Alert zum Fix mit Proof-Driven AppSec.
Häufig gestellte Fragen
Was ist Jev AI?
Jev ist ein Entscheidungsmodell, das TypeSafe AI im September 2026 als erstes sogenanntes System One Model vorgestellt hat. Statt Text zu generieren, erhält es Kontext und vordefinierte Fragen und gibt typisierte Choice-, Score- oder Boolean-Antworten mit Wahrscheinlichkeiten zurück, die Software direkt verarbeiten kann. TypeSafe nennt Antwortzeiten von 70–500 ms.
Wie unterscheidet sich Jev AI von einem LLM wie GPT oder Claude?
Ein klassisches LLM erzeugt Prosa Token für Token, die Software anschließend parsen muss. Jev wertet vordefinierte Fragen parallel aus und liefert nur die erlaubten Antworttypen, sodass keine fehlerhaft formatierte Ausgabe entsteht. Es tauscht offenes Reasoning und Textgenerierung gegen Geschwindigkeit, niedrige Kosten und strukturierte Entscheidungen – als Ergänzung, nicht als Ersatz für Reasoning-Modelle.
Kann Jev AI für Cybersicherheit eingesetzt werden?
Möglicherweise. TypeSafe hat eine Workflow-Evaluierung für Sicherheitsvorfälle veröffentlicht, und Nexus Agent hat Jev früh als Guardrail für KI-Agenten getestet. Denkbar sind SOC-Triage, Prüfungen von Agentenaktionen, semantisches DLP, Phishing-Analyse und Schwachstellenpriorisierung. Die Evidenz ist noch jung, daher sollten Sicherheitsteams das Modell mit eigenen Daten validieren.
Bedeutet „typsicher“, dass Jev AI keine Fehler macht?
Nein. Typsicherheit garantiert nur, dass die Ausgabe dem definierten Schema entspricht, etwa ALLOW, REVIEW oder BLOCK. Sie garantiert nicht, dass die Wahl richtig ist. In der Nexus-Auswertung lag Jev bei 1,8 % der selbst entschiedenen Fälle falsch und gab 42 % der Fälle an Fallback-Regeln ab. Folgenreiche Aktionen brauchen weiterhin Richtlinien, Verifikation und menschliche Prüfung.
Wie setzen Sicherheitsteams KI für Cybersicherheit sicher ein?
Behandeln Sie Modellausgaben als probabilistische Signale, nicht als letzte Instanz. Legen Sie Konfidenzschwellen nach den Kosten einer Fehlentscheidung fest, behalten Sie deterministische Autorisierungsgrenzen, geben Sie unsichere Fälle an ein stärkeres Modell oder einen Menschen weiter und verifizieren Sie Ergebnisse unabhängig. Das NIST AI Risk Management Framework und die OWASP Top 10 for LLM Applications sind gute Ausgangspunkte.
Quellen