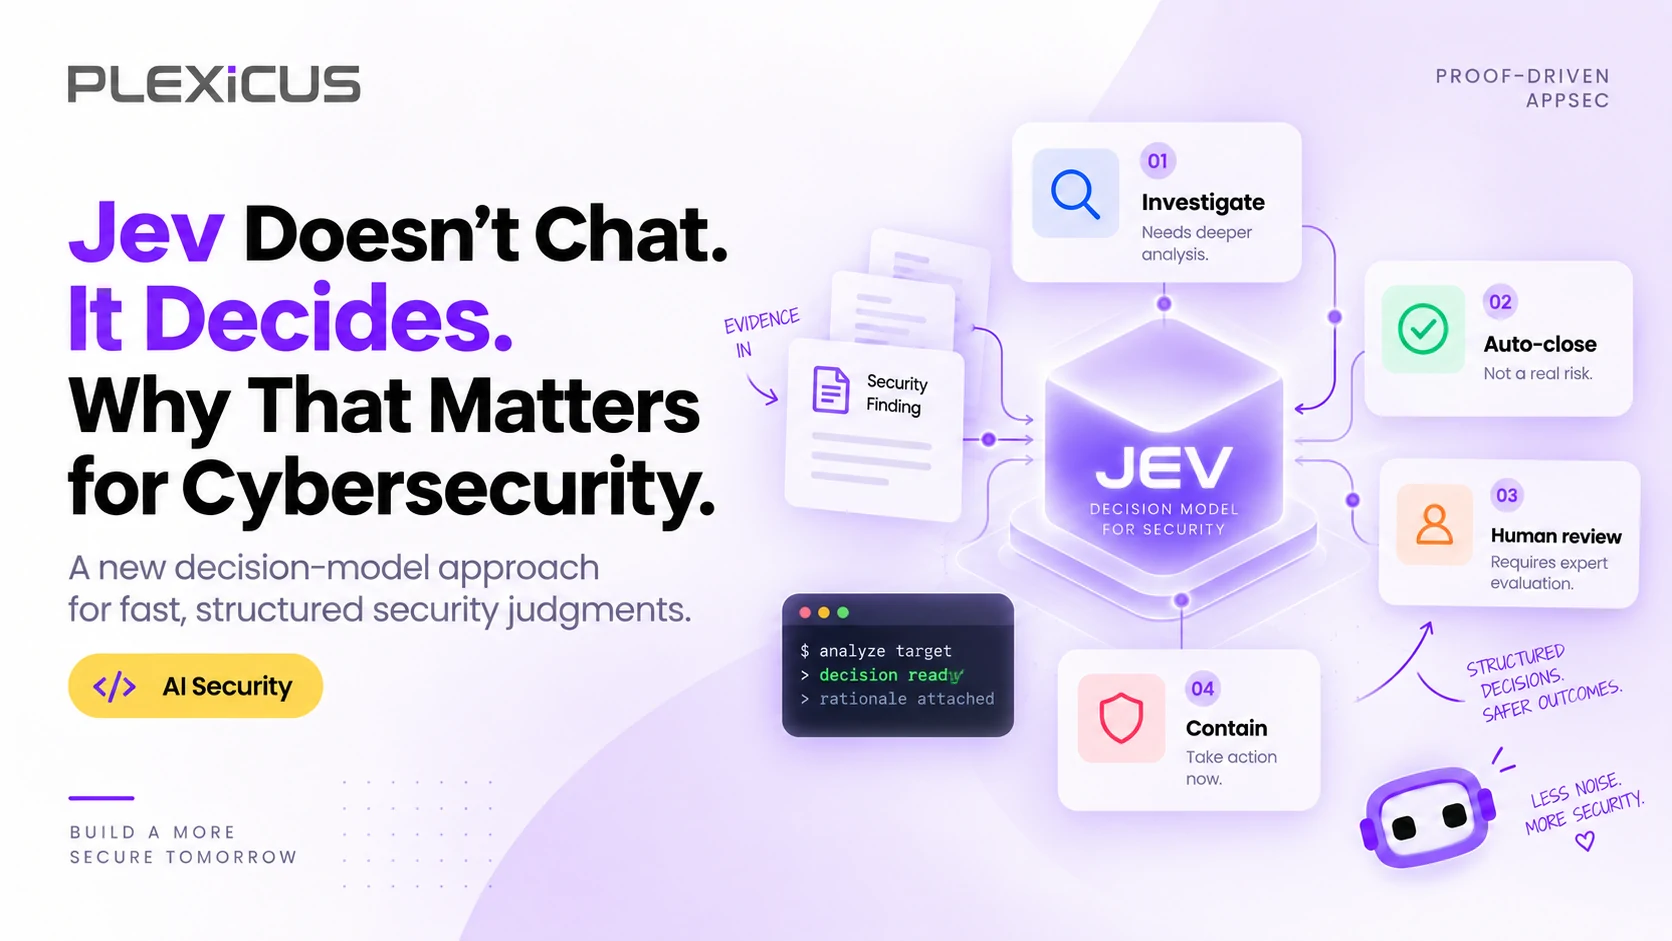
Jev AI não conversa. Decide. Por que isso importa para a cibersegurança
Jev entrega decisões tipadas, não prosa. Isso pode colocar julgamento semântico em fluxos de segurança, sempre com política, fallback, validação e revisão humana.
Além de ASPM
AppSec orientada por provas para equipes que desenvolvem com IA
A Plexicus usa AI Swarm Pentest para explorar caminhos autorizados da aplicação, validar o que é explorável e dar às equipes evidências para priorizar a remediação.
Explorar AI Swarm PentestJev AI é um modelo de decisão da TypeSafe AI que devolve escolhas, pontuações e probabilidades tipadas em vez de texto gerado. Para a IA em cibersegurança, isso importa porque sistemas de segurança tomam milhões de pequenas decisões urgentes, e um modelo que decide em menos de um segundo, por uma fração de centavo, pode levar contexto semântico a pontos onde grandes LLMs são lentos ou caros demais.
A pergunta dominante da IA tem sido qual modelo gera a melhor resposta. A TypeSafe pergunta outra coisa: e se o software precisa de uma decisão, não de texto? Lançado em 15 de setembro de 2026, Jev recebe contexto e perguntas pré-definidas e devolve escolhas, pontuações ou probabilidades tipadas.
De gerar linguagem a decidir
Um LLM pode explicar uma alerta; o sistema geralmente precisa de risco = crítico, ação = conter, confiança = 0,97. Jev elimina a prosa: a aplicação define as saídas e o modelo devolve probabilidades. A integração no Vercel AI Gateway descreve Choice, Score e Boolean em paralelo.
A avaliação Security Incidents reúne alerta, ativo, proprietário, tickets, dispositivos, manutenção e autorizações. Ela avalia atividade não autorizada, explicação disponível e força da evidência; depois pode examinar credenciais, sessões, processos, rede e propagação antes de notificar, escalar, encerrar processo ou desabilitar conta. O modelo estima; a política de segurança impõe.
Evidência inicial
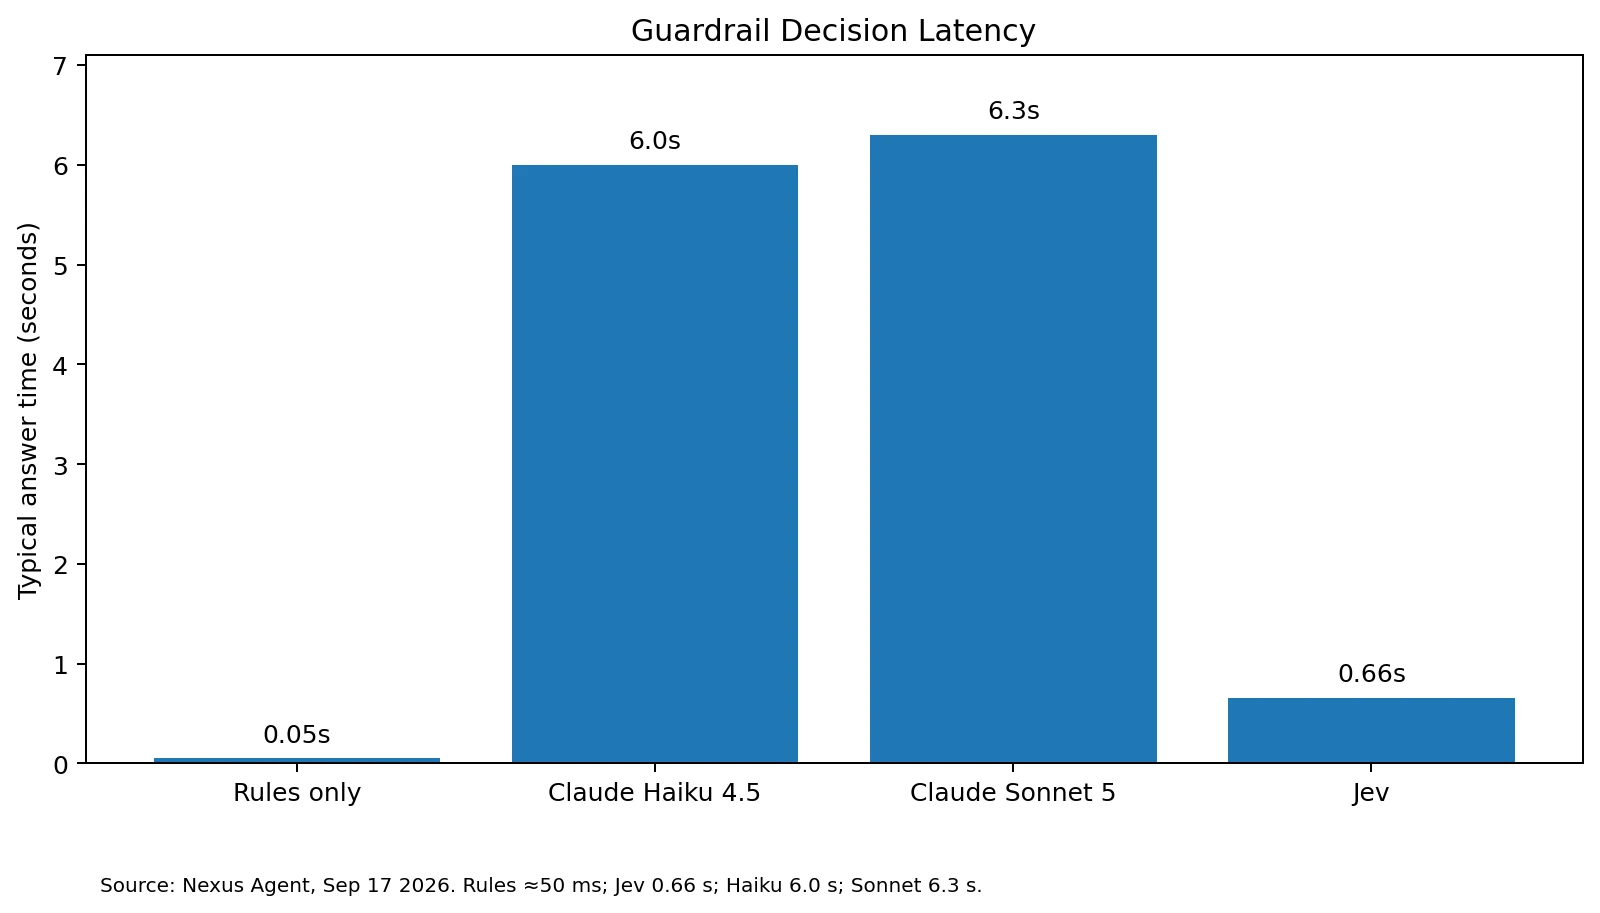
Os números mais fortes da TypeSafe (70–500 ms de resposta anunciados) são resultados do fornecedor, e a empresa reconhece que representam o limite superior dos ganhos reais. A análise do Nexus Agent relata 19.118 momentos reais, 36.218 chamadas e 469 casos de guardrail. Jev decidiu 58% e registrou 90 erros totais com fallback de regras; regras tiveram 148, Haiku 99 e Sonnet 92.
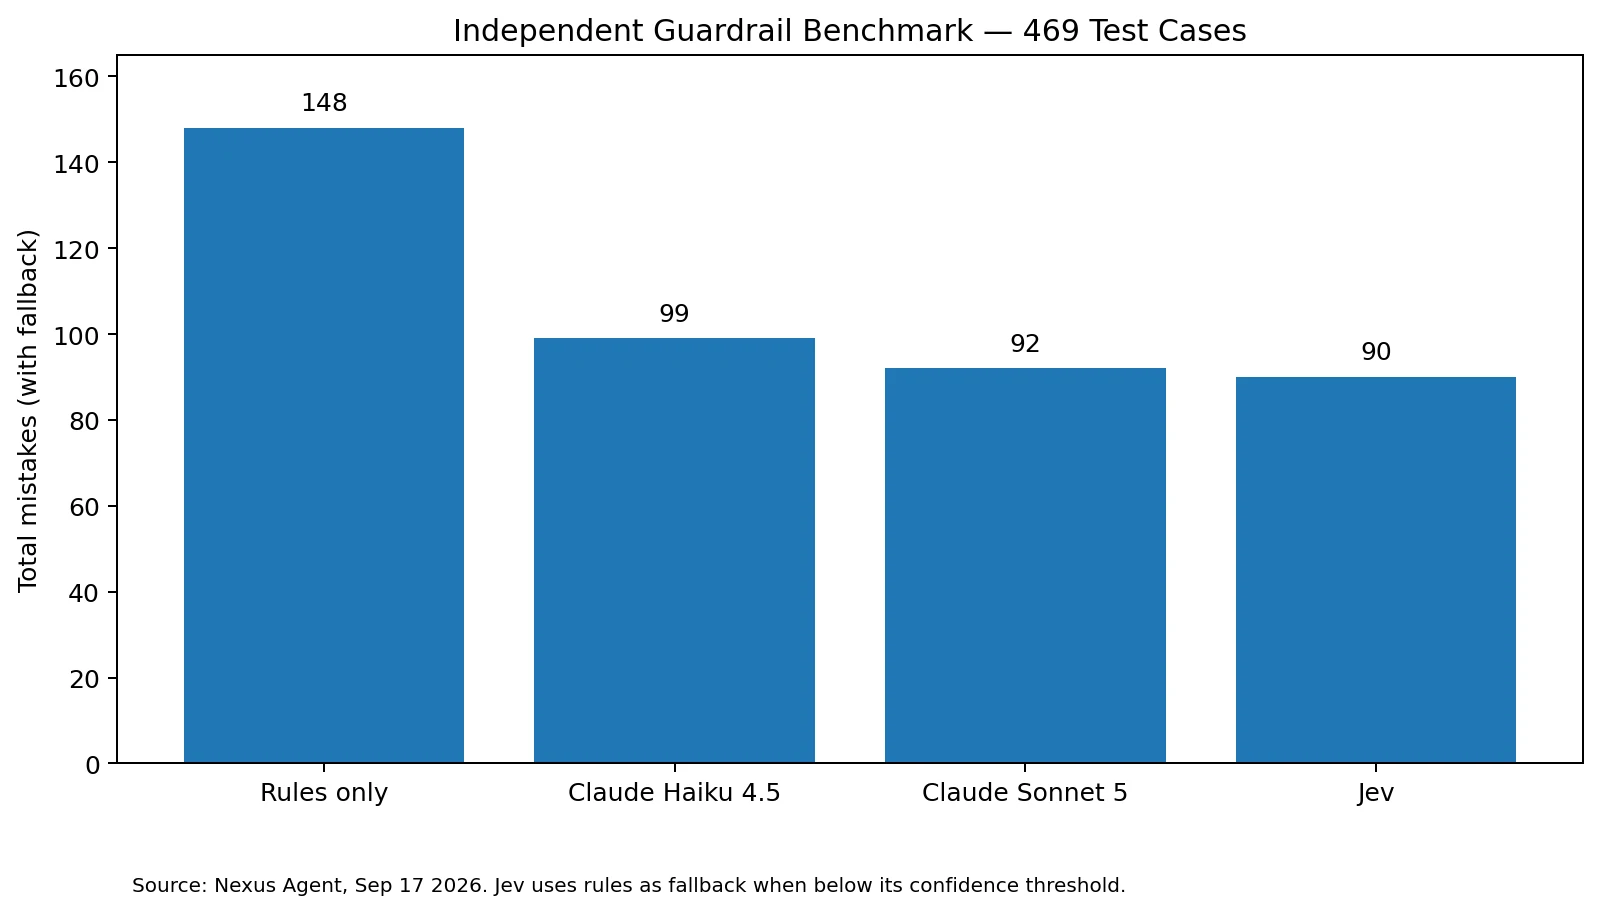
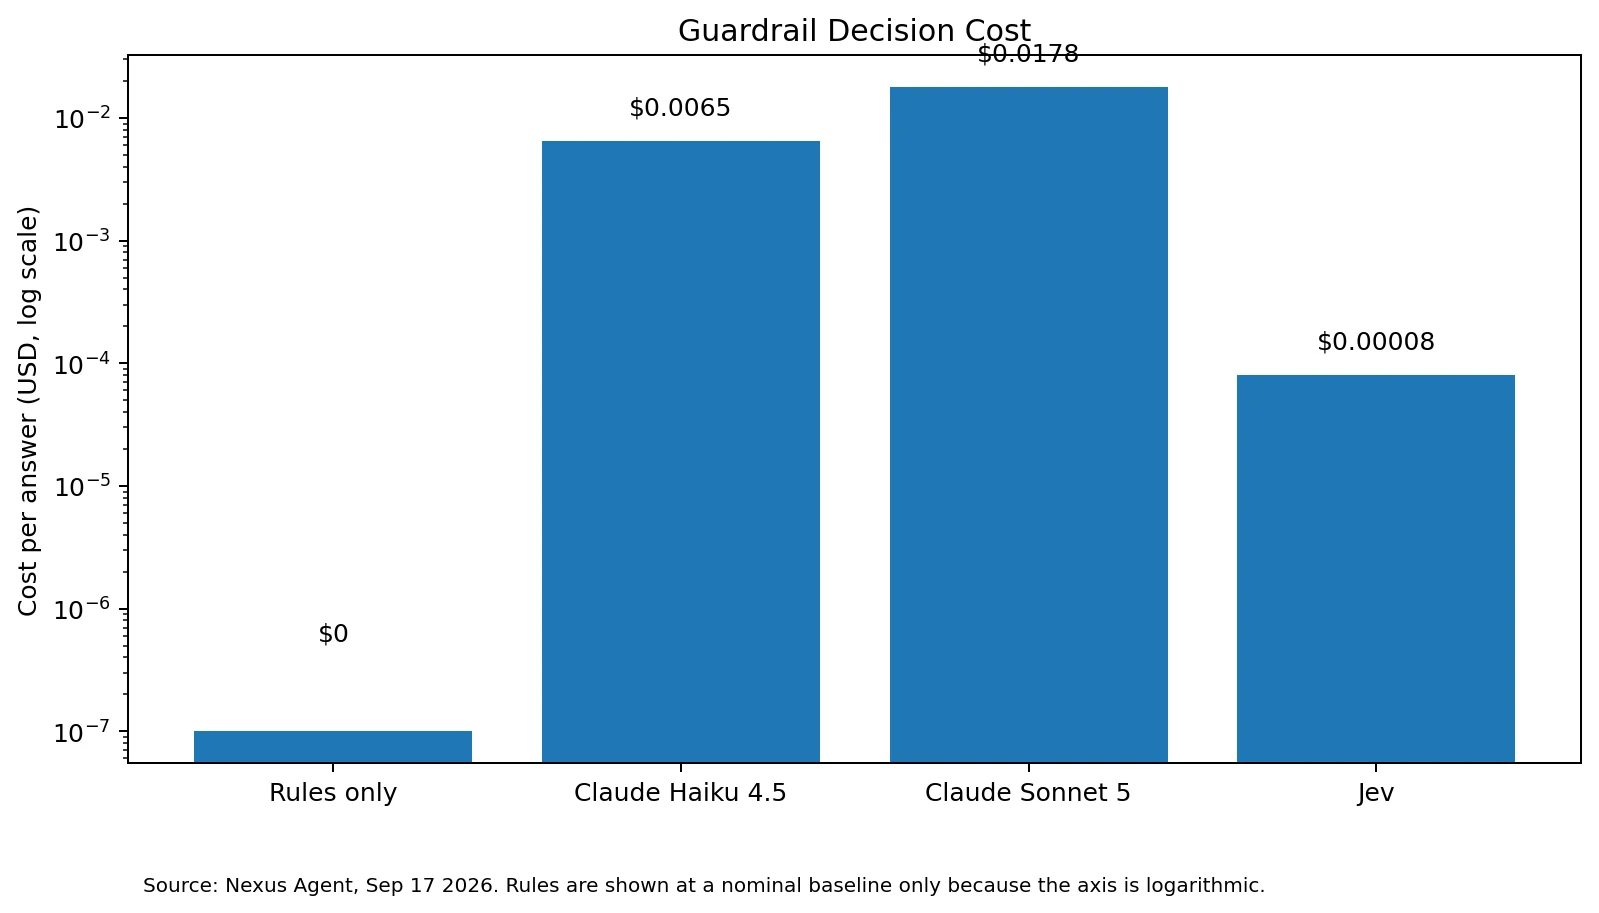
O detalhe essencial é cobertura: 1,8% de erro quando decide não é precisão universal. O padrão útil é responder com confiança e encaminhar incerteza para regras, modelo mais forte ou pessoas. Aprofundamos essa questão de encaminhamento em IA em segurança de aplicações: automação vs. ampliação. Nexus informa 0,68 segundo de mediana e US$ 0,00008 por decisão.
Onde Jev AI pode importar na IA para cibersegurança
Um SOC pode separar sinais benignos, incertos e de alto risco mais cedo. Isso não substitui analistas: reserva raciocínio caro e atenção humana para onde têm valor. Para agentes de IA, uma camada de decisão pode avaliar se a ação é destrutiva, reversível e autorizada antes de a política bloqueá-la ou escalá-la — uma resposta direta ao risco Excessive Agency (LLM06) do OWASP Top 10 for LLM Applications. O mesmo padrão vale para DLP semântico, phishing, IAM, fraude e priorização de vulnerabilidades.
Segurança de tipos não é correção: ALLOW pode ser errado quando BLOCK é necessário. Trate esses modelos como sensores probabilísticos, não como mecanismos infalíveis de política. Baixo impacto e alta confiança podem automatizar; incerteza, alto impacto ou irreversibilidade exigem investigação, controles e autorização.
Jev não substitui raciocínio profundo nem julgamento humano. Esse trabalho continua com sistemas de raciocínio, como modelos de fronteira do tipo Claude Opus 5.5 ou ferramentas multiagente como um AI Swarm Pentest. Pode ser uma camada entre detecção, raciocínio, validação, política e ação. Avaliação editorial: preserve limites determinísticos de autorização, validação independente, fallbacks e revisão humana para ações consequentes. Explicamos por que a prova importa em do alerta à correção com AppSec orientada por provas.
Perguntas frequentes
O que é o Jev AI?
Jev é um modelo de decisão lançado pela TypeSafe AI em setembro de 2026 como o primeiro do que a empresa chama de System One Models. Em vez de gerar texto, recebe contexto e perguntas predefinidas e devolve respostas tipadas Choice, Score ou Boolean com probabilidades que o software pode usar diretamente. A TypeSafe informa tempos de resposta de 70–500 ms.
Qual a diferença entre o Jev AI e um LLM como GPT ou Claude?
Um LLM convencional gera prosa token a token, que depois o software precisa interpretar. O Jev avalia perguntas predefinidas em paralelo e devolve apenas os tipos de resposta permitidos, por isso não produz saídas malformadas. Ele troca raciocínio aberto e geração de texto por velocidade, baixo custo e decisões estruturadas, complementando os modelos de raciocínio em vez de substituí-los.
O Jev AI pode ser usado em cibersegurança?
Potencialmente. A TypeSafe publicou uma avaliação de fluxo para incidentes de segurança, e o Nexus Agent testou o Jev como guardrail para agentes de IA. Usos prováveis incluem triagem no SOC, verificação de ações de agentes, DLP semântico, análise de phishing e priorização de vulnerabilidades. A evidência ainda é inicial, então valide o modelo com seus próprios dados.
“Tipado” significa que o Jev AI não erra?
Não. A segurança de tipos garante que a saída segue o esquema definido pela aplicação, como ALLOW, REVIEW ou BLOCK, mas não que a escolha esteja certa. Na avaliação do Nexus, o Jev errou em 1,8% dos casos que decidiu e repassou 42% dos casos para regras de fallback. Ações com consequências ainda exigem política, verificação e revisão humana.
Como adotar IA para cibersegurança com segurança?
Trate as saídas do modelo como sinais probabilísticos, não como autoridade final. Defina limites de confiança pelo custo de um erro, mantenha fronteiras de autorização determinísticas, encaminhe casos incertos a um modelo mais forte ou a uma pessoa e verifique os resultados de forma independente. O NIST AI Risk Management Framework e o OWASP Top 10 for LLM Applications são bons pontos de partida.
Fontes