Framework MAESTRO : guide pratique en 7 couches pour modéliser les menaces de l’IA agentique
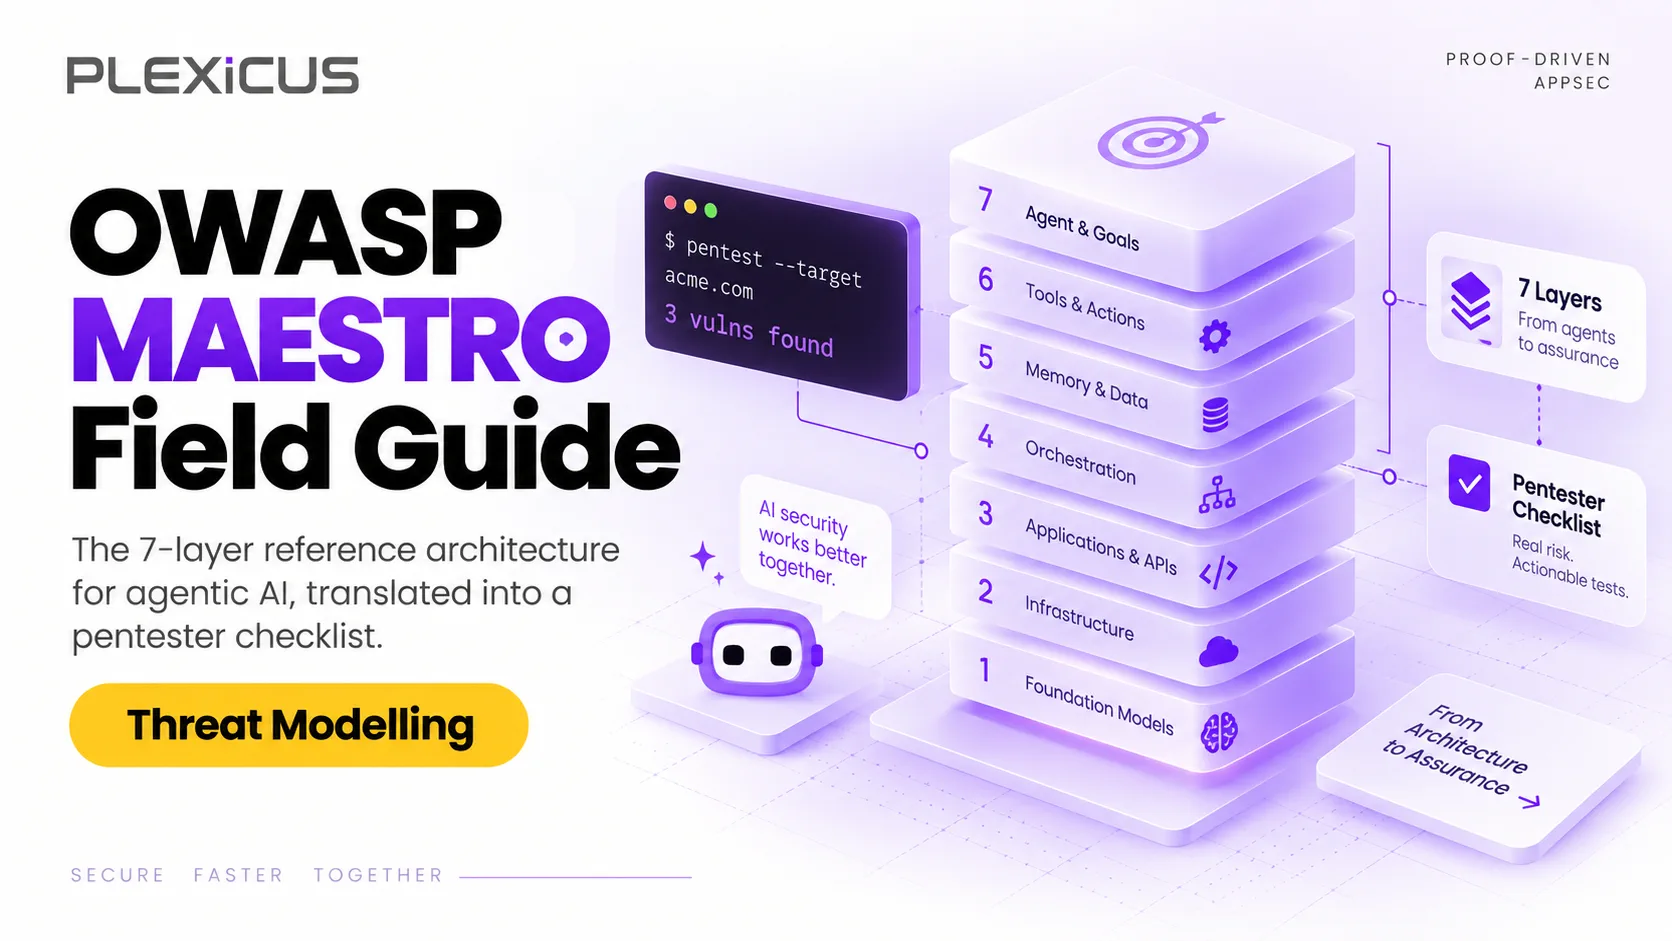
MAESTRO est le framework en 7 couches de la Cloud Security Alliance pour modéliser les menaces de l’IA agentique, mis en pratique par l’OWASP GenAI Security Project. Ce guide transforme chaque couche en une liste de contrôle de pentest.
Au-delà de l’ASPM
Une AppSec fondée sur la preuve pour les équipes qui développent avec l’IA
Plexicus utilise AI Swarm Pentest pour explorer des chemins d’application autorisés, valider ce qui est exploitable et fournir les preuves nécessaires pour prioriser la remédiation.
Découvrir AI Swarm PentestLe framework MAESTRO (Multi-Agent Environment, Security, Threat, Risk, and Outcome) est une méthode de modélisation des menaces en sept couches pour les systèmes d’IA agentique. Ken Huang l’a présenté par l’intermédiaire de la Cloud Security Alliance en février 2025. Le Multi-Agentic System Threat Modeling Guide de l’OWASP GenAI Security Project (avril 2025) s’appuie sur ce framework, d’où le nom « OWASP MAESTRO » utilisé par de nombreuses équipes. Ce guide pratique décline chaque couche MAESTRO en une liste de contrôle pour les pentesters.
Tous les frameworks de modélisation des menaces utilisés jusqu’ici par votre équipe de sécurité ont été conçus pour des logiciels écrits par des humains. STRIDE cible les menaces applicatives classiques. PASTA est un processus centré sur les risques et fondé sur la simulation d’attaques. LINDDUN couvre les menaces pour la vie privée. OCTAVE traite des risques organisationnels. Trike et VAST se concentrent sur le passage à l’échelle de la modélisation des menaces entre équipes.
Aucun ne modélise la surface de menace d’un agent. Aucun ne prévoit de couche pour « les données d’entraînement du modèle ont été empoisonnées ». Aucun ne prévoit de couche pour « la description d’un outil de l’agent a été modifiée après son approbation ». Aucun ne prévoit de couche pour « la trace de raisonnement de l’agent s’est écartée de son objectif déclaré ».
MAESTRO a été conçu pour combler cette lacune. Au lieu d’abandonner les méthodes plus anciennes, les auteurs de la CSA enrichissent les catégories de STRIDE, PASTA et LINDDUN de menaces propres à l’IA et les organisent couche par couche. La suite de ce guide présente, pour chaque couche, des schémas d’attaque concrets, des signaux de détection et des mesures d’atténuation.
Qu’est-ce que le framework MAESTRO ?
MAESTRO est une architecture de référence en 7 couches pour la sécurité de l’IA agentique. Il conserve les éléments utiles de STRIDE et de PASTA, mais modélise la surface de menace de bas en haut pour prendre en compte ce qui apparaît lorsqu’un agent d’IA dispose :
- D’une mémoire persistante
- De capacités d’appel d’outils (souvent via MCP)
- D’une boucle de raisonnement en plusieurs étapes
- De la capacité d’agir sur des systèmes externes
Les sept couches, de bas en haut :
- Foundation Models — les LLM qui alimentent l’agent
- Data Operations — les pipelines qui fournissent du contexte au modèle
- Agent Frameworks — l’environnement d’exécution qui orchestre la boucle de l’agent
- Deployment & Infrastructure — l’environnement d’exécution de l’agent
- Evaluation & Observability — la manière dont le comportement de l’agent est mesuré et journalisé
- Security & Compliance — les contrôles qui régissent l’agent
- Agent Ecosystem — les autres agents, outils et services avec lesquels l’agent interagit
Dans la version originale de la CSA, Security & Compliance est une couche transversale qui couvre les six autres, au lieu de se trouver au-dessus d’elles. Chaque couche a son propre modèle de menace, ses schémas d’attaque et ses mesures d’atténuation. Les modèles de menace génériques regroupent souvent l’essentiel de ces éléments dans une seule catégorie « dépendances externes ». MAESTRO les distingue.
MAESTRO et OWASP : qui publie quoi ?
- Cloud Security Alliance (CSA) : l’article original sur le framework MAESTRO, publié par Ken Huang le 6 février 2025.
- OWASP GenAI Security Project, Agentic Security Initiative : la taxonomie Agentic AI Threats and Mitigations (février 2025) et le Multi-Agentic System Threat Modeling Guide (avril 2025), qui applique MAESTRO à des systèmes multi-agents réels.
Le résultat est un framework que les pentesters spécialisés en IA agentique peuvent utiliser comme liste de contrôle. La suite de ce guide constitue cette liste.
Couche 1 — Foundation Models
Surface de menace
Le modèle lui-même, ses poids, ses données d’entraînement et la chaîne d’approvisionnement qui l’a produit.
Schémas d’attaque
- Empoisonnement du modèle via les données d’entraînement. Un contributeur à un jeu de données y injecte des exemples contenant une porte dérobée. Le modèle apprend le déclencheur, qui s’active en production.
- Exfiltration des poids du modèle. Un attaquant compromet le registre de modèles et copie les poids. Le modèle devient accessible aux concurrents ou peut servir à un fine-tuning adversarial.
- Checkpoints avec porte dérobée sur Hugging Face. Le fine-tuning d’un modèle connu, disponible publiquement, contient une porte dérobée. L’agent en aval en hérite.
- Fine-tuning adversarial d’un modèle de base open source. Une équipe utilise Llama 4 ou Mistral comme base. Un attaquant publie une variante présentée comme « optimisée pour la sécurité », mais subtilement désalignée. L’équipe choisit la mauvaise.
Signaux de détection
- Incohérence entre le hash attendu et celui des poids chargés
- Mises à jour de gradient suspectes pendant le fine-tuning
- Comportement en aval déclenché par des entrées rares (détection probabiliste de portes dérobées)
- Pics inhabituels de la courbe de perte pendant l’entraînement
Mesures d’atténuation
- Épingler les versions des modèles par hash et non par nom
- Obtenir les poids auprès de registres attestés (commits signés sur Hugging Face, artefacts internes signés)
- Évaluer la robustesse aux attaques adversariales avant le déploiement
- Tenir une liste d’autorisation des fournisseurs de modèles avec vérification de provenance
Couche 2 — Data Operations
Surface de menace
Les données consommées par l’agent à l’exécution : corpus de génération augmentée par récupération (RAG), modèles de prompts, historique des conversations, résultats des outils et tout autre contexte transmis au modèle au moment de l’inférence.
Schémas d’attaque
- Injection indirecte de prompt via des documents RAG. OWASP LLM01 définit l’injection indirecte de prompt comme une entrée que le modèle reçoit de sources externes, comme des sites web ou des fichiers. L’attaquant place du texte dans un document que l’agent récupérera. Ce texte contient des consignes que l’agent suit comme si elles venaient de l’utilisateur.
- Dissimulation dans un modèle de prompt. L’attaquant modifie un modèle de prompt stocké pour y ajouter des consignes qui contournent la couche de sécurité de l’agent.
- Empoisonnement des résultats d’outils. L’agent appelle un outil. Celui-ci renvoie une chaîne contenant des consignes injectées. L’agent traite le résultat de l’outil comme une source d’instructions fiable.
- Empoisonnement de la mémoire. L’agent écrit dans sa mémoire à long terme. L’attaquant peut écrire dans le même espace de stockage (souvent une base de données vectorielle). Les récupérations ultérieures incluent les consignes de l’attaquant.
- Injection dans les journaux. L’agent journalise sa trace de raisonnement. L’attaquant injecte du texte dans le journal. Un agent de supervision lit ce journal et traite le texte injecté comme une consigne.
Signaux de détection
- Résultats d’outils contenant des formulations proches d’instructions (impératifs, adresse directe)
- Documents RAG dont la densité d’instructions est anormalement élevée
- Écritures en mémoire qui ne correspondent pas à l’historique d’interaction observé de l’agent
- Entrées de journal contenant des tournures incompatibles avec la personnalité de l’agent
Mesures d’atténuation
- Traiter tout contenu récupéré et tout résultat d’outil comme des données non fiables, et non comme des consignes
- Utiliser un canal d’instructions distinct (system prompt), isolé du canal de données
- Passer les résultats des outils dans un analyseur structuré au lieu de concaténer directement des chaînes brutes
- Appliquer le suivi de provenance à chaque écriture en mémoire
Couche 3 — Agent Frameworks
Surface de menace
L’environnement d’exécution qui orchestre la boucle de l’agent : module de planification, logique de sélection des outils, interface mémoire, trace de raisonnement et planificateur d’exécution.
Schémas d’attaque
- Manipulation de la trace de raisonnement. La chaîne de pensée de l’agent apparaît dans les journaux. L’attaquant lit la trace, identifie l’objectif et y place une observation trompeuse qui détourne l’étape suivante.
- Détournement de la sélection des outils. L’agent choisit ses outils en fonction d’un planificateur. L’attaquant enregistre un outil malveillant dont le nom ressemble à celui d’un outil légitime. Le planificateur choisit le mauvais outil.
- Amplification de boucle (déni de portefeuille). L’agent entre dans une boucle de raisonnement qui consomme des jetons d’API. Elle tourne sans fin jusqu’à épuisement du budget.
- Échappement d’un sous-agent. Un agent superviseur lance un sous-agent. Celui-ci est moins contraint que le superviseur et effectue des actions que ce dernier n’aurait pas approuvées.
- Décalage entre raisonnement et action. Le raisonnement déclaré par l’agent diverge de ses actions réelles. L’auditeur lit la trace et ne voit aucun problème. Les actions racontent une autre histoire.
Signaux de détection
- Traces de raisonnement contenant des formulations incompatibles avec la personnalité ou les objectifs de l’agent
- Sélections d’outils qui ne correspondent pas au plan annoncé par l’agent
- Anomalies de consommation de jetons par invocation de l’agent
- Appels de sous-agents dépassant le budget déclaré du superviseur
- Écarts entre la trace et les journaux d’actions
Mesures d’atténuation
- Isoler le module de planification du module d’exécution
- Exiger une confirmation explicite pour tout appel d’outil hors d’une liste d’autorisation
- Plafonner la consommation de jetons par invocation et par session
- Maintenir une hiérarchie stricte superviseur/sous-agents, avec des règles d’héritage des capacités
- Comparer en continu les traces de raisonnement aux journaux d’actions
Couche 4 — Deployment & Infrastructure
Surface de menace
L’environnement dans lequel l’agent s’exécute : conteneurs, fonctions sans serveur, machines virtuelles, système d’exploitation sous-jacent, secrets utilisés par l’agent et chemins réseau auxquels il peut accéder.
Schémas d’attaque
- Évasion de conteneur. L’agent tourne dans un conteneur. Une vulnérabilité de l’environnement d’exécution permet de s’échapper vers l’hôte. L’agent dispose alors des privilèges de l’hôte.
- Vol d’identifiants à l’exécution. L’agent détient des clés d’API, des identifiants de base de données ou des jetons OAuth dans son environnement. Une injection de prompt dans un résultat d’outil le pousse à les exfiltrer.
- Déplacement latéral vers des services internes. L’agent peut accéder au réseau interne. L’attaquant l’utilise comme point de pivot.
- Porte dérobée persistante dans l’environnement d’exécution. L’attaquant installe une porte dérobée dans l’image du conteneur de l’agent. Chaque redéploiement la réintroduit.
- Fuite de données par canal auxiliaire. Les caractéristiques de calcul de l’agent (durées, utilisation du GPU) révèlent des informations sur le prompt ou l’état du modèle.
Signaux de détection
- Connexions sortantes inattendues depuis l’environnement d’exécution de l’agent
- Activité inhabituelle sur le système de fichiers ou le réseau
- Écart du conteneur par rapport à l’image de référence connue comme fiable
- Différence entre les règles de sortie déclarées et celles réellement appliquées
Mesures d’atténuation
- Exécuter l’agent avec le minimum de privilèges requis (système de fichiers en lecture seule et aucune sortie réseau hors des points de terminaison autorisés)
- Obtenir les images de conteneur auprès de registres attestés et épingler leurs hashes
- Imposer des listes d’autorisation des flux sortants au moyen de politiques réseau
- Renouveler les identifiants à chaque redémarrage de l’agent
- Déployer la détection des menaces à l’exécution (par ex. Falco, Tetragon) sur l’hôte de l’agent
Couche 5 — Evaluation & Observability
Surface de menace
L’infrastructure de télémétrie, de journalisation, d’évaluation et d’observabilité qui surveille l’agent.
Schémas d’attaque
- Empoisonnement des journaux. Les journaux de l’agent incluent les résultats des outils. L’attaquant injecte du texte dans un résultat transmis aux journaux. Le SIEM ingère l’entrée et traite le texte injecté comme la description d’une alerte.
- Usurpation de télémétrie. L’évaluateur de l’agent signale des métriques apparemment saines. Ces métriques sont falsifiées et l’agent se comporte mal.
- Empoisonnement du jeu d’évaluation. Le jeu d’évaluation est stocké avec les données de production. L’attaquant le modifie. L’agent « réussit » alors des évaluations qui ne reflètent plus le comportement réel.
- Collusion entre l’évaluateur et l’agent. Un agent distinct évalue l’agent de production. Les deux sont accessibles depuis le même point de dépôt d’injection de prompt. L’attaquant utilise ce point pour manipuler l’évaluateur.
Signaux de détection
- Entrées de journal contenant des tournures incompatibles avec l’agent
- Amélioration soudaine des métriques sans changement opérationnel correspondant
- Modification du hash du jeu d’évaluation sans commit de code ou de données associé
- Écart entre la sortie de l’évaluateur et les observations de référence
Mesures d’atténuation
- Séparer le canal de journalisation du canal de données de l’agent
- Signer et hacher tous les jeux d’évaluation ; déclencher une alerte en cas de dérive des hashes
- Traiter les sorties de l’évaluateur comme non fiables et les recouper avec la télémétrie brute
- Utiliser des signaux de référence externes (par ex. retours utilisateurs, différences dans le système de référence) pour valider les résultats d’évaluation
Couche 6 — Security & Compliance
Surface de menace
Les contrôles, les politiques et les régimes de conformité qui régissent le comportement de l’agent : RBAC, application du périmètre, journalisation d’audit, approbation avec intervention humaine et artefacts de politique en tant que code qui encodent les règles.
Schémas d’attaque
- Élargissement du périmètre par composition d’outils. Chaque outil utilisé par l’agent a un périmètre étroit. L’agent enchaîne les outils de façon à ce que leur combinaison dépasse le périmètre de chacun d’eux.
- Contournement de l’approbation humaine. Le processus d’approbation suppose qu’une personne refusera une action dangereuse. L’agent décrit l’action de façon confuse et la personne l’approuve.
- Injection dans les politiques en tant que code. Le moteur de politiques lit les règles dans un artefact versionné. L’attaquant modifie cet artefact. L’agent fonctionne alors selon de nouvelles règles.
- Altération du journal d’audit. L’agent peut accéder à son propre journal d’audit. L’attaquant s’en sert pour réécrire le journal et effacer ses traces.
Signaux de détection
- Appels d’outils dépassant le périmètre déclaré d’un outil pris individuellement
- Modèles d’approbation incompatibles avec l’action annoncée par l’agent
- Changements du hash de l’artefact de politique sans commit correspondant
- Entrées du journal d’audit modifiées après coup
Mesures d’atténuation
- Vérifier les capacités au niveau de la composition, et pas seulement de chaque outil
- Exiger un résumé en langage clair en plus de l’action elle-même
- Signer et hacher les artefacts de politique ; déclencher une alerte en cas de dérive
- Écrire les journaux d’audit dans un espace de stockage en ajout seul auquel l’agent n’a pas accès
Couche 7 — Agent Ecosystem
Surface de menace
Les autres agents, outils, serveurs MCP, services externes et personnes avec lesquels l’agent interagit en production.
Schémas d’attaque
- Empoisonnement d’outil MCP. Le serveur MCP modifie la description de son outil après l’approbation de l’agent (« rug pull », documenté par Invariant Labs). La nouvelle description entraîne un comportement différent.
- Compromission du serveur MCP. Le serveur MCP lui-même est compromis. Les appels d’outils de l’agent transitent désormais par du code contrôlé par l’attaquant.
- Injection de prompt entre agents. Les agents A et B communiquent. L’attaquant plante dans le contexte de A des consignes visant spécifiquement B.
- Attaque de la chaîne d’approvisionnement d’un marché d’outils. Un outil publié par la communauté contient du code malveillant. L’agent l’importe et l’outil exfiltre des identifiants dès sa première utilisation.
- Usurpation de l’identité d’un humain. L’agent reçoit un message qui semble provenir d’un opérateur humain, mais dont l’expéditeur est en réalité l’attaquant. L’agent suit les consignes.
Signaux de détection
- Modification de la description d’un outil après son approbation
- Changements de comportement inattendus dans des outils utilisés depuis longtemps
- Messages entre agents comportant des instructions
- Outils de places de marché dont le score de provenance est faible
- Messages d’opérateurs présentant des schémas anormaux
Mesures d’atténuation
- Épingler les descriptions des outils MCP au moment de l’approbation et signaler toute dérive
- Utiliser une liste d’autorisation d’outils assortie d’exigences de provenance
- Isoler les échanges entre agents au moyen de messages structurés
- Exiger une authentification multifacteur pour les consignes des opérateurs
- Tenir un inventaire des outils avec des scores de risque
Exemple détaillé — Hexstrike-AI
En septembre 2025, Check Point a rapporté que des acteurs malveillants discutaient de Hexstrike-AI, un framework offensif dont le serveur FastMCP relie des LLM (Claude, GPT, Copilot) à plus de 150 outils de sécurité, comme moyen d’exploiter les failles Citrix NetScaler CVE-2025-7775, CVE-2025-7776 et CVE-2025-8424 divulguées le 26 août 2025. Des messages de forum affirmaient qu’il réduisait le délai d’exploitation de plusieurs jours à moins de 10 minutes.
Hexstrike-AI est l’agent de l’attaquant, pas la victime. C’est ce qui en fait un bon exercice MAESTRO : si un agent de même conception fonctionnait dans votre environnement, comme outil de red team ou agent d’automatisation interne avec le même accès aux outils, à quelles questions chaque couche devrait-elle répondre ? Le tableau ci-dessous est notre cartographie illustrative, et non une conclusion du rapport de Check Point.
| Couche MAESTRO | Questions soulevées par un agent comme Hexstrike-AI |
|---|---|
| L1 — Foundation Models | Il dépend de LLM tiers ; le comportement du modèle et ses garde-fous échappent à votre contrôle |
| L2 — Data Operations | Les résultats des scans et des outils retournent dans le contexte du modèle, créant une voie d’injection indirecte de prompt à partir de cibles hostiles |
| L3 — Agent Frameworks | L’orchestrateur choisit parmi plus de 150 outils ; des outils similaires ou détournés pourraient le rediriger |
| L4 — Deployment & Infrastructure | Quel que soit l’endroit où tourne le serveur MCP, son accès réseau et ses identifiants en font un point de pivot |
| L5 — Evaluation & Observability | Sans journaux de chaque appel d’outil, il est difficile de reconstituer une séquence automatisée de scan et d’exploitation |
| L6 — Security & Compliance | Le périmètre est appliqué par l’opérateur, et non par l’outil ; rien n’empêche un enchaînement d’exploits de dépasser les cibles autorisées |
| L7 — Agent Ecosystem | La couche MCP constitue la principale surface d’attaque ; les descriptions d’outils et les outils communautaires doivent être épinglés et leur provenance vérifiée |
La cartographie MAESTRO rend lisible la surface de menace à chaque couche. Les pentesters qui évaluent un agent similaire disposent d’une liste de contrôle qu’ils parcourent de bas en haut. On retrouve également ce schéma d’agents connectés à de vrais outils dans des plateformes grand public. Notre analyse du stack d’agents présenté à l’OpenAI DevDay 2026 l’examine du point de vue de la défense.
Liste de contrôle MAESTRO pour les pentesters
Pour chaque couche, avant de commencer un pentest d’un système d’IA agentique, vérifiez les points suivants :
- L1 — Modèles : Quels modèles alimentent l’agent ? Quelle est leur provenance ? Les poids sont-ils épinglés ?
- L2 — Données : Que lit l’agent à l’exécution ? Le contenu récupéré est-il traité comme des consignes ou comme des données ?
- L3 — Frameworks : Existe-t-il un planificateur et un exécuteur distincts ? Les capacités des sous-agents sont-elles héritées ou limitées ?
- L4 — Infrastructure : Quels sont les privilèges à l’exécution ? Quelle est la politique de sortie ? L’image est-elle attestée ?
- L5 — Télémétrie : Qu’est-ce qui est journalisé ? Où vont les journaux ? L’agent peut-il écrire dans son propre journal d’audit ?
- L6 — Contrôles : Comment le périmètre est-il appliqué au niveau de la composition d’outils ? À quelles étapes les humains donnent-ils leur approbation ?
- L7 — Écosystème : Quels serveurs MCP l’agent utilise-t-il ? Les descriptions des outils sont-elles épinglées ? Avec quels autres agents communique-t-il ?
C’est le niveau attendu. Un pentest qui ne couvre pas les sept couches est incomplet. Si vous choisissez des outils pour ce type de mission, notre comparatif des outils de pentest IA classe le marché selon la qualité des preuves, et AI Swarm Pentest de Plexicus utilise des agents d’attaque à périmètre signé et des résultats vérifiés par rejeu. Les couches 1 à 3 se trouvent aussi dans le code : c’est là que Deep Code Analysis suit le chemin d’un résultat d’outil non fiable jusqu’à un point d’exploitation.
Pourquoi MAESTRO compte pour la sécurité de l’IA agentique
La surface de menace de l’IA agentique ne va pas diminuer. Les modèles vont gagner en capacité, les écosystèmes d’outils vont s’agrandir et les chaînes d’approvisionnement vont se complexifier. Le nombre d’agents par entreprise va augmenter, et une part croissante du code qu’ils touchent sera écrite par des machines ; dans nos propres scans, 78 % des pull requests générées par l’IA contenaient une vulnérabilité.
MAESTRO fait partie des premiers frameworks conçus pour cette réalité et fournit un vocabulaire commun au secteur. Plus tôt votre équipe l’adoptera, plus vite vos pentesters, spécialistes de la modélisation des menaces et auditeurs parleront le même langage.
Les équipes qui attendent seront celles dont les rapports d’audit réduisent la « sécurité de l’IA » à un contrôle unique. Celles qui adoptent MAESTRO dès maintenant disposeront d’une défense en profondeur multicouche, étayée par des preuves et vérifiable par rejeu : c’est le niveau attendu pour une AppSec fondée sur la preuve en 2026 et au-delà.
Questions fréquentes
Qu’est-ce que le framework MAESTRO ?
MAESTRO (Multi-Agent Environment, Security, Threat, Risk, and Outcome) est un framework de modélisation des menaces pour l’IA agentique. Il divise un système d’agents en sept couches, des Foundation Models et Data Operations jusqu’à l’écosystème d’agents, et répertorie les menaces ainsi que les mesures d’atténuation de chacune. Il complète des méthodes plus anciennes comme STRIDE, PASTA et LINDDUN avec des menaces propres à l’IA, telles que l’injection de prompt, l’empoisonnement de la mémoire et l’empoisonnement d’outils MCP.
MAESTRO est-il un framework OWASP ou Cloud Security Alliance ?
Ken Huang a présenté MAESTRO sur le blog de la Cloud Security Alliance en février 2025. L’Agentic Security Initiative de l’OWASP GenAI Security Project a ensuite publié le Multi-Agentic System Threat Modeling Guide en avril 2025, qui applique MAESTRO à des systèmes multi-agents réels. C’est pourquoi on parle souvent d’« OWASP MAESTRO », même si le framework lui-même vient de la CSA.
Quelles sont les 7 couches de MAESTRO ?
Les sept couches sont Foundation Models, Data Operations, Agent Frameworks, Deployment and Infrastructure, Evaluation and Observability, Security and Compliance et Agent Ecosystem. Security and Compliance est une couche transversale qui couvre toutes les autres. Chaque couche a sa propre surface d’attaque ; un modèle de menace MAESTRO les examine donc une par une au lieu de traiter l’agent d’IA comme une seule boîte noire.
En quoi la modélisation des menaces avec MAESTRO diffère-t-elle de STRIDE ?
STRIDE classe les menaces par type (usurpation, altération, répudiation, divulgation d’informations, déni de service et élévation de privilèges) pour les logiciels traditionnels. MAESTRO conserve cette approche, mais organise les menaces selon les couches d’un système d’agents et ajoute celles que STRIDE ne peut pas représenter : données d’entraînement empoisonnées, injection de prompt via les outils et la mémoire, décalage entre raisonnement et action, ainsi que confiance entre plusieurs agents, outils et serveurs MCP.
Comment utiliser MAESTRO pour un pentest de sécurité d’une IA agentique ?
Commencez par la couche 1 et remontez. Pour chaque couche, répertoriez les composants dans le périmètre, associez-leur les schémas d’attaque de ce guide et vérifiez la présence des signaux de détection et des mesures d’atténuation. Testez ensuite les chemins les plus risqués — généralement l’injection indirecte de prompt (couche 2), la sélection d’outils (couche 3) et les serveurs MCP (couche 7) — et conservez des preuves reproductibles pour chaque constat.
À lire également :
- De l’alerte à la correction : boucler la boucle avec l’AppSec fondée sur la preuve — le processus opérationnel que MAESTRO aide à cartographier
- Qu’est-ce que Deep Code Analysis ? — la couche d’analyse statique qui complète MAESTRO L1–L3
- 78 % des pull requests générées par l’IA contiennent une vulnérabilité — le type d’échec en production que MAESTRO L2/L7 vise à modéliser

