Jev AI ne discute pas. Il décide. Pourquoi cela compte pour la cybersécurité
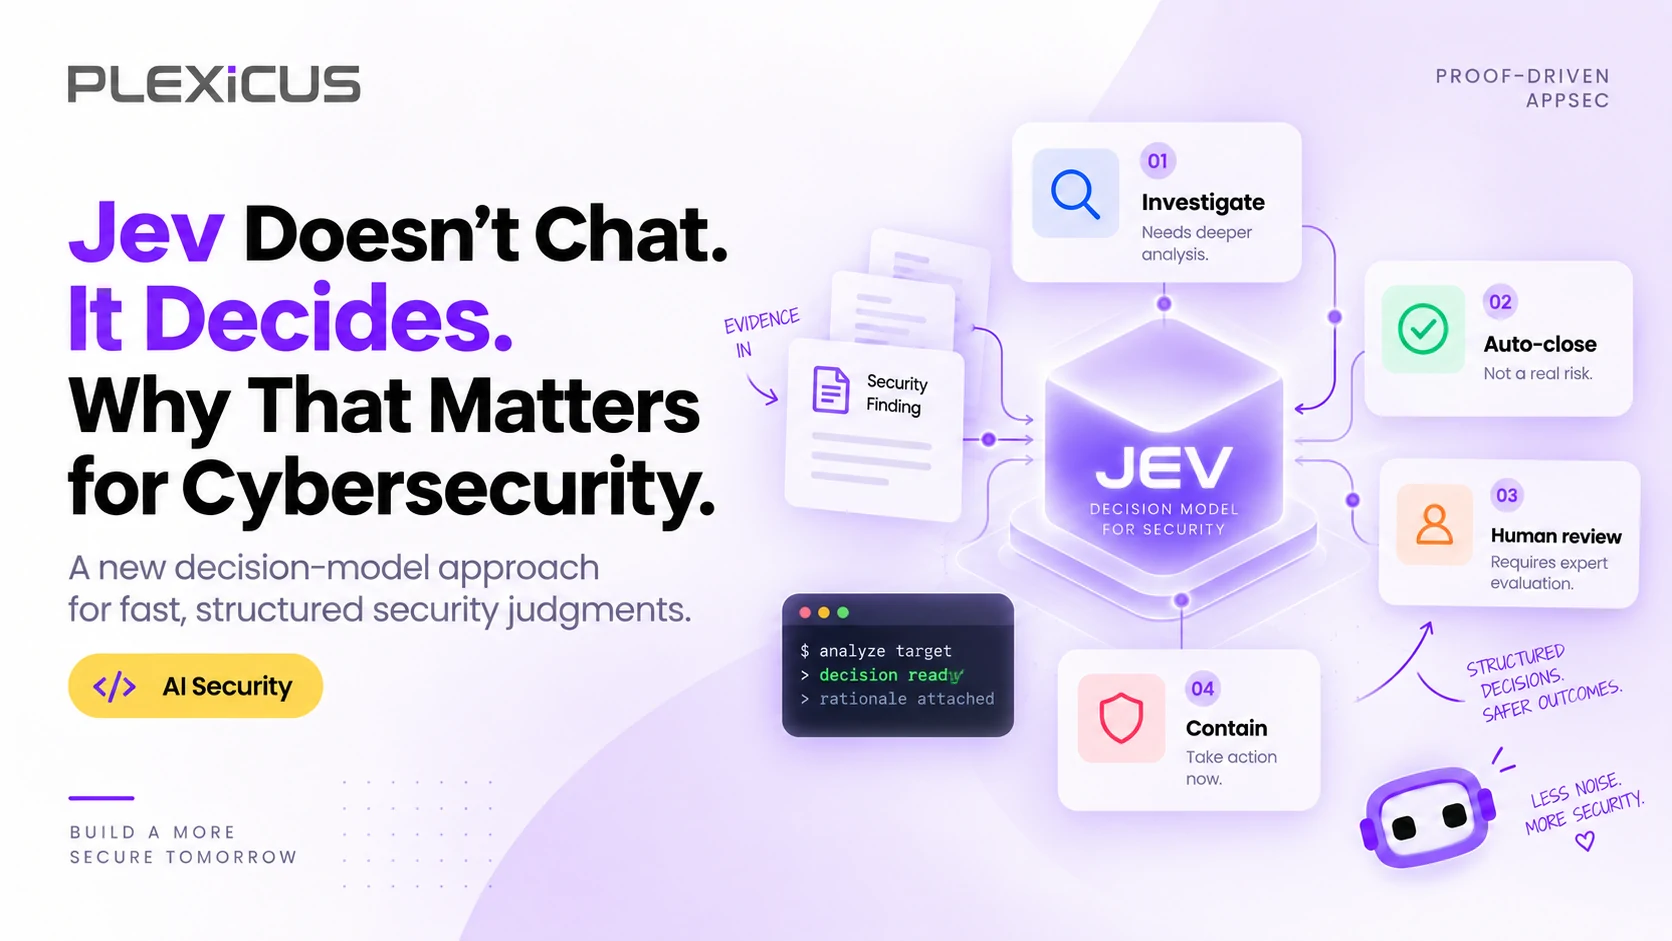
Jev produit des décisions typées plutôt que de la prose. Cette approche peut placer le jugement sémantique dans les flux de sécurité, avec politique, repli, vérification et revue humaine.
Au-delà de l’ASPM
Une AppSec fondée sur la preuve pour les équipes qui développent avec l’IA
Plexicus utilise AI Swarm Pentest pour explorer des chemins d’application autorisés, valider ce qui est exploitable et fournir les preuves nécessaires pour prioriser la remédiation.
Découvrir AI Swarm PentestJev AI est un modèle de décision de TypeSafe AI qui renvoie des choix, des scores et des probabilités typés au lieu de texte généré. Pour l’IA en cybersécurité, c’est important : les systèmes de sécurité prennent des millions de petites décisions urgentes, et un modèle qui tranche en moins d’une seconde, pour une fraction de centime, pourrait apporter du contexte sémantique là où les grands LLM sont trop lents ou trop coûteux.
La course à l’IA a longtemps demandé quel modèle écrit la meilleure réponse. TypeSafe pose une autre question : que se passe-t-il si le logiciel a besoin d’une décision, pas d’un texte ? Jev, lancé le 15 septembre 2026, reçoit un contexte et des questions définies à l’avance puis renvoie des choix, scores ou probabilités typés.
De la génération à la décision
Un LLM peut expliquer une alerte ; un système a souvent besoin de risque = critique, action = contenir, confiance = 0,97. Jev évite l’étape de prose : l’application définit les sorties et le modèle fournit les probabilités. Son intégration Vercel AI Gateway décrit des décisions Choice, Score et Boolean évaluées en parallèle.
L’évaluation Security Incidents de TypeSafe réunit alerte, actif, propriétaire, tickets, appareils, maintenance et autorisations. Elle estime activité non autorisée, explication disponible et force des preuves, puis peut examiner sessions, identifiants, processus, réseau et propagation avant de notifier, escalader, tuer un processus ou désactiver un compte. Le modèle estime ; la politique de sécurité applique.
Ce que disent les premières mesures
Les chiffres les plus spectaculaires de TypeSafe (70–500 ms de réponse annoncés) restent des résultats fournisseur ; l’entreprise reconnaît que ses plus grands gains représentent le haut de la plage réelle. L’étude de Nexus Agent fournit une preuve externe précoce : 19 118 moments réels, 36 218 appels, puis 469 cas de guardrails. Jev décide 58% des cas et totalise 90 erreurs avec repli sur les règles, contre 148 pour les règles, 99 pour Haiku et 92 pour Sonnet.
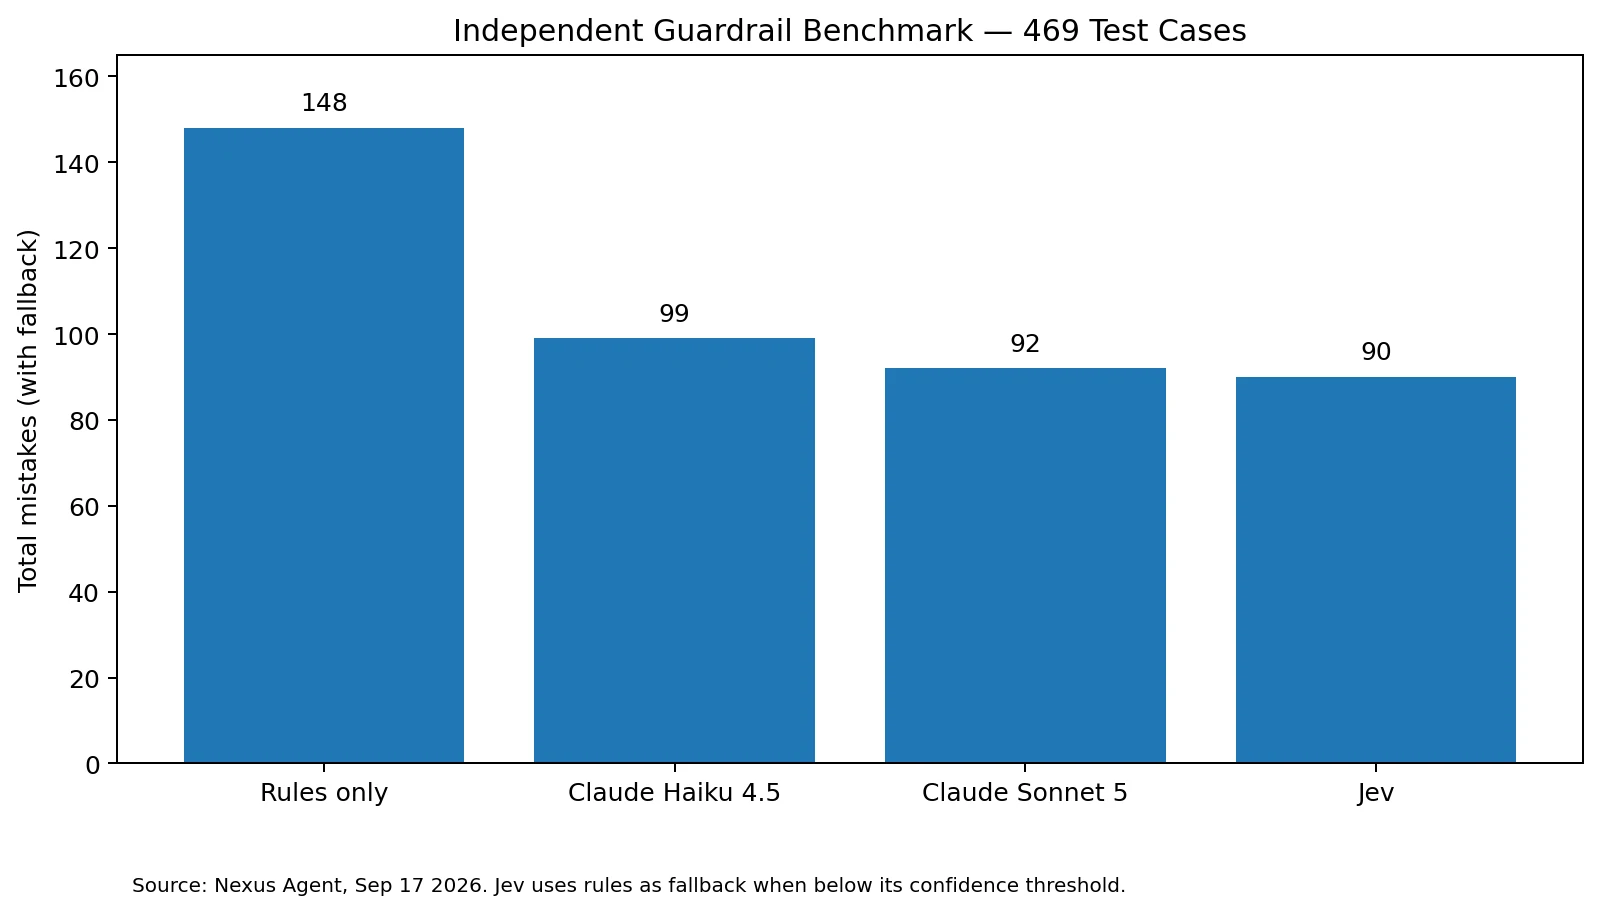
Figure 1. Source : Nexus Agent, 17 septembre 2026.
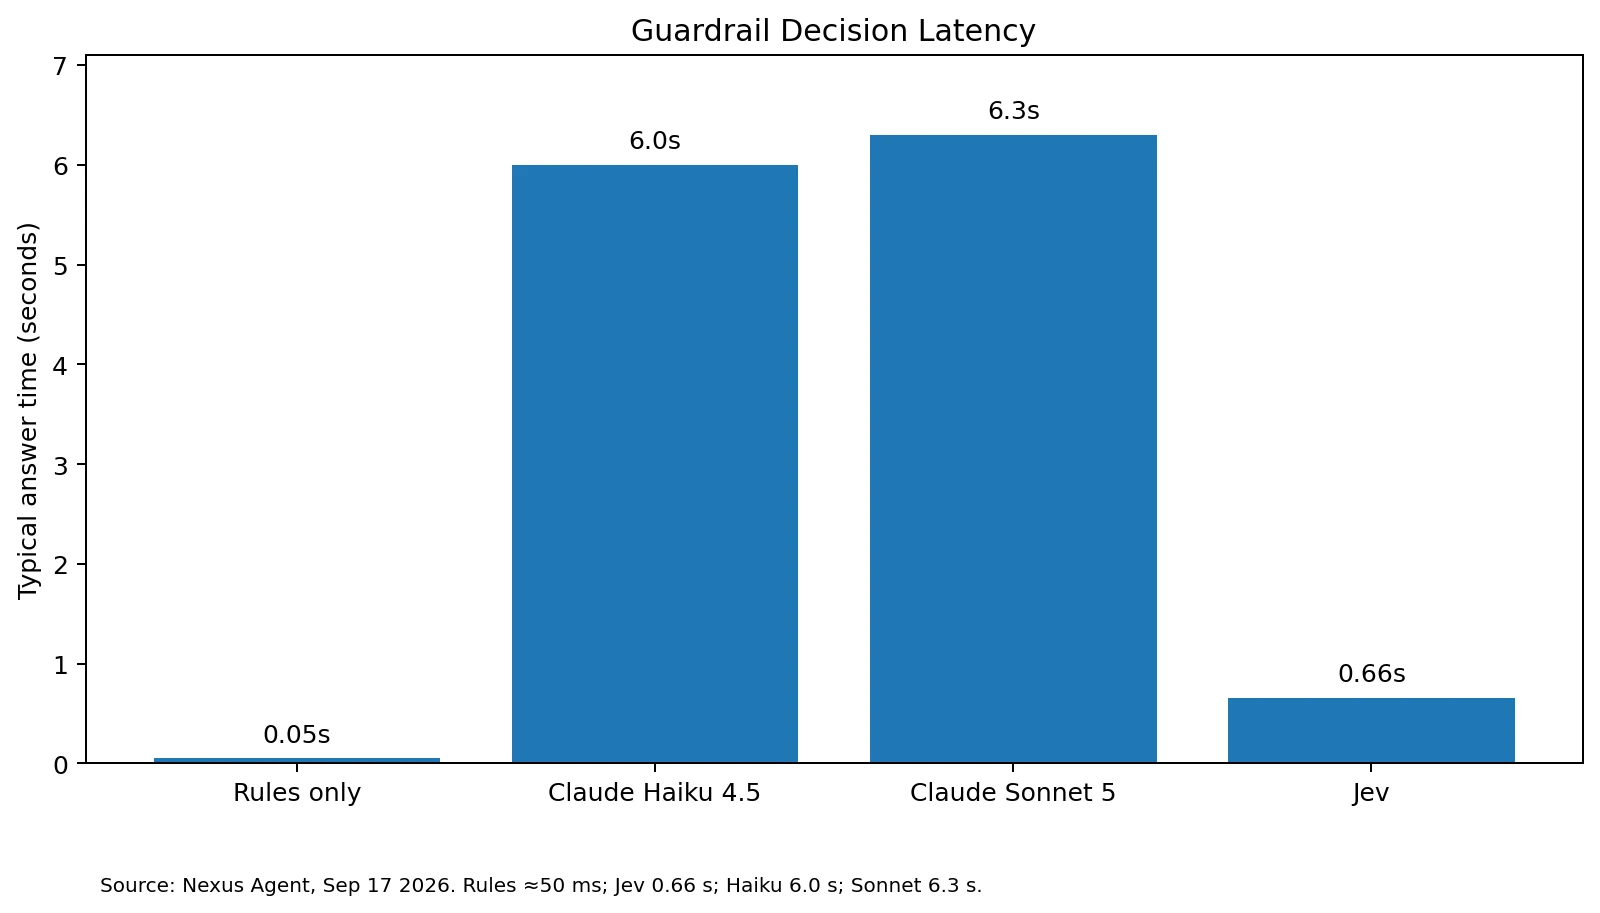
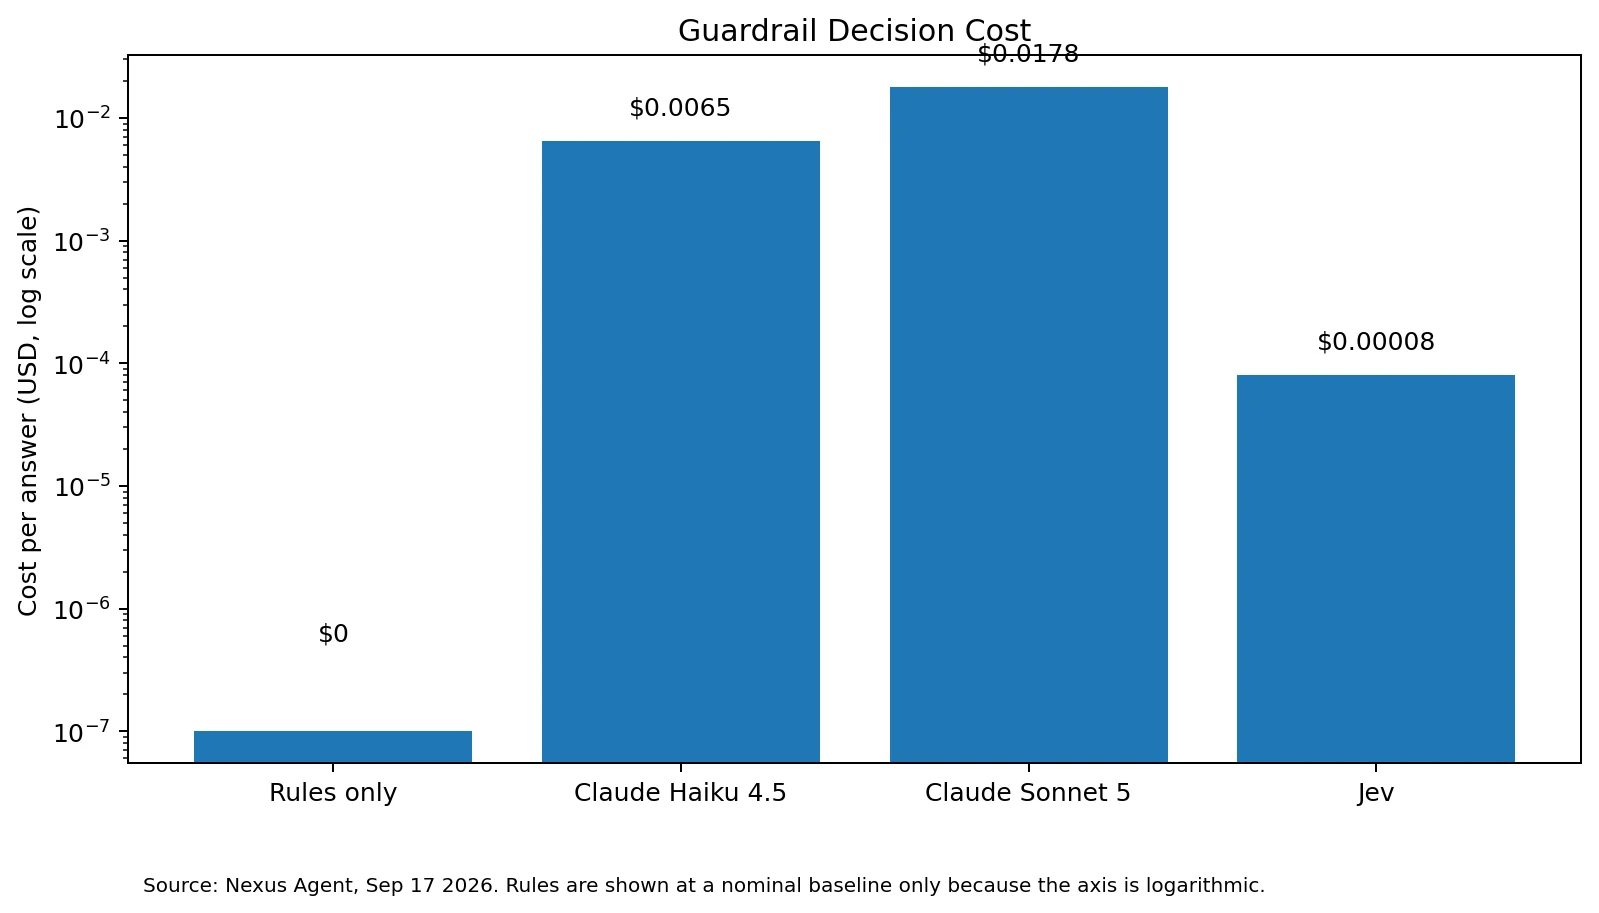
Le point important est la couverture : 1,8% d’erreur lorsqu’il décide ne signifie pas une précision universelle. Le modèle doit répondre lorsqu’il est confiant et remettre les cas incertains à des règles, un modèle plus puissant ou une personne. Nous approfondissons cette question de routage dans IA en sécurité applicative : automatisation ou augmentation ?. Nexus rapporte 0,68 seconde de latence médiane et 0,00008 USD par décision dans ce scénario.
Jev AI et l’IA pour la cybersécurité : un test important
Un SOC pourrait classer plus tôt les signaux en bénins, incertains et à haut risque. L’objectif n’est pas de remplacer les analystes, mais de réserver le raisonnement coûteux et l’attention humaine aux cas utiles. Pour les agents IA, une couche de décision peut évaluer le caractère destructeur, réversible et autorisé d’une action avant que la politique ne la bloque ou l’escalade — une réponse directe au risque Excessive Agency (LLM06) du OWASP Top 10 for LLM Applications. Le même modèle s’applique au DLP sémantique, au phishing, à l’IAM, à la fraude et à la priorisation des vulnérabilités.
La sûreté de type n’est pas la justesse : ALLOW peut rester faux quand BLOCK est nécessaire. Ces modèles sont des capteurs probabilistes, pas des moteurs de politique infaillibles. Le coût d’une erreur fixe le seuil : faible impact et forte confiance peuvent être automatisés ; incertitude, impact élevé ou irréversibilité exigent enquête, contrôles et autorisation.
Jev ne remplace ni le raisonnement profond ni le jugement humain. Ce travail reste l’affaire de systèmes de raisonnement, comme les modèles de pointe tels que Claude Opus 5.5 ou les outils multi-agents comme un AI Swarm Pentest. Il peut devenir une couche spécialisée entre détection, raisonnement, vérification, politique et action. Évaluation éditoriale : conserver des limites d’autorisation déterministes, une vérification indépendante, des replis et une revue humaine pour toute action conséquente. Nous expliquons pourquoi la preuve compte dans de l’alerte au correctif avec l’AppSec fondée sur la preuve.
Questions fréquentes
Qu’est-ce que Jev AI ?
Jev est un modèle de décision présenté par TypeSafe AI en septembre 2026 comme le premier de ce que l’entreprise appelle les System One Models. Au lieu de générer du texte, il reçoit un contexte et des questions prédéfinies, puis renvoie des réponses typées Choice, Score ou Boolean avec des probabilités directement exploitables par un logiciel. TypeSafe annonce des temps de réponse de 70 à 500 ms.
En quoi Jev AI diffère-t-il d’un LLM comme GPT ou Claude ?
Un LLM classique génère de la prose jeton par jeton, que le logiciel doit ensuite analyser. Jev évalue des questions prédéfinies en parallèle et ne renvoie que les types de réponse autorisés : il ne peut donc pas produire de sortie mal formée. Il échange le raisonnement ouvert et la génération de texte contre la vitesse, un faible coût et des décisions structurées, en complément des modèles de raisonnement.
Jev AI peut-il servir en cybersécurité ?
Potentiellement. TypeSafe a publié une évaluation de workflow consacrée aux incidents de sécurité, et Nexus Agent a testé Jev comme garde-fou pour des agents IA. Les usages probables incluent le triage SOC, le contrôle des actions d’agents, le DLP sémantique, l’analyse du phishing et la priorisation des vulnérabilités. Les preuves restent précoces : validez-le sur vos propres données.
« Typé » signifie-t-il que Jev AI ne se trompe pas ?
Non. La sûreté de type garantit que la sortie respecte le schéma défini par l’application, par exemple ALLOW, REVIEW ou BLOCK, mais pas que le choix soit juste. Dans l’évaluation de Nexus, Jev s’est trompé sur 1,8 % des cas qu’il a tranchés et a renvoyé 42 % des cas vers des règles de repli. Les actions conséquentes exigent toujours politique, vérification et revue humaine.
Comment adopter l’IA pour la cybersécurité en toute sécurité ?
Traitez les sorties du modèle comme des signaux probabilistes, pas comme une autorité finale. Fixez les seuils de confiance selon le coût d’une erreur, conservez des limites d’autorisation déterministes, orientez les cas incertains vers un modèle plus puissant ou un humain et vérifiez les résultats de façon indépendante. Le NIST AI Risk Management Framework et l’OWASP Top 10 for LLM Applications sont de bons points de départ.
Sources