MAESTRO-Framework: Praxisleitfaden mit 7 Ebenen für das Threat Modeling agentischer KI
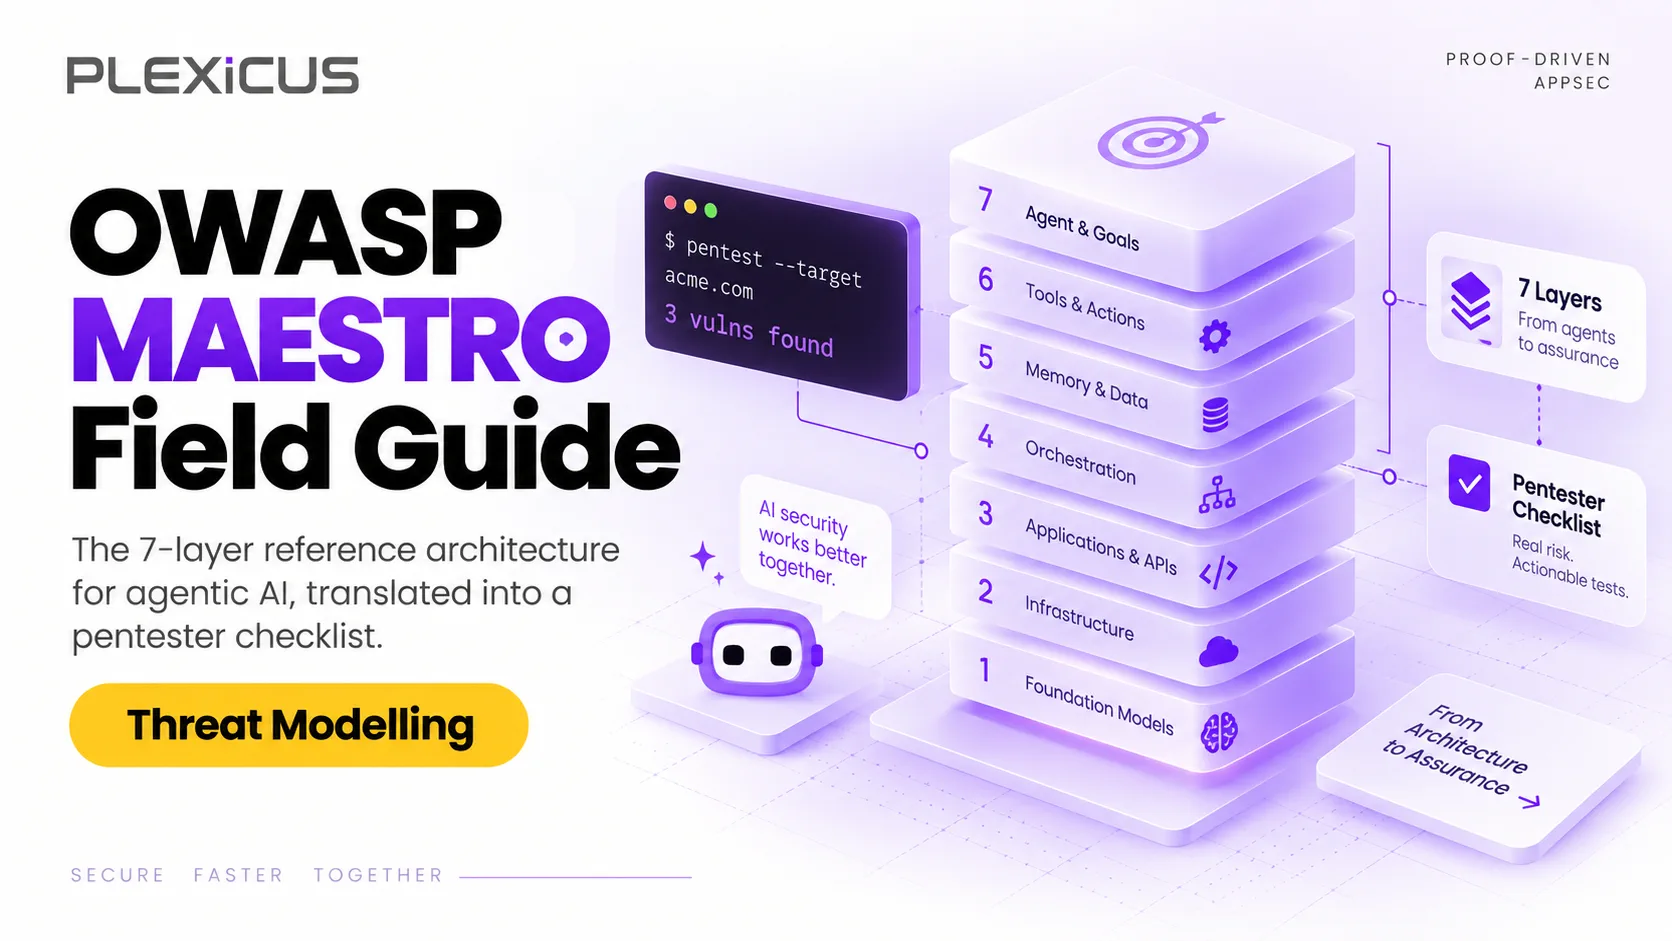
MAESTRO ist das 7-Ebenen-Framework der Cloud Security Alliance für das Threat Modeling agentischer KI, das vom OWASP GenAI Security Project angewendet wird. Dieser Leitfaden macht jede Ebene zu einer Pentest-Checkliste.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenDas MAESTRO-Framework (Multi-Agent Environment, Security, Threat, Risk, and Outcome) ist eine Methode zur Bedrohungsmodellierung agentischer KI-Systeme mit sieben Ebenen. Ken Huang stellte es im Februar 2025 über die Cloud Security Alliance vor. Der Multi-Agentic System Threat Modeling Guide des OWASP GenAI Security Project (April 2025) baut darauf auf. Deshalb nennen viele Teams es „OWASP MAESTRO“. Dieser Praxisleitfaden macht jede MAESTRO-Ebene zu einer Checkliste für Pentester.
Jedes Threat-Modeling-Framework, das Ihr Sicherheitsteam bisher eingesetzt hat, wurde für von Menschen geschriebene Software entwickelt. STRIDE zielt auf klassische Anwendungsschwachstellen. PASTA ist ein risikozentrierter Prozess mit Angriffssimulation. LINDDUN behandelt Datenschutzbedrohungen. OCTAVE dient dem organisatorischen Risikomanagement. Trike und VAST konzentrieren sich darauf, Threat Modeling über Teams hinweg zu skalieren.
Keines davon modelliert die Angriffsfläche eines Agenten. Keines hat eine Ebene für „Die Trainingsdaten des Modells wurden vergiftet“. Keines hat eine Ebene für „Die Tool-Beschreibung des Agenten wurde nach der Freigabe umgeschrieben“. Keines hat eine Ebene für „Der Reasoning-Trace des Agenten weicht von seinem erklärten Ziel ab“.
MAESTRO wurde für genau diese Lücke entwickelt. Statt ältere Methoden zu verwerfen, erweitern die Autoren der CSA Kategorien aus STRIDE, PASTA und LINDDUN um KI-spezifische Bedrohungen und ordnen sie Ebene für Ebene. Der Rest dieses Leitfadens beschreibt konkrete Angriffsmuster, Erkennungssignale und Gegenmaßnahmen für jede Ebene.
Was ist das MAESTRO-Framework?
MAESTRO ist eine Referenzarchitektur mit 7 Ebenen für die Sicherheit agentischer KI. Es übernimmt nützliche Teile aus STRIDE und PASTA, modelliert die Angriffsfläche aber von unten nach oben und berücksichtigt, was entsteht, wenn ein KI-Agent Folgendes besitzt:
- Ein dauerhaftes Gedächtnis
- Tool-Aufruffunktionen (häufig über MCP)
- Eine mehrstufige Reasoning-Schleife
- Die Fähigkeit, auf externe Systeme einzuwirken
Die sieben Ebenen, von unten nach oben:
- Foundation Models — die LLMs, die den Agenten antreiben
- Data Operations — die Pipelines, die dem Modell Kontext zuführen
- Agent Frameworks — die Laufzeitumgebung, die die Agentenschleife orchestriert
- Deployment & Infrastructure — die Umgebung, in der der Agent ausgeführt wird
- Evaluation & Observability — wie das Verhalten des Agenten gemessen und protokolliert wird
- Security & Compliance — die Kontrollen, die den Agenten steuern
- Agent Ecosystem — die anderen Agenten, Tools und Dienste, mit denen der Agent interagiert
Im CSA-Original ist Security & Compliance eine vertikale Ebene, die die übrigen sechs durchzieht, statt auf ihnen aufzubauen. Jede Ebene hat ihr eigenes Bedrohungsmodell, ihre eigenen Angriffsmuster und Gegenmaßnahmen. Allgemeine Threat Models fassen das meiste davon in einer einzigen Kategorie „Externe Abhängigkeiten“ zusammen. MAESTRO trennt diese Bereiche.
MAESTRO und OWASP: Wer veröffentlicht was?
- Cloud Security Alliance (CSA): der ursprüngliche MAESTRO-Beitrag von Ken Huang vom 6. Februar 2025.
- OWASP GenAI Security Project, Agentic Security Initiative: die Taxonomie Agentic AI Threats and Mitigations (Februar 2025) und der Multi-Agentic System Threat Modeling Guide (April 2025), der MAESTRO auf reale Multi-Agenten-Systeme anwendet.
Das Ergebnis ist ein Framework, das Pentester für agentische KI als Checkliste verwenden können. Der Rest dieses Leitfadens ist genau diese Checkliste.
Ebene 1 — Foundation Models
Angriffsfläche
Das Modell selbst, seine Gewichte, seine Trainingsdaten und die Lieferkette, über die es entstanden ist.
Angriffsmuster
- Modellvergiftung über Trainingsdaten. Ein Datensatz-Beitragender schleust manipulierte Beispiele ein. Das Modell lernt den Trigger, der dann in der Produktion aktiviert wird.
- Exfiltration von Modellgewichten. Ein Angreifer kompromittiert die Modellregistrierung und kopiert die Gewichte. Das Modell steht nun Wettbewerbern oder für adversariales Fine-Tuning zur Verfügung.
- Manipulierte Checkpoints auf Hugging Face. Ein öffentlich verfügbares Fine-Tuning eines bekannten Modells enthält eine Hintertür. Der nachgelagerte Agent übernimmt sie.
- Adversariales Fine-Tuning eines Open-Source-Basismodells. Ein Team verwendet Llama 4 oder Mistral als Basis. Ein Angreifer veröffentlicht eine scheinbar „sicherheitsoptimierte“ Variante, die subtil fehlkalibriert wurde. Das Team greift zur falschen Version.
Erkennungssignale
- Hash stimmt nicht mit den erwarteten und geladenen Gewichten überein
- Verdächtige Gradienten-Updates während des Fine-Tunings
- Nachgelagertes Verhalten, das durch seltene Eingaben ausgelöst wird (probabilistische Erkennung von Hintertüren)
- Ungewöhnliche Ausschläge in der Loss-Kurve während des Trainings
Gegenmaßnahmen
- Modellversionen per Hash statt per Name fixieren
- Gewichte aus attestierten Registrierungen beziehen (signierte Commits auf Hugging Face, intern signierte Artefakte)
- Vor dem Deployment eine Prüfung der Robustheit gegen adversariale Angriffe durchführen
- Eine Allowlist von Modellanbietern mit verifizierter Herkunft pflegen
Ebene 2 — Data Operations
Angriffsfläche
Die Daten, die der Agent zur Laufzeit verarbeitet: RAG-Korpora, Prompt-Vorlagen, Gesprächsverlauf, Tool-Ausgaben und alle weiteren Kontextinformationen, die bei der Inferenz in das Modell fließen.
Angriffsmuster
- Indirekte Prompt Injection über RAG-Dokumente. OWASP LLM01 definiert indirekte Prompt Injection als Eingabe, die das Modell aus externen Quellen wie Websites oder Dateien übernimmt. Der Angreifer platziert Text in einem Dokument, das der Agent später abruft. Darin stehen Anweisungen, denen der Agent so folgt, als kämen sie vom Nutzer.
- Einschleusen in Prompt-Vorlagen. Der Angreifer ändert eine gespeicherte Prompt-Vorlage und fügt Anweisungen hinzu, die die Sicherheitsebene des Agenten umgehen.
- Vergiftung von Tool-Ausgaben. Der Agent ruft ein Tool auf. Das Tool liefert eine Zeichenfolge mit eingeschleusten Anweisungen zurück. Der Agent behandelt die Tool-Ausgabe als vertrauenswürdige Anweisungsquelle.
- Vergiftung des Gedächtnisses. Der Agent schreibt in sein Langzeitgedächtnis. Der Angreifer kann in denselben Speicher schreiben (oft eine Vektordatenbank). Bei späteren Abrufen erscheinen die Anweisungen des Angreifers.
- Log-Injection. Der Agent protokolliert seinen Reasoning-Trace. Der Angreifer schleust Text in das Log ein. Ein Überwachungsagent liest das Log und behandelt den eingeschleusten Text als Anweisung.
Erkennungssignale
- Tool-Ausgaben mit mustertypischen Anweisungen (Imperativ, direkte Anrede)
- RAG-Dokumente mit ungewöhnlich hoher Anweisungsdichte
- Gedächtniseinträge, die nicht zum beobachteten Interaktionsverlauf des Agenten passen
- Log-Einträge mit Sprachmustern, die nicht zur Persona des Agenten passen
Gegenmaßnahmen
- Alle abgerufenen Inhalte und Tool-Ausgaben als nicht vertrauenswürdige Daten behandeln, nicht als Anweisungen
- Einen separaten Anweisungskanal (System-Prompt) verwenden, der vom Datenkanal isoliert ist
- Tool-Ausgaben durch einen strukturierten Parser statt durch rohe Zeichenkettenverkettung verarbeiten
- Die Herkunft jedes Gedächtniseintrags nachverfolgen
Ebene 3 — Agent Frameworks
Angriffsfläche
Die Laufzeitumgebung, die die Agentenschleife orchestriert: Planungsmodul, Tool-Auswahllogik, Schnittstelle zum Gedächtnis, Reasoning-Trace und Ausführungsplaner.
Angriffsmuster
- Manipulation des Reasoning-Traces. Der Chain-of-Thought des Agenten wird in Logs offengelegt. Der Angreifer liest den Trace, erkennt das Ziel und platziert eine irreführende Beobachtung, die den nächsten Schritt umlenkt.
- Übernahme der Tool-Auswahl. Der Agent wählt Tools anhand eines Planers aus. Der Angreifer registriert ein bösartiges Tool mit einem Namen, der einem legitimen ähnelt. Der Planer wählt das falsche Tool.
- Schleifenverstärkung (Denial of Wallet). Der Agent gerät in eine Reasoning-Schleife, die API-Tokens verbraucht. Sie läuft unbegrenzt, bis das Budget aufgebraucht ist.
- Ausbruch eines Sub-Agenten. Ein Supervisor-Agent startet einen Sub-Agenten. Dieser unterliegt weniger Einschränkungen als der Supervisor und führt Aktionen aus, die der Supervisor nicht genehmigt hätte.
- Abweichung zwischen Reasoning und Aktion. Das erklärte Reasoning des Agenten weicht von seinen tatsächlichen Aktionen ab. Der Auditor liest den Trace und sieht kein Problem. Die Aktionen erzählen eine andere Geschichte.
Erkennungssignale
- Reasoning-Traces mit Formulierungen, die nicht zur Persona oder zu den Zielen des Agenten passen
- Tool-Auswahlen, die nicht dem erklärten Plan des Agenten entsprechen
- Ungewöhnliche Token-Ausgaben pro Agentenaufruf
- Aufrufe von Sub-Agenten, die das angegebene Budget des Supervisors überschreiten
- Abweichungen zwischen Trace und Aktionslogs
Gegenmaßnahmen
- Planungsmodul und Ausführungsmodul voneinander isolieren
- Tool-Aufrufe außerhalb einer Allowlist nur nach ausdrücklicher Bestätigung zulassen
- Token-Ausgaben pro Aufruf und pro Sitzung begrenzen
- Eine strikte Hierarchie von Supervisor und Sub-Agenten mit Regeln zur Vererbung von Berechtigungen pflegen
- Reasoning-Traces fortlaufend mit Aktionslogs vergleichen
Ebene 4 — Deployment & Infrastructure
Angriffsfläche
Die Laufzeitumgebung des Agenten: Container, serverlose Funktionen, VMs, das zugrunde liegende Betriebssystem, die vom Agenten verwendeten Geheimnisse und die erreichbaren Netzwerkpfade.
Angriffsmuster
- Container-Ausbruch. Der Agent läuft in einem Container. Eine Schwachstelle in der Container-Laufzeit ermöglicht den Ausbruch auf den Host. Der Agent erhält nun die Berechtigungen des Hosts.
- Diebstahl von Laufzeit-Zugangsdaten. Der Agent hat API-Schlüssel, Datenbank-Zugangsdaten oder OAuth-Tokens in seiner Umgebung. Eine Prompt Injection in einer Tool-Ausgabe veranlasst den Agenten, sie zu exfiltrieren.
- Seitwärtsbewegung zu internen Diensten. Der Agent kann interne Dienste im Netzwerk erreichen. Der Angreifer nutzt ihn als Sprungbrett.
- Persistente Hintertür in der Laufzeitumgebung. Der Angreifer installiert eine Hintertür im Container-Image des Agenten. Bei jedem erneuten Deployment wird sie wieder eingeführt.
- Datenleck über Seitenkanäle. Das Rechenverhalten des Agenten (Laufzeit, GPU-Auslastung) gibt Informationen über den Prompt oder den Modellzustand preis.
Erkennungssignale
- Unerwartete ausgehende Verbindungen aus der Laufzeitumgebung des Agenten
- Ungewöhnliche Datei- oder Netzwerkaktivität
- Abweichungen des Containers vom bekannten, vertrauenswürdigen Image
- Diskrepanz zwischen deklarierten und tatsächlichen Egress-Regeln
Gegenmaßnahmen
- Den Agenten mit den minimal erforderlichen Berechtigungen ausführen (Dateisystem schreibgeschützt, ausgehender Netzwerkverkehr nur zu erlaubten Endpunkten)
- Container-Images aus attestierten Registrierungen beziehen und ihre Hashes fixieren
- Egress-Allowlist durch Netzwerkrichtlinien erzwingen
- Zugangsdaten bei jedem Neustart des Agenten rotieren
- Laufzeit-Bedrohungserkennung (z. B. Falco, Tetragon) auf dem Host des Agenten einsetzen
Ebene 5 — Evaluation & Observability
Angriffsfläche
Die Telemetrie-, Protokollierungs-, Evaluations- und Observability-Infrastruktur zur Überwachung des Agenten.
Angriffsmuster
- Vergiftung von Logs. Die Logs des Agenten enthalten Tool-Ausgaben. Der Angreifer schleust Text in eine Tool-Ausgabe ein, die in die Logs gelangt. Das SIEM übernimmt den Log-Eintrag und behandelt den eingeschleusten Text als Alarmbeschreibung.
- Manipulation der Telemetrie. Der Evaluator des Agenten meldet scheinbar gesunde Messwerte. Die Werte sind gefälscht; der Agent verhält sich fehlerhaft.
- Vergiftung des Evaluationsdatensatzes. Der Evaluationsdatensatz liegt am selben Ort wie Produktionsdaten. Der Angreifer verändert ihn. Der Agent „besteht“ nun Evaluierungen, die das reale Verhalten nicht mehr abbilden.
- Kollusion zwischen Evaluator und Agent. Ein separater Agent bewertet den Produktionsagenten. Beide sind über dieselbe Prompt-Injection-Senke erreichbar. Der Angreifer nutzt diese, um den Evaluator zu manipulieren.
Erkennungssignale
- Log-Einträge mit Sprachmustern, die nicht zum Agenten passen
- Plötzliche Metrikverbesserungen ohne entsprechende Änderungen im Betrieb
- Änderungen an Hashes des Evaluationsdatensatzes ohne zugehörigen Code- oder Daten-Commit
- Abweichungen zwischen Ausgabe des Evaluators und Beobachtungen der Ground Truth
Gegenmaßnahmen
- Protokollierungskanal und Datenkanal des Agenten voneinander trennen
- Alle Evaluationsdatensätze signieren und hashen; bei Hash-Abweichungen alarmieren
- Ausgaben des Evaluators als nicht vertrauenswürdig behandeln und mit Rohtelemetrie abgleichen
- Externe Ground-Truth-Signale (z. B. Nutzerfeedback, Änderungen im führenden System) zur Validierung der Evaluationsergebnisse nutzen
Ebene 6 — Security & Compliance
Angriffsfläche
Die Kontrollen, Richtlinien und Compliance-Vorgaben, die das Verhalten des Agenten steuern: RBAC, Durchsetzung des Scopes, Audit-Protokollierung, Freigabe durch einen Menschen und Policy-as-Code-Artefakte mit den Regeln.
Angriffsmuster
- Scope-Ausweitung durch Tool-Verknüpfung. Jedes Tool des Agenten hat einen engen Scope. Der Agent verkettet Tools so, dass die Kombination einen größeren Scope hat als jedes einzelne Tool.
- Umgehung der Freigabe durch einen Menschen. Der Freigabeprozess setzt voraus, dass ein Mensch eine gefährliche Aktion ablehnt. Der Agent beschreibt die Aktion verwirrend, und der Mensch genehmigt sie.
- Einschleusen in Policy-as-Code. Die Policy-Engine liest Regeln aus einem versionierten Artefakt. Der Angreifer ändert dieses Artefakt. Der Agent arbeitet nun unter neuen Regeln.
- Manipulation des Audit-Logs. Der Agent kann auf sein eigenes Audit-Log zugreifen. Der Angreifer nutzt ihn, um das Log zu ändern und Spuren zu verwischen.
Erkennungssignale
- Tool-Aufrufe, die den deklarierten Scope eines einzelnen Tools überschreiten
- Freigabemuster, die nicht zur vom Agenten beschriebenen Aktion passen
- Änderungen am Hash des Policy-Artefakts ohne zugehörigen Commit
- Nachträglich veränderte Audit-Log-Einträge
Gegenmaßnahmen
- Berechtigungen auf Ebene der Tool-Verknüpfung prüfen, nicht nur für einzelne Tools
- Neben der Aktion selbst eine verständliche Zusammenfassung verlangen
- Policy-Artefakte signieren und hashen; bei Abweichungen alarmieren
- Audit-Logs in einem nur ergänzbaren Speicher ablegen, auf den der Agent nicht zugreifen kann
Ebene 7 — Agent Ecosystem
Angriffsfläche
Die anderen Agenten, Tools, MCP-Server, externen Dienste und Menschen, mit denen der Agent in der Produktion interagiert.
Angriffsmuster
- MCP-Tool-Poisoning. Der MCP-Server ändert die Beschreibung seines Tools, nachdem der Agent es freigegeben hat („Rug Pull“, dokumentiert von Invariant Labs). Die neue Beschreibung sieht ein anderes Verhalten vor.
- Kompromittierung des MCP-Servers. Der MCP-Server selbst wird kompromittiert. Die Tool-Aufrufe des Agenten laufen nun über vom Angreifer kontrollierten Code.
- Prompt Injection zwischen Agenten. Agent A und Agent B kommunizieren miteinander. Der Angreifer platziert Anweisungen im Kontext von A, die gezielt B ansprechen.
- Lieferkettenangriff auf den Tool-Marktplatz. Ein von der Community veröffentlichtes Tool enthält bösartigen Code. Der Agent importiert es. Beim ersten Einsatz exfiltriert das Tool Zugangsdaten.
- Identitätsbetrug gegenüber Menschen. Der Agent erhält eine Nachricht, die von einem menschlichen Operator zu stammen scheint. Tatsächlich ist der Absender der Angreifer. Der Agent folgt den Anweisungen.
Erkennungssignale
- Abweichungen in Tool-Beschreibungen nach der Freigabe
- Unerwartete Verhaltensänderungen bei langfristig eingesetzten Tools
- Nachrichten zwischen Agenten mit anweisungsähnlichen Inhalten
- Tools aus Marktplätzen mit niedriger Herkunftsbewertung
- Operator-Nachrichten mit ungewöhnlichen Mustern
Gegenmaßnahmen
- MCP-Tool-Beschreibungen zum Zeitpunkt der Freigabe fixieren und bei Änderungen alarmieren
- Eine Tool-Allowlist mit Herkunftsanforderungen verwenden
- Kommunikation zwischen Agenten durch strukturierte Nachrichten in einer Sandbox isolieren
- Für Anweisungen von Operatoren eine Multi-Faktor-Authentifizierung verlangen
- Ein Tool-Inventar mit Risikobewertungen pflegen
Durchgespieltes Beispiel — Hexstrike-AI
Im September 2025 berichtete Check Point, dass Bedrohungsakteure über Hexstrike-AI sprachen: ein offensives Framework, dessen FastMCP-Server LLMs (Claude, GPT, Copilot) mit mehr als 150 Sicherheitstools verbindet. Sie diskutierten es als Möglichkeit, die am 26. August 2025 bekannt gegebenen Citrix-NetScaler-Schwachstellen CVE-2025-7775, CVE-2025-7776 und CVE-2025-8424 auszunutzen. Forumsbeiträge behaupteten, das Framework reduziere die Zeit bis zum Exploit von mehreren Tagen auf weniger als 10 Minuten.
Hexstrike-AI ist der Agent des Angreifers, nicht das Opfer. Genau deshalb eignet es sich gut als MAESTRO-Übung: Welche Fragen müsste jede Ebene beantworten, wenn ein Agent mit demselben Design in Ihrer Umgebung liefe — als Red-Team-Tool oder als interne Automatisierung mit denselben Tool-Reichweiten? Die folgende Tabelle ist unsere illustrative Zuordnung und keine Feststellung aus dem Check-Point-Bericht.
| MAESTRO-Ebene | Fragen zu einem Agenten wie Hexstrike-AI |
|---|---|
| L1 — Foundation Models | Er nutzt LLMs von Drittanbietern; Modellverhalten und Schutzmechanismen liegen außerhalb Ihrer Kontrolle |
| L2 — Data Operations | Scan-Ergebnisse und Tool-Ausgaben fließen zurück in den Modellkontext und schaffen einen Pfad für indirekte Prompt Injection von feindlichen Zielen |
| L3 — Agent Frameworks | Der Orchestrator wählt aus mehr als 150 Tools; ähnlich benannte oder übernommene Tools könnten ihn fehlleiten |
| L4 — Deployment & Infrastructure | Wo auch immer der MCP-Server läuft: Seine Netzwerkreichweite und Zugangsdaten machen ihn zu einem Sprungbrett |
| L5 — Evaluation & Observability | Ohne Logs für jeden Tool-Aufruf lässt sich ein automatisierter Scan-and-Exploit-Lauf nur schwer rekonstruieren |
| L6 — Security & Compliance | Der Operator setzt den Scope durch, nicht das Tool; eine verkettete Angriffskette kann den autorisierten Zielbereich verlassen |
| L7 — Agent Ecosystem | Die MCP-Ebene ist die wichtigste Angriffsfläche; Tool-Beschreibungen und Community-Tools brauchen Fixierung und Herkunftsnachweise |
Die MAESTRO-Zuordnung macht die Angriffsfläche auf jeder Ebene nachvollziehbar. Pentester, die einen ähnlichen Agenten untersuchen, erhalten eine Checkliste, die von unten nach oben führt. Dasselbe Muster — Agenten, die mit echten Tools verbunden sind — findet sich auch in gängigen Plattformen. Unsere Analyse des OpenAI-DevDay-2026-Agent-Stacks betrachtet ihn aus Sicht der Verteidigung.
MAESTRO-Checkliste für Pentester zur Bedrohungsmodellierung
Klären Sie für jede Ebene vor Beginn eines Pentests eines agentischen KI-Systems folgende Punkte:
- L1 — Modelle: Welche Modelle betreiben den Agenten? Woher stammen sie? Sind die Gewichte fixiert?
- L2 — Daten: Welche Daten liest der Agent zur Laufzeit? Behandelt er abgerufene Inhalte als Anweisungen oder als Daten?
- L3 — Frameworks: Gibt es getrennte Planungs- und Ausführungsmodule? Werden die Fähigkeiten von Sub-Agenten vererbt oder eingeschränkt?
- L4 — Infrastruktur: Welche Berechtigungen hat die Laufzeit? Welche Egress-Richtlinie gilt? Ist das Image attestiert?
- L5 — Telemetrie: Was wird protokolliert? Wohin fließen die Logs? Kann der Agent sein eigenes Audit-Log ändern?
- L6 — Kontrollen: Wie wird der Scope auf Ebene der Tool-Verknüpfung durchgesetzt? An welchen Stellen geben Menschen Aktionen frei?
- L7 — Ökosystem: Welche MCP-Server verwendet der Agent? Sind die Tool-Beschreibungen fixiert? Mit welchen anderen Agenten kommuniziert er?
Das ist der Maßstab. Jeder Auftrag, der nicht alle sieben Ebenen abdeckt, ist unvollständig. Wenn Sie Tools für diesen Auftrag auswählen, ordnet unser Vergleich von KI-Penetrationstest-Tools den Markt nach Beweisqualität. Plexicus AI Swarm Pentest setzt signierte, im Scope begrenzte Angriffsagenten mit durch Replay verifizierten Ergebnissen ein. Die Ebenen 1 bis 3 stecken auch im Code — dort verfolgt Deep Code Analysis, wie nicht vertrauenswürdige Tool-Ausgaben einen Sink erreichen.
Warum ist MAESTRO für die Sicherheit agentischer KI wichtig?
Die Angriffsfläche agentischer KI wird nicht kleiner. Die Modelle werden leistungsfähiger, die Tool-Ökosysteme wachsen und die Lieferketten werden komplexer. In Unternehmen wird es immer mehr Agenten geben, und mehr des von ihnen verwendeten Codes wird maschinell geschrieben. Unsere eigenen Scans zeigen: 78 % der KI-generierten PRs enthielten eine Schwachstelle.
MAESTRO gehört zu den ersten Frameworks, die für diese Situation entwickelt wurden, und bietet der Branche ein gemeinsames Vokabular. Je früher Ihr Team es einführt, desto schneller sprechen Pentester, Threat Modeler und Auditoren dieselbe Sprache.
Teams, die warten, werden in ihren Audit-Berichten „KI-Sicherheit“ als einzelne Kontrolle aufführen. Teams, die MAESTRO jetzt einführen, erhalten eine mehrschichtige, evidenzgestützte und durch Replay verifizierbare Verteidigung in der Tiefe — genau das ist der Maßstab für Proof-Driven AppSec im Jahr 2026 und darüber hinaus.
Häufig gestellte Fragen
Was ist das MAESTRO-Framework?
MAESTRO (Multi-Agent Environment, Security, Threat, Risk, and Outcome) ist ein Framework zur Bedrohungsmodellierung agentischer KI. Es unterteilt ein Agentensystem in sieben Ebenen — von Foundation Models und Data Operations bis zum Agenten-Ökosystem — und führt Bedrohungen sowie Gegenmaßnahmen für jede Ebene auf. Es erweitert ältere Methoden wie STRIDE, PASTA und LINDDUN um KI-spezifische Bedrohungen wie Prompt Injection, Gedächtnisvergiftung und MCP-Tool-Poisoning.
Ist MAESTRO ein Framework von OWASP oder der Cloud Security Alliance?
Ken Huang stellte MAESTRO im Februar 2025 im Blog der Cloud Security Alliance vor. Die Agentic Security Initiative des OWASP GenAI Security Project veröffentlichte anschließend im April 2025 den Multi-Agentic System Threat Modeling Guide, der MAESTRO auf reale Multi-Agenten-Systeme anwendet. Deshalb sagen viele „OWASP MAESTRO“, obwohl das Framework selbst ursprünglich von der CSA stammt.
Welche sieben Ebenen hat MAESTRO?
Die sieben Ebenen sind Foundation Models, Data Operations, Agent Frameworks, Deployment & Infrastructure, Evaluation & Observability, Security & Compliance und Agent Ecosystem. Security & Compliance ist eine vertikale Ebene, die alle anderen durchzieht. Jede Ebene hat eine eigene Angriffsfläche. Ein MAESTRO-Threat-Model untersucht sie daher einzeln, statt den KI-Agenten als eine einzige Blackbox zu behandeln.
Worin unterscheidet sich das Threat Modeling mit MAESTRO von STRIDE?
STRIDE klassifiziert Bedrohungen für herkömmliche Software nach Typ (Spoofing, Tampering, Repudiation, Information Disclosure, Denial of Service und Elevation of Privilege). MAESTRO behält diese Denkweise bei, ordnet Bedrohungen aber nach den Ebenen eines Agentensystems und ergänzt Risiken, für die STRIDE keine Kategorie hat: vergiftete Trainingsdaten, Prompt Injection über Tools und Gedächtnis, Abweichungen zwischen Reasoning und Aktion sowie Vertrauen zwischen Tools, MCP-Servern und mehreren Agenten.
Wie setzt man MAESTRO für einen Sicherheitspentest agentischer KI ein?
Beginnen Sie mit Ebene 1 und arbeiten Sie sich nach oben. Listen Sie für jede Ebene die Komponenten im Scope auf, ordnen Sie ihnen die Angriffsmuster aus diesem Leitfaden zu und prüfen Sie, ob Erkennungssignale und Gegenmaßnahmen vorhanden sind. Testen Sie anschließend die riskantesten Pfade — meist indirekte Prompt Injection (Ebene 2), Tool-Auswahl (Ebene 3) und MCP-Server (Ebene 7) — und sichern Sie für jeden Fund reproduzierbare Nachweise.
Weiterführende Lektüre:
- Vom Alarm zur Behebung: den Kreislauf mit Proof-Driven AppSec schließen — der operative Kreislauf, auf den MAESTRO abgebildet wird
- Was ist Deep Code Analysis? — die statische Analyseebene als Ergänzung zu MAESTRO L1–L3
- 78 % der KI-generierten PRs enthalten eine Schwachstelle — der Produktionsfehler, den MAESTRO L2 und L7 modellieren sollen

