Cloudflare publie son skill d’audit de sécurité IA en open source : comment il fonctionne
Le skill open source de Cloudflare associe recherche guidée par la couverture, validation indépendante et preuves structurées. Voici ce que ce processus peut établir et ses limites.
Au-delà de l’ASPM
Une AppSec fondée sur la preuve pour les équipes qui développent avec l’IA
Plexicus utilise AI Swarm Pentest pour explorer des chemins d’application autorisés, valider ce qui est exploitable et fournir les preuves nécessaires pour prioriser la remédiation.
Découvrir AI Swarm PentestCloudflare a publié un skill open source qui fournit aux agents de programmation compatibles une méthode structurée pour auditer une base de code. Le principe est simple : une suspicion générée par l’IA reste une piste tant qu’une personne n’a pas suivi le code, vérifié la frontière de confiance et tenté de la réfuter de façon indépendante.
Cette distinction compte. Repérer une fonction qui semble risquée ne prouve pas qu’un attaquant puisse l’atteindre et agir sur une ressource protégée. Le dépôt security-audit-skill de Cloudflare intègre ce parcours de preuves au processus.
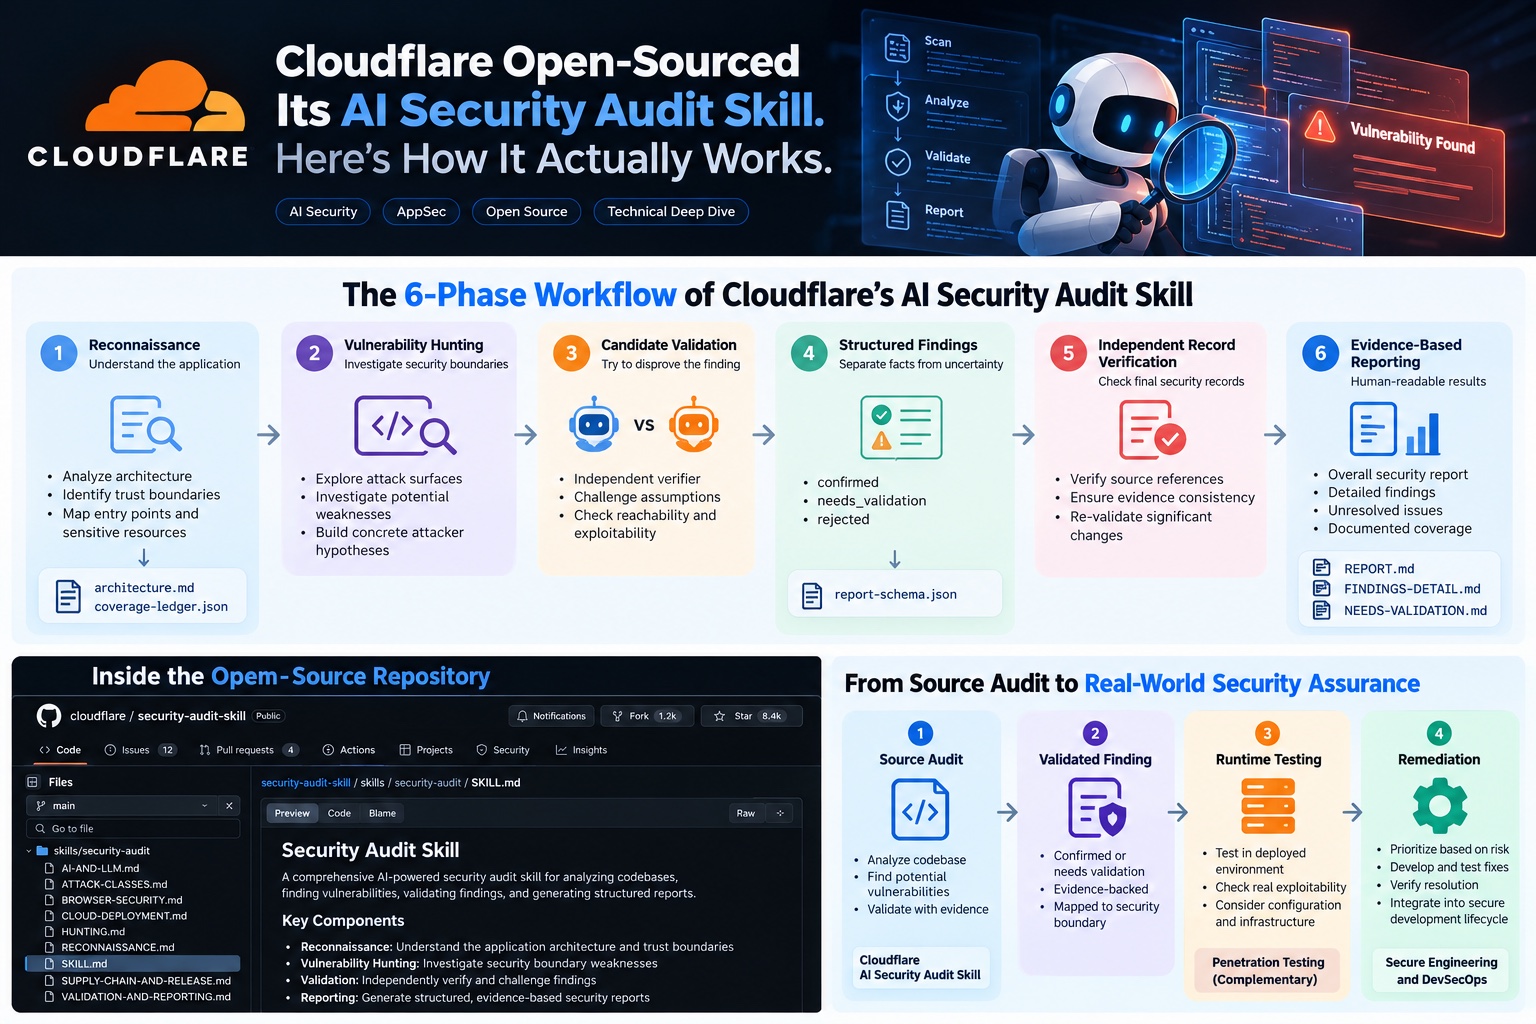
Illustration Plexicus. Tous les éléments d’interface — y compris les compteurs d’étoiles et de forks du dépôt — sont fictifs : ils ne représentent pas les données actuelles du dépôt Cloudflare ni une capture d’écran d’un produit Cloudflare.
Qu’est-ce que Cloudflare a publié en open source ?
Le dépôt public contient un skill pour agent de programmation qui audite un dépôt à la fois : des instructions, des guides sur les classes d’attaque, des règles de validation, des schémas et des scripts pour produire les enregistrements d’audit. Il est distribué sous licence MIT. Ce skill est le point de départ d’un système interne plus vaste, et non le système complet.
Dans son article du 18 juin 2026, « Build your own vulnerability harness », Cloudflare a décrit un workflow initial en sept étapes, puis son évolution vers un système interne de découverte de vulnérabilités. Le dépôt public actuel décrit six phases. Ces descriptions correspondent à des versions et à des périmètres différents ; il ne faut pas les fusionner en une seule séquence.
Cloudflare indique que son système interne couvrant plusieurs dépôts a traité 128 dépôts en environ six semaines. L’architecture interne apporte une orchestration persistante et un triage en aval, qui ne sont pas fournis automatiquement par l’installation du skill public. Le projet open source se comprend plutôt comme une méthode vérifiable pour un dépôt, que les équipes peuvent adapter.
Que contient le dépôt ?
Il comprend SKILL.md pour le workflow et les règles de sécurité ; des guides de reconnaissance et de recherche ; des références de classes d’attaque pour des sujets comme la sécurité IA/LLM, les protocoles Web, la chaîne d’approvisionnement, le cloud et le code côté client ; VALIDATION-AND-REPORTING.md ; report-schema.json ; et des validateurs Node.js sans dépendance pour les constats et le registre de couverture.
Le registre documente les parties du système examinées, par qui et avec quelles preuves. Les constats suivent un schéma qui distingue les problèmes confirmés, les pistes non résolues et les hypothèses réfutées. Ces éléments rendent l’audit plus facile à examiner, mais leur présence ne garantit pas à elle seule l’exactitude des conclusions.
Les six phases ci-dessous correspondent au mode d’audit complet (Full audit mode). Par défaut, le skill fonctionne en mode conseil : pour une question ou une revue ciblée, il utilise uniquement les conseils pertinents et ne lance pas automatiquement les six phases ni ne crée d’artefacts d’audit.
Le workflow actuel en six phases
1. Reconnaissance — cartographie initiale
L’agent cartographie l’architecture, les utilisateurs et services concernés, les points d’entrée, les ressources sensibles et les frontières de confiance. Il consigne le résultat dans architecture.md et crée un coverage-ledger.json composé d’unités de travail déterministes. Le périmètre est ainsi visible et les zones manquantes peuvent être repérées.
2. Coverage-led hunting — recherche guidée par la couverture
Des agents de recherche isolés reçoivent des unités du registre, documentent leurs vérifications et étudient des hypothèses liées à de véritables frontières de sécurité. Des agents critiques de couverture cherchent les lacunes. C’est plus précis que de demander à plusieurs agents de « scanner le code » : le travail et les preuves de couverture sont consignés.
Une bonne hypothèse précise les capacités initiales de l’attaquant, la ressource protégée, le chemin dans l’application et le franchissement de frontière supposé. Par exemple, un gestionnaire qui charge une facture par son identifiant ne prouve pas une faille d’autorisation. Il faut vérifier si l’utilisateur contrôle cet identifiant, si une autre couche vérifie la propriété et si la requête peut franchir une frontière entre clients.
3. Candidate validation — validation des pistes
Un nouveau vérificateur reçoit chaque piste unique et tente de la réfuter. Il vérifie si l’entrée est contrôlée par l’attaquant, si le chemin est accessible, si une protection existe ailleurs et si les preuves montrent un résultat de sécurité réel. L’agent qui découvre un constat ne le valide pas lui-même.
4. Structured output — résultats structurés
Le skill écrit les constats dans findings.json avec trois verdicts distincts :
| Verdict | Signification |
|---|---|
confirmed | Une trace complète dans le code et un résultat observé dans un cadre limité établissent une violation de frontière. |
needs_validation | Un fait précis reste à vérifier ; le constat ne reçoit pas de sévérité avant sa résolution. |
rejected | La piste est réfutée et le motif est consigné. |
Un validateur de schéma vérifie la structure. Il ne peut pas, à lui seul, établir l’exploitabilité ; la validation reste donc une phase distincte.
5. Independent record verification — vérification indépendante des constats
De nouveaux agents vérifient les affirmations finales sur le code source et leurs preuves. Si un constat est remplacé de manière substantielle, le nouvel enregistrement fait l’objet d’une autre vérification indépendante. Il s’agit d’examiner le rapport comme pièce de sécurité, et pas seulement de répéter l’enquête initiale sur le code.
6. Target-neutral reporting — rapports neutres vis-à-vis de la cible
Les enregistrements vérifiés et le registre génèrent REPORT.md, FINDINGS-DETAIL.md et NEEDS-VALIDATION.md. Les équipes peuvent voir ce qui est confirmé, ce qui reste incertain et les zones couvertes, sans que l’incertitude soit présentée comme un fait.
Le skill public et le harness interne de Cloudflare
L’article de lancement de Cloudflare décrit un Vulnerability Discovery Harness (VDH) et un Vulnerability Validation System (VVS). Le VDH organise l’analyse du code source et produit des pistes de vulnérabilité. Le VVS traite ensuite les résultats : déduplication, applicabilité en production, priorisation et transmission aux équipes d’ingénierie. Le système plus vaste ajoute aussi une orchestration persistante à l’échelle de plusieurs dépôts, du contexte inter-dépôts et des boucles de retour opérationnel.
Ce contexte est essentiel pour interpréter les résultats de Cloudflare. Le skill public structure un audit, mais ses utilisateurs doivent toujours fournir un environnement d’agent compatible, des contrôles d’exécution sûrs et un moyen d’évaluer l’exposition liée au déploiement. Il ne faut pas déduire que toutes les fonctions du harness interne se trouvent dans le dépôt autonome.
Que signifient les chiffres publiés par Cloudflare ?
Cloudflare a publié en juin 2026 des chiffres issus de son système interne. Ce sont des résultats opérationnels rapportés par l’entreprise, et non un benchmark indépendant du skill public.
| Mesure publiée | Chiffre de Cloudflare |
|---|---|
| Dépôts couverts par le périmètre initial du VDH | 128 |
| Pistes brutes du VDH | 20 799 |
| Pistes ayant passé la validation du VDH | Environ 12 057 |
| Constats dans le pool VVS combiné | 13 841 sur 145 dépôts |
| Doublons identifiés dans ce pool | 5 442 |
| Éléments recyclés à faible risque ou associés au mauvais dépôt | 1 154 |
| Éléments à traiter par les équipes d’ingénierie | 7 245 |
Le chiffre de 128 correspond au périmètre initial de la flotte VDH. Le pool VVS combiné concernait 145 dépôts. Ce sont deux populations distinctes qu’il ne faut pas confondre. Le calcul compte également : les 7 245 éléments à traiter par les équipes d’ingénierie résultent du retrait des doublons et des éléments recyclés à faible risque ou mal attribués dans le pool combiné.
« À traiter » ne signifie pas « confirmé comme exploitable sur un système de production accessible depuis Internet ». Les chiffres de Cloudflare concernent ses propres recherches cloisonnées et son contexte opérationnel ; certains enregistrements reposaient sur des snapshots susceptibles de devenir obsolètes après des changements de code ou de configuration. Ils illustrent l’échelle et le triage, pas un taux universel de détection ni un décompte de failles exploitables depuis l’extérieur.
Cloudflare indique aussi qu’il est impossible de calculer un taux de faux négatifs fiable sans connaître toutes les vulnérabilités présentes. L’entreprise a rapporté qu’une seule exécution avait trouvé environ la moitié des problèmes découverts sur plusieurs exécutions dans ses expériences. C’est un résultat propre à ces essais, pas une affirmation selon laquelle le skill détecterait la moitié des vulnérabilités dans n’importe quelle base de code.
Skill d’audit, SAST et test d’intrusion
Le skill complète les autres méthodes AppSec au lieu de les remplacer. Le SAST peut analyser le code de façon répétable à la recherche de motifs et de flux de données connus. Un audit agentique ajoute une analyse explicite de l’architecture et des frontières de confiance, un suivi de la couverture et une revue contradictoire. Chaque méthode a ses propres limites ; les analyseurs statiques avancés peuvent également raisonner entre fonctions et composants.
Un audit du code source diffère aussi d’un test d’intrusion en conditions réelles. L’analyse du code peut suivre une vérification d’autorisation et reproduire localement un comportement délimité. Un pentest autorisé peut tester un environnement déployé avec des comptes approuvés et un périmètre défini, afin d’observer l’effet de la configuration d’exécution, des fournisseurs d’identité, des passerelles et de l’infrastructure sur le chemin d’attaque. Aucune méthode ne prouve à elle seule la sécurité complète.
Ne dirigez pas le skill contre une cible en ligne et ne considérez pas son déclencheur « pen-test » comme une autorisation de sonder un service déployé. Le workflow documenté est défensif et centré sur le code source. Toute compilation, tout test, processus, navigateur, émulateur, fuzzing ou fixture contrôlé par la cible doit s’exécuter dans un sandbox imposé par le système d’exploitation. Celui-ci doit désactiver le réseau externe, utiliser un environnement assaini et limité à une liste autorisée, appliquer des limites de ressources et restreindre les écritures à des répertoires temporaires assignés. Sans ces contrôles, le workflow exige de conserver la piste au statut needs_validation et de ne pas exécuter le code cible. Évaluez uniquement le code et les environnements que vous possédez ou êtes explicitement autorisés à tester.
Installer le skill en toute sécurité
Le README du projet documente l’installation avec la Skills CLI :
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
Pour une installation au niveau utilisateur, le README ajoute --global. Lancez un agent de programmation compatible dans un dépôt autorisé ou pointez-le vers celui-ci, puis demandez un audit. Les validateurs nécessitent Node.js ; l’agent doit prendre en charge l’utilisation d’outils et les sous-agents parallèles.
L’installation du skill ne crée pas de sandbox système. Mettez en place les contrôles du système d’exploitation avant d’exécuter du code contrôlé par le dépôt. Respectez les règles approuvées de traitement des données, utilisez des identités et données de test, empêchez les téléchargements de dépendances pendant les builds et ne transmettez pas d’identifiants. Avant d’agir, examinez le registre de couverture, les preuves de chaque affirmation et toutes les modifications proposées.
Ce que cela implique pour les équipes AppSec
La principale contribution est la discipline du processus : consigner ce qui a été examiné, distinguer les pistes des constats confirmés, contester chaque piste indépendamment et conserver précisément la question non résolue quand les preuves manquent. Cette démarche rend la recherche assistée par agent plus facile à examiner. Elle ne garantit ni une couverture complète, ni un comportement constant du modèle, ni un impact en production.
Dans un programme AppSec plus large, les équipes doivent encore relier les constats du code au contexte d’exécution, à la responsabilité, à l’exposition et aux tests des correctifs. Pour évaluer des applications en cours d’exécution dans un périmètre autorisé, vous pouvez découvrir Plexicus AI Swarm Pentest comme approche distincte de test à l’exécution. Ce produit ne fait pas partie du skill de Cloudflare, centré sur le code source, et les deux méthodes ne sont pas équivalentes. Évaluez chaque approche selon les preuves qu’elle peut fournir dans le périmètre autorisé ; la publication de Cloudflare n’établit aucune capacité d’un autre produit.
Le critère pratique est simple : évaluez un résultat de sécurité selon la traçabilité des preuves, la frontière qu’il établit, l’incertitude qu’il préserve et la possibilité de le reproduire et d’agir — et non selon le nombre de constats dans un tableau de bord.
Questions fréquentes
Le skill de Cloudflare est-il gratuit ?
Le dépôt est sous licence MIT. L’utilisation des modèles, le calcul et l’environnement d’agent peuvent toutefois engendrer des coûts.
Le skill public est-il le même que le système interne de Cloudflare ?
Non. Le projet public est un point de départ pour un dépôt. Le harness interne ajoute l’orchestration de flotte, ainsi que la validation et le triage décrits dans le blog de Cloudflare.
Corrige-t-il automatiquement les vulnérabilités ?
Le skill public se concentre sur l’audit, la validation et les rapports. Cloudflare décrit séparément des workflows de correction dans son système interne, avec tests de régression et revue humaine. Il ne faut pas les attribuer au skill autonome.
La vérification indépendante élimine-t-elle les faux positifs ?
Non. Elle permet de contester les affirmations non étayées et de préserver l’incertitude. Elle ne garantit ni la justesse de chaque classification ni l’absence de vulnérabilités manquées.
Puis-je l’utiliser contre un site de production ?
N’utilisez pas le workflow d’audit source pour sonder des services en ligne. Une validation en conditions réelles exige une autorisation explicite et un périmètre sûr défini séparément ; les exigences d’exécution documentées concernent du code cible local et isolé.
Sources
- Cloudflare, Build your own vulnerability harness, 18 juin 2026.
- Cloudflare, dépôt et README de security-audit-skill.
- Cloudflare, instructions du Security Audit skill.