Cloudflare macht seinen KI-Security-Audit-Skill quelloffen: So funktioniert er
Cloudflares quelloffener Skill für Coding-Agenten kombiniert abdeckungsorientierte Suche, unabhängige Validierung und strukturierte Belege. Was der Ablauf leisten kann – und was nicht.
Mehr als ASPM
Proof-Driven AppSec für Teams, die mit KI entwickeln
Plexicus nutzt AI Swarm Pentest, um autorisierte Anwendungspfade zu erkunden, ausnutzbare Risiken zu validieren und Teams Belege für die Priorisierung der Remediation zu geben.
AI Swarm Pentest ansehenCloudflare hat einen quelloffenen Skill veröffentlicht, der kompatiblen Coding-Agenten einen strukturierten Ablauf für Code-Audits gibt. Der Kern: Ein KI-generierter Verdacht bleibt ein Kandidat, bis jemand den Quellcode nachverfolgt, die Vertrauensgrenze prüft und unabhängig versucht, den Befund zu widerlegen.
Das ist entscheidend. Eine verdächtig wirkende Funktion zu finden, beweist nicht, dass ein Angreifer sie erreichen und eine geschützte Ressource beeinflussen kann. Cloudflares Repository security-audit-skill macht diesen Belegpfad zum Teil des Prozesses.
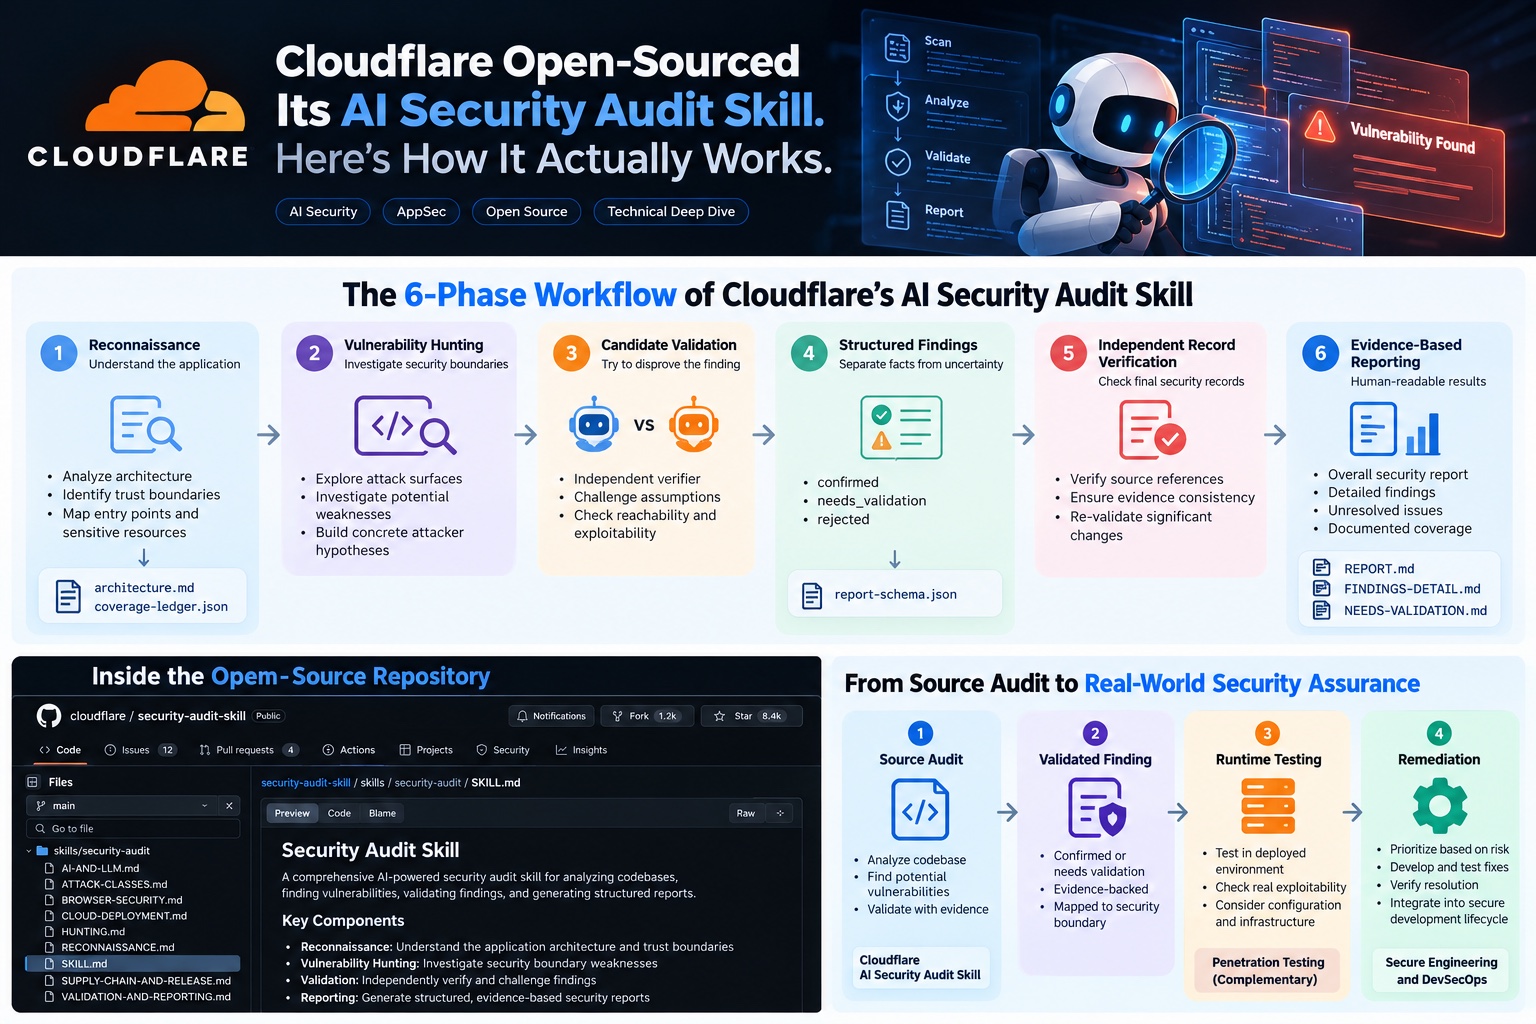
Plexicus-Illustration. Alle UI-Details – einschließlich der Zähler für Repository-Sterne und Forks – sind Mockups, keine Live-Daten des Cloudflare-Repositories und kein Screenshot eines Cloudflare-Produkts.
Was hat Cloudflare quelloffen gemacht?
Das öffentliche Repository enthält einen Skill für Coding-Agenten, der jeweils ein einzelnes Repository auditiert: Anweisungen, Angriffsklassen, Validierungsregeln, Schemas und Skripte für Audit-Datensätze. Er steht unter der MIT-Lizenz. Dieser Skill war der Ausgangspunkt für ein größeres internes System, ist aber nicht mit dem gesamten System gleichzusetzen.
In dem Artikel „Build your own vulnerability harness“ vom 18. Juni 2026 beschrieb Cloudflare zunächst einen Ablauf mit sieben Schritten und anschließend dessen Ausbau zu einem internen System zur Schwachstellensuche. Das aktuelle öffentliche Repository beschreibt sechs Phasen. Die Beschreibungen beziehen sich auf unterschiedliche Versionen und Umfänge und dürfen nicht zu einem einzigen Ablauf vermischt werden.
Cloudflare zufolge deckte ein internes Flotten-Harness in rund sechs Wochen 128 Repositories ab. Die interne Architektur umfasst dauerhafte Orchestrierung und nachgelagerte Triage, die nicht automatisch mit der Installation des öffentlichen Skills bereitstehen. Das öffentliche Projekt ist am besten als prüfbare Methode für ein einzelnes Repository zu verstehen, die Teams anpassen können.
Was enthält das Repository?
Dazu gehören SKILL.md mit Ablauf und Sicherheitsregeln, Leitfäden zu Reconnaissance und Hunting, Angriffsklassen etwa für KI/LLM-Sicherheit, Webprotokolle, Lieferkette, Cloud und clientseitigen Code sowie VALIDATION-AND-REPORTING.md, report-schema.json und abhängigkeitsfreie Node.js-Validatoren für Findings und Coverage-Ledger.
Das Ledger dokumentiert, welche Systembereiche von wem und mit welchen Belegen untersucht wurden. Findings werden in einem Schema erfasst, das bestätigte Probleme, offene Kandidaten und widerlegte Hypothesen unterscheidet. Diese Artefakte machen ein Audit nachvollziehbarer, beweisen aber nicht automatisch, dass jede Schlussfolgerung richtig ist.
Die folgenden sechs Phasen beschreiben den Full audit mode. Standardmäßig arbeitet der Skill im Guidance-Modus: Bei gezielten Fragen und Prüfungen nutzt er nur die relevanten Hinweise und startet nicht automatisch alle sechs Phasen oder erstellt Audit-Artefakte.
Der aktuelle Ablauf in sechs Phasen
1. Reconnaissance — Architektur und Grenzen erfassen
Der Agent erfasst Architektur, beteiligte Identitäten, Einstiegspunkte, sensible Ressourcen und Vertrauensgrenzen. Die Ergebnisse landen in architecture.md; ein coverage-ledger.json legt nachvollziehbare Arbeitseinheiten fest. Dadurch wird der Untersuchungsumfang sichtbar, und spätere Prüfer können Lücken erkennen.
2. Coverage-led hunting — abdeckungsorientierte Suche
Isolierte Hunter erhalten Einheiten aus dem Ledger, dokumentieren ihre Prüfungen und untersuchen Hypothesen zu tatsächlichen Vertrauensgrenzen. Coverage Critics suchen nach ausgelassenen Bereichen. Das ist konkreter als mehrere Agenten einfach „den Code scannen“ zu lassen: Arbeitsschritte und Belege für die Abdeckung werden festgehalten.
Eine brauchbare Hypothese nennt die Ausgangsmöglichkeiten des Angreifers, die geschützte Ressource, den Pfad durch die Anwendung und den vermuteten Grenzübertritt. Ein Handler, der eine Rechnung anhand einer ID lädt, ist beispielsweise nicht automatisch eine Autorisierungsschwachstelle. Zu prüfen ist, ob Nutzer die ID kontrollieren, eine andere Schicht den Besitz prüft und ob dadurch eine Mandantengrenze überschritten werden kann.
3. Candidate validation — Kandidaten validieren
Ein neuer Verifizierer erhält jeden eindeutigen Kandidaten und versucht, ihn zu widerlegen. Er prüft, ob die Eingabe vom Angreifer kontrolliert wird, der Pfad erreichbar ist, an anderer Stelle eine Schutzmaßnahme greift und die Belege einen echten Sicherheitseffekt zeigen. Der entdeckende Agent verifiziert den eigenen Befund nicht.
4. Structured output — strukturierte Ausgabe
Der Skill schreibt Findings in findings.json und unterscheidet drei Urteile:
| Urteil | Bedeutung |
|---|---|
confirmed | Vollständiger Quellpfad und ein begrenzt beobachtetes Ergebnis belegen eine verletzte Vertrauensgrenze. |
needs_validation | Eine konkrete Tatsache ist ungeklärt; bis zur Prüfung erhält der Datensatz keinen Schweregrad. |
rejected | Der Kandidat wurde widerlegt; der Grund ist dokumentiert. |
Ein Schema-Validator prüft die Struktur. Er kann die Ausnutzbarkeit nicht selbst belegen; deshalb bleibt die Validierung eine eigene Phase.
5. Independent record verification — unabhängige Prüfung der Datensätze
Neue Agenten prüfen die endgültigen Quellcodeaussagen und die dazugehörigen Belege. Wird ein Eintrag wesentlich ersetzt, erhält auch der Ersatz eine unabhängige Prüfung. Dabei wird der Bericht als Sicherheitsnachweis geprüft, nicht nur die ursprüngliche Codehypothese wiederholt.
6. Target-neutral reporting — zielneutrale Berichte
Aus den verifizierten Datensätzen und dem Ledger entstehen REPORT.md, FINDINGS-DETAIL.md und NEEDS-VALIDATION.md. Teams sehen, was bestätigt wurde, was offen ist und welche Bereiche untersucht wurden, ohne dass Unsicherheit als Tatsache dargestellt wird.
Öffentlicher Skill und internes Harness im Vergleich
Cloudflares Startartikel beschreibt ein internes Vulnerability Discovery Harness (VDH) und ein Vulnerability Validation System (VVS). Das VDH organisiert Quellcodeuntersuchungen und erzeugt Schwachstellenkandidaten. Das VVS übernimmt die nachgelagerte Prüfung, etwa Deduplizierung, Produktionsrelevanz, Priorisierung und Weitergabe an die Entwicklung. Das größere System ergänzt außerdem persistente Orchestrierung über viele Repositories, Kontext über Repository-Grenzen hinweg und operative Feedback-Schleifen.
Dieser Kontext ist wichtig, um Cloudflares Ergebnisse einzuordnen. Ein öffentlicher Skill strukturiert ein Audit. Die Anwender müssen jedoch weiterhin eine kompatible Agentenumgebung, sichere Ausführungskontrollen und eine Bewertung der konkreten Deployment-Exposition bereitstellen. Nicht jede Funktion des internen Harness ist Teil des eigenständigen Repositories.
Was bedeuten Cloudflares Zahlen?
Cloudflare veröffentlichte im Juni 2026 Kennzahlen aus seinem internen System. Es sind vom Unternehmen gemeldete Betriebsergebnisse und kein unabhängiger Benchmark des öffentlichen Skills.
| Gemeldete Kennzahl | Cloudflares Wert |
|---|---|
| Repositories im anfänglichen VDH-Flottenumfang | 128 |
| Rohe VDH-Kandidaten | 20.799 |
| Nach VDH-Validierung verbliebene Kandidaten | etwa 12.057 |
| Findings im kombinierten VVS-Pool | 13.841 aus 145 Repositories |
| In diesem Pool erkannte Duplikate | 5.442 |
| Falschem Repository zugeordnete oder wiederverwendete Einträge mit geringem Risiko | 1.154 |
| Als umsetzbar an die Entwicklung weitergeleitet | 7.245 |
Die Zahl 128 beschreibt den anfänglichen Flottenumfang des VDH. Der kombinierte VVS-Pool umfasste laut Bericht 145 Repositories. Das sind unterschiedliche Grundgesamtheiten. Auch die Rechnung ist relevant: Die 7.245 umsetzbaren Einträge ergeben sich nach Abzug von Duplikaten sowie falsch zugeordneten oder wiederverwendeten Einträgen mit geringem Risiko aus dem kombinierten Pool.
„Umsetzbar“ bedeutet nicht „auf einem aus dem Internet erreichbaren Produktionssystem nachweislich ausnutzbar“. Cloudflares Angaben beziehen sich auf eigene, abgegrenzte Forschung und den betrieblichen Kontext; einige Datensätze beruhten auf Snapshots, die durch Änderungen an Code oder Konfiguration veralten können. Die Zahlen zeigen Umfang und Triage, aber weder eine universelle Erkennungsrate noch die Anzahl externer, ausnutzbarer Fehler.
Cloudflare weist außerdem darauf hin, dass sich eine verlässliche False-Negative-Rate nicht bestimmen lässt, solange nicht alle vorhandenen Schwachstellen bekannt sind. Ein einzelner Lauf habe in den Experimenten etwa die Hälfte der über mehrere Läufe gefundenen Probleme erkannt. Das ist ein Ergebnis dieser Läufe, keine allgemeingültige Quote für beliebige Codebasen.
Audit-Skill, SAST und Penetrationstest
Der Skill ergänzt andere AppSec-Methoden, statt sie zu ersetzen. SAST kann Code wiederholt auf bekannte Muster und Datenflüsse prüfen. Ein agentisches Audit ergänzt eine explizite Untersuchung von Architektur und Vertrauensgrenzen, dokumentierte Abdeckung und adversariale Prüfung. Beide Ansätze haben unterschiedliche Fehlermöglichkeiten; moderne statische Analyse kann ebenfalls über Funktionen und Komponenten hinweg argumentieren.
Ein quellcodeorientiertes Audit ist außerdem kein Laufzeit-Pentest. Beim Code-Review lässt sich etwa ein Autorisierungspfad nachverfolgen und ein begrenztes Verhalten lokal reproduzieren. Ein autorisierter Pentest kann mit genehmigten Konten und definiertem Umfang eine bereitgestellte Umgebung prüfen. Dabei zeigt sich, wie Laufzeitkonfiguration, Identitätsanbieter, Gateways und Infrastruktur den Angriffspfad beeinflussen. Keine Methode beweist für sich allein vollständige Sicherheit.
Richte den Skill nicht auf ein Live-Ziel aus und verstehe den Auslöser „pen-test“ nicht als Erlaubnis, einen bereitgestellten Dienst zu prüfen. Der dokumentierte Ablauf ist defensiv und quellcodeorientiert. Alle vom Ziel kontrollierten Builds, Tests, Prozesse, Browser, Emulatoren, Fuzzer und Fixtures müssen in einer vom Betriebssystem erzwungenen Sandbox laufen. Sie muss externe Netzwerke deaktivieren, eine bereinigte Allowlist-Umgebung verwenden, Ressourcenlimits durchsetzen und Schreibzugriffe auf zugewiesene Scratch-Pfade beschränken. Fehlen diese Kontrollen, soll der Kandidat laut Workflow needs_validation bleiben und der Zielcode nicht ausgeführt werden. Prüfe nur Code und Umgebungen, die dir gehören oder für die du ausdrücklich autorisiert bist.
Skill sicher installieren
Die README dokumentiert die Installation über die Skills CLI:
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
Für eine Installation auf Benutzerebene ergänzt die README --global. Starte einen kompatiblen Coding-Agenten in oder mit Zugriff auf ein autorisiertes Repository und fordere ein Audit an. Die Validatoren benötigen Node.js; der Agent muss Tool-Aufrufe und parallele Subagenten unterstützen.
Die Installation des Skills erstellt keine OS-Sandbox. Lege die Betriebssystemkontrollen fest, bevor du Repository-kontrollierten Code ausführen lässt. Beachte die genehmigten Datenschutzbedingungen deines Unternehmens, verwende Dummy-Identitäten und Testdaten, erlaube Builds keine Abhängigkeitsdownloads und vererbe keine Zugangsdaten. Prüfe das Coverage-Ledger, die Belege zu jedem Befund und alle vorgeschlagenen Änderungen, bevor du handelst.
Bedeutung für AppSec-Teams
Der wichtigste Beitrag ist die Prozessdisziplin: festhalten, was geprüft wurde, Kandidaten von bestätigten Findings trennen, jeden Kandidaten unabhängig hinterfragen und bei fehlender Evidenz die genaue offene Frage bewahren. Das macht agentengestützte Forschung besser überprüfbar. Es garantiert weder vollständige Abdeckung noch gleichbleibendes Modellverhalten oder Produktionsauswirkungen.
Für ein umfassenderes AppSec-Programm müssen Teams Quellbefunde weiterhin mit Laufzeitkontext, Zuständigkeit, Exposition und Retests der Behebung verbinden. Für die Prüfung autorisierter, laufender Anwendungen kannst du Plexicus AI Swarm Pentest als separaten Ansatz für Laufzeittests ansehen. Er ist nicht Teil von Cloudflares quellcodeorientiertem Skill, und beide Methoden sind nicht gleichwertig. Bewerte jeden Ansatz anhand der Belege, die er für den genehmigten Umfang liefern kann; aus der Cloudflare-Veröffentlichung lassen sich keine Produktfähigkeiten ableiten.
Der praktische Maßstab ist einfach: Bewerte ein Sicherheitsergebnis nach nachvollziehbaren Belegen, der nachgewiesenen Vertrauensgrenze, offengelegter Unsicherheit und der Möglichkeit, es nachzustellen und zu beheben – nicht nach der Anzahl von Findings im Dashboard.
Häufige Fragen
Ist Cloudflares Skill kostenlos?
Das Repository steht unter MIT-Lizenz. Kosten für Modellnutzung, Rechenleistung und die umgebende Agentenumgebung können trotzdem anfallen.
Ist der öffentliche Skill derselbe wie Cloudflares internes System?
Nein. Das öffentliche Projekt ist ein Ausgangspunkt für ein einzelnes Repository. Das interne Harness ergänzt Flotten-Orchestrierung und nachgelagerte Validierung und Triage, die Cloudflare in seinem Blog beschreibt.
Behebt der Skill Schwachstellen automatisch?
Der öffentliche Skill konzentriert sich auf Audit, Validierung und Berichte. Cloudflare beschreibt für das interne System separate Behebungsabläufe mit Regressionstests und menschlicher Prüfung. Diese sollte man nicht dem alleinstehenden Skill zuschreiben.
Verhindert die unabhängige Prüfung False Positives?
Nein. Sie soll unbelegte Aussagen hinterfragen und Unsicherheit sichtbar halten. Sie garantiert weder korrekte Klassifizierungen noch, dass keine Schwachstelle übersehen wurde.
Kann ich den Skill gegen eine Produktionswebsite einsetzen?
Verwende den Quellcode-Audit-Ablauf nicht, um Live-Dienste zu prüfen. Laufzeitvalidierung braucht ausdrückliche Autorisierung und einen separat definierten sicheren Umfang; die dokumentierten Ausführungsanforderungen beziehen sich auf isolierten lokalen Zielcode.
Quellen
- Cloudflare, Build your own vulnerability harness, 18. Juni 2026.
- Cloudflare, Repository und README zu security-audit-skill.
- Cloudflare, Anweisungen zum Security-Audit-Skill.